
Apuntes · Capítulo 1Introducción
¿Qué hace un sistema operativo? Introducción y procesos
¿Qué hace un sistema operativo? Introducción y procesos
Cada vez que abren un navegador, compilan un programa o guardan un archivo, hay una pieza de software que trabaja sin que la vean: el sistema operativo (operating system, OS). Este curso trata de esa pieza. Vamos a estudiar qué hace, cómo lo hace y por qué está diseñada así, leyendo y modificando el código de un kernel real.
Este primer capítulo tiene dos partes. En la primera respondemos qué es un sistema operativo, lo vemos en acción con cuatro pequeños programas, repasamos cómo llegamos a los sistemas de hoy y vemos cómo se organiza un kernel por dentro. En la segunda presentamos la abstracción más importante del curso: el proceso (process), un programa en ejecución.
Ruta de lectura.
- Antes de clase (15–20 min): «Qué pasa cuando un programa se ejecuta», «Tres trabajos del sistema operativo» y «Mecanismo y política».
- En clase: sesión A, «Cuatro demostraciones», «Metas de diseño», «Un poco de historia» y «Cómo se organiza un kernel»; sesión B, «La abstracción de proceso».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 2 y 4, y «Tanenbaum contra Torvalds».
Lectura. Este capítulo acompaña a OSTEP cap. 1 (diálogo), cap. 2 Introduction to Operating Systems, cap. 3 (diálogo sobre virtualización) y cap. 4 The Abstraction: The Process. El código está en
code/week-01y se compila conmakedentro del contenedor del curso (env/run.sh).
Qué pasa cuando un programa se ejecuta
Un procesador hace algo muy simple, miles de millones de veces por segundo: busca (fetch) la siguiente instrucción en memoria, la decodifica (decode) para saber qué operación es y la ejecuta (execute): suma dos registros, compara, salta a otra dirección, lee o escribe memoria. Después pasa a la siguiente instrucción. Ese es el modelo de Von Neumann y es todo lo que la CPU sabe hacer.
Con solo eso, una computadora ejecutaría un programa a la vez, y ese programa tendría que saber manejar el disco, la pantalla y el teclado por su cuenta. Nadie quiere programar así. El sistema operativo es la capa de software que se pone entre los programas y el hardware para que todo esto sea fácil, seguro y eficiente:
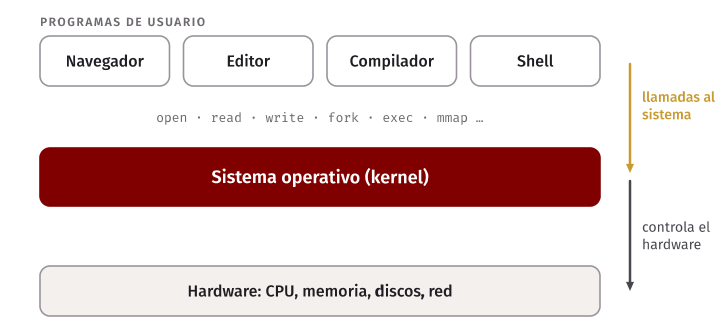
La parte del sistema operativo que corre con todos los privilegios del procesador se llama kernel. Los programas no tocan el hardware directamente: le piden al kernel que lo haga por ellos.
Tres trabajos del sistema operativo
1. Virtualizar
La técnica central es la virtualización: tomar un recurso físico (la CPU, la memoria, un disco) y transformarlo en una versión virtual, más general y más fácil de usar. Hay una sola CPU física, pero cada programa se comporta como si tuviera una CPU para él solo. Hay una sola memoria física, pero cada programa ve su propio espacio de memoria, que empieza en las mismas direcciones y que nadie más puede tocar. Por eso a veces se dice que el sistema operativo es una máquina virtual.
2. Administrar recursos
Si diez programas quieren la CPU, alguien tiene que decidir cuál corre ahora y por cuánto tiempo. Si la memoria no alcanza, alguien decide a quién se le quita. Si llegan cien pedidos al disco, alguien decide el orden. El sistema operativo es un administrador de recursos (resource manager): reparte la CPU, la memoria y los dispositivos entre los programas, de forma eficiente y justa.
3. Ofrecer una interfaz: las llamadas al sistema
Para que los programas puedan pedir cosas, el kernel ofrece unos cientos de
llamadas al sistema (system calls): open, read, write, fork,
exec, mmap… Funcionan como la biblioteca estándar de la máquina: un
conjunto fijo de operaciones con las que se construye todo lo demás.
Conviene distinguir dos cosas que en C se ven iguales. Cuando su programa llama
a printf, está llamando a una función de la biblioteca de C (libc), que
corre en el mismo programa, sin privilegios. printf arma el texto en un
buffer y, en algún momento, llama a write. write también es una función de
libc, pero muy delgada: lo único que hace es pasar el control al kernel con una
instrucción especial. Esa entrada al kernel es la llamada al sistema
propiamente dicha. La semana 2 veremos ese mecanismo en detalle.
Idea clave. Este curso se organiza en tres piezas: virtualización (de la CPU y de la memoria), concurrencia (muchas cosas pasando a la vez sin romperse) y persistencia (datos que sobreviven a un apagón). Además veremos máquinas virtuales, sistemas distribuidos y seguridad.
Cuatro demostraciones
Los cuatro programas de code/week-01 muestran, cada
uno, una de esas piezas. Compílenlos dentro del contenedor:
$ cd code/week-01
$ make
Todos usan la función spin() de common.h, que
hace una espera activa: consulta el reloj una y otra vez hasta que pase el
tiempo pedido, sin soltar la CPU.
Demostración 1: virtualizar la CPU
cpu.c imprime cinco veces el texto que recibe, una
vez por segundo:
int main(int argc, char *argv[]) {
    for (int i = 0; i < 5; i++) {
        spin(1);
        printf("%s\n", argv[1]);
        fflush(stdout);
    }
    return 0;
}
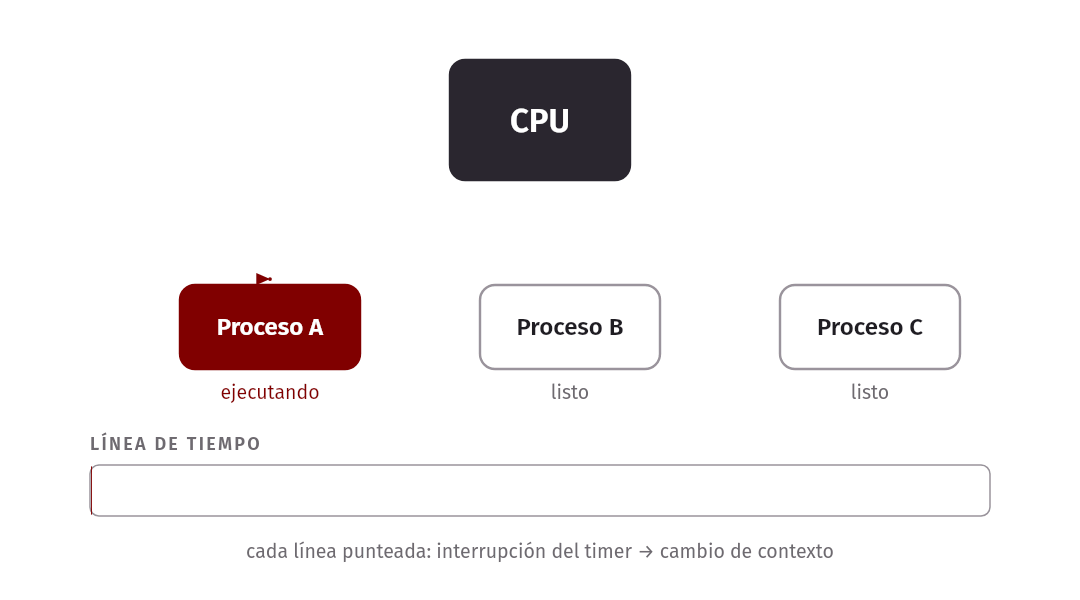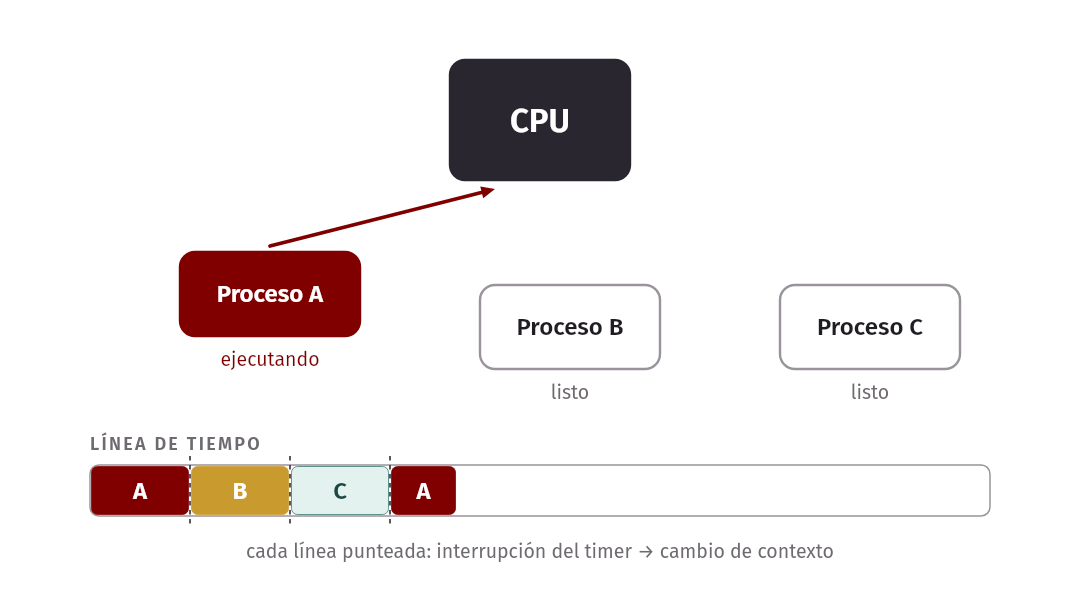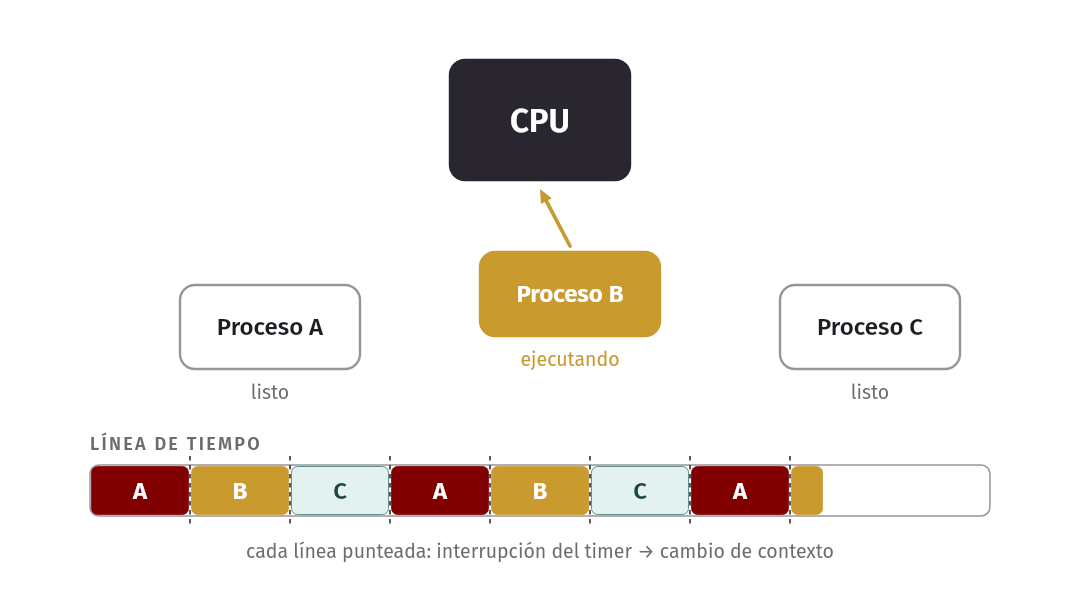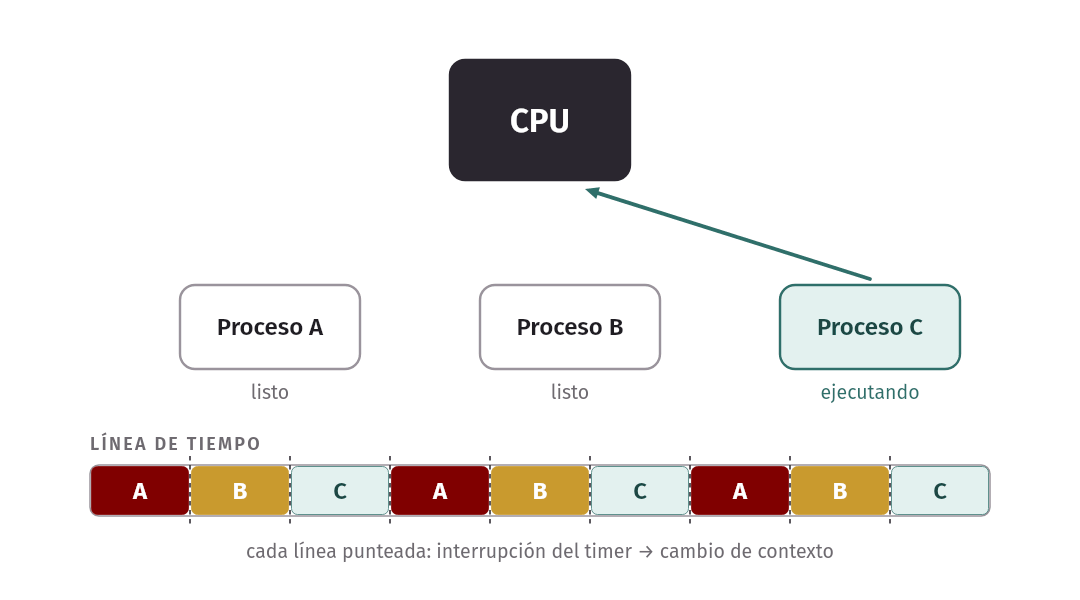
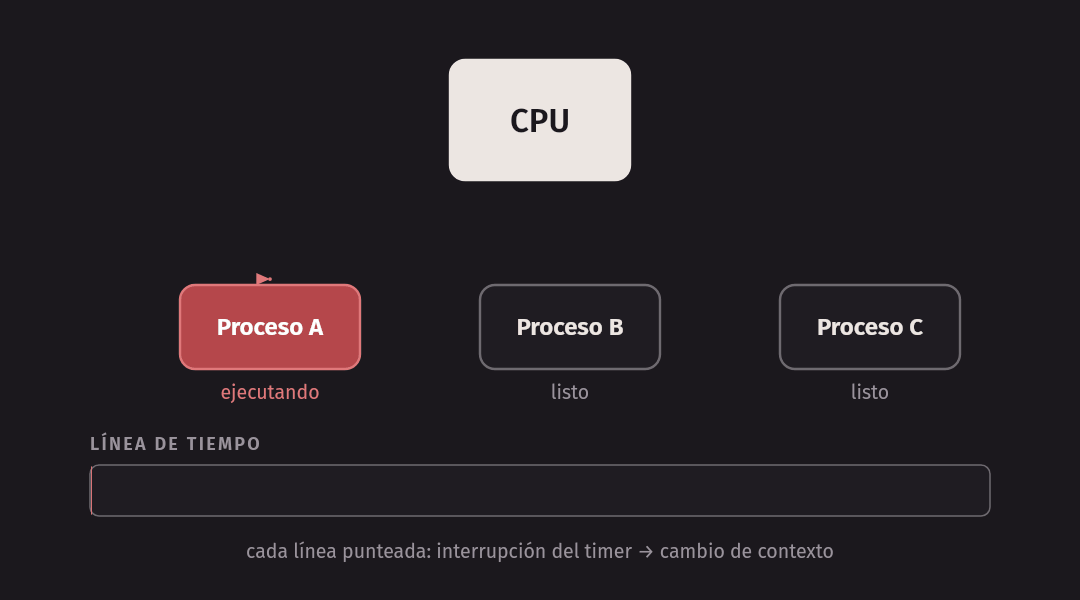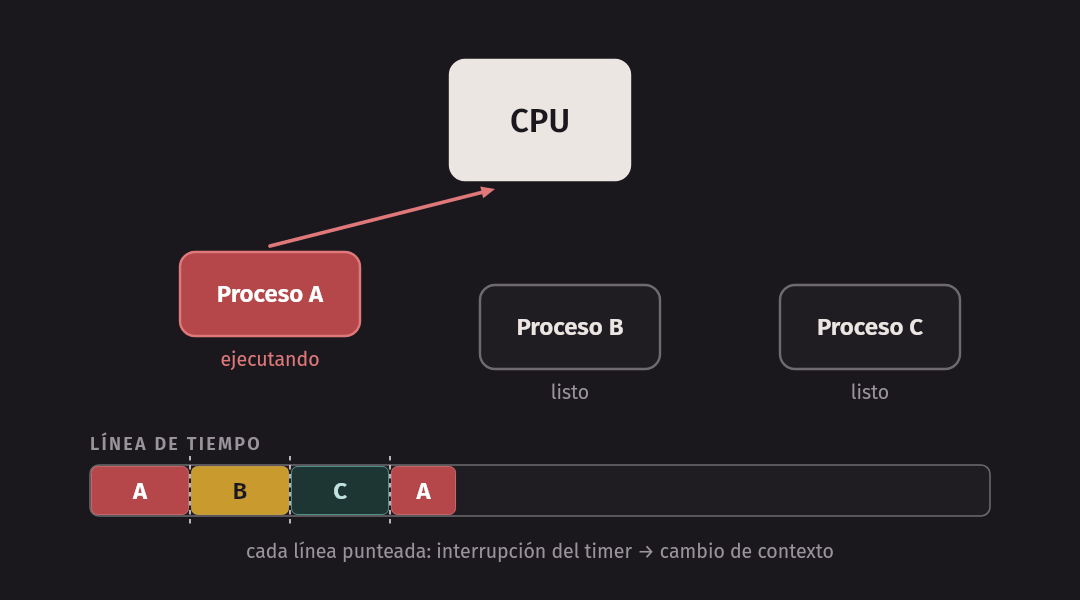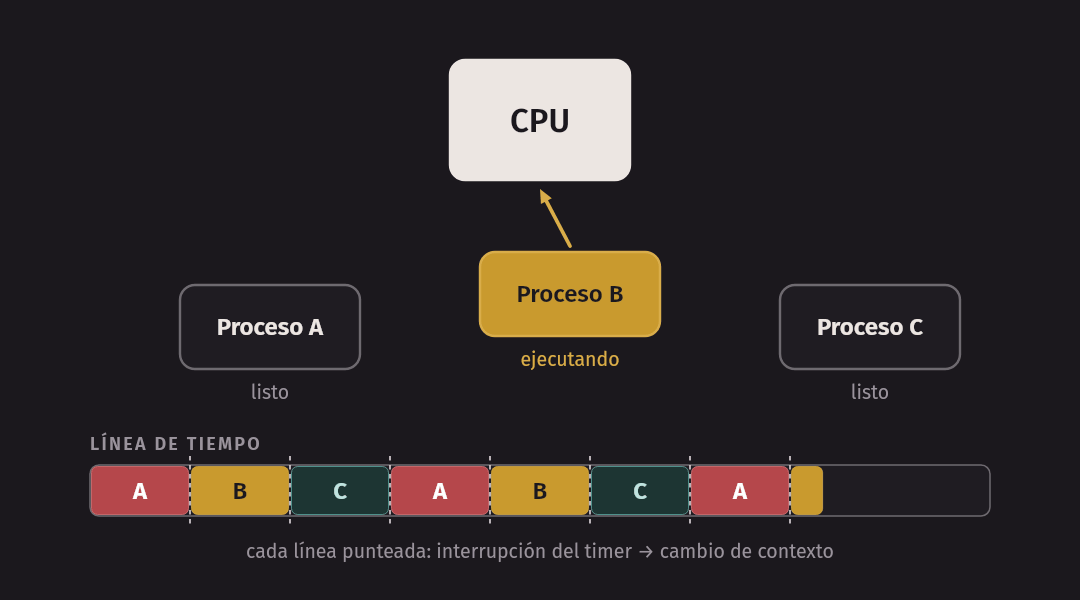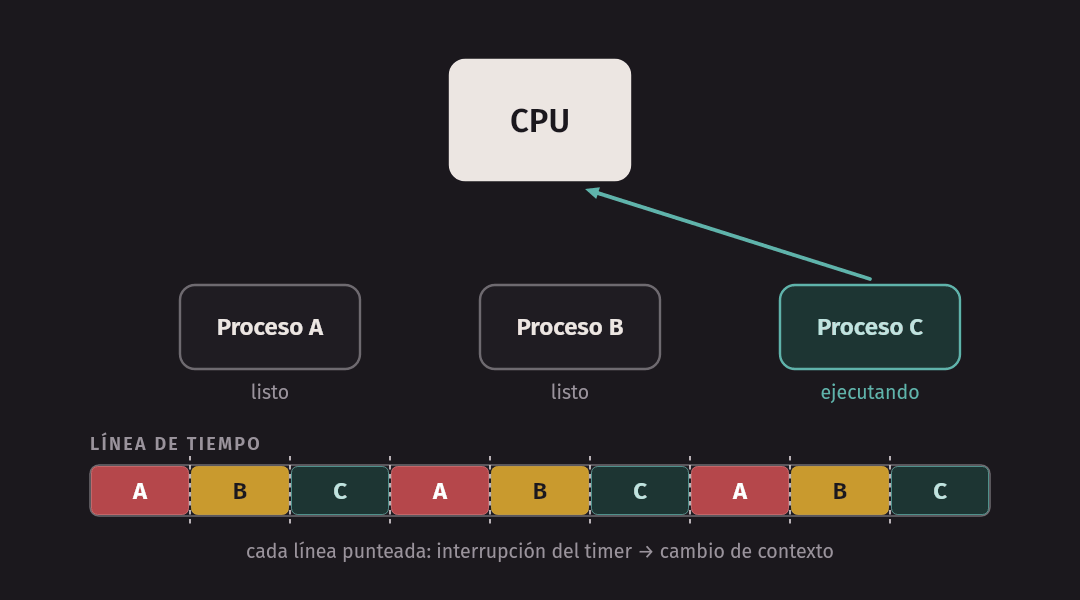
Ejecuten dos copias a la vez, con & para que la shell no espere a la
primera:
$ ./cpu A & ./cpu B &
A
B
B
A
...
Las dos copias avanzan juntas, aunque cada una quiere la CPU todo el tiempo.
Si lanzan más copias que núcleos tiene su máquina, siguen avanzando todas, solo
que más lento. El orden en que aparecen A y B cambia de una ejecución a
otra: lo decide el sistema operativo. Cada programa cree tener una CPU
exclusiva. Esa es la virtualización de la CPU, y a ella dedicamos las
semanas 1 a 4: cómo se cambia de un programa a otro (mecanismo) y a cuál le toca
(política).
Demostración 2: virtualizar la memoria
mem.c reserva un entero con malloc, imprime su
dirección y lo incrementa una vez por segundo:
int *p = malloc(sizeof(int));
*p = atoi(argv[1]);
printf("(%d) dirección: %p\n", getpid(), (void *)p);
for (int i = 0; i < 4; i++) {
    spin(1);
    *p = *p + 1;
    printf("(%d) *p = %d\n", getpid(), *p);
}
Ejecuten dos copias, una que empieza en 0 y otra en 100:
$ setarch -R ./mem 0 &
$ setarch -R ./mem 100 &
(34) dirección: 0xaaaaaaac12a0
(35) dirección: 0xaaaaaaac12a0
(34) *p = 1
(35) *p = 101
(34) *p = 2
(35) *p = 102
...
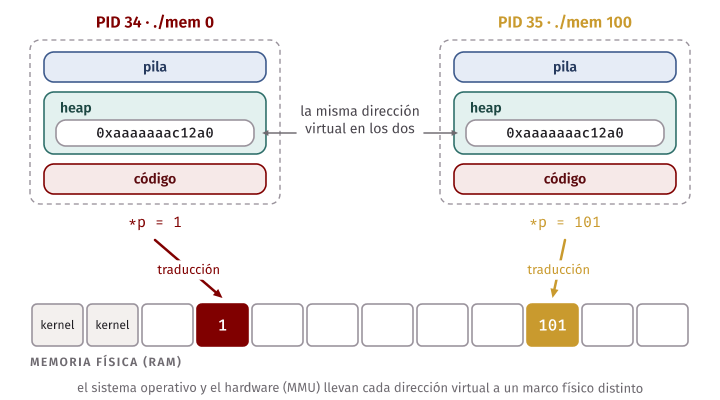
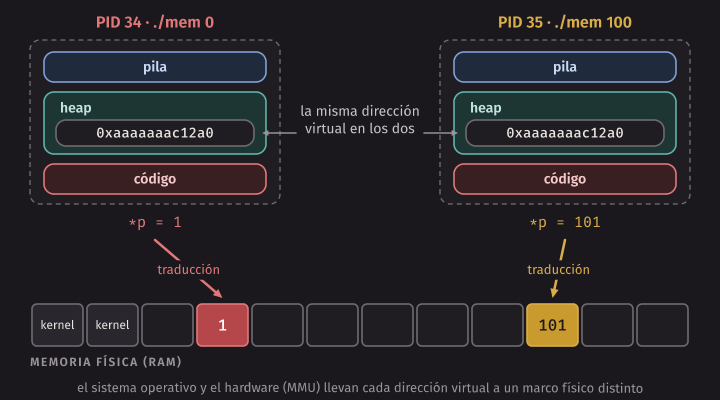
El número entre paréntesis es el identificador de proceso (PID). Las dos copias
usan la misma dirección, 0xaaaaaaac12a0, y sin embargo cada una tiene su
propio valor: una cuenta 1, 2, 3, 4 y la otra 101, 102, 103, 104. Si fuera la
misma celda de memoria física, una pisaría a la otra.
La explicación es que la dirección que ve el programa es virtual. Cada proceso tiene su propio espacio de direcciones (address space), y el sistema operativo, con ayuda del hardware, traduce cada dirección virtual a una dirección física distinta. Es la virtualización de la memoria, el tema de las semanas 5 a 8.
¿Para qué sirve setarch -R? Linux, por seguridad, coloca el heap y la pila en
posiciones aleatorias cada vez que arranca un programa (address space layout
randomization, ASLR). Con ASLR activo las dos copias imprimirían direcciones
diferentes y el experimento no se vería. setarch -R lanza el programa con
ASLR desactivado. Para que funcione dentro de Docker, el contenedor debe
arrancar con --security-opt seccomp=unconfined, porque el filtro de seguridad
por defecto de Docker bloquea la llamada personality() que usa setarch.
env/run.sh ya pasa esa opción.
Demostración 3: concurrencia
threads.c crea dos hilos (threads) dentro
del mismo proceso. Los dos comparten la memoria y los dos incrementan el mismo
contador loops veces:
static volatile long counter = 0;

static void *worker(void *arg) {
    for (long i = 0; i < loops; i++)
        counter++;          // leer, sumar, escribir: tres pasos, no uno
    return NULL;
}
El resultado debería ser 2 * loops. Con pocos ciclos, lo es:
$ ./threads 1000
esperado: 2000
obtenido: 2000
$ ./threads 1000000
esperado: 2000000
obtenido: 1080962
Con un millón de ciclos se perdieron casi un millón de sumas, y si lo ejecutan
de nuevo el número será otro. El problema es que counter++ no es una sola
instrucción: el procesador lee el valor de memoria a un registro, le
suma uno y lo escribe de vuelta. Si los dos hilos leen el mismo valor,
por ejemplo 500, los dos escriben 501 y una de las sumas se pierde. Con 1000
ciclos cada hilo termina antes de que el otro empiece, y casi nunca se
intercalan; con un millón, se intercalan todo el tiempo.
Esta situación se llama condición de carrera (race condition), y evitarla sin perder rendimiento es el tema de la parte de concurrencia (semanas 9 a 12): locks, variables de condición, semáforos.
Demostración 4: persistencia
La memoria es volátil: se borra al apagar la computadora. Para que los datos
sobrevivan necesitamos un disco y un sistema de archivos (file system).
io.c crea un archivo y escribe una línea:
int fd = open("hola.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
write(fd, msg, strlen(msg));
fsync(fd);   // sin esto, los datos podrían quedar solo en la caché del kernel
close(fd);
Parece trivial, pero el sistema operativo tiene que decidir en qué parte del
disco van los datos, actualizar las estructuras que dicen qué bloques están
ocupados y a qué archivo pertenecen, y hacerlo rápido. Por rendimiento, write
normalmente deja los datos en memoria y los escribe al disco más tarde; fsync
obliga al kernel a escribirlos ya. Y queda la pregunta más difícil: ¿qué pasa si
se va la luz a mitad de la escritura? Guardar datos de forma confiable y
eficiente es la persistencia, la tercera parte del curso (semanas 13 a 15).
Metas de diseño
Un sistema operativo intenta lograr varias cosas a la vez:
| Meta | Qué significa |
|---|---|
| Abstracciones | Que la máquina sea fácil de usar: procesos, archivos, memoria virtual |
| Rendimiento | Que el sistema operativo cueste poco tiempo y poca memoria |
| Protección y aislamiento | Que un programa no pueda dañar a otro ni al kernel |
| Confiabilidad | Que el kernel no falle: si falla, falla todo |
| Eficiencia energética | Importante en celulares, laptops y centros de datos |
| Seguridad | Resistir a programas y usuarios maliciosos |
Estas metas chocan entre sí. Más protección significa más verificaciones, y eso cuesta rendimiento. Más rendimiento suele significar código más complicado, y eso cuesta confiabilidad. Casi todas las decisiones que veremos en el curso son un compromiso entre metas.
Un poco de historia
Los sistemas operativos actuales no se diseñaron de una vez: cada idea apareció para resolver un problema concreto de su época.
Bibliotecas y lotes (1950s). Las primeras computadoras ejecutaban un programa a la vez. El “sistema operativo” era poco más que una biblioteca de rutinas para manejar la E/S. Un operador humano juntaba los trabajos y los cargaba uno tras otro: el procesamiento por lotes (batch).
Protección y multiprogramación (1960s). Pronto se vio que el código del sistema operativo debía ser especial: si cualquier programa podía leer cualquier parte del disco, no había privacidad. Así aparecieron la idea de llamada al sistema y el modo kernel: el hardware distingue entre código privilegiado y código de usuario, y solo se entra al kernel por puntos de entrada controlados. También apareció la multiprogramación (multiprogramming): con varios trabajos en memoria, mientras uno espera al disco (muy lento) la CPU ejecuta otro. Y con ella el tiempo compartido (time sharing): muchos usuarios conectados a la vez desde terminales, cada uno con la sensación de tener la máquina para él, porque el sistema cambia de uno a otro muchas veces por segundo. Multiprogramación y tiempo compartido son, justamente, virtualización de la CPU.
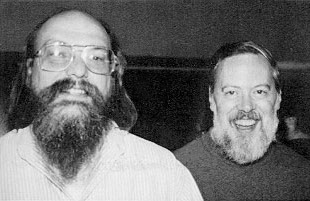
Unix (1969). Ken Thompson y Dennis Ritchie, en Bell Labs, crearon Unix a partir de las ideas del sistema Multics, pero mucho más simple. Unix se basa en pocas abstracciones que se combinan bien: procesos, archivos, pipes y una shell en la que cada comando hace una sola cosa. Estaba escrito en C, el lenguaje que Ritchie creó para eso, y por eso pudo llevarse a otras máquinas.
Computadoras personales (1980s). Con la PC, el sistema operativo volvió a empezar casi de cero. Los primeros sistemas para PC, como DOS o el Mac OS clásico, no protegían la memoria: un programa con un error podía borrar la memoria de todos y colgar la máquina. Con los años, las ideas de los sistemas grandes regresaron: Windows NT y Mac OS X ya tenían protección.
Linux (1991) y hoy. Linus Torvalds publicó Linux, un kernel libre tipo Unix. Hoy Linux corre en casi todos los servidores, en Android, en routers y en todas las supercomputadoras de la lista Top500. macOS e iOS también descienden de Unix. Las ideas de 1970 siguen vigentes.
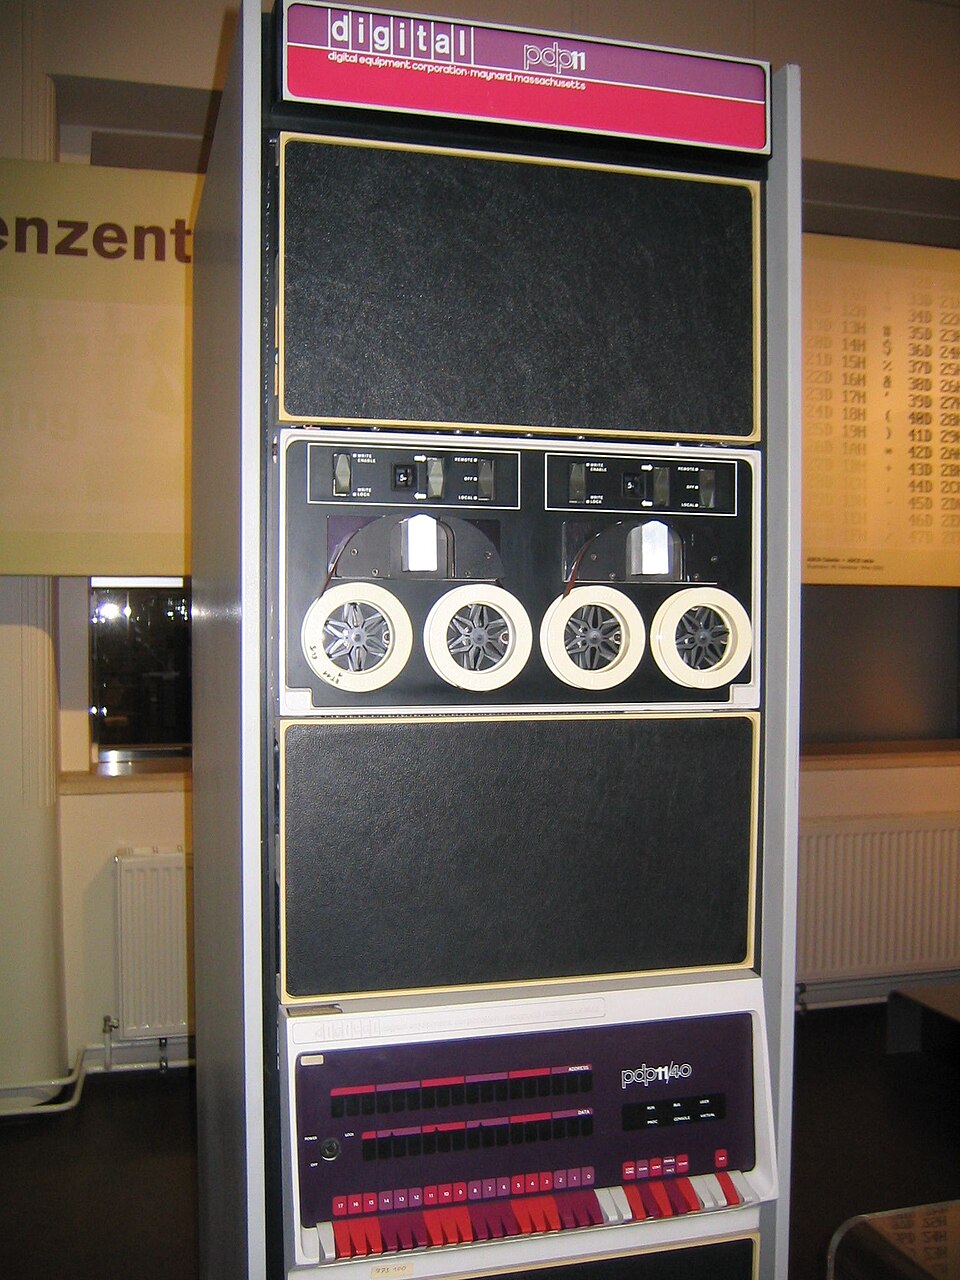
En xv6. En los proyectos del curso usamos xv6-riscv, una reimplementación moderna de Unix v6 escrita en el MIT para enseñar. Corre sobre RISC-V, una arquitectura de procesador abierta que se usa en investigación, en chips embebidos y cada vez más en la industria. Tiene menos de 7000 líneas de C y ensamblador en
kernel/: se puede leer completo en un semestre. Lo ejecutamos con el emulador QEMU dentro del contenedor del curso (make qemu).
Cómo se organiza un kernel
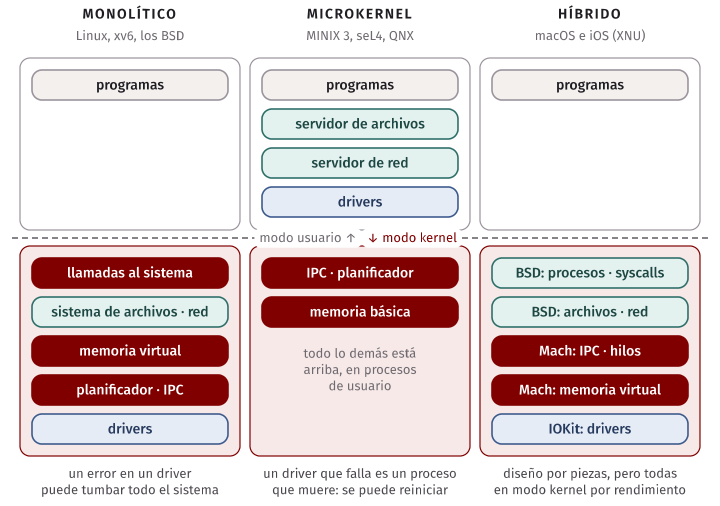
Hasta aquí hablamos de “el kernel” como si fuera una sola pieza. Si lo es o no depende del diseño. La pregunta de fondo es qué código corre en modo kernel, con todos los privilegios del procesador, y qué código corre como un programa más, en modo usuario. Hay que trazar esa línea en algún lugar, y cada familia de sistemas operativos la traza en un sitio distinto.
Monolítico: todo adentro
En un kernel monolítico (monolithic kernel), todo el sistema operativo (llamadas al sistema, planificador, memoria virtual, sistemas de archivos, red y drivers) se compila y se enlaza en un solo programa que corre en modo kernel, en un solo espacio de direcciones. Cuando el sistema de archivos necesita un bloque del disco, llama a una función del driver, igual que una función de su programa en C llama a otra. Es simple y es rápido.
El precio es que adentro no hay paredes. Un puntero mal usado en el driver de una cámara web puede escribir encima de la lista de procesos, y entonces cae el sistema entero, no solo la cámara. Además, todo ese código tiene privilegios totales, y en Linux son decenas de millones de líneas, la mayoría drivers. Linux y los BSD son monolíticos. xv6 también.
En xv6. El
Makefilede xv6 lista enOBJSlos 27 archivos objeto del kernel (kernel/proc.o,kernel/fs.o,kernel/virtio_disk.o, …) y la regla$K/kernellos enlaza en un único ejecutable,kernel/kernel. Todo el camino de unread()está ahí adentro. Dentro del contenedor, en su clon de xv6:$ make kernel/kernel ... $ riscv64-linux-gnu-nm kernel/kernel | grep -wE 'sys_read|fileread|readi|bread|virtio_disk_rw' 0000000080002b66 T bread 000000008000424c T fileread 000000008000360a T readi 0000000080004d62 T sys_read 00000000800058d8 T virtio_disk_rw
nmlista los símbolos de un ejecutable con su dirección (las direcciones exactas pueden variar con la versión de xv6). Las cinco funciones son las capas que atraviesa una lectura: la llamada al sistema (kernel/sysfile.c), los archivos abiertos (kernel/file.c), los inodos (kernel/fs.c), la caché de bloques (kernel/bio.c) y el driver del disco (kernel/virtio_disk.c). Todas viven en el mismo espacio de direcciones, cerca de0x80000000, y pasar de una a otra es una llamada a función común.
Por capas
Una forma de poner orden dentro de un kernel grande es apilarlo en capas: cada capa usa solo los servicios de las capas de abajo. El primer sistema construido así fue THE, de Edsger Dijkstra y sus estudiantes en Eindhoven (1968): la capa más baja repartía el procesador entre procesos, la siguiente administraba la memoria, y los programas de usuario estaban casi arriba de todo. La ventaja es que cada capa se puede probar sobre las de abajo, que ya funcionan. El problema es decidir el orden: el driver del disco necesita memoria para sus buffers, pero el administrador de memoria necesita el disco para el swap, así que ¿cuál va abajo? Y en THE las capas eran una disciplina de diseño: al final todo se enlazaba en un solo programa, sin paredes entre capas.
Microkernel: lo mínimo adentro
Un microkernel le da la vuelta a la pregunta: ¿qué es lo mínimo que tiene que correr en modo kernel? Casi siempre: cambiar de proceso, armar los espacios de direcciones, atender las interrupciones y entregar mensajes entre procesos (comunicación entre procesos, interprocess communication, IPC). Todo lo demás, el sistema de archivos, la red y los drivers, corre como procesos de usuario llamados servidores, cada uno en su propio espacio de direcciones. Para leer un archivo, un programa no llama al sistema de archivos: le envía un mensaje al servidor de archivos y espera la respuesta.
Eso compra dos cosas:
- Aislamiento. Si el driver de la cámara tiene un puntero mal usado, solo puede dañar su propia memoria: el proceso muere y el resto sigue. MINIX 3 vigila a sus drivers y reinicia automáticamente el que se cae.
- Un kernel tan pequeño que se puede verificar. seL4 tiene del orden de diez mil líneas de C, y en 2009 fue el primer kernel de propósito general con una prueba matemática, revisada por computadora, de que su código hace exactamente lo que dice su especificación. Con decenas de millones de líneas, eso es impensable.
Por eso se eligen cuando que el sistema no se caiga vale más que unos microsegundos: QNX corre en el software de muchos autos, y seL4 se ha usado en helicópteros y drones experimentales. Y desde mediados de la década de 2010, el Management Engine de Intel, un pequeño procesador escondido dentro del chip, corre MINIX 3.
El costo está en los mensajes. Sigamos un read() que tiene que ir al disco:
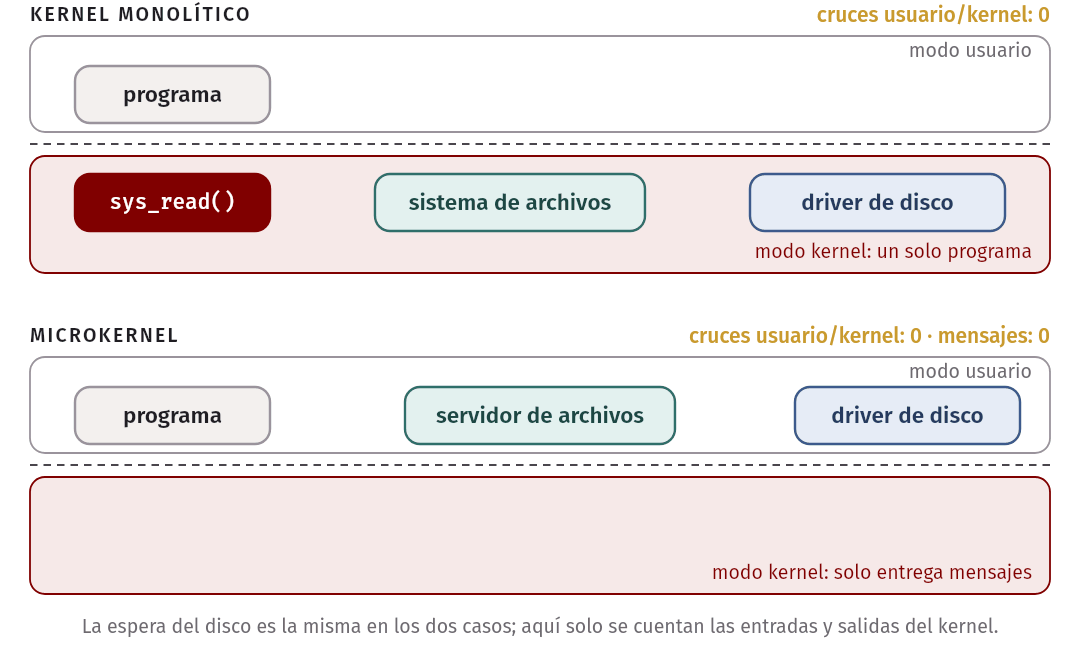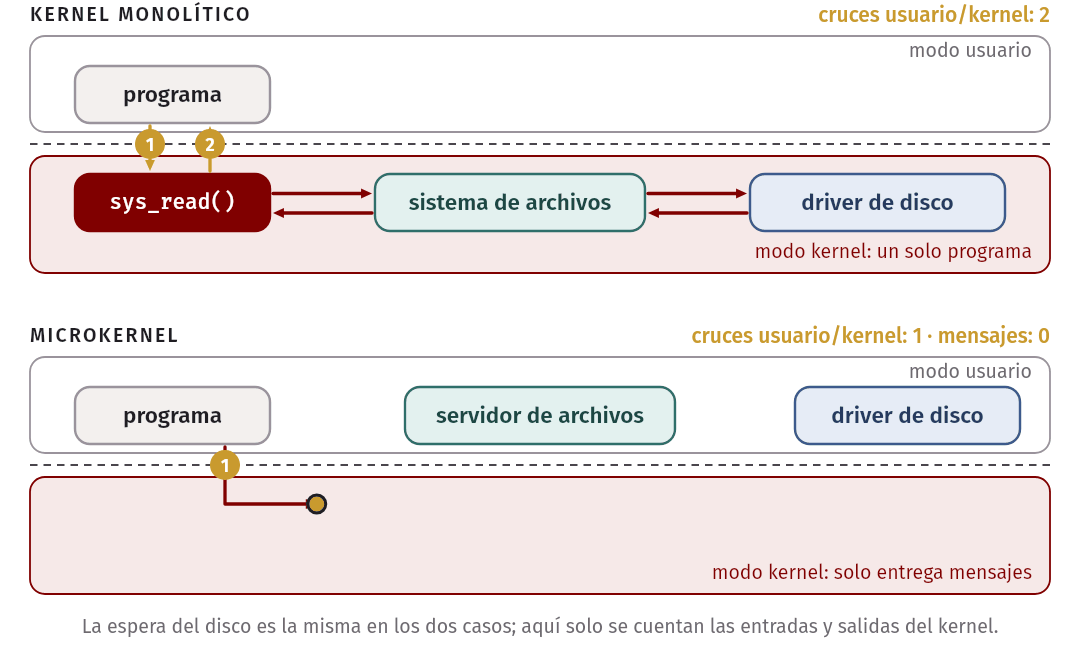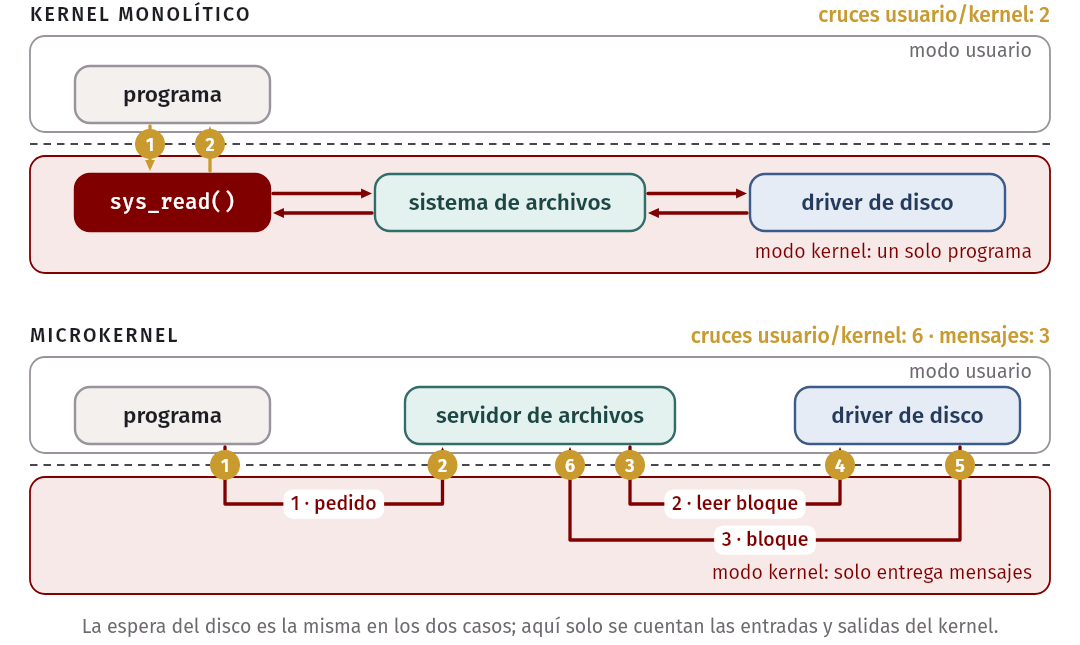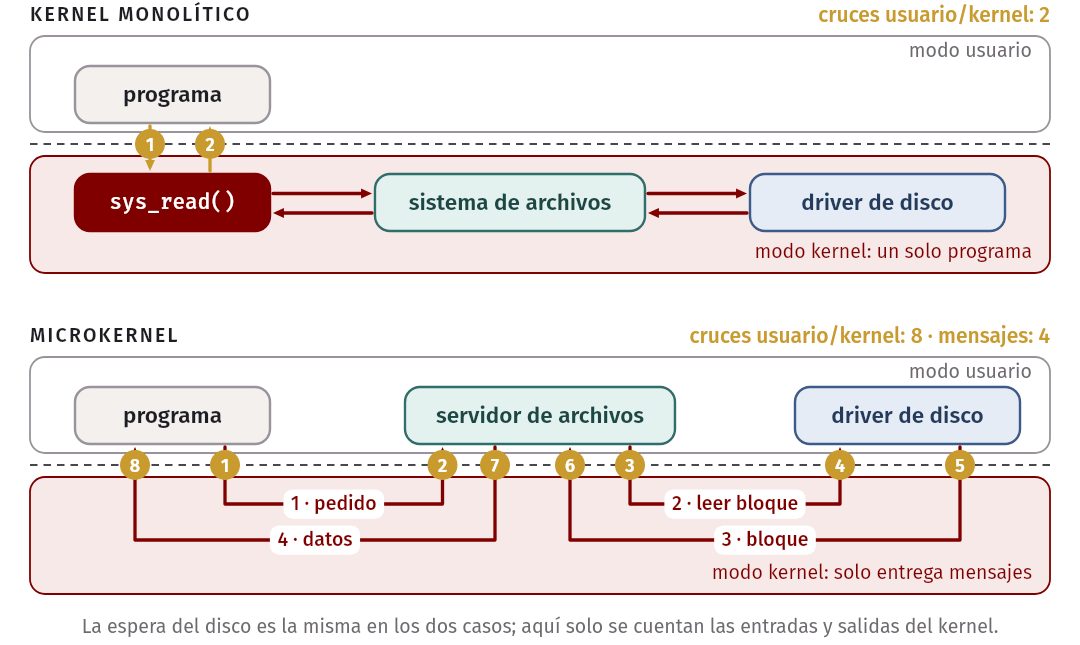
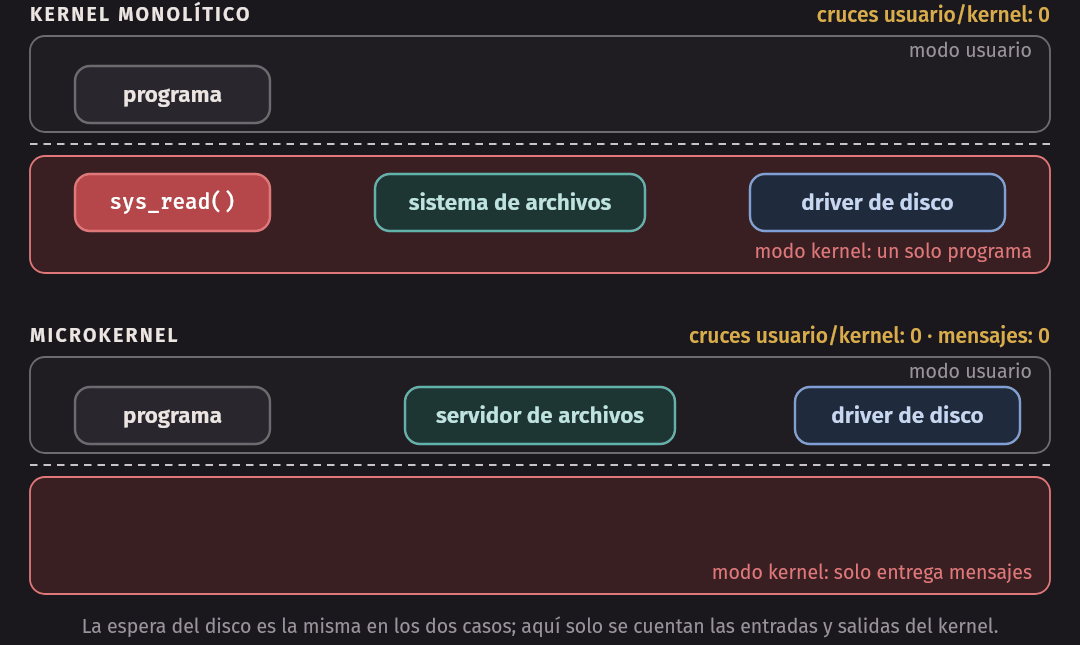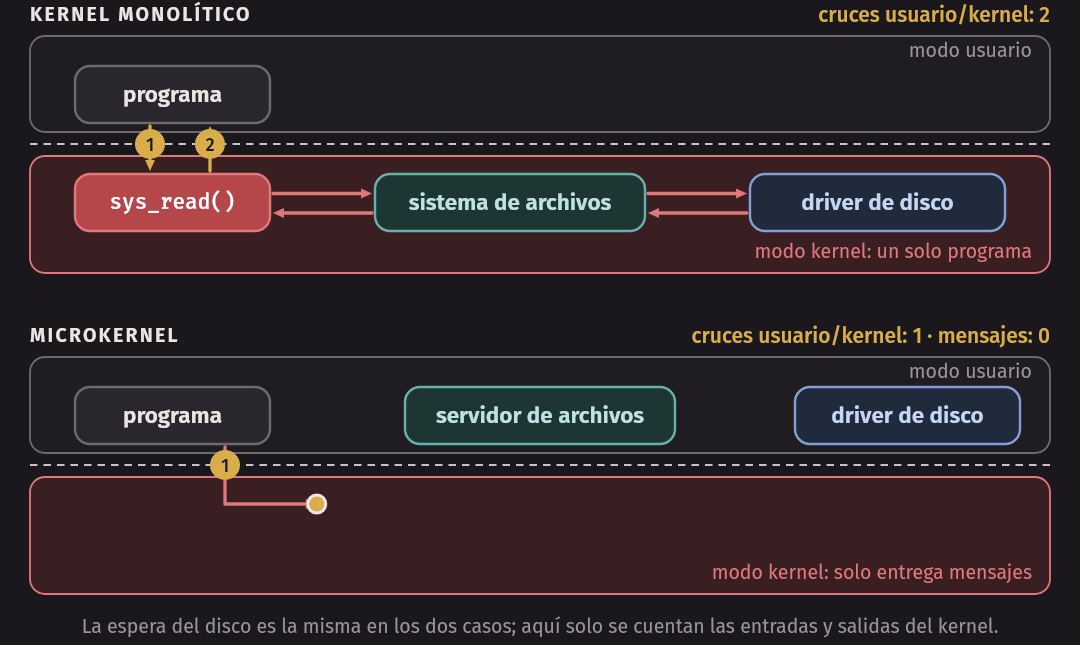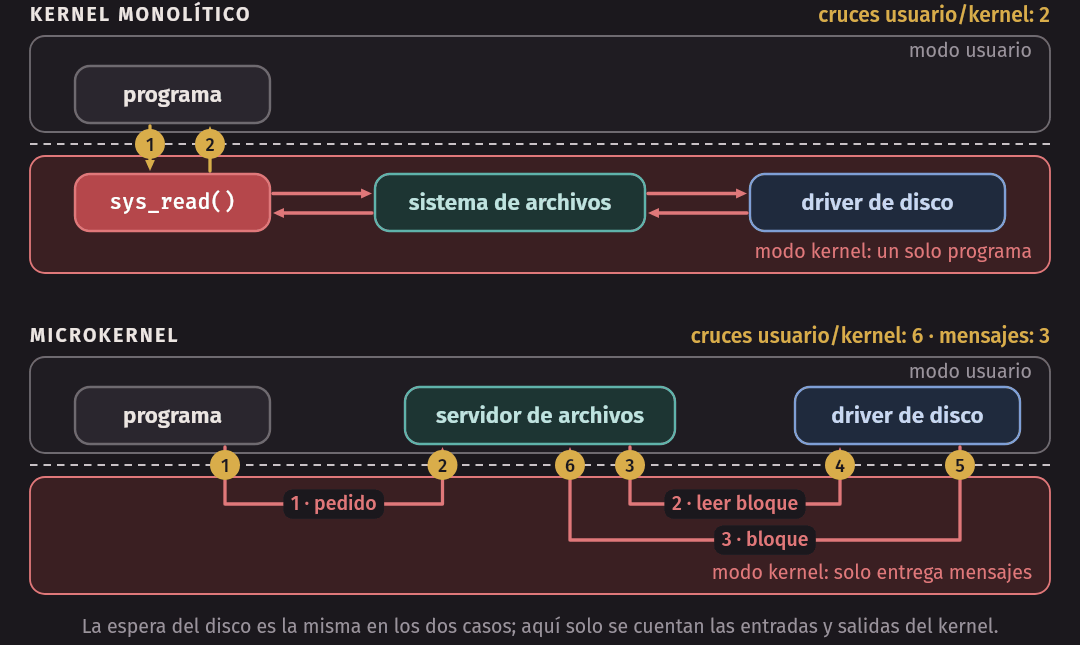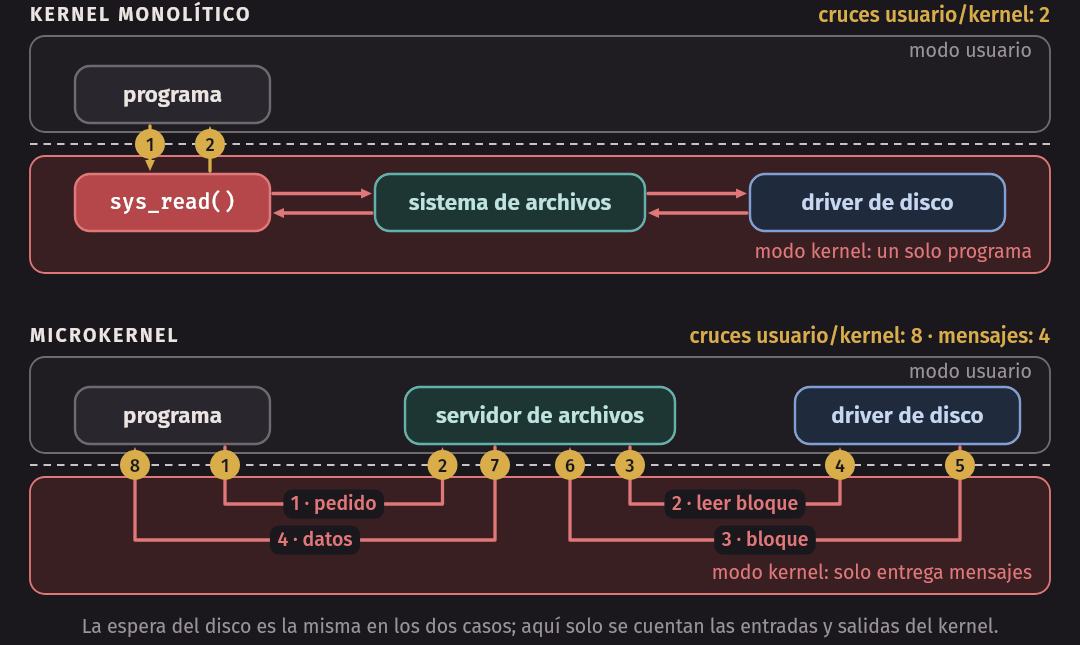
En el monolítico hay 2 cruces entre modo usuario y modo kernel: entrar y salir. En el microkernel hay 4 mensajes y 8 cruces, y algo peor: cada mensaje termina en otro proceso, así que cada uno es también un cambio de espacio de direcciones, y la caché del procesador, llena de datos del proceso anterior, le sirve poco al siguiente. En MINIX el driver, además, le pide al kernel que escriba en los registros del dispositivo por él, lo que agrega más cruces que la figura no cuenta. La semana 2 veremos qué pasa exactamente en cada cruce.
Ejemplo resuelto: ¿cuánto cuesta la estructura?
Supongamos costos redondos (no son mediciones; la semana 2 ustedes medirán los de su máquina):
- Una llamada al sistema simple, entrar y salir del kernel: 0,1 µs.
- Un mensaje entre procesos (entrar al kernel, cambiar de espacio de direcciones y salir en el otro proceso): 1 µs.
En el read() de la figura, el monolítico paga una llamada al sistema y el
microkernel paga 4 mensajes:
| Monolítico | Microkernel | Diferencia | |
|---|---|---|---|
| Costo de la estructura | 0,1 µs | 4 × 1 = 4 µs | 3,9 µs |
| Con un SSD (80 µs de lectura) | 80,1 µs | 84 µs | 4,9 % más lento |
| Con un disco duro (5 ms) | 5000,1 µs | 5004 µs | 0,08 % más lento |
Cuando el dispositivo es lento, la estructura casi no se nota. El problema aparece en las operaciones cortas, que son la mayoría: si el trabajo útil dura pocos microsegundos, 4 µs de mensajes pueden duplicar o triplicar el tiempo. Por eso la historia de los microkernels es la historia de hacer el IPC más barato. Mach, el microkernel de los años 80, tenía mensajes lentos, y le dio mala fama a toda la idea; L4, a comienzos de los 90, mostró que un IPC diseñado con cuidado puede ser mucho más rápido, y seL4 desciende de él.
El término medio: módulos y kernels híbridos
Linux es monolítico, pero no hay que recompilarlo para agregar un driver: los
módulos cargables (loadable kernel modules) son archivos .ko que se
cargan en el kernel mientras está corriendo (modprobe) y se listan con
lsmod o en /proc/modules. Así una distribución trae miles de drivers y
carga solo los del hardware que encuentra. Pero ojo: un módulo cargado corre
en modo kernel, en el mismo espacio de direcciones que el resto. Da
flexibilidad, no aislamiento: un error en un módulo sigue tumbando todo.
Los kernels híbridos toman la estructura de un microkernel pero ponen las piezas en modo kernel para no pagar los mensajes. XNU, el kernel de macOS y de iOS, junta el microkernel Mach, una capa de BSD (procesos, archivos, red, llamadas al sistema POSIX) y los drivers de IOKit en un solo espacio de direcciones. Windows NT nació con ideas de microkernel, con subsistemas en modo usuario, y con los años fue pasando partes al kernel por rendimiento: en NT 4.0 (1996), el manejo de ventanas y gráficos entró al kernel.
Dos extremos más, en una línea cada uno. Un exokernel (MIT, 1995; uno de sus autores, Frans Kaashoek, también es autor de xv6) solo reparte el hardware de forma segura y deja las abstracciones, como archivos o memoria virtual, a bibliotecas dentro de cada programa. Un unikernel compila una sola aplicación junto con justo el código de sistema operativo que necesita, en una imagen que corre directamente sobre un hipervisor; lo retomaremos al ver máquinas virtuales.
Tanenbaum contra Torvalds
En enero de 1992, pocos meses después de que apareciera Linux, Andrew
Tanenbaum, profesor en Ámsterdam y autor de MINIX (el sistema sobre el que
Torvalds había aprendido y desarrollado Linux), publicó en el grupo de noticias
comp.os.minix un mensaje titulado “LINUX is obsolete”. Su argumento: un
kernel monolítico en 1991 era un paso atrás, porque el futuro eran los
microkernels; y además Linux estaba atado al procesador 386. Torvalds
respondió de inmediato, defendiendo que Linux funcionaba bien y ya era útil, y
siguió una discusión larga y famosa en la que participó mucha gente. Más de
treinta años después, los dos tenían parte de razón: Linux, monolítico, corre
en casi todos los servidores y celulares; los microkernels ganaron donde la
confiabilidad pesa más que unos microsegundos, y sus ideas (drivers fuera del
kernel, kernels pequeños y verificables) siguen avanzando.
Idea clave. La estructura de un kernel es otro compromiso: el monolítico gana en rendimiento y simplicidad; el microkernel, en aislamiento y en que se puede verificar. El precio del microkernel se paga en mensajes, y lo que importa es cuánto cuesta un mensaje frente al trabajo útil.
La abstracción de proceso
Programa y proceso
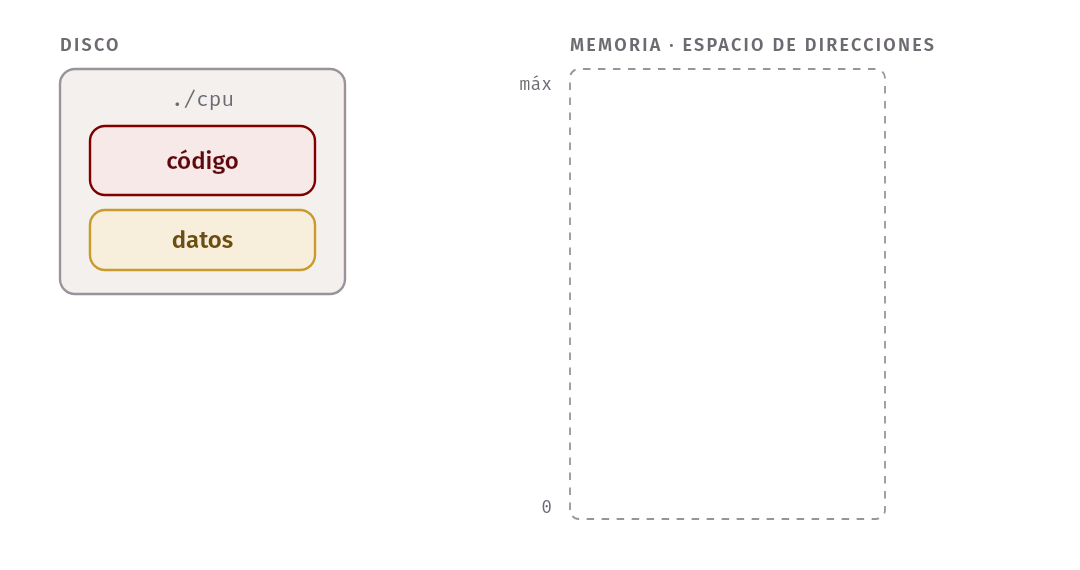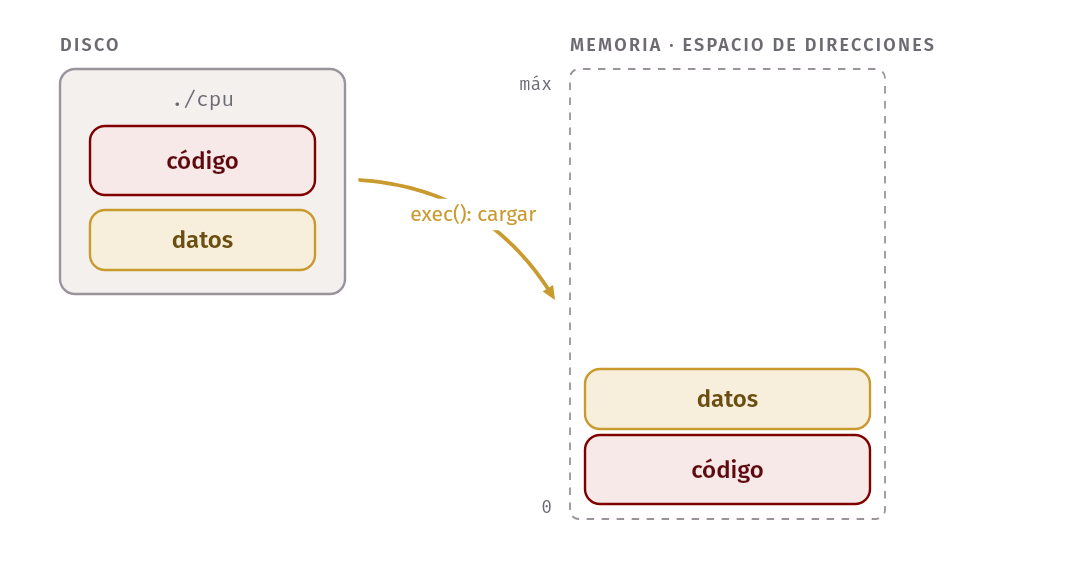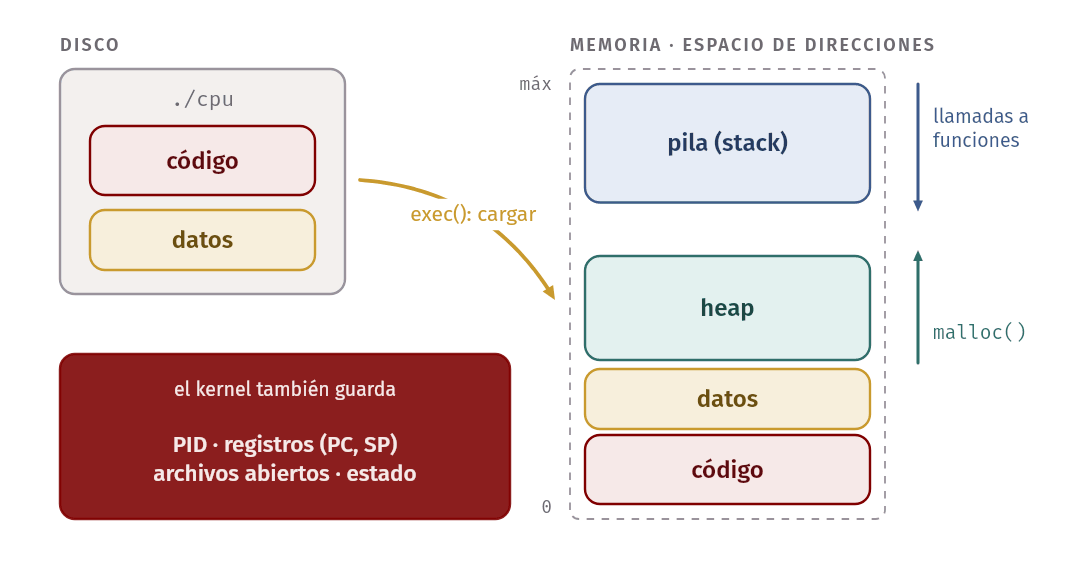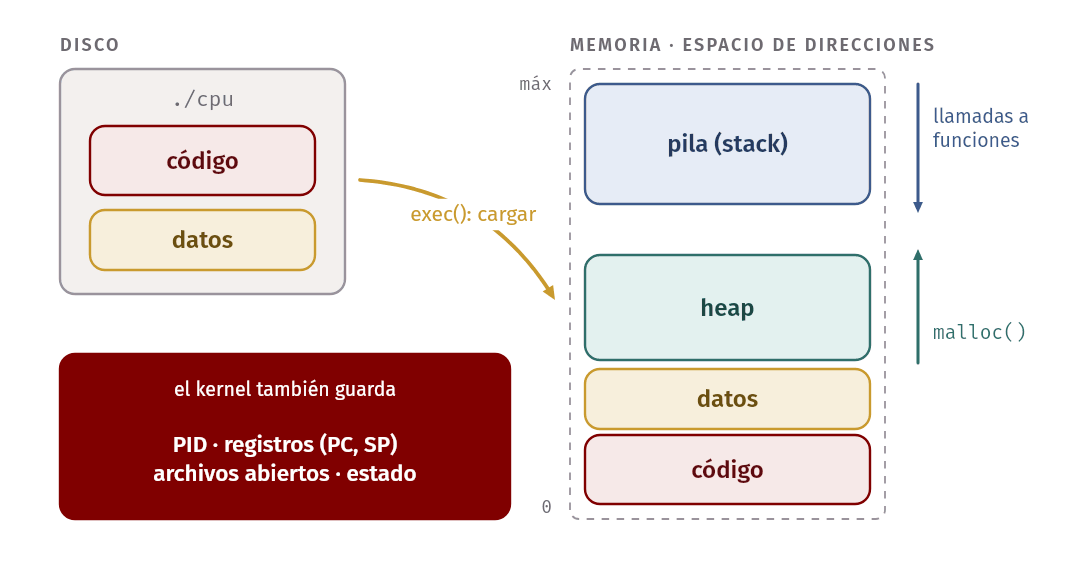
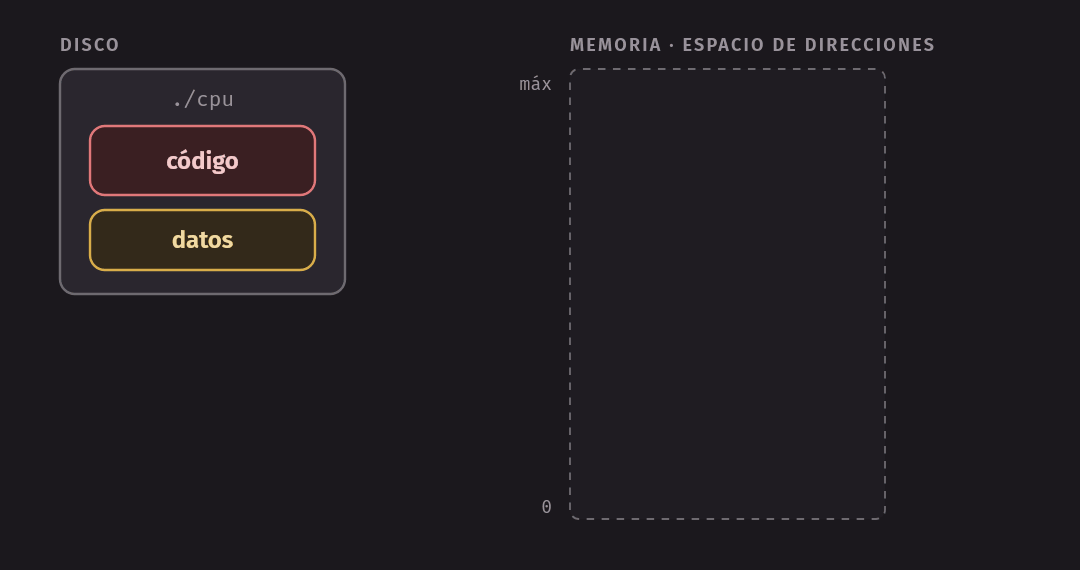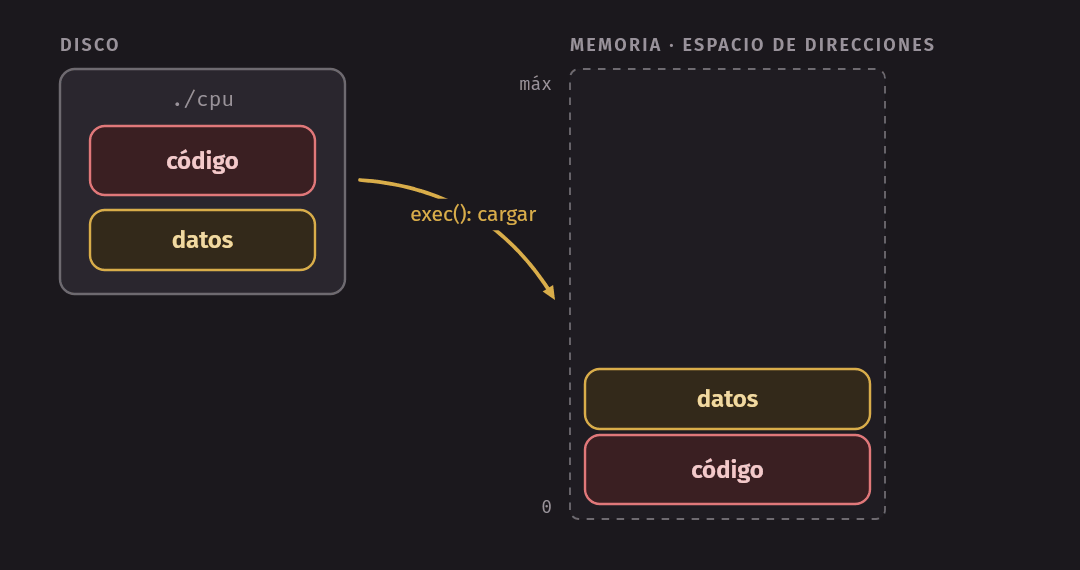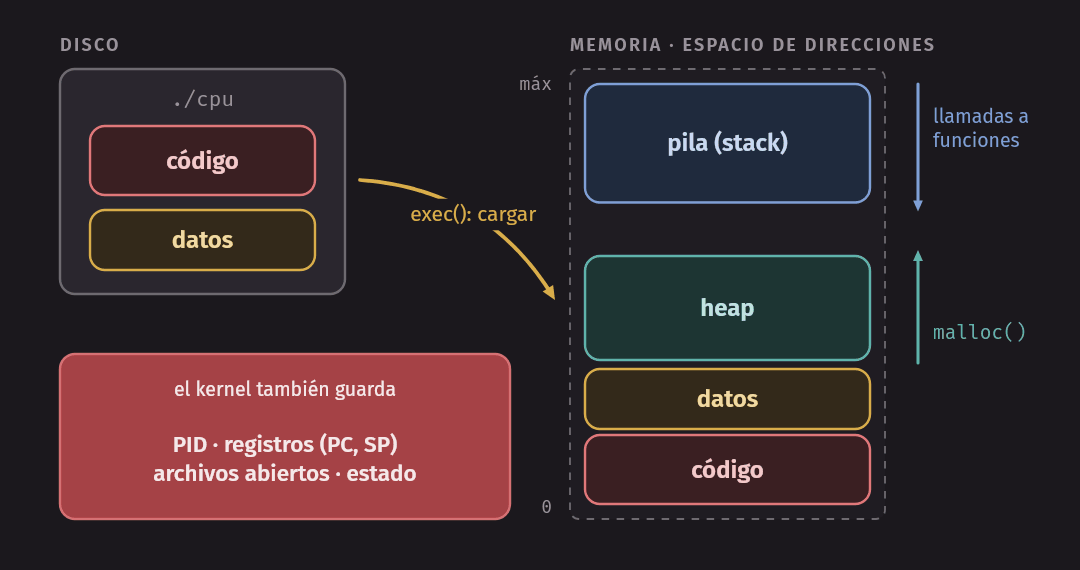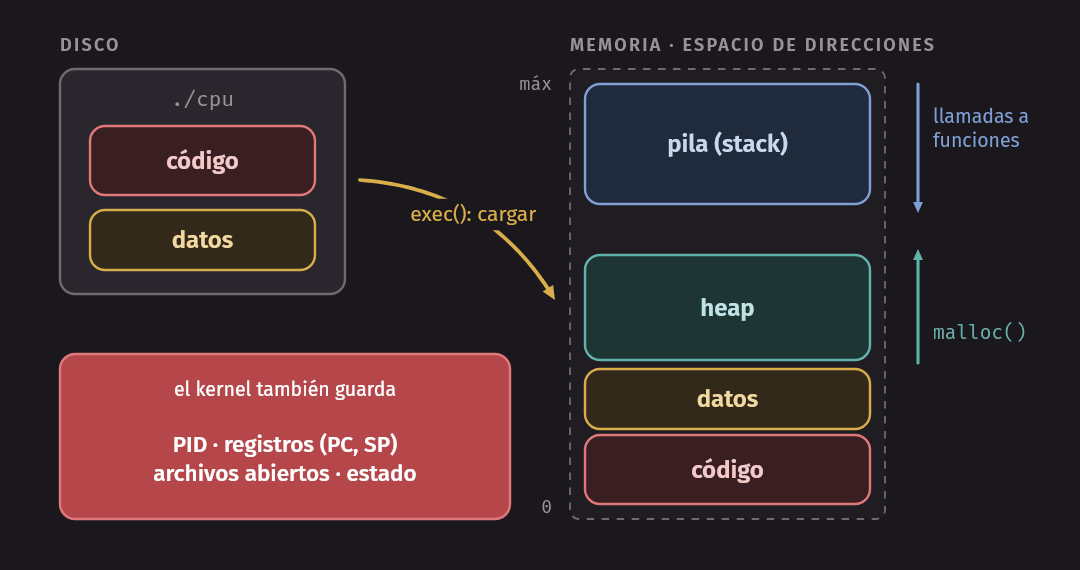
Un programa es un archivo: instrucciones y datos estáticos guardados en el disco, inertes. Un proceso es un programa en ejecución. Para pasar de uno a otro, el sistema operativo carga el programa en memoria y le prepara todo lo que necesita para correr.
¿Qué forma parte de un proceso? Todo aquello que el programa puede leer o modificar mientras corre, su estado de máquina:
- Memoria: su espacio de direcciones, con el código, los datos estáticos,
el heap (memoria dinámica de
malloc) y la pila (stack) con las variables locales y las direcciones de retorno. - Registros: los registros de propósito general y, sobre todo, el contador de programa (program counter, PC), que dice qué instrucción sigue, y el puntero de pila (stack pointer, SP).
- Recursos de E/S: por ejemplo, la lista de archivos abiertos.
Además, el kernel guarda datos propios sobre cada proceso: su identificador (PID), su estado, quién es su padre.
Crear un proceso, paso a paso
Para ejecutar un programa, el sistema operativo:
- Carga el código y los datos estáticos desde el ejecutable a la memoria del proceso. Los primeros sistemas cargaban todo antes de empezar; los modernos lo hacen perezosamente (lazily): solo cargan cada parte cuando el programa la usa. Para entender cómo, necesitamos paginación y swapping (semanas 6 a 8).
- Reserva la pila y la inicializa con los argumentos de
main:argcy el arregloargv. - Prepara el heap, al principio pequeño, del que
mallocirá pidiendo memoria. - Abre tres descriptores de archivo (file descriptors): 0 para la entrada estándar, 1 para la salida estándar y 2 para el error estándar. Así el programa puede leer del teclado y escribir en la pantalla sin abrir nada.
- Salta a
main: carga el PC con el punto de entrada del programa y le cede la CPU.
La API de procesos
Cualquier sistema operativo ofrece, con uno u otro nombre, estas operaciones sobre procesos:
| Operación | Qué hace |
|---|---|
| Crear | Ejecutar un programa nuevo |
| Destruir | Terminar un proceso que no termina solo |
| Esperar | Bloquearse hasta que otro proceso termine |
| Controlar | Suspenderlo y reanudarlo |
| Consultar | Saber su estado, cuánto tiempo de CPU usó, etc. |
En Unix estas operaciones son fork, exec, wait, kill y compañía, y son
el tema de la semana 2.
Estados de un proceso
Un proceso no está siempre usando la CPU. En el modelo más simple puede estar en uno de tres estados:
- Ejecutando (running): está corriendo en un procesador ahora mismo.
- Listo (ready): podría correr, pero el sistema operativo eligió otro.
- Bloqueado (blocked): está esperando algo, por ejemplo que termine una lectura del disco, y no puede avanzar hasta que eso ocurra.
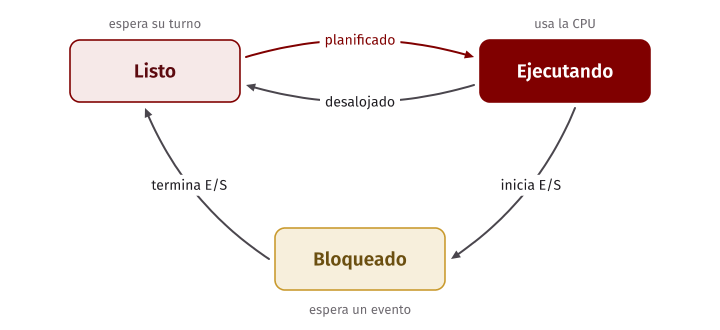
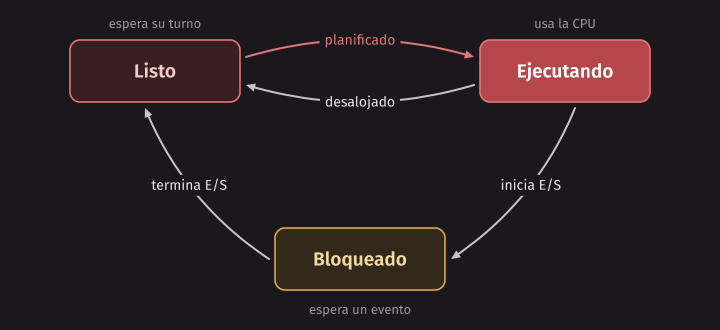
Las transiciones son las que importan. Pasar de listo a ejecutando es ser planificado (scheduled); de ejecutando a listo, ser desalojado (descheduled). Las dos decisiones las toma el sistema operativo. Un proceso que inicia una operación de E/S pasa a bloqueado, y cuando la E/S termina vuelve a listo, no directamente a ejecutando: tiene que esperar su turno.
Además existen estados de inicio y fin. Un proceso recién creado está en un estado inicial mientras se prepara. Uno que ya terminó pero cuyo padre todavía no recogió su resultado queda en un estado final, que en Unix se llama zombi (zombie).
Una traza con E/S
Supongamos dos procesos. P0 ejecuta tres instrucciones y luego inicia una lectura de disco que tarda tres unidades de tiempo. P1 solo usa la CPU. Si el sistema operativo aprovecha la espera:
| Tiempo | Proceso 0 | Proceso 1 | Nota |
|---|---|---|---|
| 1 | Ejecutando | Listo | |
| 2 | Ejecutando | Listo | |
| 3 | Ejecutando | Listo | P0 inicia una lectura de disco |
| 4 | Bloqueado | Ejecutando | P0 espera; P1 aprovecha la CPU |
| 5 | Bloqueado | Ejecutando | |
| 6 | Listo | Ejecutando | Termina la E/S de P0 |
| 7 | Listo | Ejecutando | P1 termina |
| 8 | Ejecutando | --- |
La CPU está ocupada los 8 instantes. Si en cambio el sistema operativo esperara a que P0 termine antes de ejecutar P1, la CPU estaría desocupada en los instantes 4, 5 y 6, y todo tomaría 11 unidades. Esa es la idea de la multiprogramación, ahora en números.
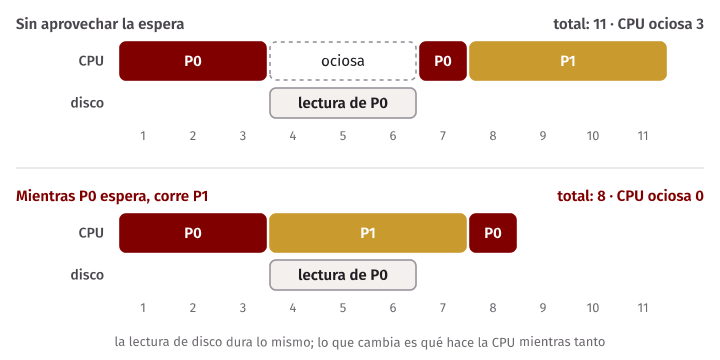
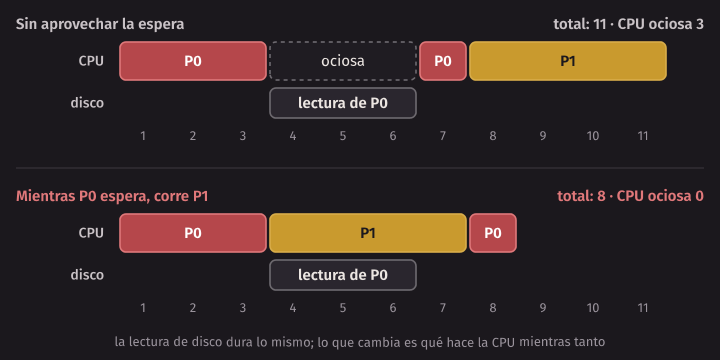
La tabla deja una decisión abierta: en el instante 6, cuando P0 vuelve a estar
listo, ¿hay que darle la CPU de inmediato o dejar que P1 termine? Esa es una
decisión del planificador (scheduler), y la estudiaremos en las semanas 3 y
4. En el laboratorio pueden experimentar con estas trazas usando el simulador
process-run.py de OSTEP.
Las estructuras del kernel
Para administrar todo esto, el kernel guarda, por cada proceso, una estructura con su estado. Tradicionalmente se llama bloque de control de proceso (process control block, PCB). Todos los PCB juntos forman la lista de procesos (process list). Cuando un proceso deja de ejecutar, sus registros se guardan en su PCB; cuando vuelve a ejecutar, se cargan desde ahí. Esa operación es el cambio de contexto (context switch).
En xv6. El PCB de xv6-riscv es
struct proc, enkernel/proc.h:enum procstate { UNUSED, USED, SLEEPING, RUNNABLE, RUNNING, ZOMBIE }; struct proc { struct spinlock lock; enum procstate state; // Process state void *chan; // If non-zero, sleeping on chan int killed; // If non-zero, have been killed int xstate; // Exit status to be returned to parent's wait int pid; // Process ID struct proc *parent; // Parent process uint64 kstack; // Virtual address of kernel stack uint64 sz; // Size of process memory (bytes) pagetable_t pagetable; // User page table struct trapframe *trapframe; // data page for trampoline.S struct context context; // swtch() here to run process struct file *ofile[NOFILE]; // Open files struct inode *cwd; // Current directory char name[16]; // Process name (debugging) };La lista de procesos es un arreglo fijo,
struct proc proc[NPROC]enkernel/proc.c, conNPROCigual a 64 (kernel/param.h). Los estados se corresponden con los del modelo:RUNNABLEes listo,RUNNINGes ejecutando ySLEEPINGes bloqueado.UNUSEDmarca una entrada libre del arreglo;USEDes el estado inicial, el que poneallocproc()mientras prepara un proceso nuevo;ZOMBIEes el estado final. La memoria está descrita porpagetableysz, los archivos abiertos porofileycwd, y los registros se guardan en dos lugares:trapframe(los registros del programa de usuario) ycontext(los del kernel, para el cambio de contexto). La semana 2 veremos para qué sirve cada uno.
Mecanismo y política
Para virtualizar la CPU, el sistema operativo necesita dos cosas distintas:
- Un mecanismo (mechanism): cómo se hace algo. Por ejemplo, el cambio de contexto, que guarda los registros de un proceso y carga los de otro. Es código de bajo nivel que responde a “¿cómo se hace?”.
- Una política (policy): qué decisión tomar. Por ejemplo, a qué proceso darle la CPU ahora, considerando cuánto tiempo lleva esperando, si es interactivo o si tiene prioridad. Responde a “¿cuál?”.
Separarlos es un principio de diseño que veremos todo el semestre. El mismo
mecanismo sirve para muchas políticas: se puede cambiar el planificador sin
tocar el código del cambio de contexto. En xv6, el cambio de contexto vive en
swtch() (kernel/swtch.S) y la política en la función scheduler()
(kernel/proc.c), que hoy simplemente recorre el arreglo de procesos y elige
el siguiente RUNNABLE. En el proyecto P2 van a cambiar esa política por una
lotería sin tocar swtch().
Resumen
- El sistema operativo virtualiza recursos físicos, los administra entre programas y ofrece una interfaz de llamadas al sistema.
- El curso tiene tres piezas: virtualización, concurrencia y persistencia. Las
demostraciones
cpu,mem,threadseiomuestran una cada una. - Las metas de diseño (abstracción, rendimiento, protección, confiabilidad, energía, seguridad) chocan entre sí; diseñar es elegir compromisos.
- Lotes, multiprogramación, tiempo compartido, Unix, PCs y Linux: cada etapa agregó ideas que siguen en los sistemas de hoy.
- Un kernel monolítico (Linux, xv6) pone todo el sistema operativo en modo kernel, en un solo espacio de direcciones; un microkernel (MINIX 3, seL4, QNX) deja adentro solo lo mínimo y corre archivos, red y drivers como procesos de usuario que se hablan por mensajes.
- El microkernel gana aislamiento y un kernel verificable, y paga en IPC: un
read()que va al disco son 2 cruces usuario/kernel en el monolítico y 8 (4 mensajes) en el microkernel. Los módulos de Linux y los kernels híbridos (XNU, Windows NT) son términos medios. - Un proceso es un programa en ejecución: espacio de direcciones, registros y recursos abiertos. Está listo, ejecutando o bloqueado.
- El kernel guarda cada proceso en un PCB; en xv6 es
struct proc, dentro del arregloproc[NPROC]. - Mecanismo (cómo) y política (qué) se diseñan por separado.
Ejercicios
- ¿Qué significa que el sistema operativo “virtualiza” la CPU? ¿Qué ilusión le
da a cada programa? Respondan usando la salida de
./cpu A & ./cpu B &. - Ejecuten
./threadscon 1000, 10000, 100000 y 1000000 ciclos, tres veces cada uno. Anoten los resultados. ¿Desde qué valor empiezan a perderse sumas? ¿Por qué con pocos ciclos casi nunca pasa? - Ejecuten dos copias de
memsinsetarch -R. ¿Qué cambia en la salida? ¿Se rompe la conclusión de la demostración? - Comenten la línea
fsync(fd)deio.c. ¿Cambia algo que puedan observar? ¿En qué situación sí haría diferencia? - Repitan la traza de la sección “Una traza con E/S” suponiendo que P1 también hace una E/S de 3 unidades después de su segunda instrucción. ¿Cuántas unidades de tiempo toma todo? ¿Cuántas está la CPU desocupada?
- Con el simulador
process-run.py, ejecuten./process-run.py -l 3:0,5:100,5:100,5:100 -S SWITCH_ON_IO -I IO_RUN_LATER -c -py luego lo mismo con-I IO_RUN_IMMEDIATE. El primer proceso hace tres E/S y los otros tres solo usan la CPU. ¿Cuánto tiempo total toma cada opción y qué porcentaje del tiempo está ocupada la CPU? ¿Qué debería hacer el sistema operativo con la CPU cuando un proceso se bloquea, y a quién conviene dársela cuando la E/S termina? - Den un ejemplo de mecanismo y uno de política dentro de un sistema operativo, distintos de los del capítulo.
- Busquen en
kernel/proc.cde xv6 todas las asignaciones ap->state. Para cada una, digan a qué transición del diagrama de estados corresponde. - El driver USB de una cámara web tiene un error y escribe en una dirección equivocada. ¿Qué puede pasar en Linux, en MINIX 3 y en macOS? ¿Cambia algo si en Linux ese driver es un módulo cargable en lugar de estar compilado dentro del kernel?
- Con los costos supuestos del ejemplo resuelto, piensen en un
read()cuyo bloque ya está en la caché del servidor de archivos, así que no hace falta hablar con el driver, y cuyo trabajo útil (buscar en la caché y copiar los datos) toma 2 µs. ¿Cuántos mensajes y cuántos cruces usuario/kernel hay en el microkernel? ¿Cuántas veces más lento es que en el monolítico? Después del laboratorio de la semana 2, rehagan la cuenta con el costo de una llamada al sistema y el de una ida y vuelta por pipe que midan en su máquina (tomen la mitad de la ida y vuelta como costo de un mensaje). - Abran el
Makefilede xv6 y ubiquenOBJSy la regla que producekernel/kernel. Supongan que quieren sacarkernel/virtio_disk.cdel kernel y convertirlo en un proceso de usuario, como en un microkernel. Nombren al menos tres cosas que hoy el driver hace directamente y que, en modo usuario, tendría que pedirle al kernel o recibir de él. - Dentro del contenedor del curso, ejecuten
cat /proc/modules. ¿Cuántos módulos ven? Si tienen Linux instalado en su computadora, comparen conlsmodfuera del contenedor. ¿De qué kernel son los módulos que ve el contenedor? (Pista: ejecutenuname -ren los dos lados.)