
Apuntes · Capítulo 2CPU
Crear, reemplazar y esperar: la API de procesos
Crear, reemplazar y esperar: la API de procesos
En la semana 1 vimos que un proceso es un programa en ejecución: un espacio de
direcciones, un conjunto de registros y los recursos que el sistema operativo
lleva registrados para él. Este capítulo responde a la pregunta práctica que
viene después: ¿cómo se crea un proceso nuevo? En Unix la respuesta son tres
llamadas al sistema (system calls) que conviene estudiar juntas: fork(),
exec() y wait(). Con ellas se construye, entre otras cosas, la shell que
usamos todos los días y que ustedes van a escribir en el proyecto P1.
En la segunda mitad veremos qué pasa por debajo cuando un programa hace una llamada al sistema, y cómo el sistema operativo recupera el control de la CPU aunque un programa no quiera devolverlo: la ejecución directa limitada (limited direct execution).
Ruta de lectura.
- Antes de clase (15–20 min): «Duplicar un proceso:
fork()», «Esperar al hijo:wait()» y «Reemplazar el programa:exec()».- En clase: sesión A, las tres llamadas, «Por qué están separadas: la shell» y «Señales: avisarle algo a un proceso»; sesión B, «Por debajo: ejecución directa limitada».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 5 y 6, y «¿Cuánto cuesta todo esto?».
Lectura. Este capítulo acompaña a OSTEP cap. 5 Interlude: Process API y cap. 6 Mechanism: Limited Direct Execution. Todo el código está en
code/week-02y se compila conmakedentro del contenedor del curso.
Duplicar un proceso: fork()
fork() crea un proceso nuevo que es una copia casi exacta del que la
llamó. El proceso original se llama padre (parent) y el nuevo, hijo (child).
El hijo recibe una copia del espacio de direcciones del padre, de sus registros
y de su tabla de descriptores de archivo. Empieza a ejecutar en el mismo punto:
justo al retornar de fork().
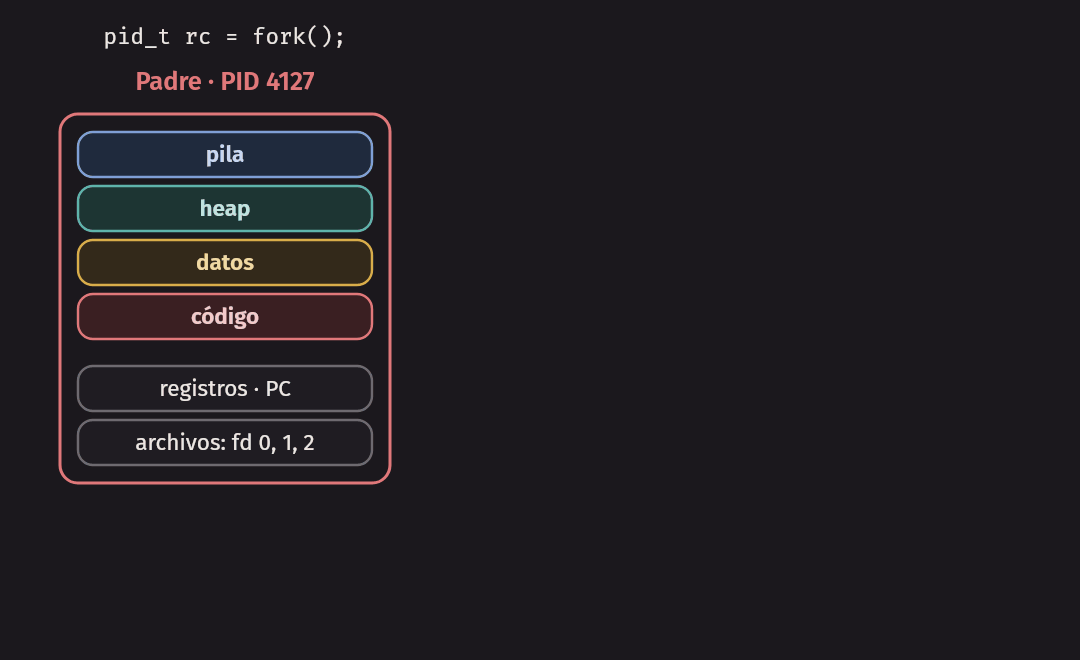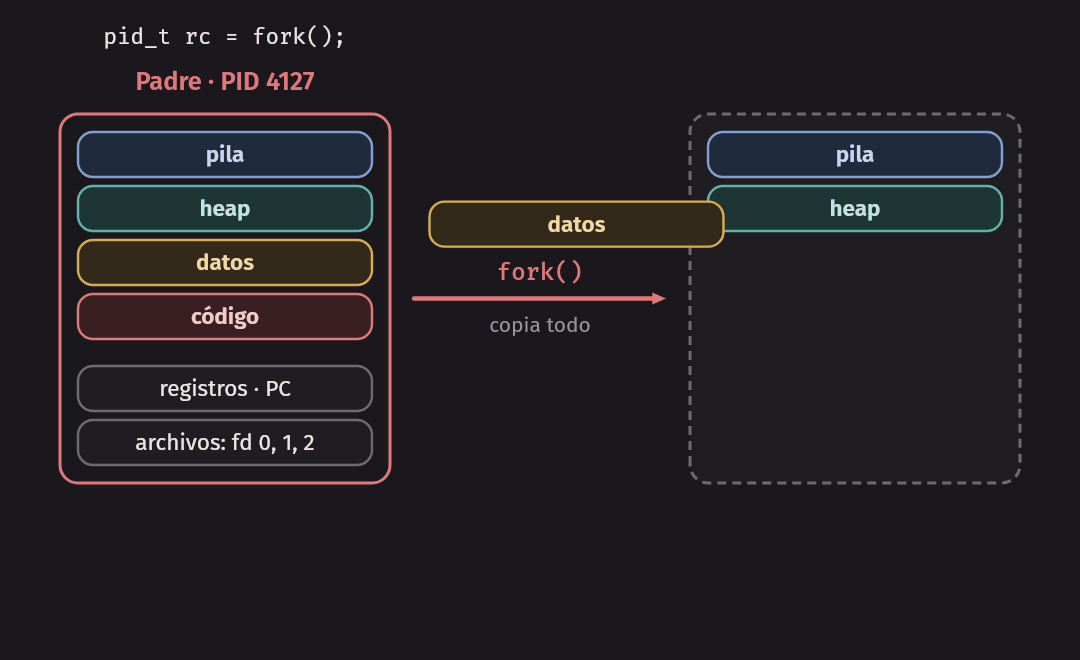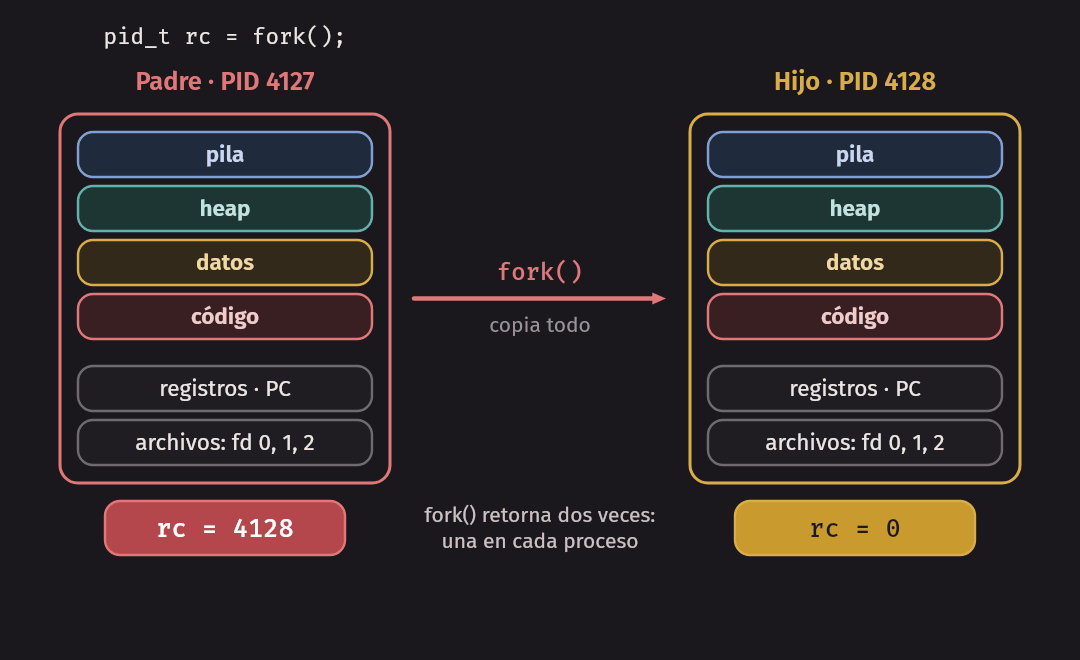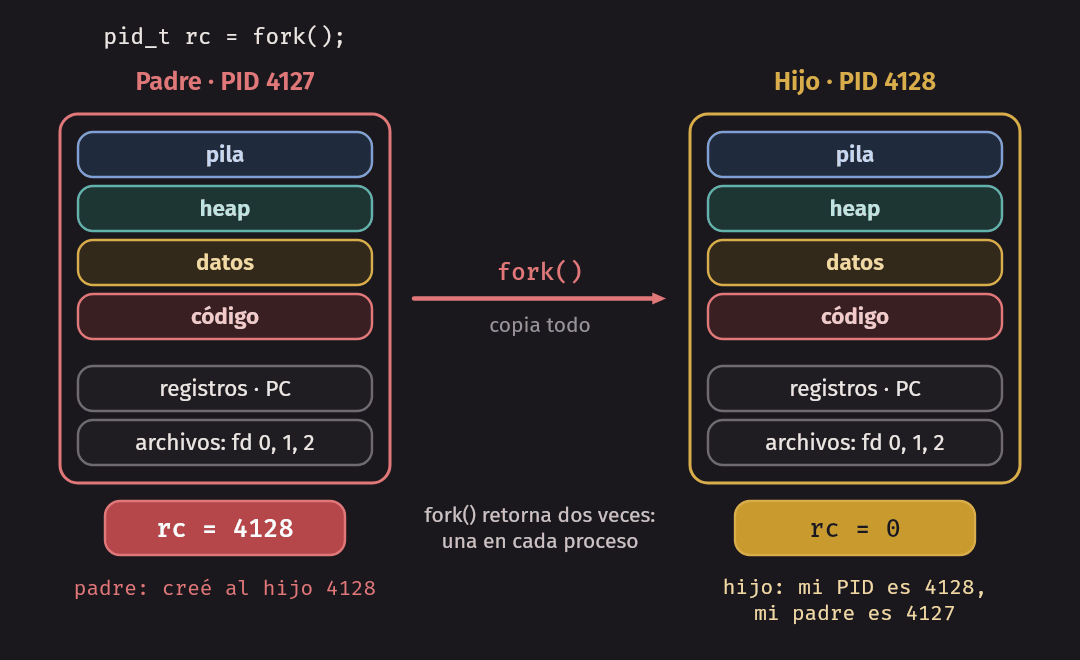
Lo que distingue a uno del otro es el valor de retorno:
| Quién | fork() retorna |
|---|---|
| Padre | El PID del hijo (un número positivo) |
| Hijo | 0 |
| Padre, si falló | -1 (y no se creó ningún hijo) |
pid_t rc = fork();
if (rc < 0) {
    perror("fork");
    exit(1);
} else if (rc == 0) {
    printf("hijo: mi PID es %d, mi padre es %d\n", getpid(), getppid());
} else {
    printf("padre: creé al hijo %d\n", rc);
}
Una forma de recordarlo: fork() se llama una vez y retorna dos veces, una
en cada proceso. Desde ese momento hay dos programas corriendo el mismo código,
cada uno con su propia copia de las variables.
$ ./fork
hola, soy 4127
padre: creé al hijo 4128
hijo: mi PID es 4128, mi padre es 4127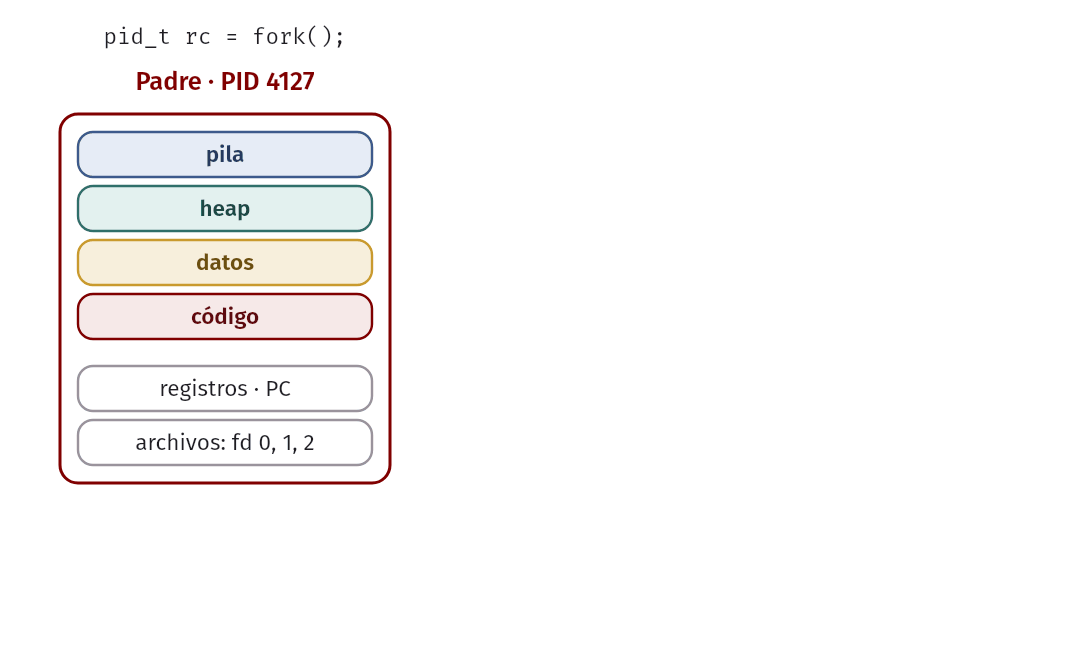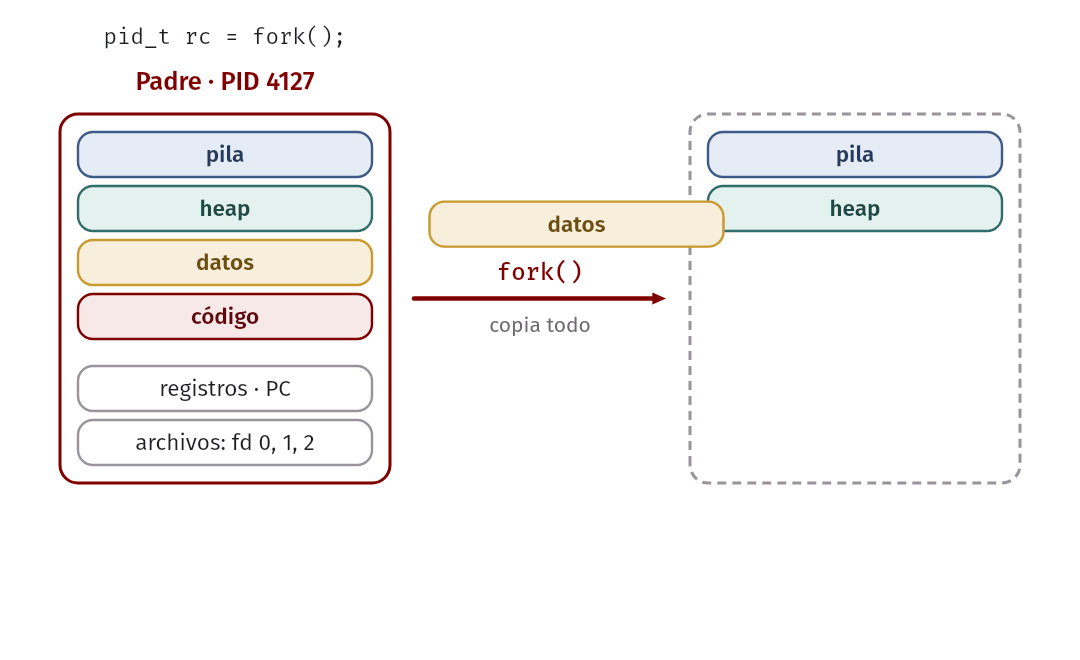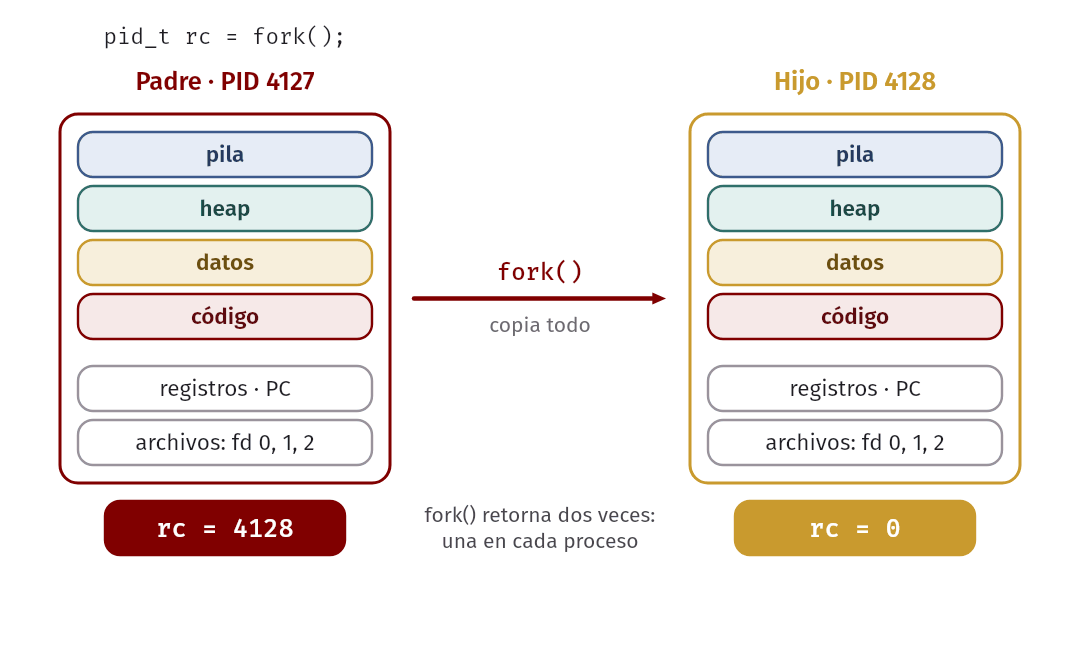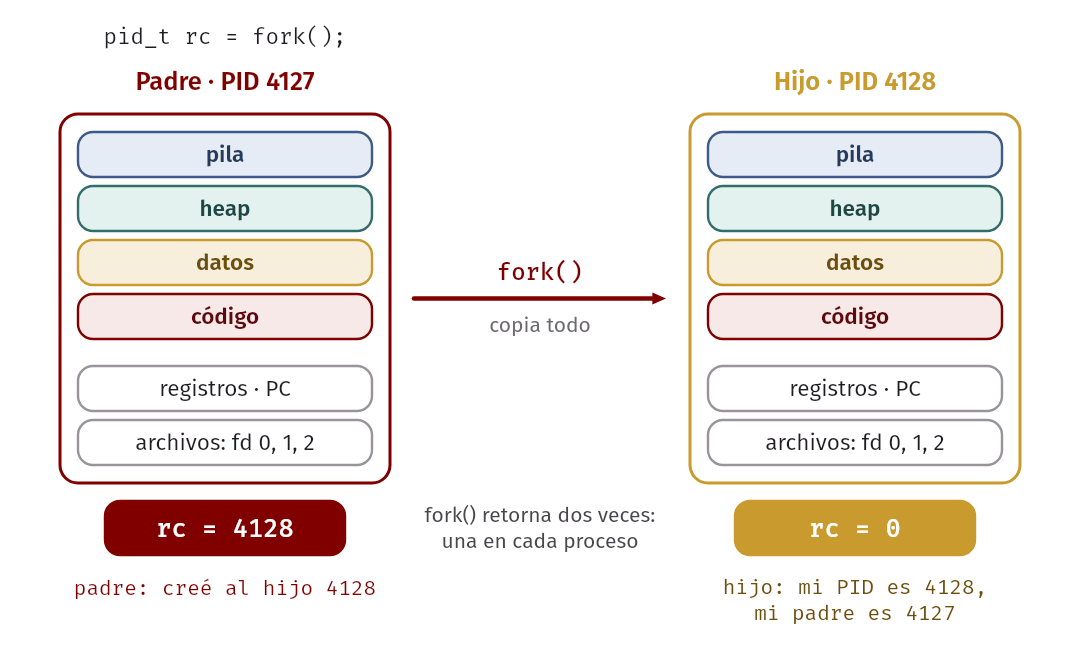
¿Quién imprime primero?
Si ejecutan fork varias veces, a veces aparece primero la línea del padre y a
veces la del hijo. No hay un orden garantizado: después de fork() hay dos
procesos listos para ejecutar y decide el planificador (scheduler). En una
máquina con varios núcleos pueden incluso ejecutar al mismo tiempo. Esta es la
primera vez en el curso que nos encontramos con el no determinismo, y no
será la última: en la parte de concurrencia es el problema central.
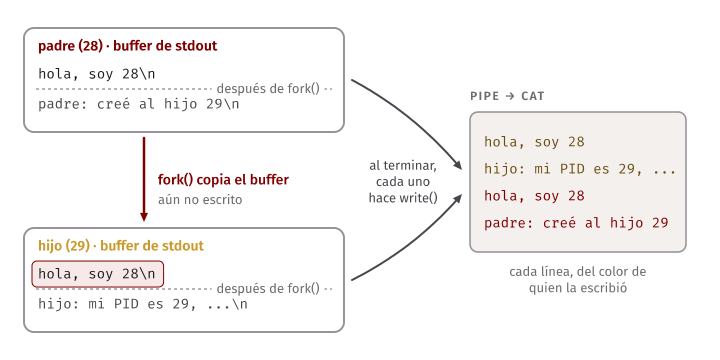
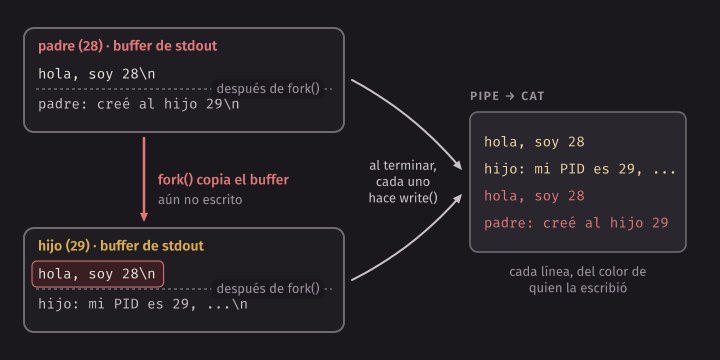
Un misterio: “hola” aparece dos veces
Prueben esto en el contenedor:
$ ./fork | cat
hola, soy 28
hijo: mi PID es 29, mi padre es 28
hola, soy 28
padre: creé al hijo 29
El printf("hola...") está antes del fork(), ¿cómo puede imprimirse dos
veces? La respuesta no está en el kernel sino en la biblioteca de C. printf no
escribe directamente: guarda el texto en un buffer en memoria del
proceso y lo envía con write() más tarde. Cuando la salida es una terminal, el
buffer se vacía en cada salto de línea; cuando es un pipe o un
archivo, se vacía recién cuando se llena o cuando el programa termina.
Con | cat, al momento del fork() el texto hola, soy 28 todavía está en el
buffer. fork() copia toda la memoria del padre, buffer incluido, así que
los dos procesos terminan con el mismo texto pendiente y los dos lo escriben al
salir.
Idea clave.
fork()copia el estado completo del proceso, incluido lo que la biblioteca tiene guardado en memoria y todavía no escribió. Si van a hacerfork(), llamen antes afflush(stdout).
Esperar al hijo: wait()
Muchas veces el padre necesita saber cuándo terminó el hijo, y cómo terminó.
Para eso está wait() (o su versión más flexible, waitpid()): bloquea al
padre hasta que un hijo termine y le entrega su código de salida.
if (rc == 0) {
    printf("hijo %d trabajando...\n", getpid());
    sleep(1);
    exit(42);
}

int status;
pid_t done = waitpid(rc, &status, 0);
if (WIFEXITED(status))
    printf("padre: el hijo %d terminó con código %d\n", done, WEXITSTATUS(status));
Ahora la salida sí es determinista: el padre no imprime hasta que el hijo
termina. status no es directamente el código de salida; contiene varios datos
empaquetados, y se lee con las macros WIFEXITED, WEXITSTATUS,
WIFSIGNALED, etc. (ver man 2 wait).
Zombis y huérfanos
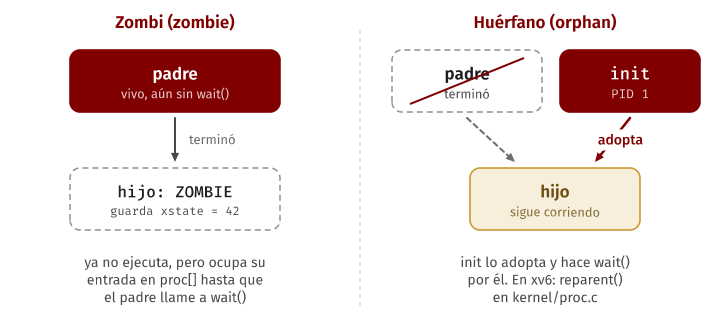
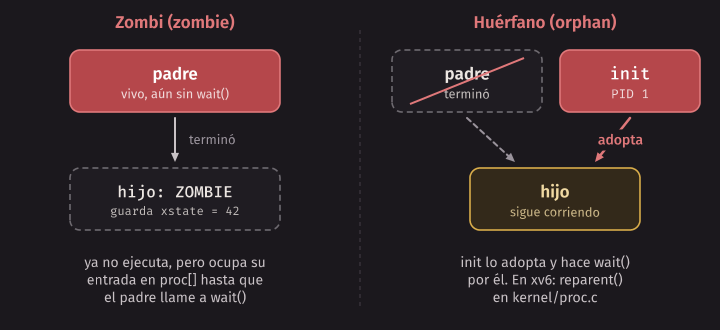
Cuando un hijo termina, el kernel no puede borrarlo por completo: tiene que
guardar su código de salida hasta que el padre lo pida con wait(). Mientras
tanto, el hijo es un proceso zombi (zombie): ya no ejecuta, pero ocupa una
entrada en la tabla de procesos. Un programa que crea hijos y nunca llama a
wait() va acumulando zombis.
Si el padre termina antes que el hijo, el hijo queda huérfano (orphan) y es
adoptado por el proceso init (PID 1), que se encarga de llamar a wait() por
él.
Reemplazar el programa: exec()
fork() solo sirve para ejecutar el mismo programa. Para ejecutar uno
distinto existe la familia exec(): execl, execlp, execv, execvp,
execve… Todas hacen lo mismo con distintas formas de pasar los argumentos.
exec() no crea un proceso. Toma el proceso actual y reemplaza su
contenido: carga el código y los datos del nuevo programa, reinicia la pila y
el heap, y empieza a ejecutar su main. El PID es el mismo y los
descriptores de archivo abiertos se conservan.
if (rc == 0) {
    char *args[] = {"wc", "-l", (char *)file, NULL};
    execvp(args[0], args);
    perror("execvp");   // solo se llega aquí si exec falla
    exit(1);
}
Fíjense en la línea después de execvp. Si exec() funciona, nunca
retorna: el código que la llamó ya no existe. Por eso lo que viene después
solo se ejecuta si hubo un error, por ejemplo si el programa no existe.
| Llamada | ¿Crea un proceso? | ¿Cambia el programa? | Retorna |
|---|---|---|---|
fork() |
Sí | No | Dos veces |
exec() |
No | Sí | Nunca, salvo error |
wait() |
No | No | Cuando termina un hijo |
Por qué están separadas: la shell
Podría parecer más simple tener una sola llamada “crear proceso que ejecute este
programa” (Windows tiene CreateProcess). La separación de Unix tiene una
ventaja enorme: entre fork() y exec() el hijo puede preparar su propio
entorno, ejecutando código normal antes de convertirse en el otro programa.
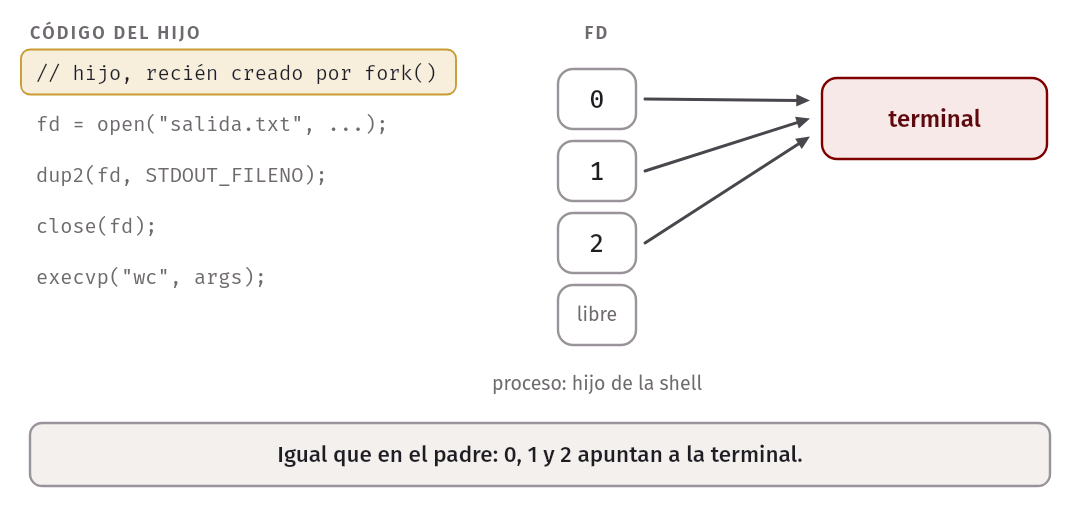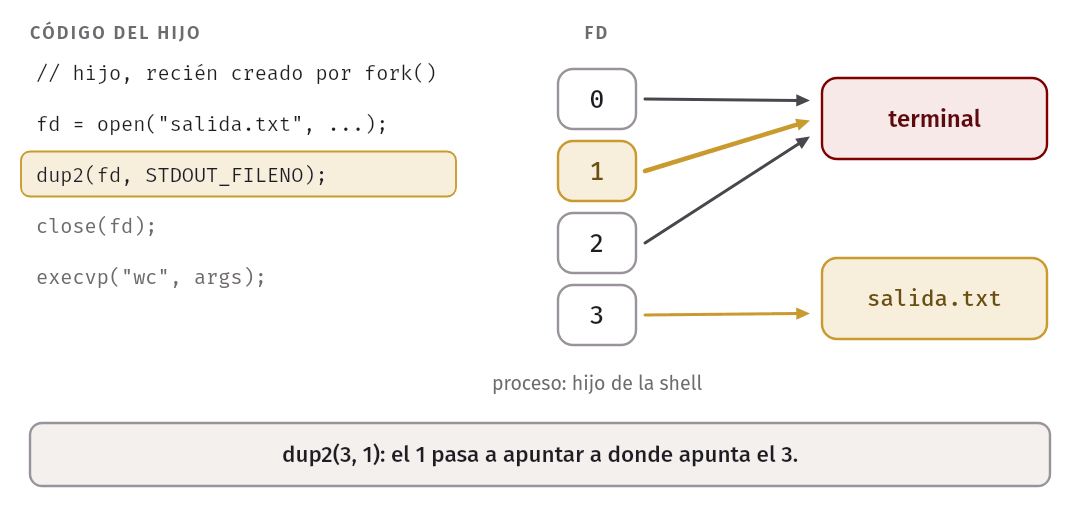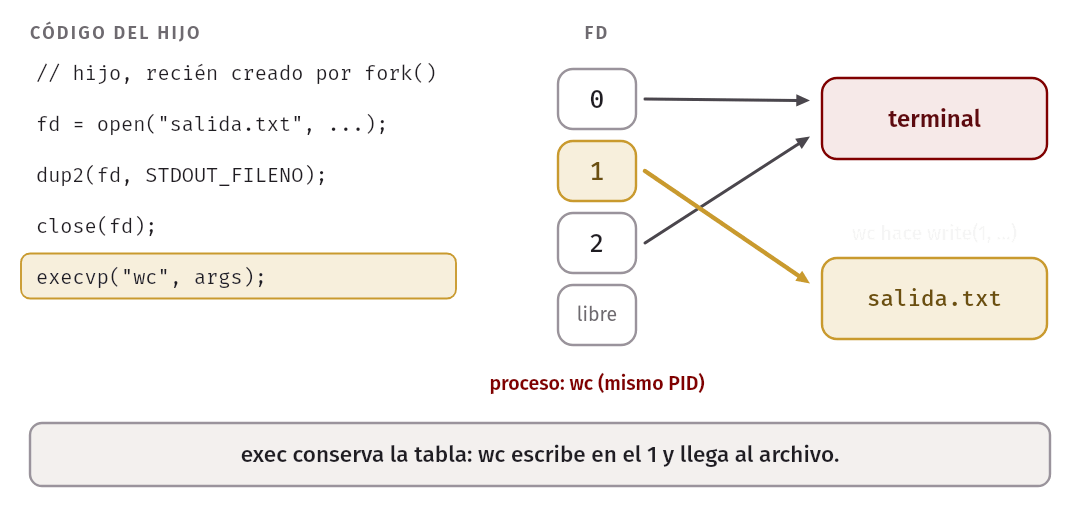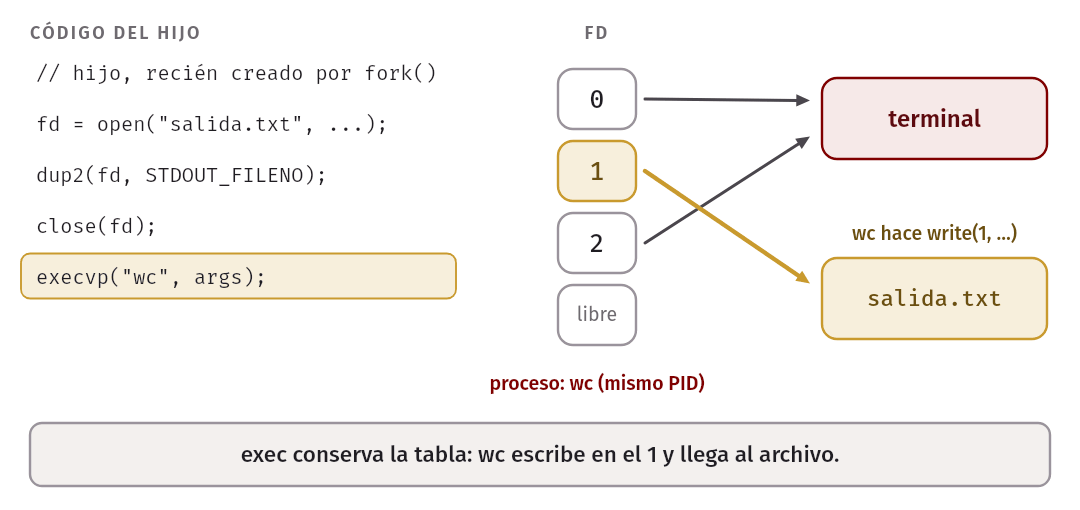
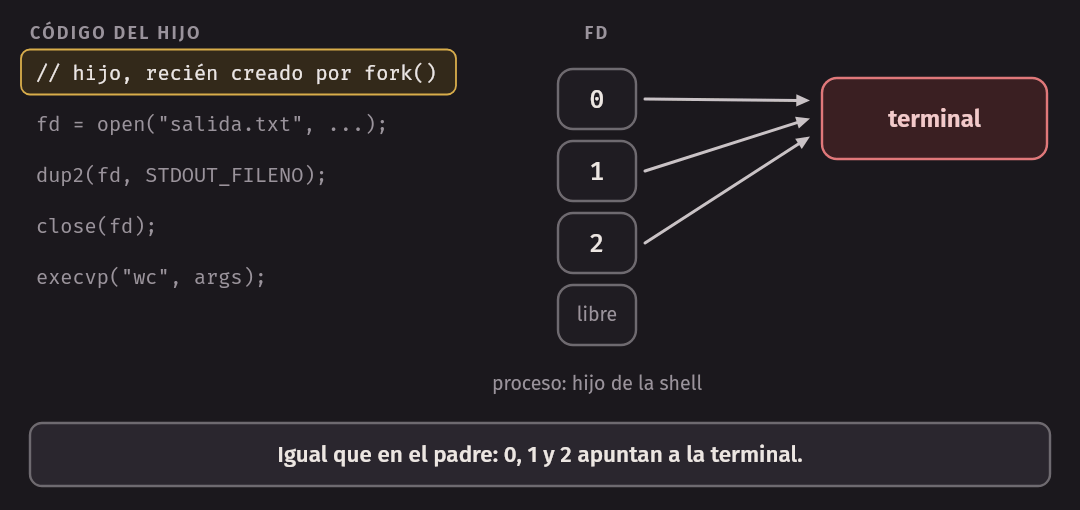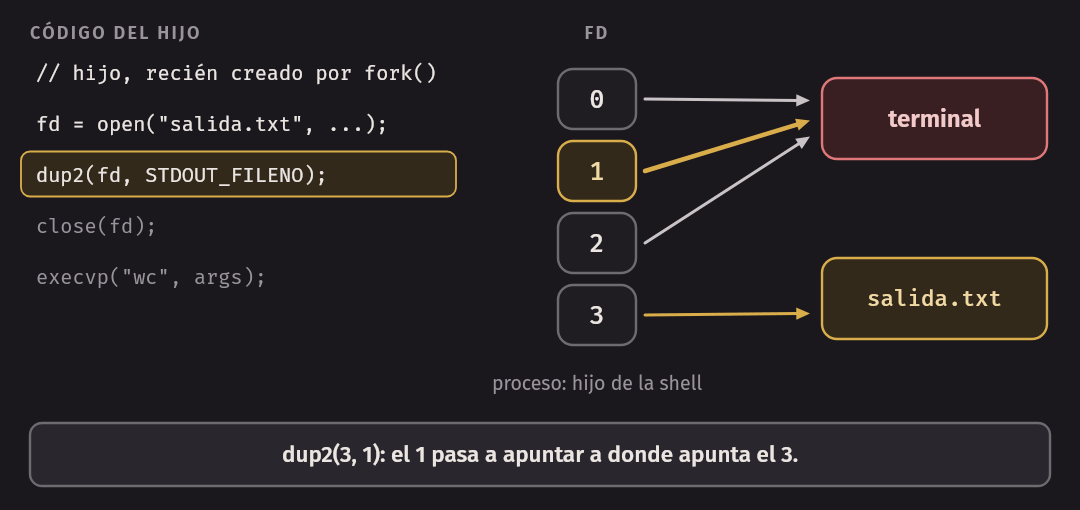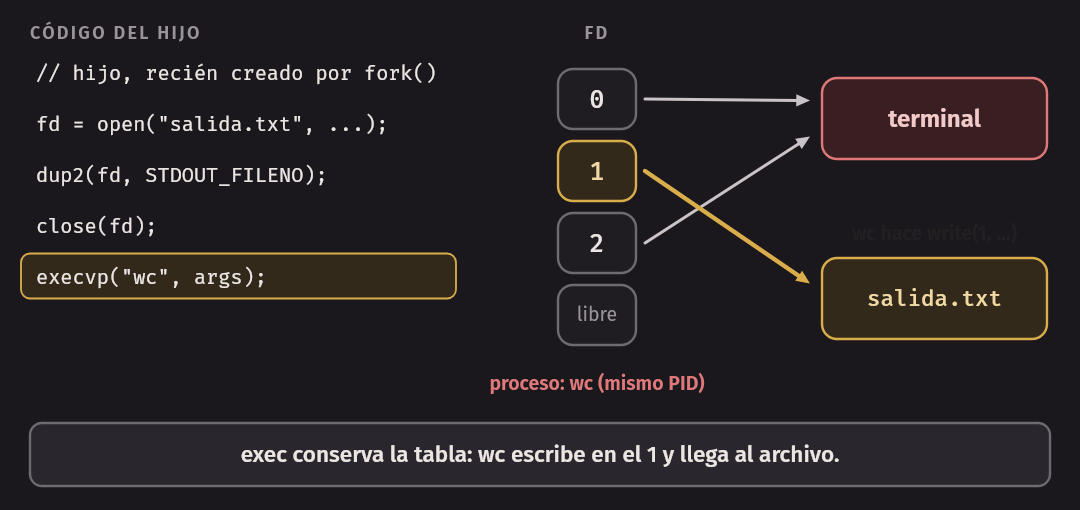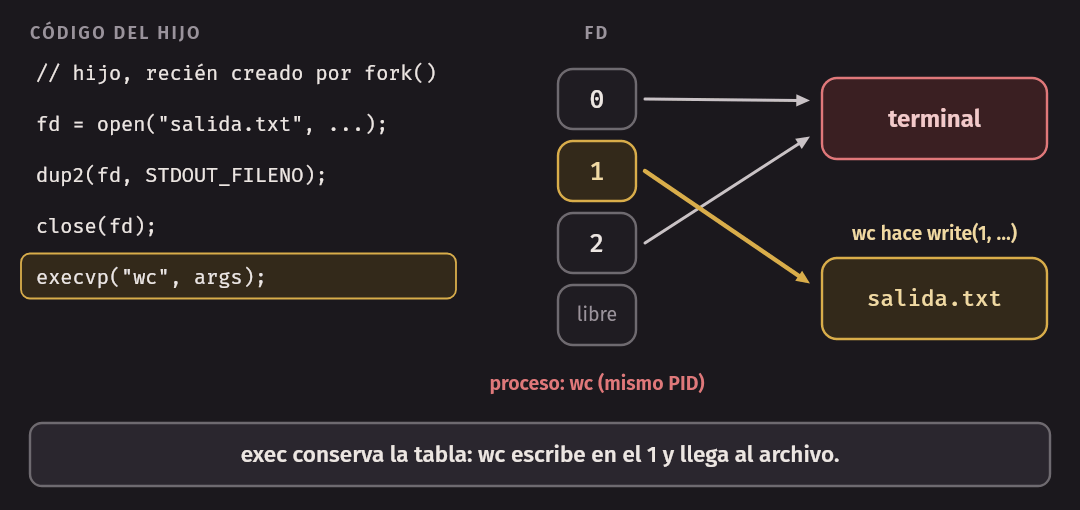
Así funciona la redirección en la shell. Cuando escriben
$ wc -l redirect.c > salida.txtla shell hace fork(), y el hijo, antes de llamar a exec(), abre
salida.txt y lo pone en el lugar de la salida estándar:
int fd = open("salida.txt", O_CREAT | O_WRONLY | O_TRUNC, 0644);
dup2(fd, STDOUT_FILENO);   // la salida estándar ahora es el archivo
close(fd);

char *args[] = {"wc", "-l", "redirect.c", NULL};
execvp(args[0], args);
wc no sabe nada de redirecciones: escribe en el descriptor 1 como siempre, y
como exec() conserva los descriptores abiertos, el texto termina en el
archivo. Los pipes (ls | wc) funcionan igual, usando pipe() en vez de
open(). Esto es exactamente lo que van a implementar en wish (P1).
El ciclo completo de una shell es, entonces:
- Leer una línea y separarla en palabras.
fork().- En el hijo: preparar redirecciones y llamar a
exec(). - En el padre:
wait()al hijo (salvo que el comando termine en&). - Volver al paso 1.
Señales: avisarle algo a un proceso
Hasta ahora los procesos solo se comunican con el kernel por iniciativa propia, con llamadas al sistema. Pero a veces hace falta avisarle algo a un proceso desde afuera: que el usuario presionó Ctrl-C, que un hijo terminó, que debe cerrarse. Para eso Unix tiene las señales (signals): avisos pequeños, identificados por un número, que el kernel entrega a un proceso.
| Señal | Cuándo llega | Acción por defecto |
|---|---|---|
SIGINT |
Ctrl-C en la terminal | Terminar |
SIGTERM |
kill PID: pedir que termine |
Terminar |
SIGKILL |
kill -9 PID |
Terminar (no se puede capturar) |
SIGTSTP |
Ctrl-Z | Suspender |
SIGCONT |
fg o bg |
Reanudar |
SIGCHLD |
Un hijo terminó | Ignorar |
Enviar una señal es una llamada al sistema más: kill(pid, sig). El comando
kill de la shell solo la envuelve. Lo interesante está del lado de quien la
recibe: con sigaction() un proceso puede instalar un manejador (handler),
una función que el kernel hace ejecutar cuando llega la señal, interrumpiendo
lo que el proceso estaba haciendo. Es la versión para procesos de lo que una
interrupción es para la CPU.
static volatile sig_atomic_t interrupts = 0;

static void on_int(int sig) {
    (void)sig;
    interrupts++;           // en un manejador, solo operaciones seguras
}

struct sigaction sa = {0};
sigemptyset(&sa.sa_mask);
sa.sa_handler = on_int;
sigaction(SIGINT, &sa, NULL);   // Ctrl-C ya no mata al programa
El programa completo, signal.c, cuenta los
Ctrl-C y termina ordenadamente con SIGTERM:
$ ./signal &
PID 34: prueben Ctrl-C o kill -TERM 34
$ kill -INT 34
SIGINT número 1: lo ignoro
$ kill -INT 34
SIGINT número 2: lo ignoro
$ kill -TERM 34
SIGTERM: termino ordenadamente tras 2 SIGINT
Dos detalles importan. Primero, SIGKILL (y SIGSTOP) no se pueden
capturar ni ignorar: el sistema operativo siempre conserva una forma de
detener un proceso, por más que este intente evitarlo. Segundo, un manejador
puede ejecutarse en cualquier punto del programa, incluso a mitad de un
printf; por eso dentro de él solo se deben usar operaciones seguras, como
escribir una variable volatile sig_atomic_t. Es un primer encuentro con los
problemas de concurrencia de la parte II del curso.
SIGCHLD cierra el círculo con wait(): una shell puede recibir esa señal
para saber que un trabajo en segundo plano (&) terminó y recogerlo, sin
quedarse bloqueada esperándolo.
Quién puede enviar señales a quién
Cada proceso pertenece a un usuario, identificado por un número (UID), que
hereda de su padre en fork(). El kernel revisa ese UID en cada kill(): un
usuario normal solo puede enviar señales a sus propios procesos, y el
superusuario (root, UID 0) puede enviarlas a cualquiera.
$ id
uid=1001(ana) gid=1001(ana)
$ kill -9 1
bash: kill: (1) - Operation not permitted
El proceso 1 (init) pertenece a root, así que la usuaria ana no puede
matarlo. Este es el primer ejemplo de algo que veremos en la semana 16: el
kernel actúa como monitor de referencia que revisa cada pedido antes de
cumplirlo.
En xv6. xv6 no tiene usuarios ni manejadores de señales: la única “señal” es matar. La llamada
kill(pid)termina enkkill()(kernel/proc.c), que no destruye al proceso de inmediato; solo marcap->killed = 1y, si estaba dormido, lo despierta. El proceso muere la próxima vez que pasa por el kernel:usertrap()(kernel/trap.c) revisakilled(p)y llama akexit(-1). Matar a un proceso a mitad de una operación del kernel podría dejar estructuras a medio actualizar; esperar a un punto seguro evita ese problema.
Por debajo: ejecución directa limitada
Hasta ahora usamos las llamadas al sistema como si fueran funciones. Pero
fork() no puede ser una función común: tiene que modificar estructuras del
kernel y crear un espacio de direcciones. ¿Cómo pasa el control de un programa
de usuario al sistema operativo, y cómo vuelve?
La forma más rápida de ejecutar un programa es dejarlo correr directamente sobre la CPU, sin intermediarios. El problema es que entonces el programa podría hacer cualquier cosa: escribir en el disco de otro usuario, desactivar interrupciones o simplemente no devolver nunca la CPU. La solución de los sistemas operativos modernos es la ejecución directa limitada: el programa corre directo en el hardware, pero con límites que el propio hardware impone.
Problema 1: operaciones restringidas
El procesador tiene al menos dos modos de ejecución:
- Modo usuario (user mode): aquí corren los programas. Las instrucciones privilegiadas, como acceder a dispositivos o cambiar tablas de páginas, provocan una excepción.
- Modo kernel (kernel mode): aquí corre el sistema operativo, sin restricciones.
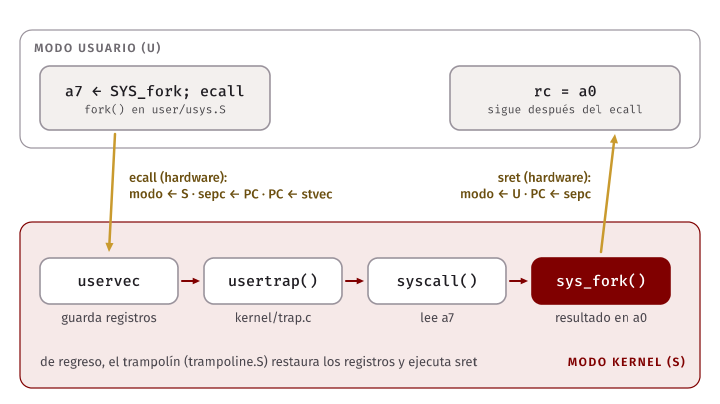
Para pedir algo al kernel, un programa ejecuta una instrucción especial de
trap: ecall en RISC-V, syscall en x86-64. Esa instrucción cambia a modo
kernel y salta a una dirección fija dentro del kernel, guardando dónde estaba
el programa (en RISC-V, en el registro sepc). El programa no puede elegir a
dónde salta: el kernel escribió de antemano la dirección de su manejador de
traps en un registro especial (stvec en RISC-V; en x86, una tabla de traps),
y solo el modo kernel puede modificarlo. (En xv6, prepare_return() vuelve a
escribir stvec con la dirección de uservec justo antes de cada regreso a
modo usuario, y usertrap() lo cambia a kernelvec mientras el kernel
trabaja.) El manejador guarda el resto de los
registros del programa, atiende el pedido y, al terminar, ejecuta la
instrucción de retorno (sret en RISC-V), que restaura el estado y vuelve a
modo usuario.
En xv6. Pueden seguir este camino en el código de xv6-riscv. El script
user/usys.plgenera las funciones de usuario: cada una pone el número de llamada en el registroa7y ejecutaecall. En el kernel,uservec(enkernel/trampoline.S) guarda los registros del programa en su trapframe y salta ausertrap()enkernel/trap.c, que llama asyscall()enkernel/syscall.c. Esta leea7y ejecuta la función que corresponde, por ejemplosys_fork()enkernel/sysproc.c. El valor de retorno se deja ena0. Lo recorremos con gdb en el laboratorio de la semana 4.
Problema 2: recuperar la CPU
Si el programa corre directamente sobre la CPU, el sistema operativo no está ejecutando. ¿Cómo hace para quitarle la CPU y dársela a otro proceso?
Los primeros sistemas confiaban en que los programas devolvieran el control
cada tanto (enfoque cooperativo): al hacer una llamada al sistema, o con una
llamada explícita yield(). Un programa con un bucle infinito colgaba toda la
máquina.
La solución definitiva es la interrupción del temporizador (timer interrupt): un dispositivo de hardware que interrumpe a la CPU cada pocos milisegundos. Al llegar la interrupción, el hardware hace lo mismo que con un trap: guarda el estado y salta al manejador que el kernel registró. El kernel recupera así el control sin importar lo que haga el programa, y puede decidir si lo deja seguir o si cambia a otro.
El cambio de contexto
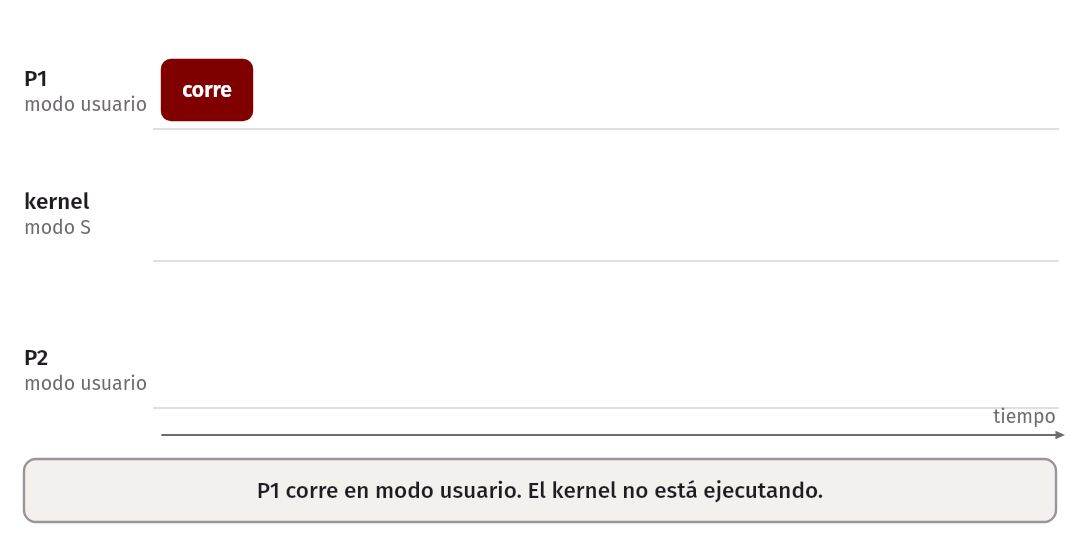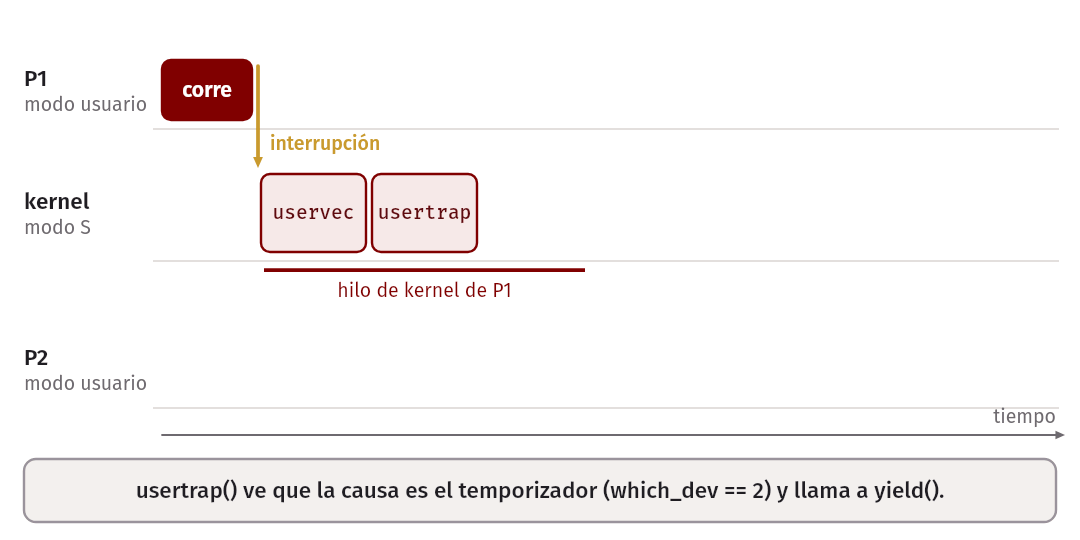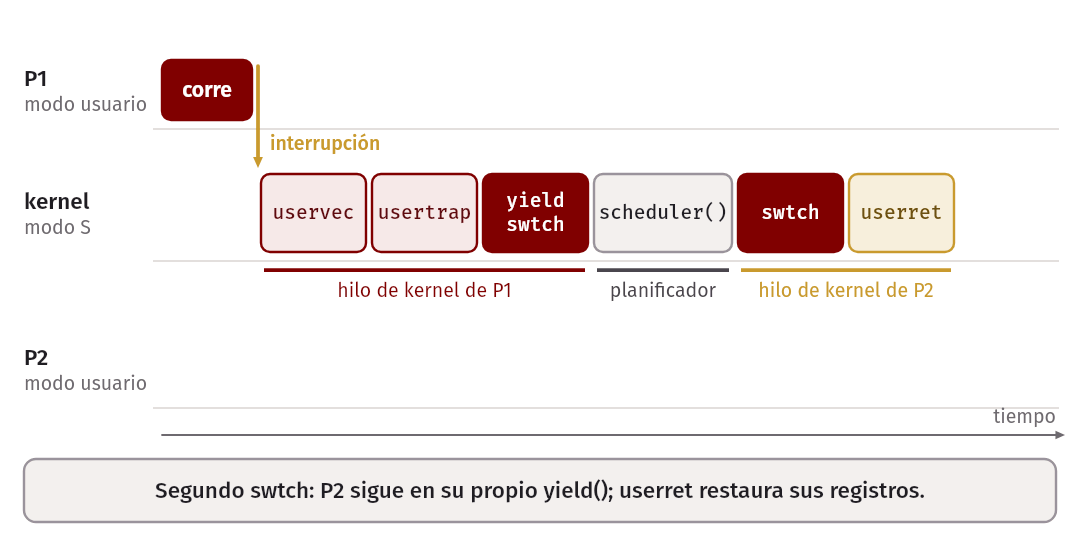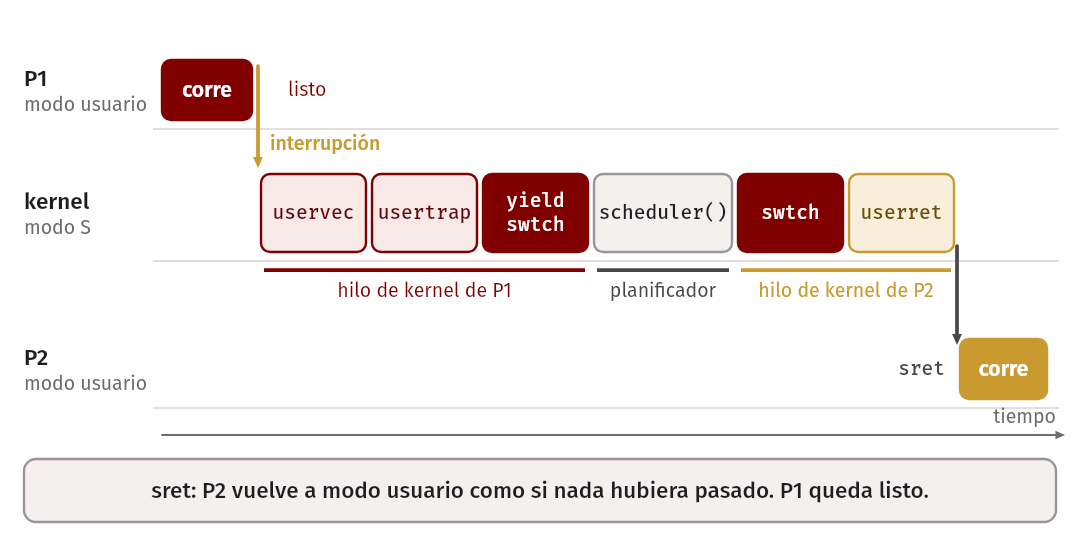
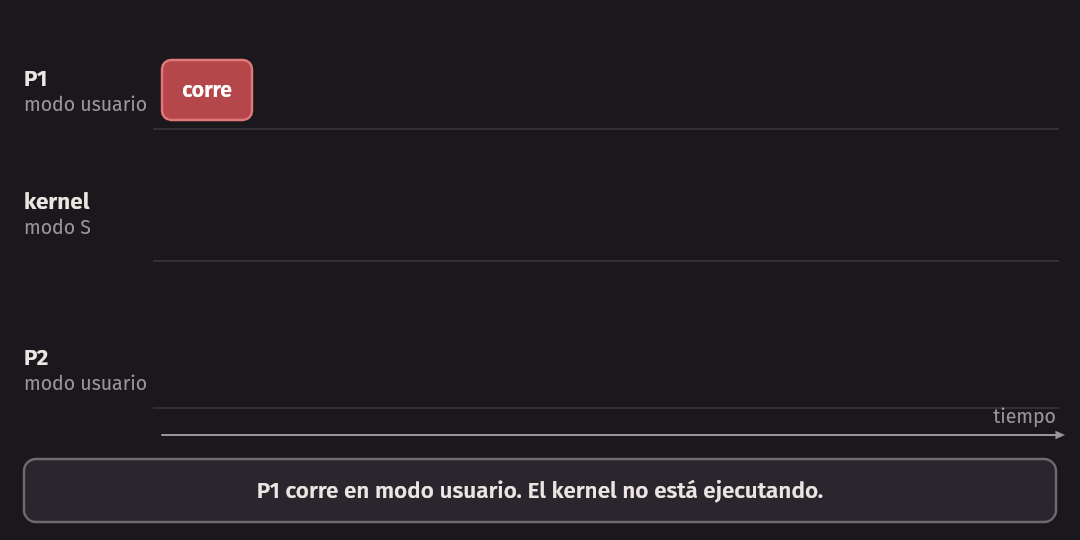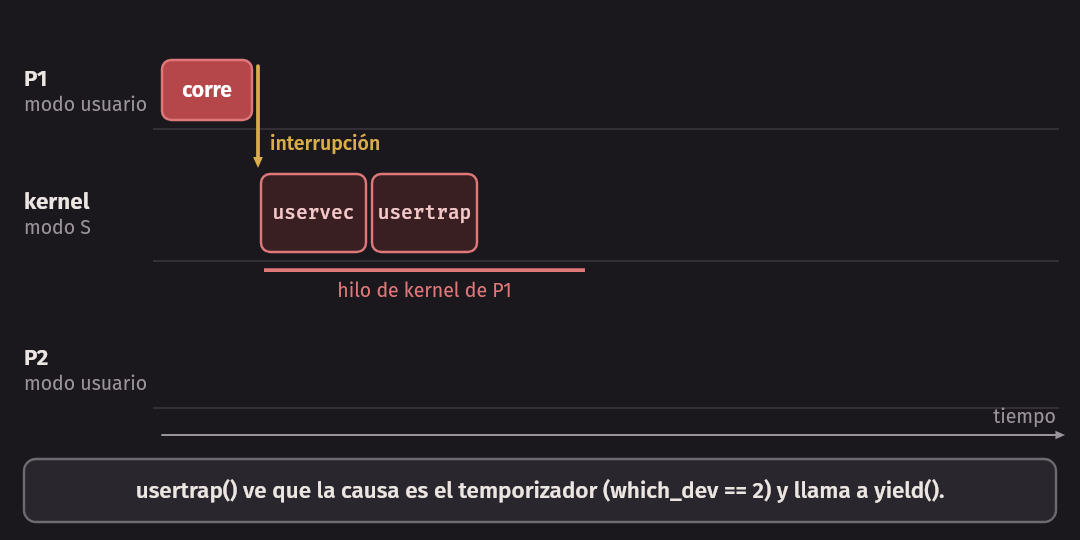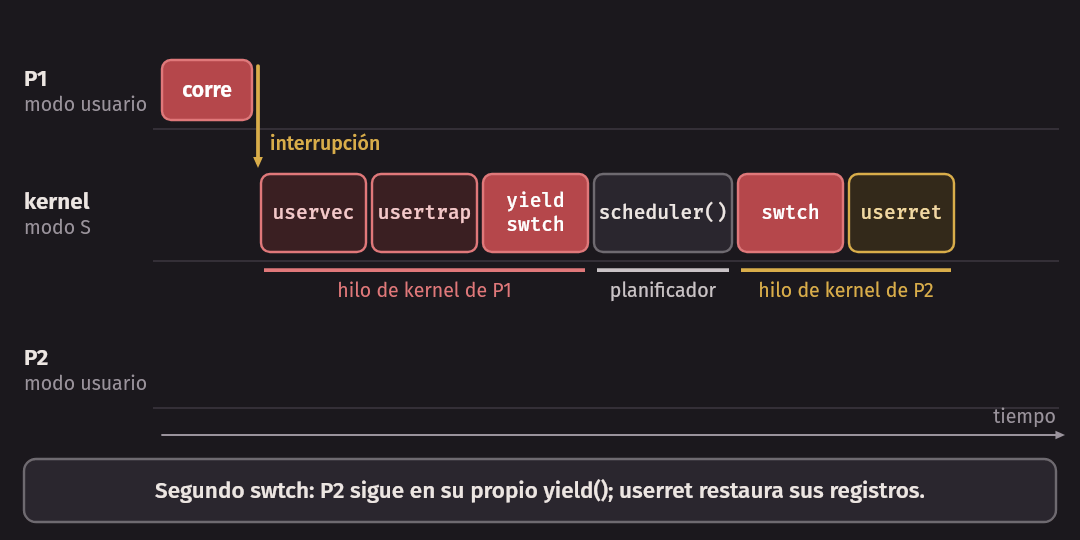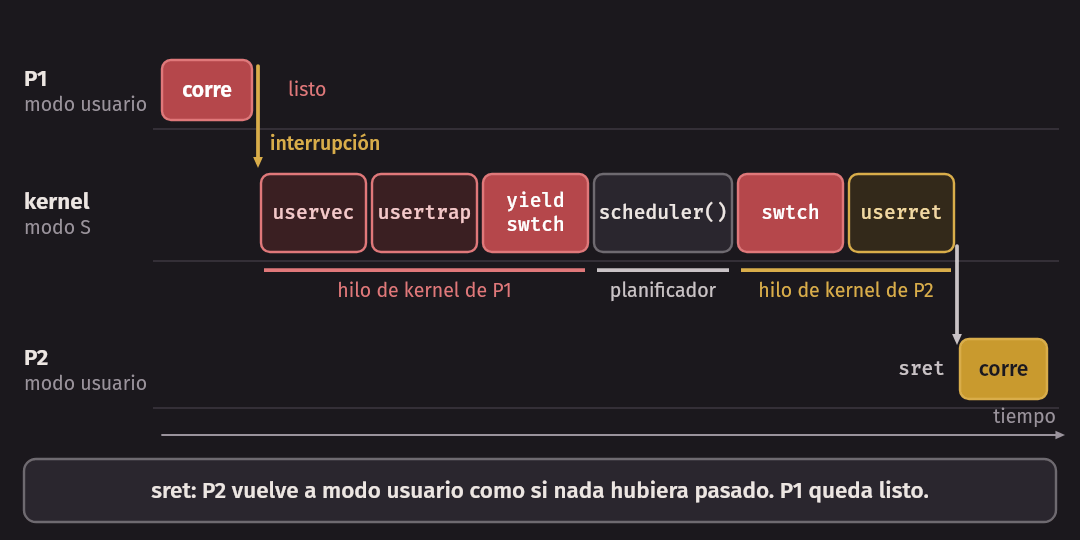
Cuando el kernel decide cambiar de proceso, realiza un cambio de contexto (context switch): guarda los registros del proceso actual en su estructura del kernel y carga los del siguiente. Al ejecutar return-from-trap, la CPU continúa con el otro proceso como si nada hubiera pasado.
En xv6, el corazón de esta operación es la función swtch en
kernel/swtch.S: unas pocas instrucciones de ensamblador que guardan en un
struct context los registros que el compilador espera que se conserven
(ra, sp y s0 a s11) y cargan los del otro contexto. Al retornar,
swtch ya está ejecutando con otra pila. Ojo: en xv6 un proceso no salta
directamente a otro. sched() hace swtch hacia el hilo del planificador de
esa CPU (scheduler() en kernel/proc.c), y el planificador elige el
siguiente proceso RUNNABLE y hace un segundo swtch hacia él. Un cambio de
contexto en xv6 son, entonces, dos llamadas a swtch.
| Evento | Quién lo inicia | Qué hace el hardware |
|---|---|---|
| Llamada al sistema | El programa (ecall) |
Pasa a modo kernel y salta al manejador de traps |
| Interrupción del temporizador | El hardware | Lo mismo, sin que el programa lo pida |
| Retorno del trap | El kernel (sret) |
Restaura el estado y vuelve a modo usuario |
¿Cuánto cuesta todo esto?
La ejecución directa limitada es rápida, pero no gratis. Una llamada al
sistema cuesta bastante más que una llamada a función: hay que entrar al
kernel con un trap, guardar los registros del programa, en xv6 cambiar de
tabla de páginas, hacer el trabajo y deshacer todo al volver. Un cambio de
contexto cuesta todavía más: además de entrar al kernel, corre el
planificador y swtch, y el proceso que entra encuentra la caché y la TLB
“frías”, llenas de datos del proceso anterior.
Estos costos se pueden medir desde un programa normal, y es la tarea del laboratorio de esta semana (cap. 6 de OSTEP):
- Llamada al sistema. Llamar un millón de veces a
read(fd, buf, 0), que entra al kernel pero no lee nada, entre dosclock_gettime(), y dividir el tiempo entre el número de llamadas. - Cambio de contexto. Dos procesos se pasan un byte por dos pipes, de un
lado a otro. Cada vuelta obliga a dos cambios de contexto. Hay que fijar
ambos procesos al mismo núcleo (con
taskset), porque si corren en núcleos distintos no hay cambio de contexto que medir.
No damos aquí los números, porque dependen de la máquina y el objetivo es que
los midan ustedes. Comparen el resultado con el costo de una llamada a una
función vacía: ¿cuántas llamadas a función “vale” una llamada al sistema? Esa
diferencia explica por qué la biblioteca de C junta muchos printf en un
buffer antes de llamar a write(), que es justo lo que vimos en el misterio
del “hola” duplicado.
Resumen
fork()crea una copia del proceso y retorna dos veces: el PID del hijo en el padre y0en el hijo. El orden de ejecución después defork()no está garantizado.wait()bloquea al padre hasta que un hijo termina y recoge su código de salida; mientras nadie lo recoge, el hijo es un zombi.exec()reemplaza el programa del proceso actual y no retorna si tiene éxito. Conserva el PID y los descriptores abiertos.- Separar
fork()yexec()permite que el hijo prepare su entorno, y en eso se basan la redirección y los pipes de la shell. - Las señales avisan eventos a un proceso, que puede capturarlas con
sigaction()(salvoSIGKILL). Solo el owner del proceso orootpuede enviarlas. - Una llamada al sistema y un cambio de contexto cuestan mucho más que una llamada a función; por eso se miden y se evitan cuando se puede.
- La ejecución directa limitada combina modo usuario/kernel, traps y la interrupción del temporizador para que los programas corran rápido sin perder el control de la máquina.
Ejercicios
- ¿Cuántos procesos existen al terminar
fork(); fork(); fork();? Dibujen el árbol de procesos y verifiquen agregando unprintfcongetpid()ygetppid(). - Modifiquen
fork.cpara que el padre y el hijo incrementen una misma variable globalxy la impriman. ¿Comparten el valor? ¿Por qué? - En
exec.c, cambien"wc"por un programa que no existe. ¿Qué se imprime y desde qué línea del código? - Escriban
pipe.c: un programa que ejecute el equivalente dels | wc -lusandopipe(), dosfork(),dup2()yexecvp(). - Con
strace -f ./fork, identifiquen la llamada al sistema que realmente ejecutafork()en Linux. ¿Se llamafork? - Ejecuten
signal.cy prueben Ctrl-C varias veces. ¿Cómo lo detienen? Intenten capturar tambiénSIGKILLconsigaction()y revisen el valor de retorno. ¿Qué error da y por qué el sistema operativo no lo permite? - Midan el costo de una llamada al sistema con un millón de
read(fd, buf, 0)y el de una llamada a una función vacía. ¿Cuántas veces más cara es la llamada al sistema en su máquina?