
Apuntes · Capítulo 3CPU
Planificación de la CPU: de FIFO a MLFQ
Planificación de la CPU: de FIFO a MLFQ
En la semana 2 vimos el mecanismo que permite compartir la CPU: la interrupción del temporizador (timer interrupt) devuelve el control al kernel cada cierto tiempo, y el cambio de contexto (context switch) guarda los registros de un proceso y carga los de otro. Ese mecanismo no dice nada sobre una pregunta que el kernel tiene que responder cientos de veces por segundo: de todos los procesos listos, ¿a cuál le damos la CPU ahora? Esa es la política, y quien la aplica es el planificador (scheduler).
Este capítulo construye esa política poco a poco. Empezamos con supuestos muy simples sobre los programas, que hacen fácil razonar, y los vamos quitando uno por uno. Cada vez que cae un supuesto, la política anterior falla y aparece otra mejor. Al final llegamos a la Multi-Level Feedback Queue (MLFQ), una política que funciona sin saber nada del futuro y que, con variaciones, se usó en BSD, Solaris y Windows. Cerramos con la planificación de tiempo real, donde ya no importan los promedios sino que cada trabajo termine antes de su plazo.
Ruta de lectura.
- Antes de clase (15–20 min): «Supuestos sobre la carga de trabajo», «Medir: el tiempo de retorno», «FIFO» y «Una nueva métrica: el tiempo de respuesta».
- En clase: sesión A, de «SJF: primero el más corto» a «Cae el supuesto 5: no conocemos el futuro»; sesión B, de «Multi-Level Feedback Queue» a «Ajuste y sistemas reales», y «Planificación de tiempo real».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios», rehaciendo los diagramas de Gantt con los simuladores. Para ampliar: OSTEP cap. 7 y 8, «En Linux: SCHED_FIFO, SCHED_RR y SCHED_DEADLINE» y «¿Por qué un sistema de propósito general no garantiza plazos?».
Lectura. Este capítulo acompaña a OSTEP cap. 7 Scheduling: Introduction y cap. 8 Scheduling: The Multi-Level Feedback Queue. Todos los diagramas de Gantt de este capítulo se pueden reproducir con los simuladores
sched.c,mlfq.cyrtsched.c, que se compilan conmakedentro del contenedor del curso.
$ cd code/week-03
$ make
$ ./sched fifo 12 3 3       # tres trabajos: 12, 3 y 3 ticks
$ ./mlfq -o 20 15@8:3/1     # MLFQ con las reglas 4a/4b
$ ./rtsched 3/6 4/9         # tiempo real: RM y EDF con dos tareas periódicas
$ make test                 # corre todos los ejemplos del capítulo
$ make clean
Supuestos sobre la carga de trabajo
Al conjunto de procesos que corren en el sistema lo llamamos carga de trabajo (workload), y a cada proceso, un trabajo (job). Para empezar suponemos que:
- Todos los trabajos duran lo mismo.
- Todos llegan al mismo tiempo.
- Una vez que empiezan, corren hasta terminar.
- Solo usan la CPU: no hacen E/S.
- Sabemos de antemano cuánto dura cada uno.
Ninguno es realista, y el quinto menos que todos: el kernel no puede saber cuánto va a tardar un programa (eso se parece demasiado al problema de la parada). Pero con estos supuestos las cuentas son simples y se ve con claridad qué hace cada política.
Medir: el tiempo de retorno
Para comparar políticas necesitamos una métrica. La primera es el tiempo de retorno (turnaround time) de un trabajo:
T_retorno = T_fin - T_llegadaEs cuánto espera el usuario desde que lanza el trabajo hasta que tiene el resultado. Para una carga completa usamos el promedio sobre todos los trabajos. Es una métrica de rendimiento. Hay otras, como la equidad (fairness): que todos reciban una parte parecida de la CPU. Veremos que rendimiento y equidad suelen chocar.
En los ejemplos el tiempo se mide en ticks, unidades enteras de tiempo. Los dibujamos con diagramas de Gantt: una barra horizontal donde cada tramo indica qué trabajo tuvo la CPU.
FIFO
La política más simple es FIFO (First In, First Out), también llamada FCFS (First Come, First Served): se atiende a los trabajos en el orden en que llegaron. Basta una cola.
Supongamos que A, B y C llegan en t = 0 (A un instante antes que B, y B un
instante antes que C) y cada uno dura 6 ticks:
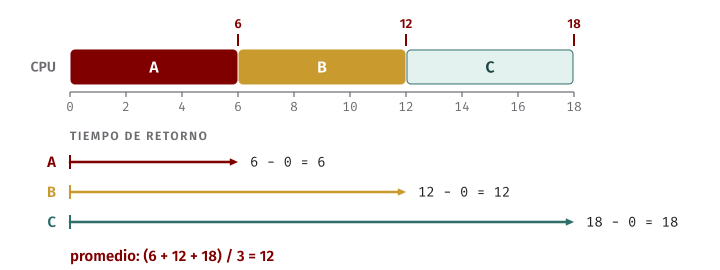
A termina en 6, B en 12 y C en 18. El retorno promedio es (6 + 12 + 18) / 3 = 12.
Cae el supuesto 1: el efecto convoy
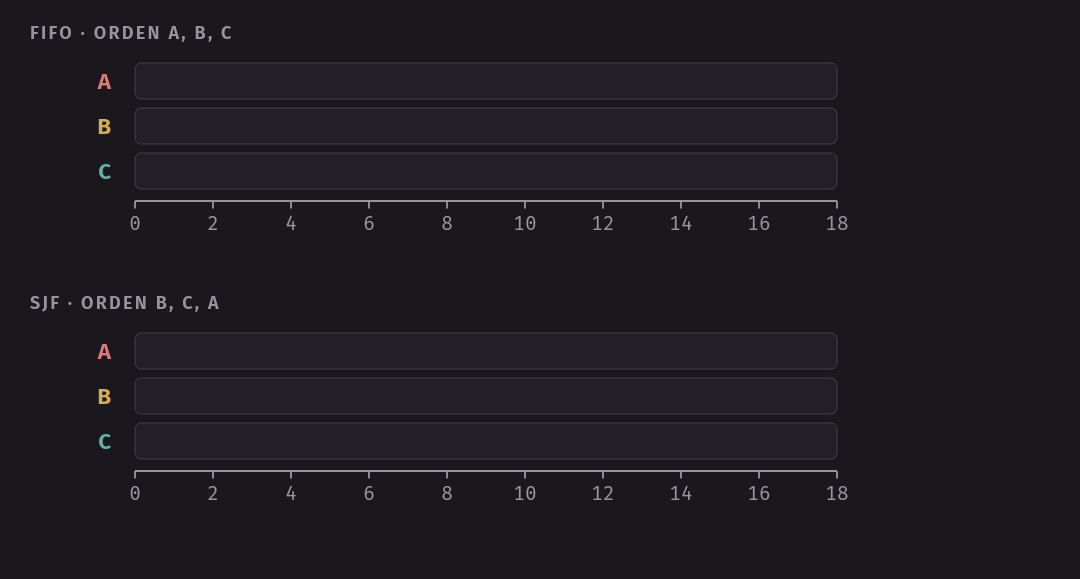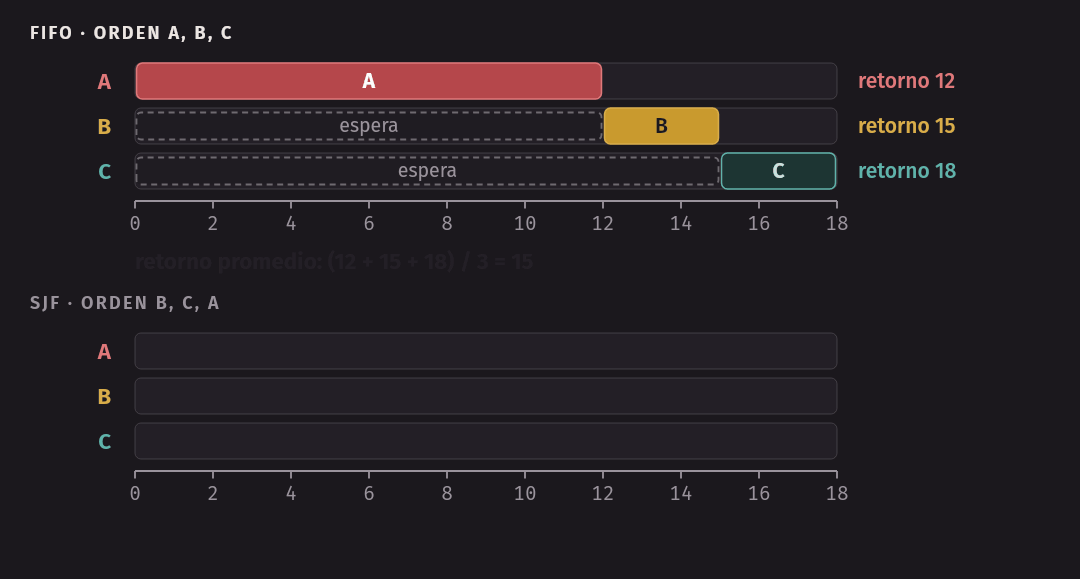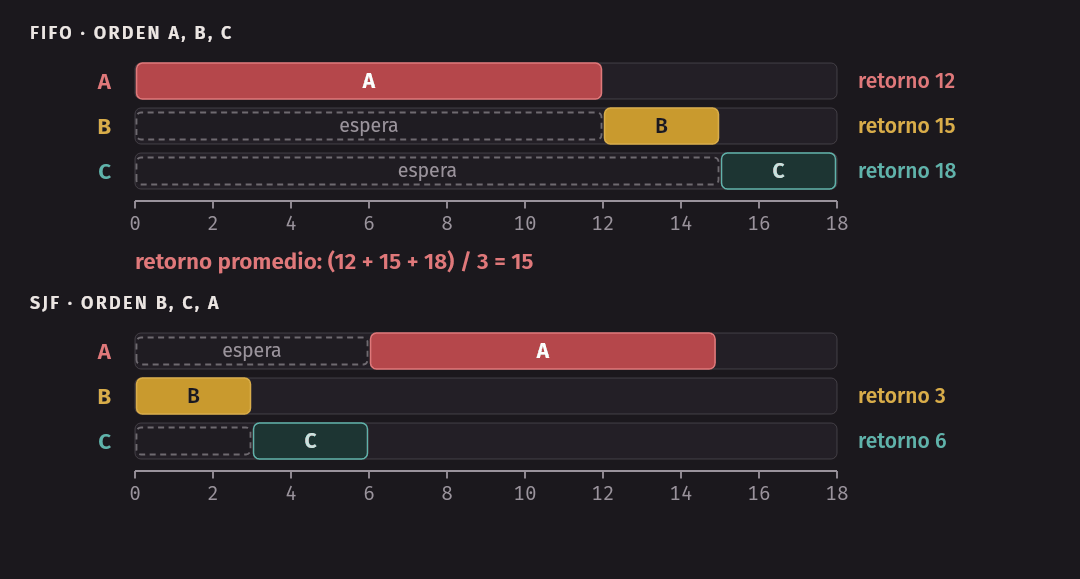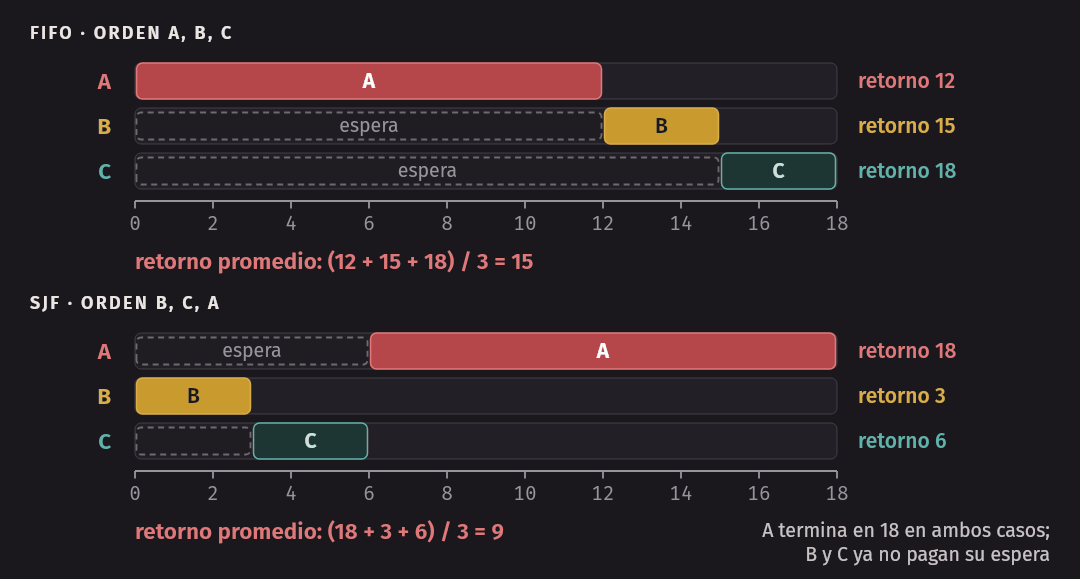
Ahora los trabajos duran distinto: A dura 12 y B y C, solo 3. Con FIFO:
$ ./sched fifo 12 3 3
política: FIFO
       0    5    10   15
gantt  AAAAAAAAAAAABBBCCC
tramos A[0,12) B[12,15) C[15,18)

trabajo llegada duración  inicio  fin  retorno  respuesta
   A        0       12       0    12       12          0
   B        0        3      12    15       15         12
   C        0        3      15    18       18         15
promedio                                15.00       9.00
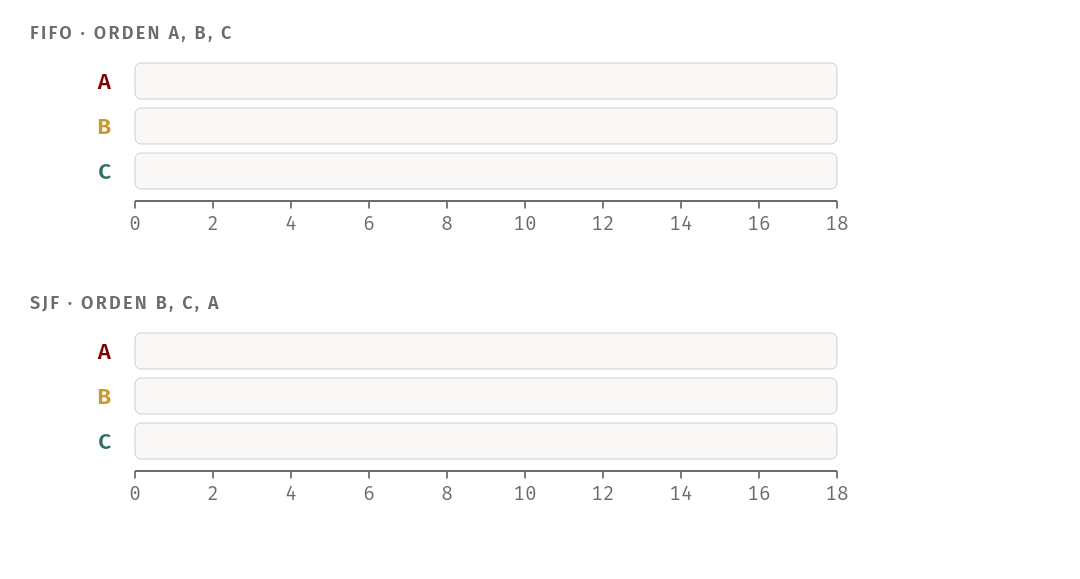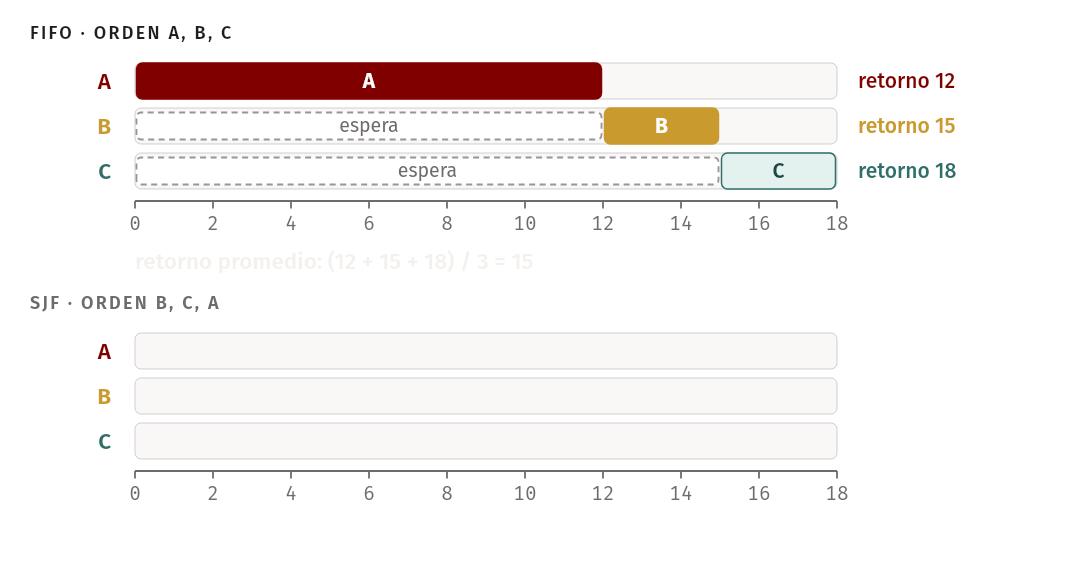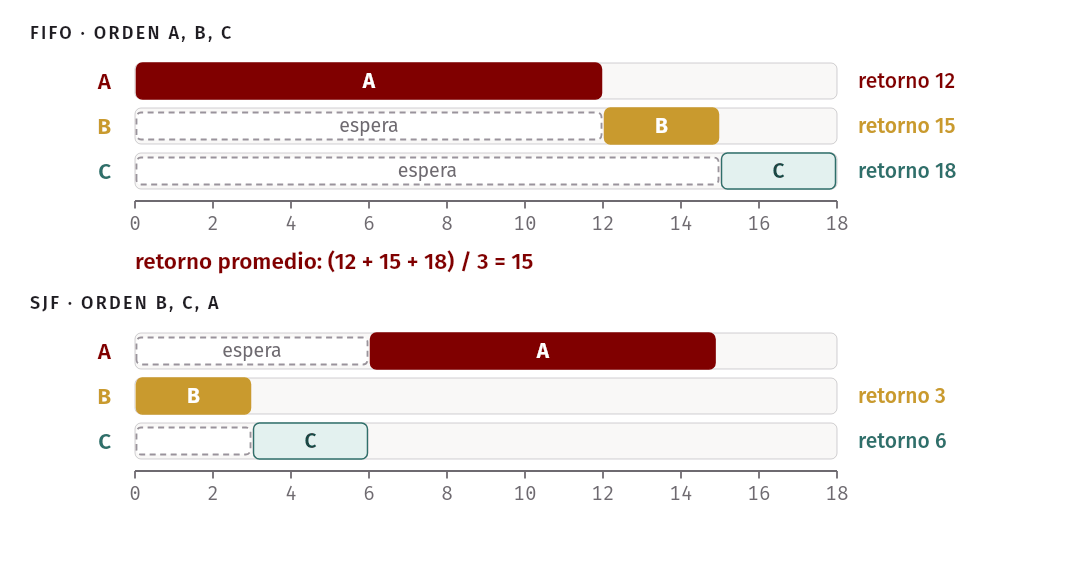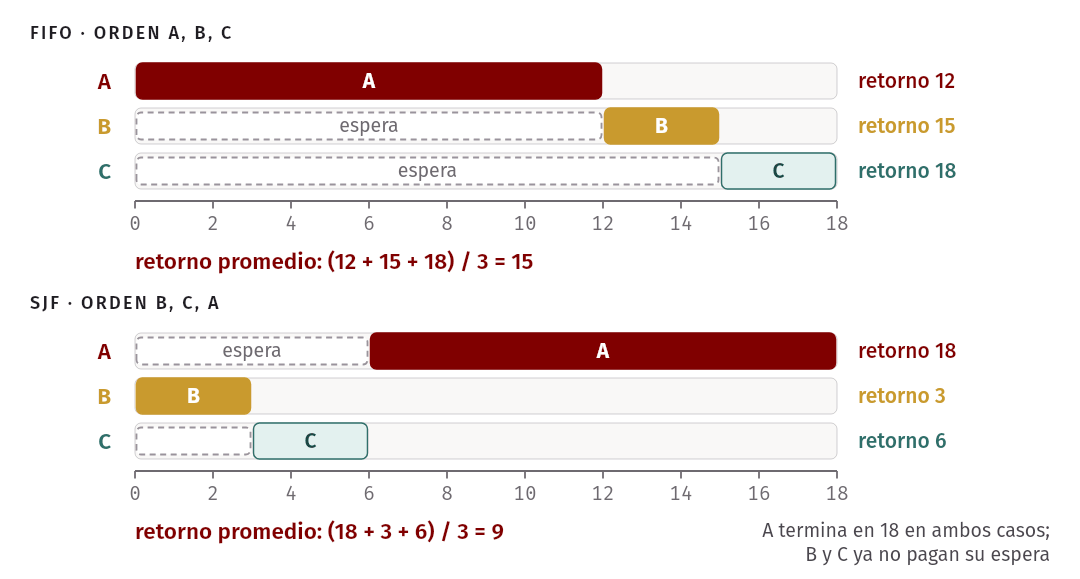
El retorno promedio sube a 15, aunque dos de los tres trabajos necesitan solo 3 ticks. B y C pasan casi todo su tiempo esperando detrás de A. A esto se le llama efecto convoy (convoy effect): varios consumidores cortos de un recurso quedan atascados detrás de uno largo. Es la cola única del supermercado cuando adelante hay alguien con dos carritos llenos y tú llevas solo una gaseosa.
SJF: primero el más corto
La solución es la que usan los supermercados con su caja rápida: atender primero a los que necesitan menos. SJF (Shortest Job First) ordena los trabajos por duración y los corre en ese orden:
$ ./sched sjf 12 3 3
gantt  BBBCCCAAAAAAAAAAAA
...
   A        0       12       6    18       18          6
   B        0        3       0     3        3          0
   C        0        3       3     6        6          3
promedio                                 9.00       3.00
El promedio baja de 15 a 9. A termina en el mismo instante que antes (en 18), pero B y C ya no pagan su espera.
¿Por qué SJF es óptimo?
Si todos los trabajos llegan al mismo tiempo, SJF da el menor retorno promedio posible. La intuición es un argumento de intercambio. Tomen dos trabajos seguidos en cualquier orden, uno largo L y uno corto S. El segundo de los dos termina en el mismo instante en cualquier orden; lo que cambia es cuándo termina el primero. Si va L primero, el primero termina tarde; si va S, termina temprano. Con L = 6 y S = 2:
| Orden | Fin del primero | Fin del segundo | Suma |
|---|---|---|---|
| L, S | 6 | 8 | 14 |
| S, L | 2 | 8 | 10 |
Cualquier orden en el que un trabajo largo vaya antes que uno más corto se puede mejorar intercambiándolos. El único orden que ya no se puede mejorar es de menor a mayor: SJF.
Idea clave. FIFO y SJF dan exactamente el mismo resultado cuando los trabajos llegan ya ordenados de corto a largo, y en particular cuando todos duran lo mismo. La diferencia aparece cuando un trabajo largo llega antes que uno corto.
Cae el supuesto 2: llegadas en distinto momento
SJF, tal como lo definimos, es no apropiativo (non-preemptive): una vez que
un trabajo empieza, corre hasta terminar. Eso es un problema si los trabajos
no llegan juntos. Supongamos que A (12) llega en t = 0, y B (3) y C (3) llegan
en t = 2:
$ ./sched sjf 12 3@2 3@2
gantt  AAAAAAAAAAAABBBCCC
...
   A        0       12       0    12       12          0
   B        2        3      12    15       13         10
   C        2        3      15    18       16         13
promedio                                13.67       7.67
En t = 0 solo está A, así que SJF lo elige. Cuando llegan B y C, A ya está
corriendo y no se le puede quitar la CPU. El convoy volvió: el retorno
promedio es (12 + 13 + 16) / 3 ≈ 13,67.
STCF: SJF con desalojo
Para arreglarlo hay que soltar el supuesto 3 y permitir que el planificador desaloje (preempt) a un trabajo que está corriendo. Ya tenemos el mecanismo: la interrupción del temporizador y el cambio de contexto. La política se llama STCF (Shortest Time-to-Completion First) o PSJF (Preemptive SJF): cada vez que llega un trabajo, se corre el que tenga menos tiempo restante, contando al nuevo.
$ ./sched stcf 12 3@2 3@2
política: STCF
       0    5    10   15
gantt  AABBBCCCAAAAAAAAAA
tramos A[0,2) B[2,5) C[5,8) A[8,18)

trabajo llegada duración  inicio  fin  retorno  respuesta
   A        0       12       0    18       18          0
   B        2        3       2     5        3          0
   C        2        3       5     8        6          3
promedio                                 9.00       1.00
Sigamos las decisiones:
| Tiempo | Qué pasa | Tiempo restante | Corre |
|---|---|---|---|
| 0 | Llega A | A: 12 | A |
| 2 | Llegan B y C | A: 10, B: 3, C: 3 | B (desaloja a A) |
| 5 | Termina B | A: 10, C: 3 | C |
| 8 | Termina C | A: 10 | A |
El promedio vuelve a 9. Con llegadas en distintos momentos, STCF es óptimo para el retorno promedio, por el mismo argumento de intercambio que SJF.
Prácticamente todos los planificadores modernos son apropiativos (preemptive). Los no apropiativos vienen de la época de los sistemas por lotes, cuando cada trabajo corría hasta el final antes de pensar en el siguiente.
Una nueva métrica: el tiempo de respuesta
Si conociéramos las duraciones y solo nos importara el retorno, STCF sería la respuesta final. Pero con los sistemas de tiempo compartido apareció otra exigencia: el usuario está frente a una terminal y quiere ver que el sistema le hace caso. Para eso se define el tiempo de respuesta (response time):
T_respuesta = T_primera_ejecución - T_llegadaEs cuánto tarda el sistema en empezar a atender un trabajo. En el ejemplo de STCF, A tiene respuesta 0, B tiene 0 y C tiene 3 (llegó en 2 y corrió por primera vez en 5): promedio 1. Pero si A, B y C llegan juntos y duran 6 cada uno, SJF da respuestas de 0, 6 y 12, con promedio 6. El tercer trabajo no corre ni un tick hasta que los otros dos terminan por completo. Si ese trabajo era el editor donde están escribiendo, el sistema se siente congelado.
Round Robin
La idea de Round Robin (RR) es no correr los trabajos hasta el final, sino durante un quantum (time slice), y luego pasar al siguiente de la cola. El quantum tiene que ser un múltiplo del periodo del temporizador: si el temporizador interrumpe cada 10 ms, el quantum puede ser 10, 20 o 30 ms.
Con A, B y C de 6 ticks y quantum 1:
$ ./sched -q 1 rr 6 6 6
política: Round Robin (quantum 1)
       0    5    10   15
gantt  ABCABCABCABCABCABC
...
   A        0        6       0    16       16          0
   B        0        6       1    17       17          1
   C        0        6       2    18       18          2
promedio                                17.00       1.00
La respuesta promedio baja de 6 a 1. Pero miren el retorno: 17, peor que los 12 de SJF y casi el peor posible. RR estira a todos los trabajos: cada uno avanza un poco y todos terminan casi al final.
El tamaño del quantum
Repitiendo la simulación con distintos quantum se ve el compromiso completo:
| Quantum | Respuesta promedio | Retorno promedio |
|---|---|---|
| 1 | 1 | 17 |
| 2 | 2 | 16 |
| 3 | 3 | 15 |
| 6 | 6 | 12 |
Con quantum 6 (igual a la duración de cada trabajo), RR se convierte en FIFO. Un quantum corto da buena respuesta y mal retorno; uno largo, lo contrario. Esto no es casualidad: cualquier política que sea justa en escalas cortas de tiempo, repartiendo la CPU por igual entre los trabajos activos, tiene que retrasar el final de todos ellos. Si quieren buen retorno tienen que ser injustos y dejar que los cortos terminen primero; si quieren buena respuesta, tienen que alternar.
El costo del cambio de contexto
Hay otra razón para no elegir un quantum diminuto: cada cambio de contexto
cuesta. El simulador acepta la opción -c para cobrar un costo fijo en cada
cambio (en el diagrama, *):
$ ./sched -q 3 -c 1 rr 6 6 6
política: Round Robin (quantum 3), cambio de contexto: 1
       0    5    10   15   20
gantt  AAA*BBB*CCC*AAA*BBB*CCC
...
promedio                                19.00       4.00
cambios de contexto: 5 ticks de 23 (22% de la CPU)
Con un costo de 1 tick por cambio:
| Quantum | Ticks perdidos | Ticks totales | CPU perdida |
|---|---|---|---|
| 1 | 17 | 35 | 49 % |
| 3 | 5 | 23 | 22 % |
| 6 | 2 | 20 | 10 % |
La técnica general es la amortización: un costo fijo pesa menos si se paga menos veces. El quantum tiene que ser bastante más grande que el costo del cambio para que la fracción perdida sea pequeña, pero no tanto como para que el sistema deje de responder. Y el costo real de un cambio es más que guardar y cargar registros: el proceso que entra encuentra las cachés, el TLB y el predictor de saltos llenos con datos del anterior, y corre más lento hasta que se vuelven a llenar.
En xv6. El planificador de xv6 es Round Robin en su forma más simple. La función
scheduler()enkernel/proc.ces un bucle infinito que recorre el arregloproc[NPROC]en orden y, para cada proceso en estadoRUNNABLE, lo marcaRUNNINGy le cede la CPU conswtch(&c->context, &p->context). Cuando el proceso devuelve la CPU, el bucle sigue con el siguiente de la tabla. ¿Cuándo la devuelve? Enusertrap()(kernel/trap.c), si la causa del trap fue el temporizador (which_dev == 2), se llama ayield(), que pone al proceso enRUNNABLEy vuelve al planificador consched(). El temporizador se reprograma enclockintr()conw_stimecmp(r_time() + 1000000), que según el comentario del código es alrededor de una décima de segundo: ese es el quantum de xv6. No hay prioridades ni historia. En el proyecto P2 lo van a reemplazar por un planificador por lotería.
Este es el corazón del bucle, recortado (los // ... marcan lo omitido):
// kernel/proc.c, scheduler()
for (;;) {
  // ... (interrupciones)
  for (p = proc; p < &proc[NPROC]; p++) {
    acquire(&p->lock);
    if (p->state == RUNNABLE) {
      p->state = RUNNING;
      c->proc = p;
      swtch(&c->context, &p->context);
      c->proc = 0;  // ...
    }
    release(&p->lock);
  }
  // ... si nadie estaba listo: wfi
}
Y la otra mitad, en usertrap():
// kernel/trap.c: ceder la CPU si fue el temporizador
if (which_dev == 2)
  yield();
Cae el supuesto 4: E/S
Los programas reales hacen E/S. Mientras un proceso espera al disco está bloqueado y no usa la CPU; el planificador debería aprovechar ese tiempo con otro trabajo. Y cuando la E/S termina, la interrupción del disco devuelve el control al kernel, que pasa al proceso de bloqueado a listo y puede decidir si lo corre de inmediato.
Veamos un ejemplo. A usa la CPU 2 ticks, espera 2 ticks de disco, y así tres veces (6 ticks de CPU en total). B no hace E/S y necesita 8 ticks de CPU. Si el planificador trata a A como un solo trabajo y lo corre completo antes de B, la CPU queda ociosa mientras A espera al disco:
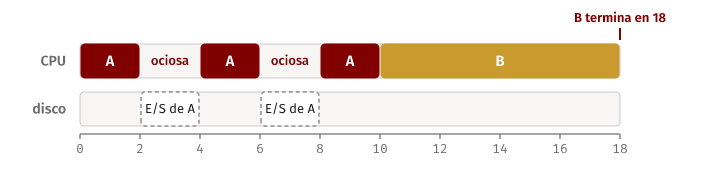
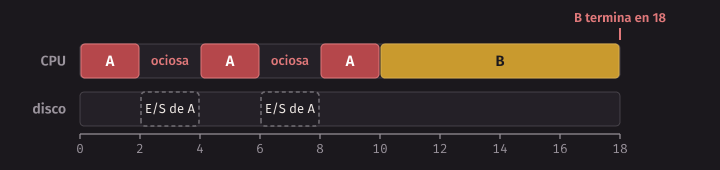
B termina en 18. La solución es tratar cada ráfaga de CPU de A como un trabajo independiente de 2 ticks. Con STCF, al inicio la elección es entre un trabajo de 2 (la ráfaga de A) y uno de 8 (B): corre A. Cuando A pide su E/S, corre B. Cuando la E/S termina, llega una nueva ráfaga de A de 2 ticks, que desaloja a B (al que le quedan 6, y en la siguiente vuelta, 4):
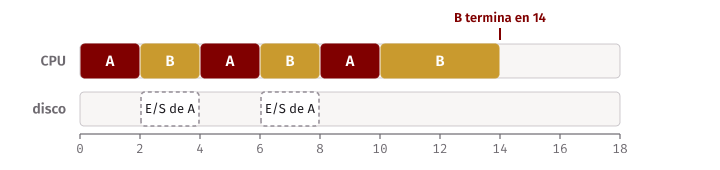
La CPU nunca queda ociosa y B termina en 14 en vez de 18. Esta es la superposición (overlap) de CPU y E/S. El efecto práctico es muy deseable: los procesos interactivos, que hacen ráfagas cortas entre E/S, corren seguido y responden rápido, mientras los procesos de cálculo usan los huecos.
Cae el supuesto 5: no conocemos el futuro
Resumamos lo que tenemos. SJF y STCF optimizan el retorno, pero necesitan saber cuánto dura cada trabajo (o cada ráfaga). Round Robin optimiza la respuesta sin saber nada, pero castiga el retorno. En un sistema real no conocemos las duraciones. La pregunta para la segunda mitad es: ¿se puede tener un buen retorno, como SJF, y una buena respuesta, como RR, sin conocer el futuro? La respuesta clásica es usar el pasado para predecirlo.
Multi-Level Feedback Queue
La MLFQ fue descrita por Fernando Corbató en 1962 para el sistema CTSS, un trabajo que le valió, junto con otros, el premio Turing. La estructura básica es un conjunto de colas, cada una con una prioridad distinta. Cada trabajo listo está en exactamente una cola. En los ejemplos usamos tres: Q2 (la más alta), Q1 y Q0 (la más baja). Las dos primeras reglas dicen a quién elegir:
- Regla 1. Si Prioridad(A) > Prioridad(B), corre A (B no).
- Regla 2. Si Prioridad(A) = Prioridad(B), A y B se turnan en Round Robin.
Hasta aquí es un planificador de prioridades fijas. Lo interesante de MLFQ es que la prioridad cambia según el comportamiento observado. Un trabajo que suelta la CPU a menudo para esperar teclas se parece a un proceso interactivo: merece prioridad alta. Uno que usa la CPU durante mucho tiempo seguido se parece a un cálculo largo: puede esperar.
Reglas 3 y 4: subir y bajar
Llamamos asignación (allotment) a cuánto tiempo de CPU puede usar un trabajo en un nivel antes de bajar de prioridad. Para empezar, la asignación es igual a un quantum. Las reglas de un primer intento son:
- Regla 3. Un trabajo nuevo entra en la cola más alta.
- Regla 4a. Si un trabajo usa toda su asignación, baja un nivel.
- Regla 4b. Si un trabajo suelta la CPU antes de agotar su asignación (por ejemplo, para hacer E/S), se queda en el mismo nivel y su cuenta vuelve a cero.
El simulador mlfq.c implementa estas reglas. La
opción -o usa las reglas viejas 4a/4b; un trabajo se escribe
duración@llegada:ráfaga/espera. Cada fila de la salida es una cola y cada
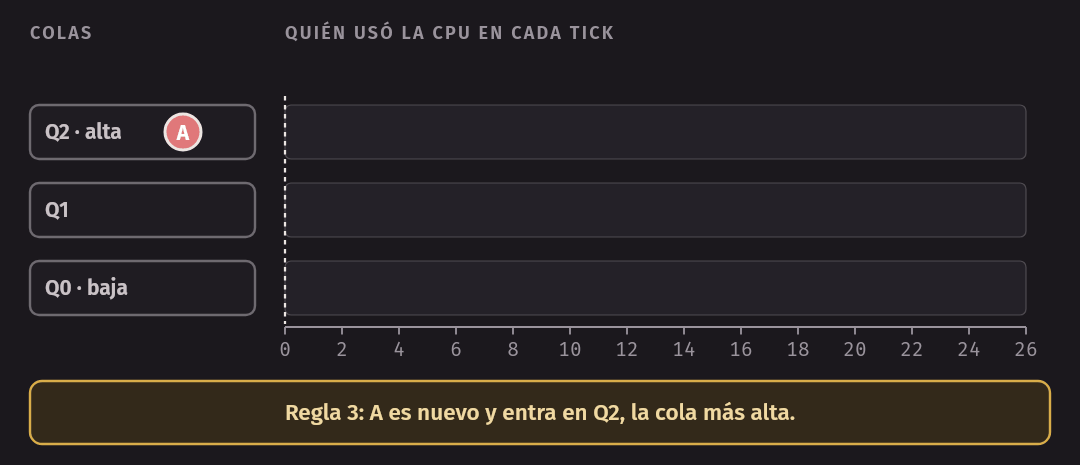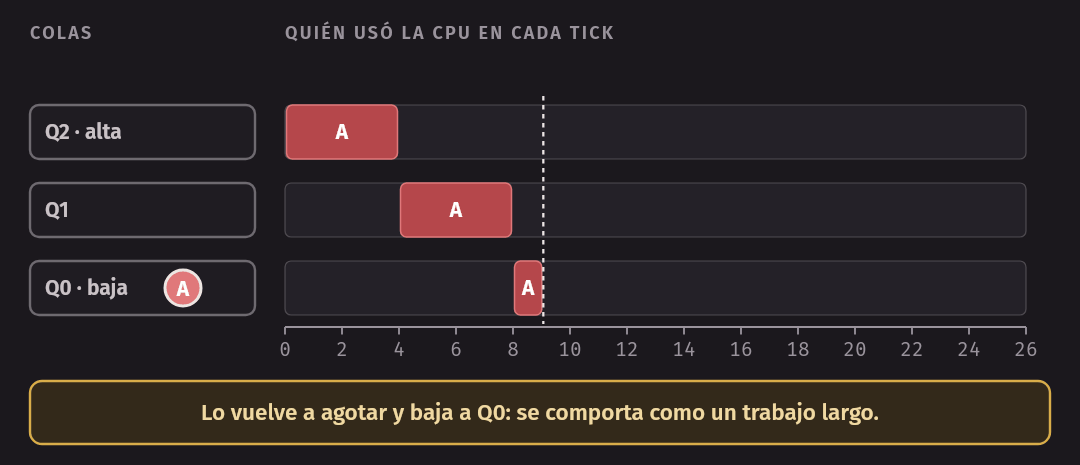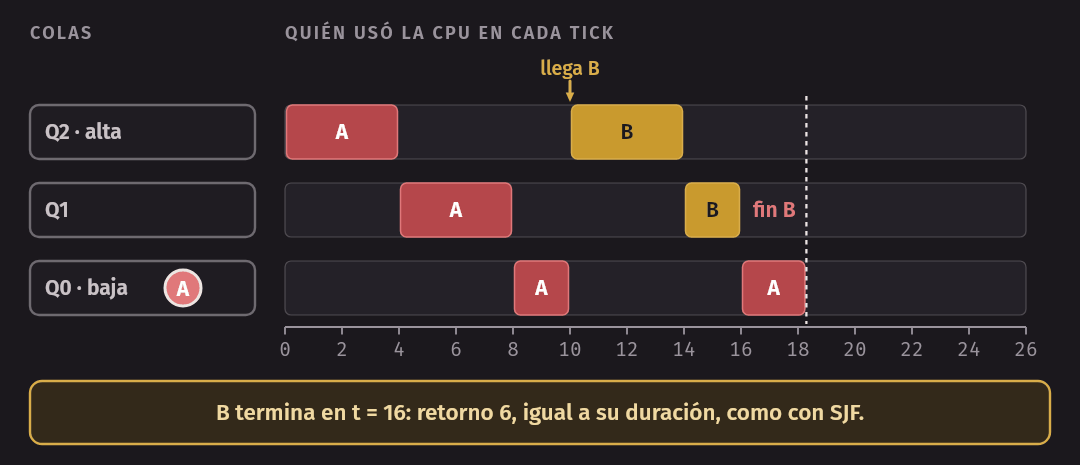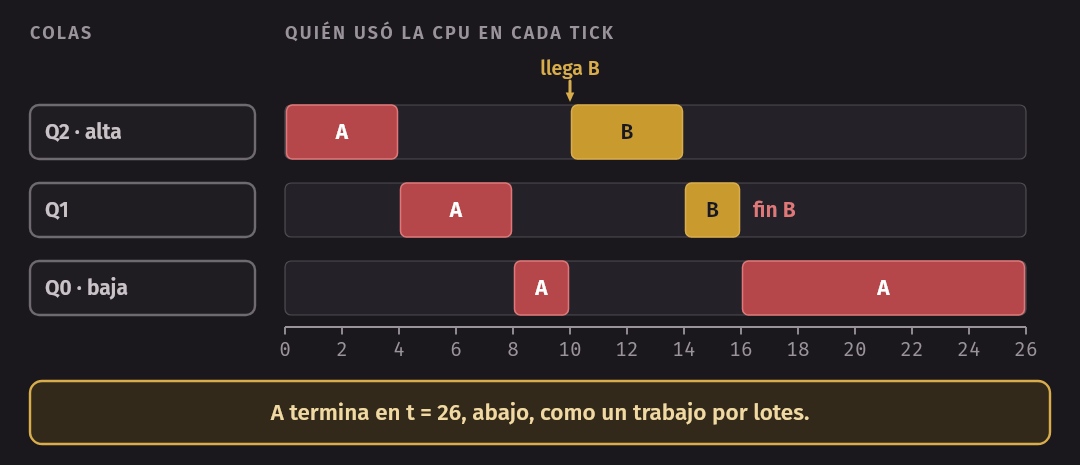
columna un tick. Veamos un trabajo largo A (20) y uno corto B (6) que llega
en t = 10, con quantum 4:
$ ./mlfq 20 6@10
MLFQ: 3 colas, quantum 4, asignación 4, boost no, regla 4
    0    5    10   15   20   25
Q2  AAAA......BBBB............
Q1  ....AAAA......BB..........
Q0  ........AA......AAAAAAAAAA
A entra en Q2 (regla 3), agota su quantum y baja a Q1, y luego a Q0 (regla
4a). Cuando llega B, entra en Q2 y por la regla 1 desaloja a A. B baja a Q1 y
termina en t = 16: su retorno es 6, igual a su duración. Sin saber nada de
antemano, MLFQ trató a B como lo habría hecho SJF.
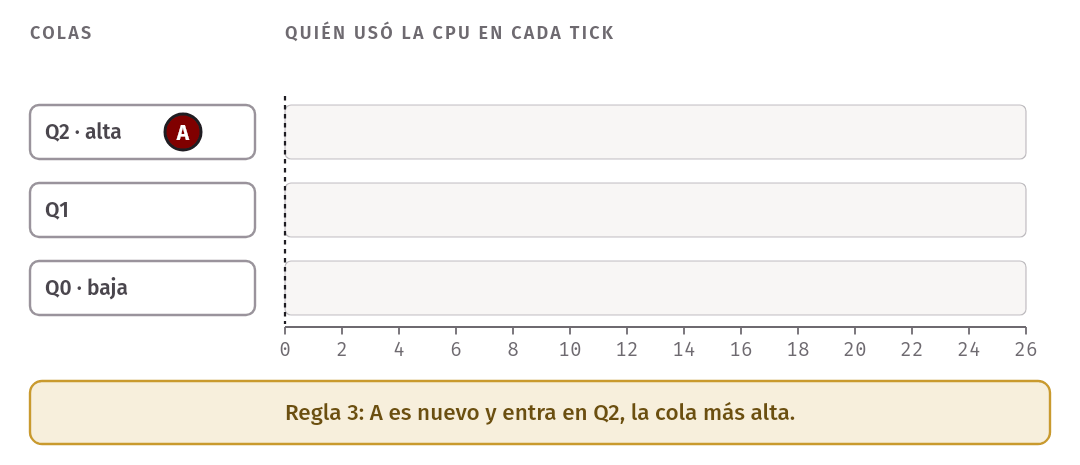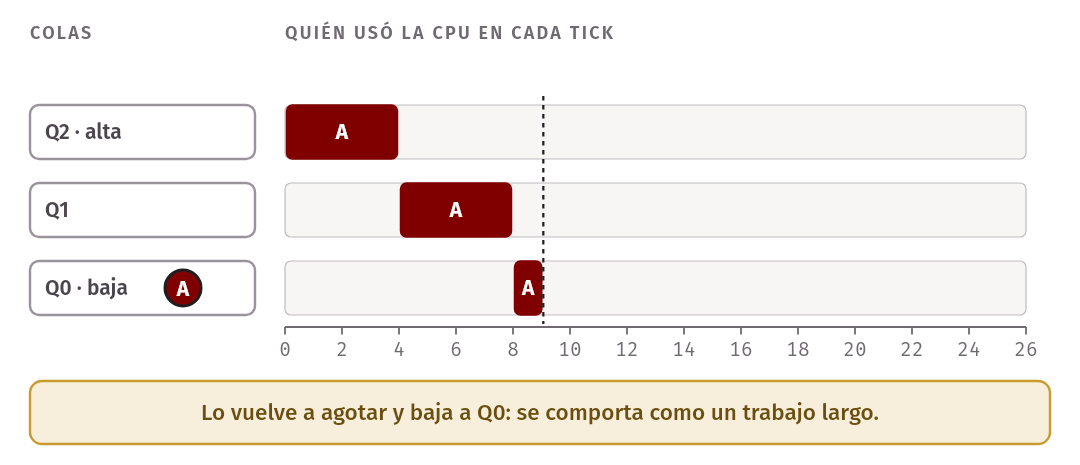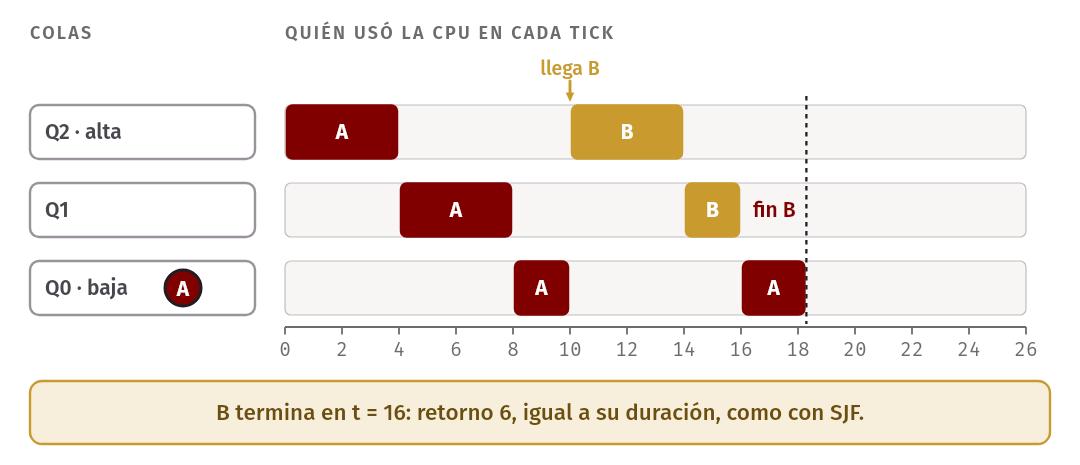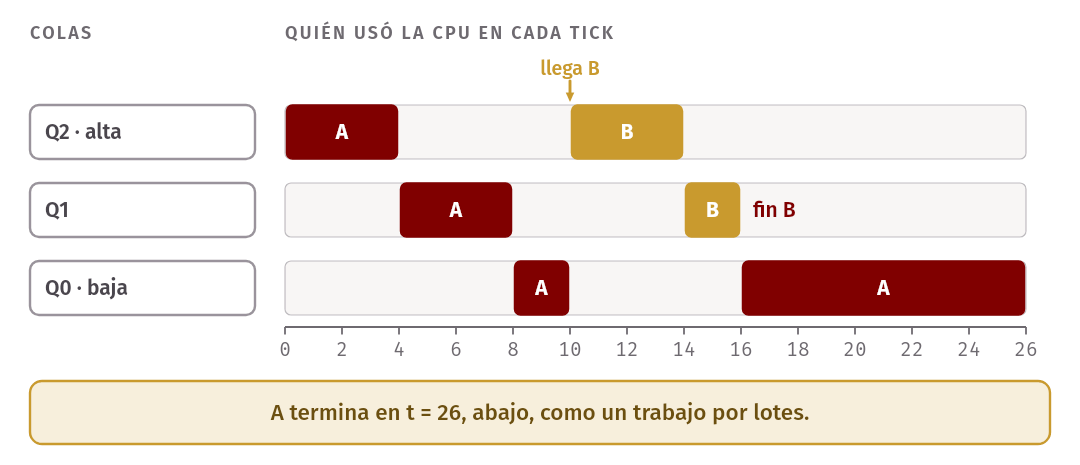
Idea clave. MLFQ apuesta a que cada trabajo nuevo es corto. Si lo es, termina rápido en las colas altas. Si no, va bajando y termina corriendo abajo, como un trabajo por lotes. La duración no se pregunta: se mide.
Ahora un trabajo interactivo: B corre 1 tick y hace E/S de 2 ticks, una y otra vez, como un editor que espera teclas:
$ ./mlfq -o 20 6@8:1/2
    0    5    10   15   20   25
Q2  AAAA....B..B..B..B..B..B..
Q1  ....AAAA..................
Q0  .........AA.AA.AA.AA.AA.AA
B nunca agota su quantum, así que por la regla 4b se queda en Q2 y tiene respuesta inmediata cada vez que vuelve de la E/S. Mientras espera, corre A: CPU y E/S superpuestas.
Problemas del primer intento
Este MLFQ parece funcionar, pero tiene tres problemas serios.
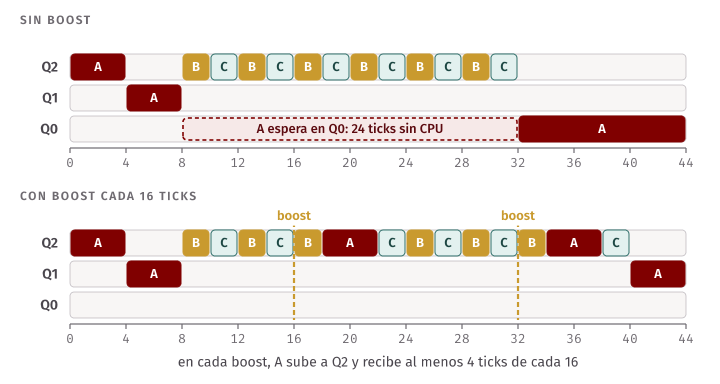
Inanición. Si hay suficientes trabajos interactivos, entre todos pueden mantener la CPU ocupada y los trabajos de abajo nunca corren. Con dos interactivos, B y C, que alternan 2 ticks de CPU y 2 de E/S:
$ ./mlfq -o 20 12@8:2/2 12@8:2/2
    0    5    10   15   20   25   30   35   40
Q2  AAAA....BBCCBBCCBBCCBBCCBBCCBBCC............
Q1  ....AAAA....................................
Q0  ................................AAAAAAAAAAAA
Cuando uno hace E/S, corre el otro, y A no recibe un solo tick entre t = 8 y
t = 32. Con más interactivos, A podría no correr nunca: inanición
(starvation).
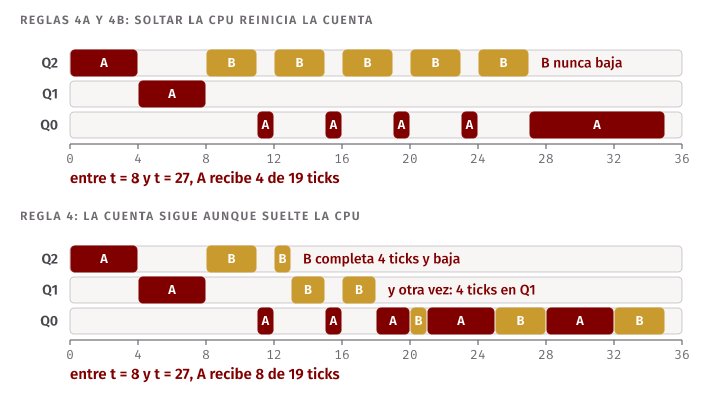
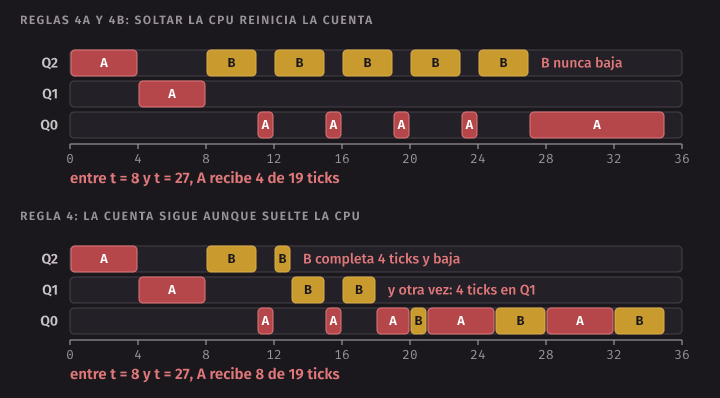
Trampas. Un programa astuto puede engañar al planificador (gaming the scheduler): corre casi todo su quantum y, justo antes de agotarlo, hace una E/S inútil. Por la regla 4b, nunca baja:
$ ./mlfq -o 20 15@8:3/1
    0    5    10   15   20   25   30
Q2  AAAA....BBB.BBB.BBB.BBB.BBB........
Q1  ....AAAA...........................
Q0  ...........A...A...A...A...AAAAAAAA
B usa 3 de cada 4 ticks; entre t = 8 y t = 27, A recibe solo 4 de 19 ticks.
Cambio de comportamiento. Un trabajo puede pasar por una fase de cálculo y luego volverse interactivo. Con estas reglas, una vez que bajó, se queda abajo para siempre.
Regla 5: priority boost
La solución a la inanición y al cambio de comportamiento es la misma:
- Regla 5. Cada cierto periodo S, mover todos los trabajos del sistema a la cola más alta.
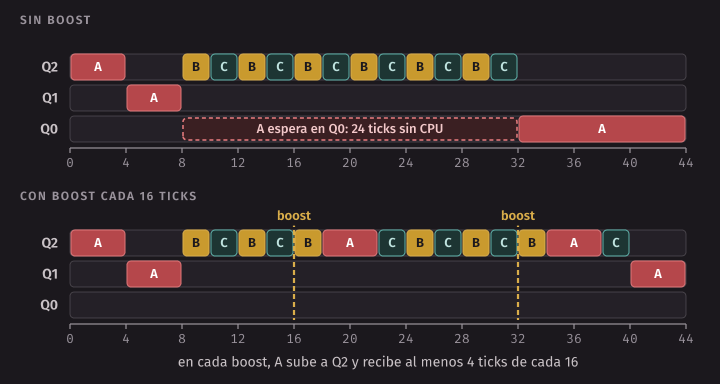
Con el mismo ejemplo de la inanición y S = 16:
$ ./mlfq -o -b 16 20 12@8:2/2 12@8:2/2
    0    5    10   15   20   25   30   35   40
Q2  AAAA....BBCCBBCCBBAAAACCBBCCBBCCBBAAAACC....
Q1  ....AAAA................................AAAA
Q0  ............................................
En cada boost, A sube a Q2, entra en el Round Robin con B y C, usa su asignación y vuelve a bajar. Recibe al menos 4 ticks cada 16: ya no hay inanición. Y un trabajo que se volvió interactivo sube con el boost y, como ya no agota su asignación, se queda arriba.
¿Cuánto debe valer S? Si es muy grande, los trabajos largos pasan hambre durante mucho tiempo; si es muy chico, los interactivos comparten la cola alta con todos los trabajos de cálculo y pierden su ventaja. John Ousterhout llamaba a este tipo de parámetros voo-doo constants: parece que hace falta magia negra para elegirlos bien.
Regla 4: llevar la cuenta
Las trampas vienen de la regla 4b, que olvida cuánto usó un trabajo cada vez que suelta la CPU. La solución es llevar la cuenta (accounting) del tiempo usado en cada nivel, sin importar en cuántos pedazos se usó. Las reglas 4a y 4b se reemplazan por una sola:
- Regla 4. Cuando un trabajo agota su asignación en un nivel (sin importar cuántas veces haya soltado la CPU), baja un nivel.
El mismo tramposo, sin -o:
$ ./mlfq 20 15@8:3/1
    0    5    10   15   20   25   30
Q2  AAAA....BBB.B......................
Q1  ....AAAA.....BB.BB.................
Q0  ...........A...A..AABAAAABBBAAAABBB
En Q2, B usa 3 ticks, hace su E/S y usa 1 más: completó 4 y baja. En Q1 le
pasa lo mismo. En Q0 se turna con A en Round Robin; entre t = 8 y t = 27, A
recibe ahora 8 ticks en lugar de 4.
Idea clave. La regla 4 (contabilidad) existe para que nadie pueda quedarse arriba con trampas; la regla 5 (boost) existe para que nadie se quede abajo para siempre. Son dos problemas distintos con dos soluciones distintas.
Un detalle: con la regla 4, un trabajo interactivo honesto también termina
bajando si acumula suficiente CPU. Por eso, en la práctica, la asignación de
las colas altas suele ser varias veces el quantum (la opción -a del
simulador), y el boost lo devuelve arriba cada cierto tiempo.
Ajuste y sistemas reales
Las cinco reglas dejan muchos parámetros abiertos: cuántas colas, qué quantum y qué asignación en cada una, cada cuánto hacer el boost. No hay valores correctos para todas las cargas; se ajustan (tuning) midiendo. Una práctica común es dar quantum corto a las colas altas (por ejemplo, 10 ms), donde están los trabajos interactivos, y quantum largo a las bajas (cientos de ms), donde están los trabajos de cálculo y la respuesta importa poco: así se hacen menos cambios de contexto donde no hacen falta.
Algunos sistemas reales:
- Solaris, en su clase de planificación Time-Sharing, usa una tabla que el administrador puede modificar. Por defecto tiene 60 colas, con quantum que crece desde 20 ms en la más alta hasta unos cientos de ms en la más baja, y un boost aproximadamente cada segundo.
- FreeBSD (versión 4.3) no usa una tabla sino una fórmula: la prioridad depende de cuánta CPU usó el proceso, y ese uso se va “olvidando” con el tiempo (decay-usage). El efecto del boost aparece de forma gradual.
- Windows NT y sus sucesores también usan una variante de cola multinivel con retroalimentación.
- Muchos sistemas aceptan consejos del usuario. En Unix,
nicesube o baja un poco la prioridad de un proceso. Algunos sistemas reservan las prioridades más altas para el propio kernel.
Linux tomó otro camino: su planificador CFS no usa colas de prioridad sino que reparte la CPU en proporción. Es el tema de la próxima semana, junto con la planificación por lotería.
Planificación de tiempo real
Todas las políticas de este capítulo se juzgaron por promedios: retorno promedio, respuesta promedio. Hay sistemas donde el promedio no sirve de nada. El control de frenos ABS de un auto lee los sensores de las ruedas cada pocos milisegundos y tiene que decidir antes de la siguiente lectura; si una vez de cada mil llega tarde, que las otras 999 hayan sido rapidísimas no consuela a nadie. En un sistema de tiempo real (real-time system), una respuesta correcta que llega tarde es una respuesta equivocada.
Tareas periódicas y plazos
La mayor parte del trabajo de tiempo real es periódico: leer un sensor, mover un actuador, decodificar el siguiente cuadro de video. Lo describimos con tareas periódicas. Cada tarea i tiene:
- un periodo Tᵢ: cada Tᵢ ticks se activa y suelta una nueva instancia (un trabajo, en el lenguaje de este capítulo);
- un tiempo de cómputo Cᵢ: cuánta CPU necesita cada instancia, en el peor caso;
- un plazo (deadline) Dᵢ: cada instancia tiene que terminar a lo más Dᵢ ticks después de soltarse.
En este capítulo usamos siempre Dᵢ = Tᵢ (plazo implícito): cada instancia debe terminar antes de que llegue la siguiente. Un videojuego a 60 cuadros por segundo es una tarea con T = D ≈ 16,7 ms.
Según lo que cuesta perder un plazo, se distinguen dos clases:
- Tiempo real duro (hard real-time): perder un plazo es una falla del sistema. Frenos, airbag, marcapasos, control de vuelo.
- Tiempo real blando (soft real-time): perder un plazo de vez en cuando degrada la calidad, pero el sistema sigue sirviendo. Audio y video, juegos, videollamadas: se nota un salto en la imagen y la vida continúa.
Fíjense en algo: el tiempo real recupera el supuesto 5 que descartamos con MLFQ. Aquí sí se conoce de antemano cuánto dura cada trabajo, porque se mide: Cᵢ es el tiempo de ejecución en el peor caso (worst-case execution time). Sin ese número no hay garantía posible.
La cuenta más importante es la utilización (utilization): qué fracción de la CPU piden todas las tareas juntas.
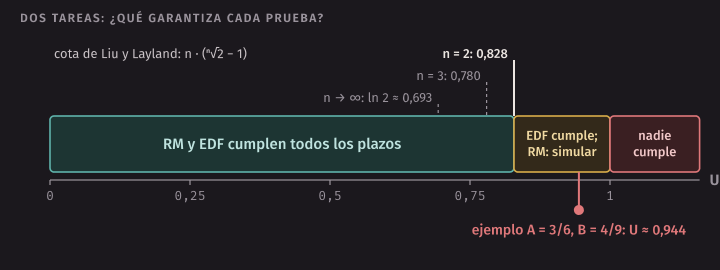
U = C₁/T₁ + C₂/T₂ + ... + Cₙ/TₙSi U > 1, las tareas piden más CPU de la que existe y ninguna política puede cumplir todos los plazos. Si U ≤ 1, la CPU alcanza en promedio, pero falta ver si se puede ordenar el trabajo para que cada instancia llegue a tiempo. Eso depende de la política.
Rate-monotonic: prioridad fija según el periodo
La idea de rate-monotonic (RM) es la más simple que funciona: cada tarea recibe una prioridad fija, más alta cuanto más corto es su periodo, y el planificador siempre corre la instancia lista de mayor prioridad, desalojando a las demás. Es lo mismo que las reglas 1 y 2 de MLFQ, pero la prioridad no se aprende del comportamiento: se asigna una vez, mirando T.
En 1973, Liu y Layland demostraron dos resultados sobre RM con una CPU, desalojo y D = T:
-
Entre todas las políticas de prioridad fija, RM es óptima: si alguna asignación de prioridades fijas cumple todos los plazos, RM también.
-
Con n tareas, RM cumple todos los plazos si
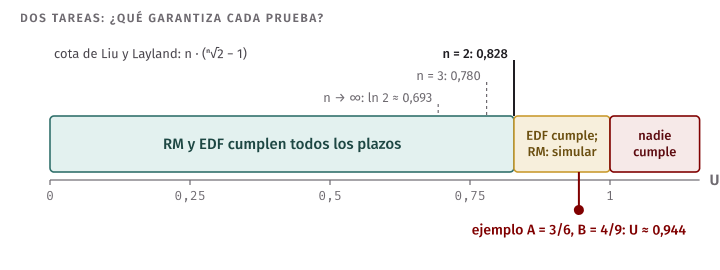
U ≤ n · (2^(1/n) − 1)
La cota baja con n y se acerca a ln 2 ≈ 0,693:
| Tareas n | 1 | 2 | 3 | 4 | → ∞ |
|---|---|---|---|---|---|
| Cota de RM | 1 | 0,828 | 0,780 | 0,757 | 0,693 |
Ojo con la lógica: la prueba es suficiente, no necesaria. Si U está bajo la cota, RM cumple seguro. Si está sobre la cota, la prueba no dice nada: RM puede cumplir o no, y hay que simular.
EDF: el plazo más cercano primero
EDF (Earliest Deadline First) usa prioridad dinámica: en cada momento corre la instancia cuyo plazo absoluto está más cerca. La prioridad de una tarea cambia de una instancia a otra: la misma tarea puede ser la más urgente ahora y la menos urgente dentro de un rato.
El resultado de EDF es más fuerte: con una CPU, desalojo y D = T, EDF cumple todos los plazos si y solo si U ≤ 1. No hay zona gris. Y es óptima: si alguna política puede cumplir los plazos, EDF también.
Un ejemplo: RM pierde un plazo y EDF no
Tomemos dos tareas: A necesita 3 ticks cada 6 y B necesita 4 ticks cada 9.
U = 3/6 + 4/9 = 0,500 + 0,444 = 0,944Está sobre la cota de RM para dos tareas (0,828) y bajo 1: la zona del medio.
El simulador rtsched.c recibe cada tarea como
C/T, simula RM y EDF hasta el hiperperiodo (el mínimo común múltiplo de
los periodos, aquí 18; desde ahí todo se repite) y marca con ! el instante de
cada plazo perdido:
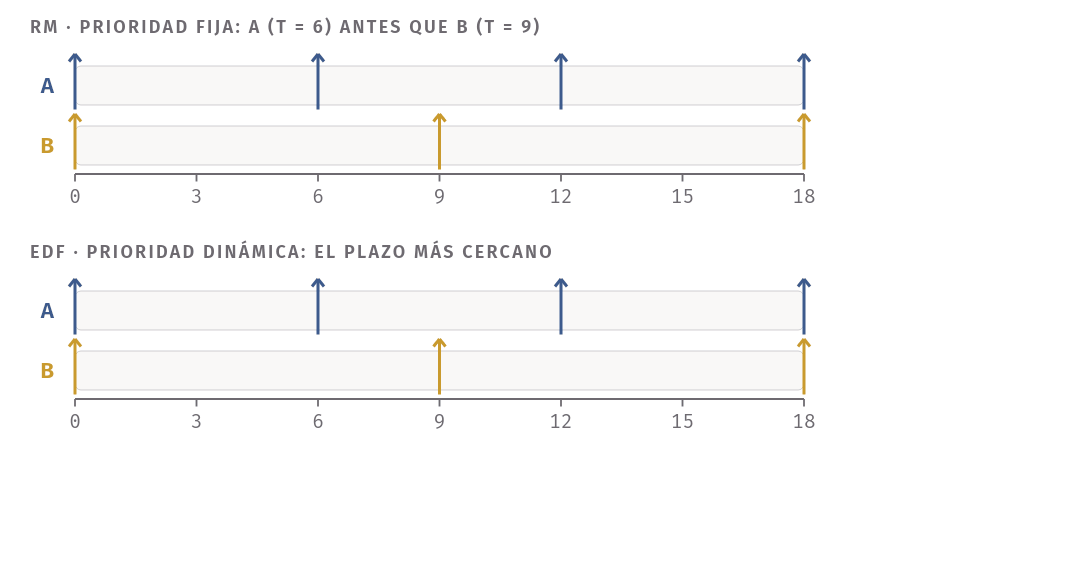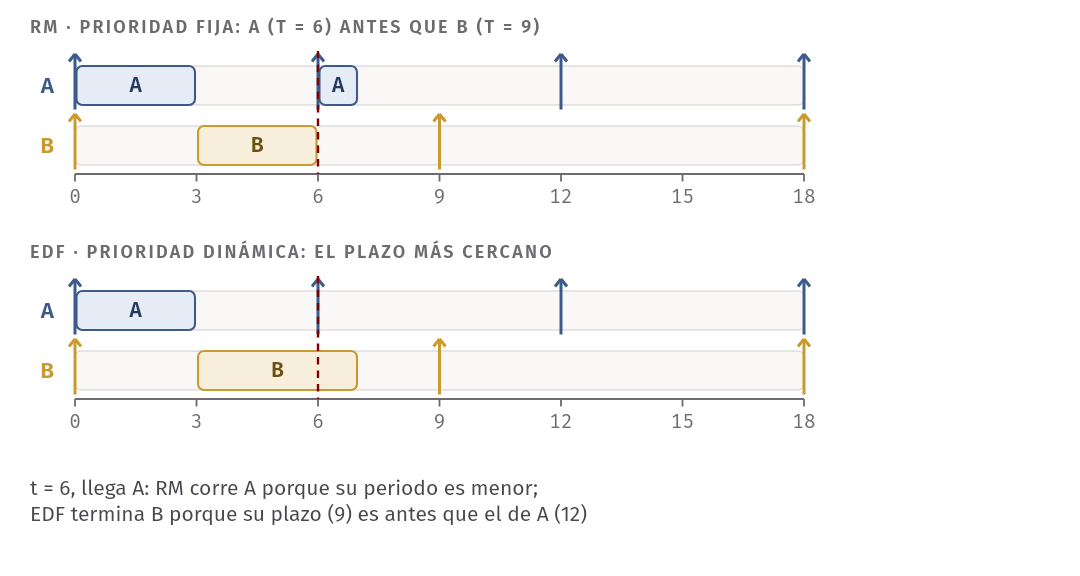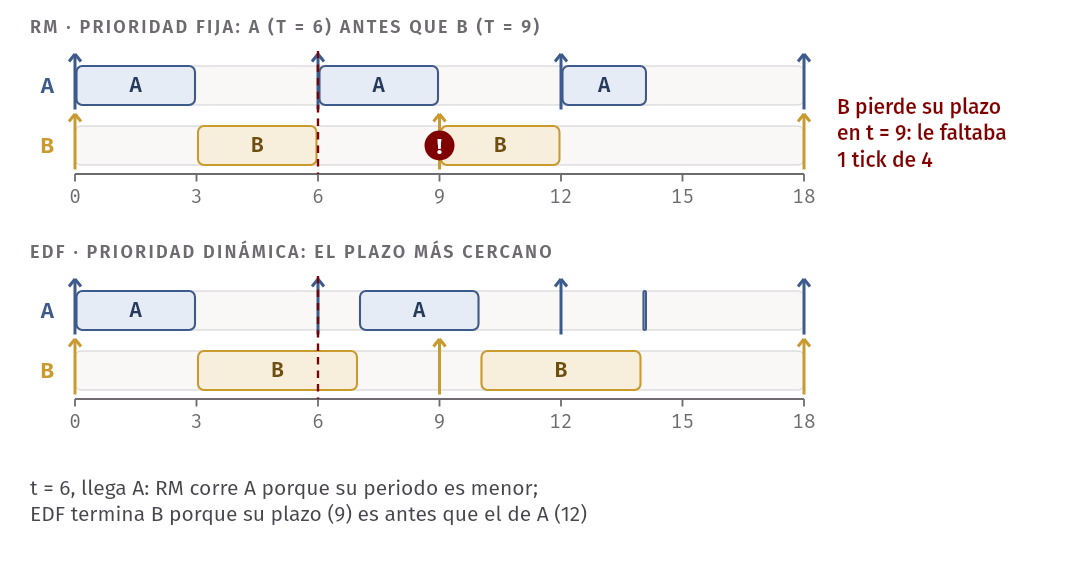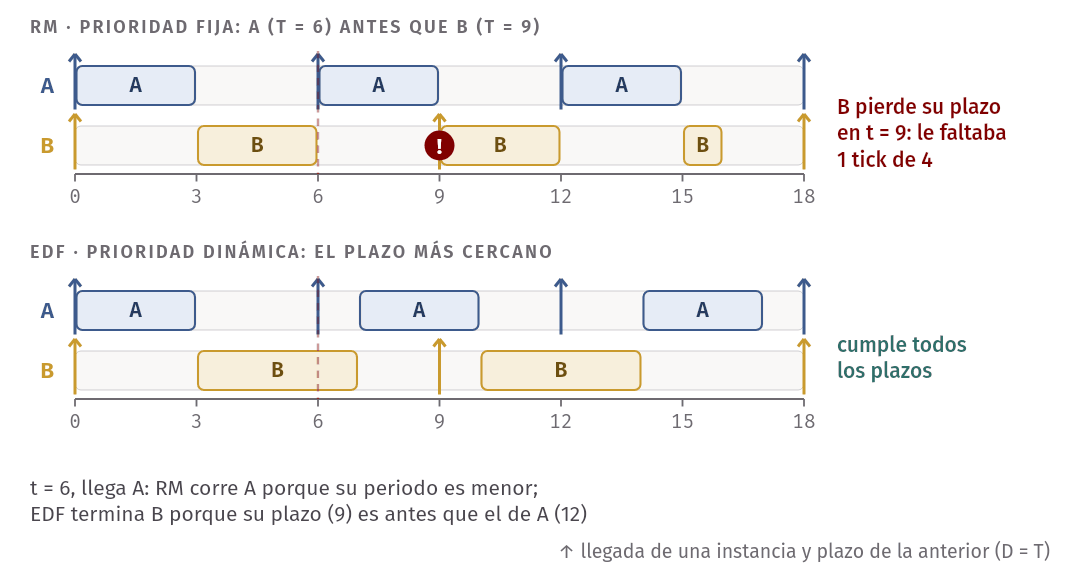
$ ./rtsched 3/6 4/9
tarea   C   T   C/T
  A     3   6  0.500
  B     4   9  0.444
U = 0.944   cota de RM para n = 2: 0.828   hiperperiodo: 18
cota < U <= 1: EDF cumple; RM no está garantizado (hay que simular)

RM (prioridad fija: menor periodo primero)
       0    5    10   15
gantt  AAABBBAAABBBAAAB..
plazo           !
tramos A[0,3) B[3,6) A[6,9) B[9,12) A[12,15) B[15,16) .[16,18)
plazos perdidos: 1
  B en t = 9 (le faltaba 1)

EDF (prioridad dinámica: plazo más cercano primero)
       0    5    10   15
gantt  AAABBBBAAABBBBAAA.
tramos A[0,3) B[3,7) A[7,10) B[10,14) A[14,17) .[17,18)
plazos perdidos: 0
Todo se decide en t = 6. Sigamos las decisiones:
| Tiempo | Qué pasa | RM corre | EDF corre |
|---|---|---|---|
| 0 | Llegan A (plazo 6) y B (plazo 9) | A (periodo 6 < 9) | A (plazo 6 < 9) |
| 3 | Termina A | B | B |
| 6 | Llega A (plazo 12); a B le falta 1 tick | A (periodo 6 < 9) | B (plazo 9 < 12) |
| 7 | EDF: termina B | A | A |
| 9 | Plazo de B; llega B (plazo 18) | B perdió su plazo | A (plazo 12 < 18) |
En t = 6, RM le da la CPU a A porque su periodo es más corto, aunque A tiene
hasta t = 12 para terminar y B solo hasta t = 9. A B le faltaba un tick y
no lo recibe. EDF mira los plazos, termina B en t = 7 y todavía le sobra
tiempo para A. El simulador descarta lo que le faltaba a una instancia que
perdió su plazo (en tiempo real duro, un resultado tarde no sirve), por eso la
segunda instancia de B empieza limpia en t = 9.
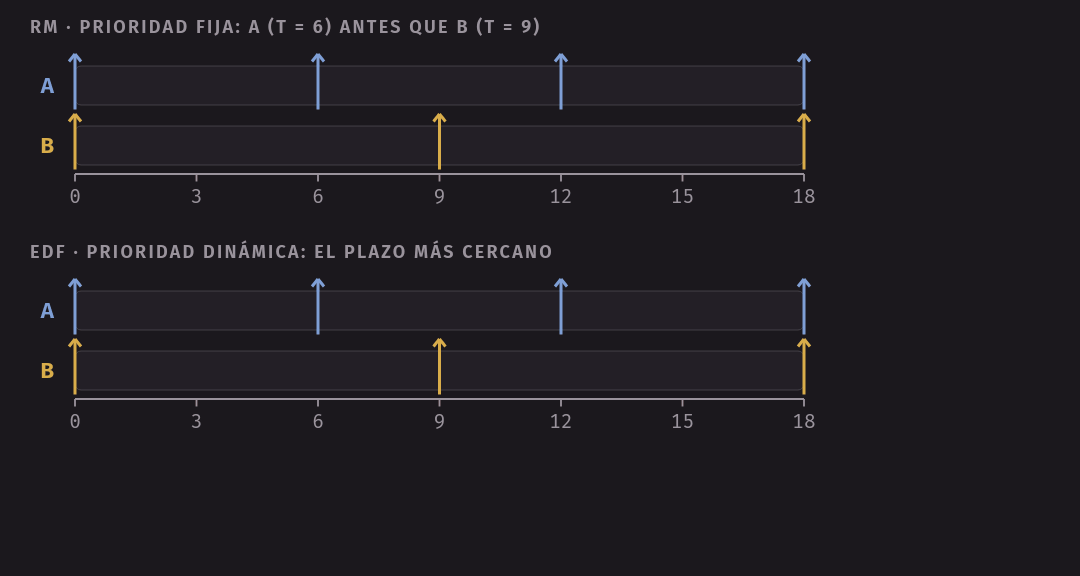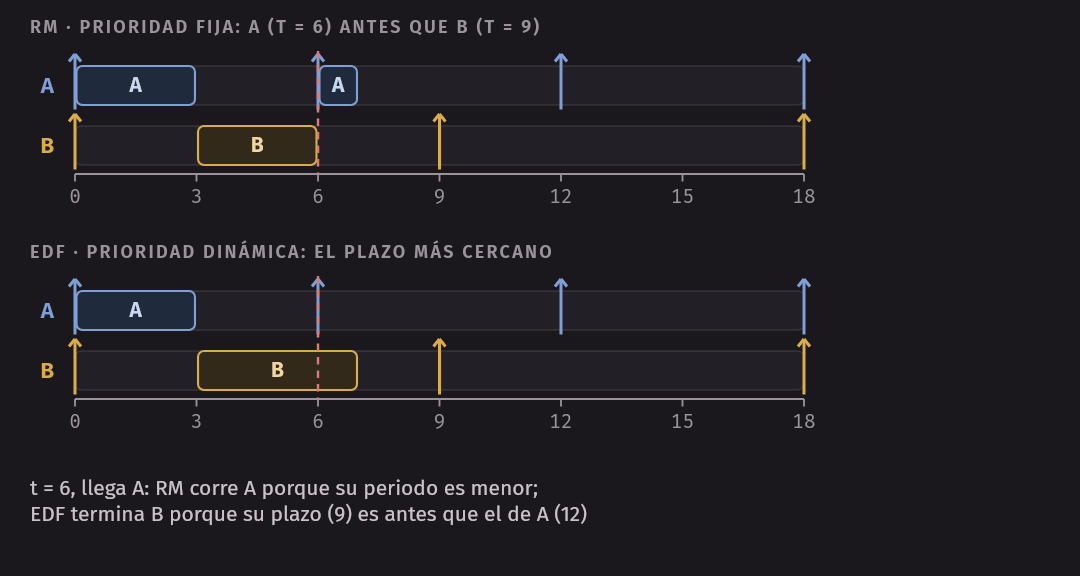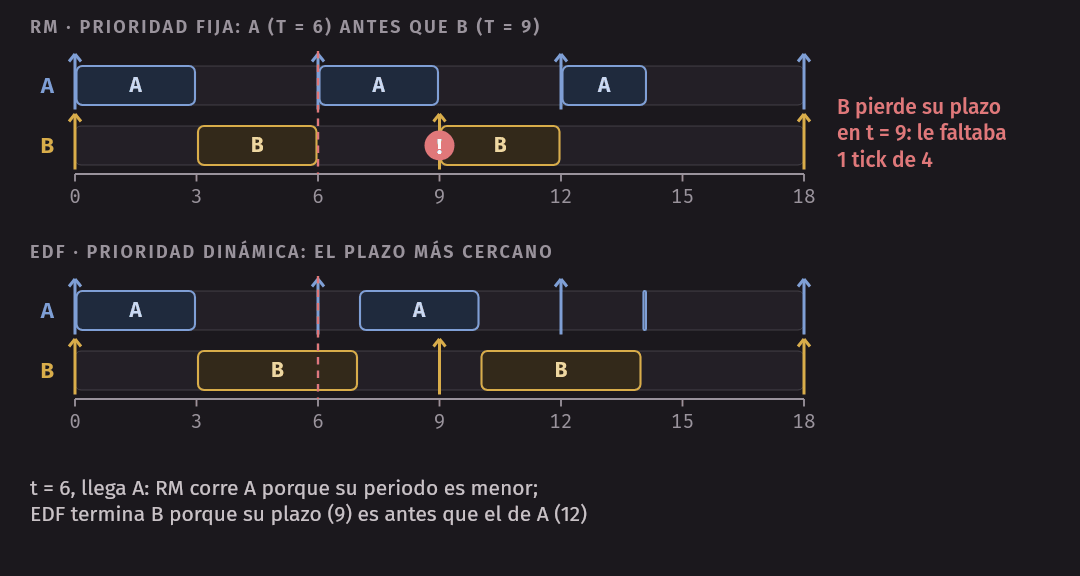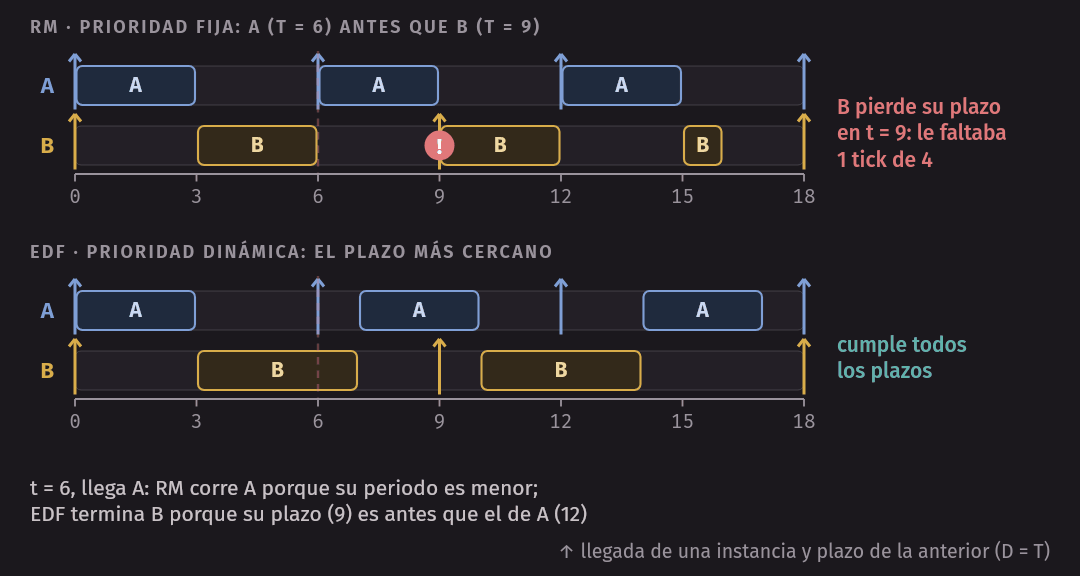
¿Por qué no usar siempre EDF? Porque RM tiene ventajas prácticas. Las prioridades fijas son lo que ofrecen casi todos los kernels de tiempo real y el hardware de interrupciones, y su comportamiento ante una sobrecarga es predecible: si alguien se pasa de su C, pierden plazos las tareas de menor prioridad, que son las de periodo más largo. En EDF, una tarea que se pasa de su tiempo puede retrasar a todas las demás en cadena.
Idea clave. RM ordena las tareas una sola vez, por periodo; EDF las reordena en cada instante, por plazo. Bajo la cota de Liu y Layland las dos cumplen. Entre la cota y 1, EDF cumple siempre y RM depende de los números. Sobre 1 no hay política que salve los plazos.
En Linux: SCHED_FIFO, SCHED_RR y SCHED_DEADLINE
Linux separa los procesos en clases de planificación. Los procesos normales
están en SCHED_OTHER y comparten la CPU con la política que veremos la
próxima semana. Por encima hay tres clases de tiempo real:
SCHED_FIFO: prioridad fija de 1 a 99. Un proceso de esta clase corre hasta que se bloquea, cede la CPU o lo desaloja uno de mayor prioridad; no tiene quantum. Cualquier procesoSCHED_FIFOlisto pasa por delante de todos los procesos normales.SCHED_RR: igual queSCHED_FIFO, pero los procesos de la misma prioridad se turnan en Round Robin con un quantum.SCHED_DEADLINE(desde Linux 3.14): EDF. Cada tarea declara tres números, runtime (≈ C), deadline (D) y period (T), y está por encima deSCHED_FIFO. El kernel, además, vigila que cada tarea no use más de su runtime por periodo, para que una tarea que se pasa no arrastre a las demás.
Con SCHED_FIFO se implementa RM a mano: basta dar más prioridad a la tarea
de periodo más corto. SCHED_DEADLINE hace la prueba de utilización por
ustedes: al pedir la clase, el kernel suma runtime/period de todas las
tareas SCHED_DEADLINE y rechaza la nueva con el error EBUSY si el total
pasa del límite (por defecto, el 95 % de cada CPU). Es la cuenta de U de esta
sección, hecha por el kernel en la llamada al sistema sched_setattr().
La herramienta de línea de comandos es chrt. Dentro del contenedor del curso,
chrt -m muestra el rango de prioridades de cada clase. Para cambiar la clase
hace falta el permiso CAP_SYS_NICE. env/run.sh lanza el contenedor con
ese permiso; sin él (un docker run sin --cap-add=SYS_NICE), chrt -f 50 ...
falla con Operation not permitted:
$ chrt -m
SCHED_OTHER min/max priority    : 0/0
SCHED_FIFO min/max priority     : 1/99
SCHED_RR min/max priority       : 1/99
SCHED_BATCH min/max priority    : 0/0
SCHED_IDLE min/max priority     : 0/0
SCHED_DEADLINE min/max priority : 0/0
$ chrt -f 50 chrt -p 0          # chrt -p 0 corre como SCHED_FIFO 50
pid 10's current scheduling policy: SCHED_FIFO
pid 10's current scheduling priority: 50
$ chrt -d --sched-runtime 3000000 --sched-deadline 6000000 \
       --sched-period 6000000 0 chrt -p 0
pid 11's current scheduling policy: SCHED_DEADLINE
pid 11's current scheduling priority: 0
pid 11's current runtime/deadline/period parameters: 3000000/6000000/6000000
La última línea es la tarea A del ejemplo, con ticks de 1 ms: 3 ms de CPU cada
6 ms (chrt recibe nanosegundos). Un detalle de seguridad: un proceso
SCHED_FIFO con un bucle infinito acapararía su CPU para siempre. Por eso
Linux limita el tiempo de todas las clases de tiempo real juntas a
/proc/sys/kernel/sched_rt_runtime_us (950000) de cada
/proc/sys/kernel/sched_rt_period_us (1000000): el 5 % restante queda para
los procesos normales, entre ellos la shell desde la que se puede matar al
proceso descontrolado.
¿Por qué un sistema de propósito general no garantiza plazos?
Las pruebas de RM y EDF suponen un mundo ideal: el planificador desaloja al instante, C se conoce y nada más usa la CPU. Linux en una laptop rompe las tres suposiciones:
- El peor caso de C es difícil de acotar. Una instancia puede encontrar las cachés y el TLB fríos tras un cambio de contexto, sufrir un fallo de página o esperar a que una página vuelva del swap. El tiempo promedio es bueno; el peor caso, enorme.
- El kernel no siempre se puede desalojar. Mientras corre con las interrupciones deshabilitadas o con un spinlock tomado, ni la tarea más urgente puede entrar. Y las interrupciones de dispositivos corren antes que cualquier proceso, sea de la clase que sea.
- Los locks mezclan prioridades. Si una tarea urgente espera un lock que tiene una tarea de baja prioridad, y esta no corre porque hay otras de prioridad media, la urgente queda esperando a las de prioridad media. Es la inversión de prioridades (priority inversion), que veremos con los locks.
SCHED_FIFOySCHED_RRno tienen control de admisión. Nadie suma U: si las tareas piden más de lo que hay, se pierden plazos sin aviso.
Linux mejora mucho con la opción PREEMPT_RT (incorporada al kernel principal
en la versión 6.12), que hace desalojable casi todo el kernel y lleva la
latencia a decenas de microsegundos. Eso alcanza para muchos sistemas blandos y
para bastante control industrial. Para tiempo real duro con certificación
(aviones, autos, equipos médicos) se usan kernels pequeños diseñados para
acotar cada camino de código, los sistemas operativos de tiempo real
(RTOS), como FreeRTOS, Zephyr, QNX o VxWorks.
Resumen
- El tiempo de retorno (fin − llegada) mide rendimiento; el tiempo de respuesta (primera ejecución − llegada) mide interactividad.
- FIFO es simple pero sufre el efecto convoy. SJF es óptimo para el retorno si todos llegan juntos; STCF, su versión apropiativa, lo es cuando llegan en distintos momentos. Ambos necesitan conocer las duraciones.
- Round Robin da buena respuesta a costa del retorno. El quantum es un compromiso: corto para responder rápido, largo para amortizar el costo del cambio de contexto.
- Tratar cada ráfaga de CPU como un trabajo permite superponer E/S y CPU.
- MLFQ aprende del pasado. Reglas 1 y 2: prioridades y RR. Regla 3: todo trabajo entra arriba. Regla 4: baja quien agota su asignación, con contabilidad para evitar trampas. Regla 5: el boost evita la inanición.
- xv6 usa un Round Robin simple sobre
proc[]con un quantum de un tick del temporizador. - En tiempo real cada tarea periódica pide C de CPU cada T y debe terminar antes de su plazo. La utilización U = Σ Cᵢ/Tᵢ decide: con U > 1 nadie cumple.
- RM (prioridad fija por periodo) cumple si U ≤ n(2^(1/n) − 1); sobre esa cota hay que simular. EDF (prioridad dinámica por plazo) cumple si y solo si U ≤ 1.
- Linux ofrece
SCHED_FIFO,SCHED_RR(prioridades fijas 1–99) ySCHED_DEADLINE(EDF con control de admisión), pero un kernel de propósito general no garantiza plazos duros: latencias no desalojables, peor caso difícil de acotar e inversión de prioridades.
Ejercicios
- Calculen a mano el retorno y la respuesta promedio de FIFO, SJF y RR
(quantum 2) para tres trabajos de duraciones 8, 4 y 2 que llegan en
t = 0. Verifiquen con./sched. - Con trabajos que llegan en
t = 0, ¿para qué cargas da SJF el mismo retorno que FIFO? ¿Y el mismo tiempo de respuesta que RR? Justifiquen y prueben un ejemplo de cada caso con el simulador. - En RR con N trabajos que llegan juntos y quantum q, ¿cuál es el peor tiempo
de respuesta? Expresen la fórmula y verifíquenla con
./sched -q. - Usando la opción
-c, encuentren para la cargarr 6 6 6el quantum más chico que mantiene la CPU perdida por debajo del 15 % cuando un cambio de contexto cuesta 1 tick. - Construyan una carga en la que MLFQ sin boost (
./mlfq -o) deje a un trabajo sin CPU durante al menos 50 ticks. Luego encuentren el periodo de boost más grande con el que ese trabajo recibe al menos el 10 % de la CPU. - Con las reglas 4a/4b, ¿qué patrón
ráfaga/esperale da a un tramposo la mayor fracción de CPU con quantum 4? Comparen con la regla 4 y con-a 8. - Lean
scheduler()enkernel/proc.cde xv6-riscv. Si hay dos procesosRUNNABLEenproc[3]yproc[10], yproc[3]vuelve a estar listo apenas cede la CPU, ¿en qué orden corren durante los siguientes cuatro quanta? ¿Es exactamente Round Robin? - Tres tareas: A = 1/4, B = 2/6 y C = 3/12 (
C/T). Calculen U y compárenla con la cota de RM para tres tareas. ¿Qué garantiza cada prueba? Dibujen a mano los diagramas de RM y EDF hasta el hiperperiodo y verifiquen con./rtsched. - Con A = 2/4 y B = 4/8, U = 1, muy por encima de la cota de RM. Predigan si
RM pierde algún plazo y compruébenlo con
./rtsched. ¿Qué tienen de especial estos periodos? Inventen otro par con U = 1 donde RM sí pierda. - A = 1/4 y B = C/10. Encuentren el mayor C que pasa la prueba de Liu y Layland, el mayor con el que EDF cumple todos los plazos y el mayor con el que RM los cumple según el simulador. Comparen los tres valores y expliquen la diferencia.
- Un proceso con
SCHED_FIFOy prioridad 50 entra en un bucle infinito en una máquina con una sola CPU. ¿Qué les pasa a los procesos normales? ¿Qué cambia sisched_rt_runtime_usvale -1? Luego: en esa misma máquina ya corre una tareaSCHED_DEADLINEcon runtime 5 ms y period 10 ms; ¿qué responde el kernel si otra pide runtime 5 ms y period 10 ms? ¿Y si pide 4 ms cada 10 ms?