
Apuntes · Capítulo 4CPU
Lotería, varios CPUs y un primer vistazo a xv6
Lotería, varios CPUs y un primer vistazo a xv6
La semana pasada construimos planificadores que optimizan el tiempo de retorno (turnaround time) y el tiempo de respuesta (response time), hasta llegar a MLFQ. Este capítulo cambia la pregunta: a veces interesa qué fracción de la CPU recibe cada uno, por ejemplo dos máquinas virtuales que pagan por el 75 % y el 25 % de un servidor. Esa es la planificación proporcional (proportional share): lotería, stride y el CFS de Linux.
Después salimos del supuesto de un solo CPU, donde aparecen cachés con copias del mismo dato y colas que se vuelven cuello de botella. Cerramos con el primer contacto práctico con xv6-riscv: cómo arranca, cómo viaja una llamada al sistema y cómo se agrega una nueva.
Ruta de lectura.
- Antes de clase (15–20 min): «Boletos» e «Implementación», de «Planificación por lotería», y «Cierre de la virtualización de la CPU».
- En clase: sesión A, «Planificación por lotería», «Stride: la lotería sin azar» y «El planificador de Linux: CFS»; sesión B, «Planificación con varios CPUs»; laboratorio, «Primer contacto con xv6-riscv».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 9 y 10, «Moneda, transferencia e inflación» y «Desde Linux 6.6: EEVDF».
Lectura. Este capítulo acompaña a OSTEP cap. 9 Scheduling: Proportional Share, cap. 10 Multiprocessor Scheduling (Advanced) y cap. 11, el diálogo que cierra la virtualización de la CPU. El código está en
code/week-04y se compila conmakedentro del contenedor del curso.
Planificación por lotería
Boletos
Cada proceso recibe un número de boletos (tickets). La fracción de CPU que le corresponde es la fracción de boletos que tiene. Si A tiene 300 boletos y B tiene 100, A debe recibir 300/400 = 75 % de la CPU y B, 25 %.
En la lotería (lottery scheduling), en cada quantum se sortea un boleto y corre su owner. Nadie lleva la cuenta de cuánto corrió cada uno: la proporción sale de la probabilidad.
Implementación
Basta una lista de procesos y un generador de números aleatorios. Se sortea un número entre 0 y el total menos 1, y se recorre la lista sumando boletos hasta pasarlo:
// Recorre la lista sumando boletos hasta pasar al ganador: O(n).
static int pick_winner(struct job *jobs, int n, int winner) {
    int counter = 0;
    for (int i = 0; i < n; i++) {
        counter += jobs[i].tickets;
        if (counter > winner)
            return i;
    }
    return n - 1;  // no debería pasar
}
Con A = 100 boletos y B = 50, A es owner de los números 0 a 99 y B de 100 a 149. Si sale el 112, el recorrido suma 100 (no pasa) y luego 150 (pasa): gana B. Ordenar la lista de mayor a menor acorta el recorrido promedio.
El programa lottery.c simula esto con una
semilla fija, para que el resultado sea reproducible:
$ ./lottery 7 20 100 50
quantum  1: boleto  33 -> A
quantum  2: boleto  55 -> A
...
quantum  7: boleto 112 -> B
...
  boletos  esperado  obtenido
A     100     66.7%     55.0%
B      50     33.3%     45.0%

$ ./lottery 7 10000 100 50 | tail -3
  boletos  esperado  obtenido
A     100     66.7%     66.9%
B      50     33.3%     33.1%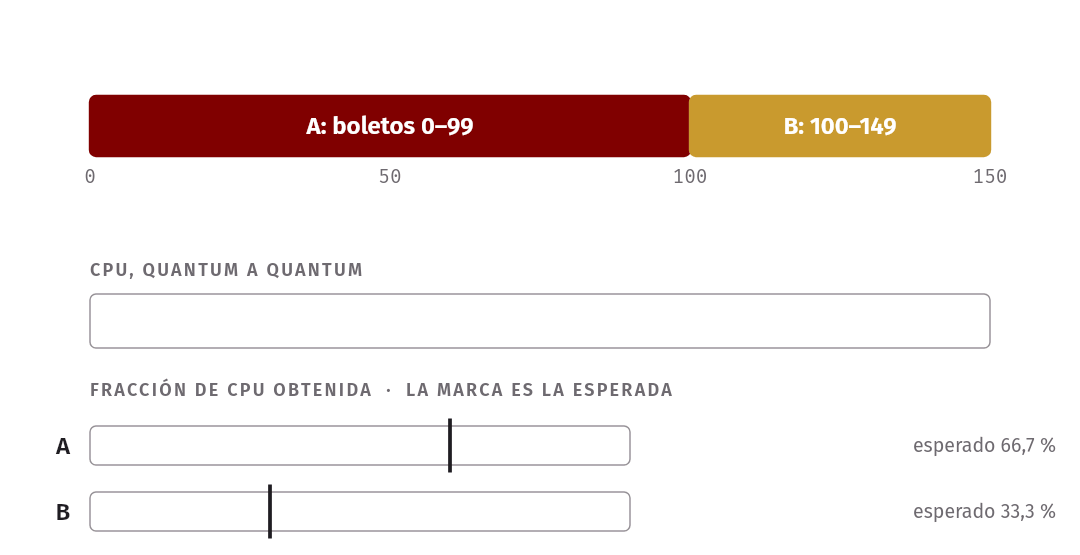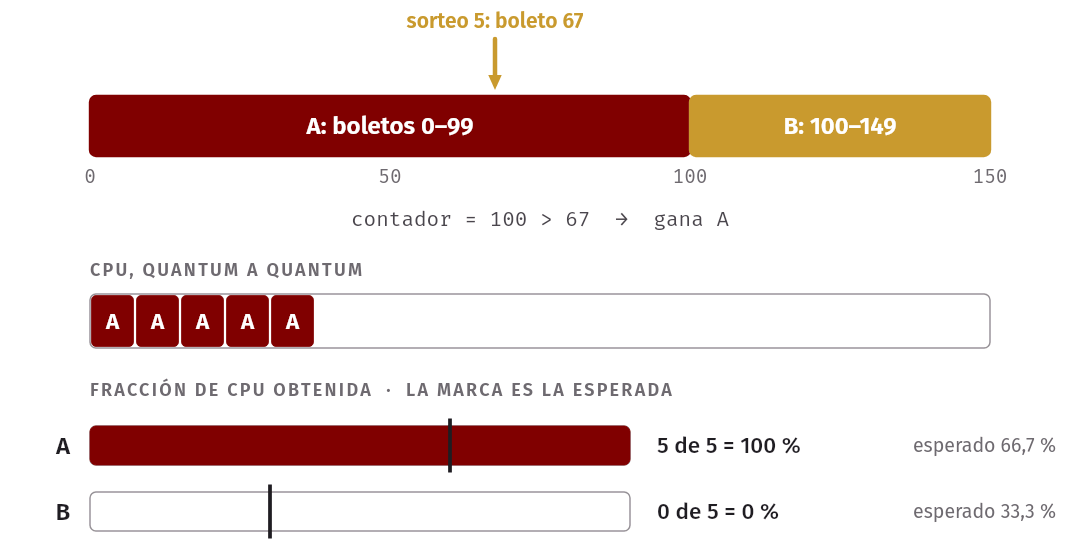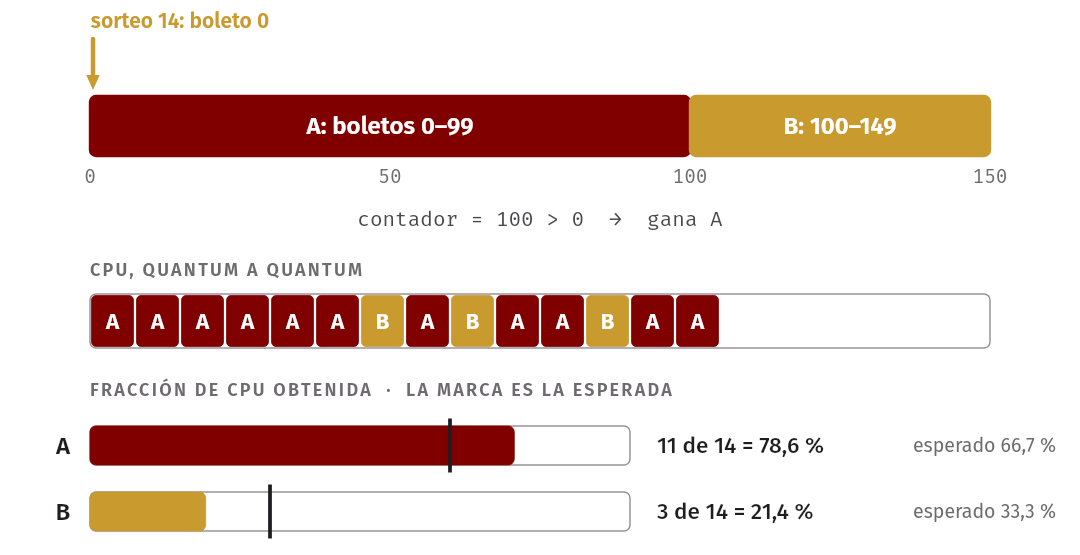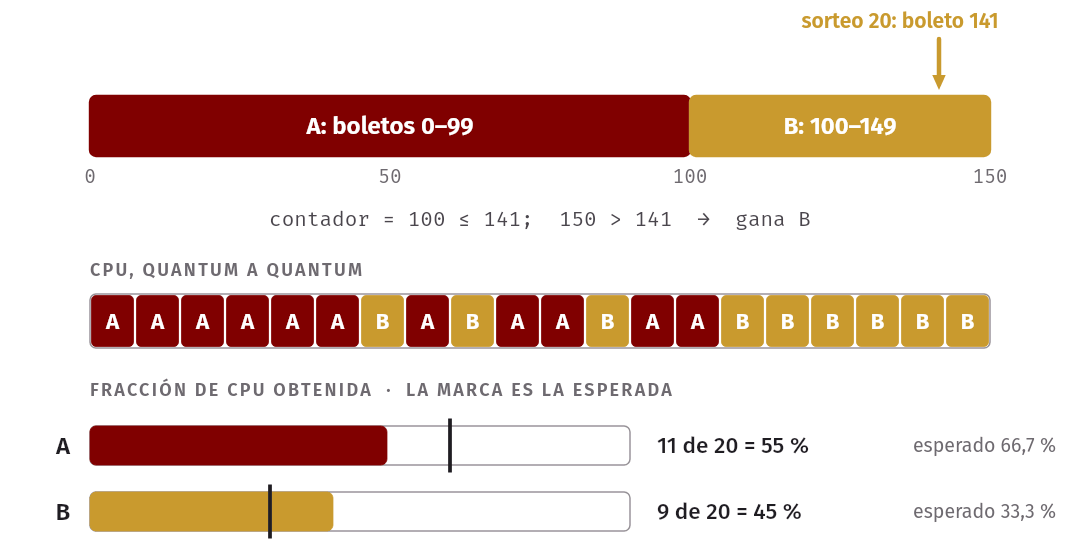
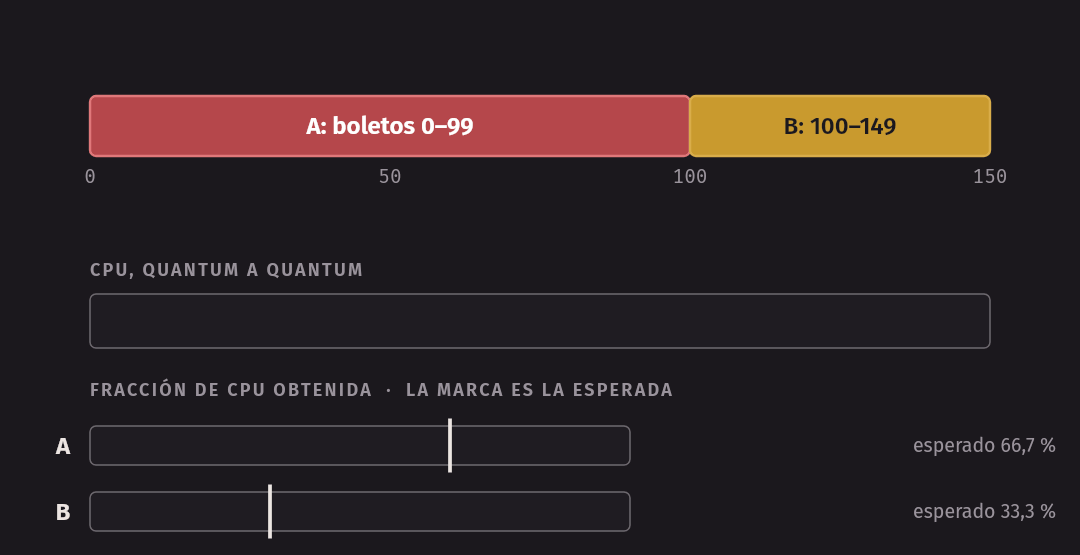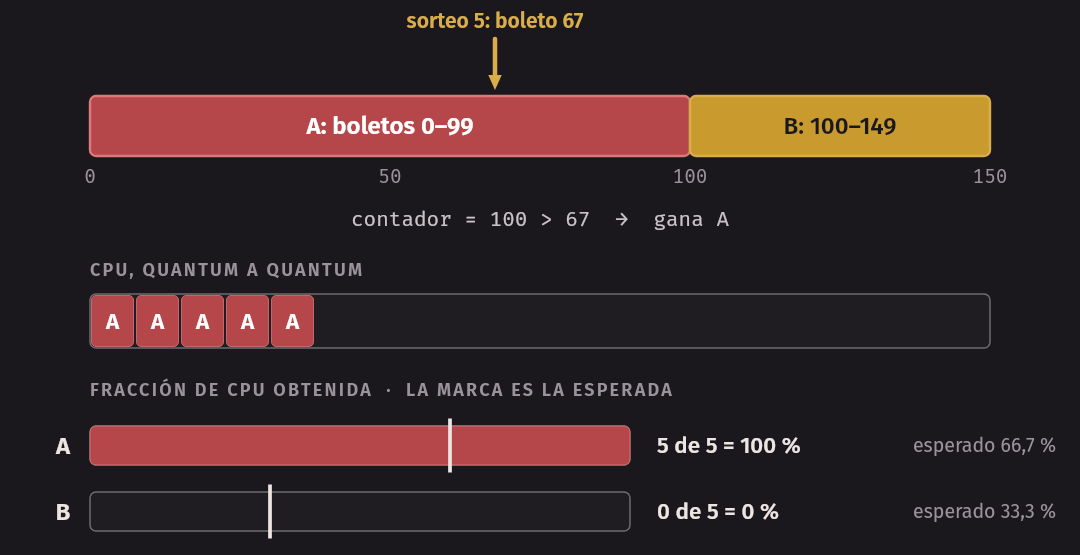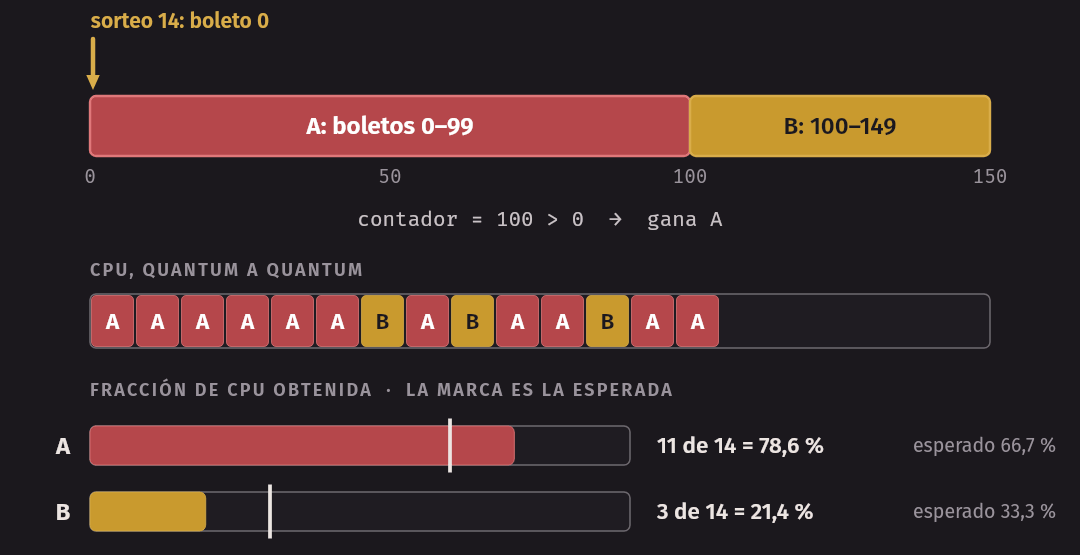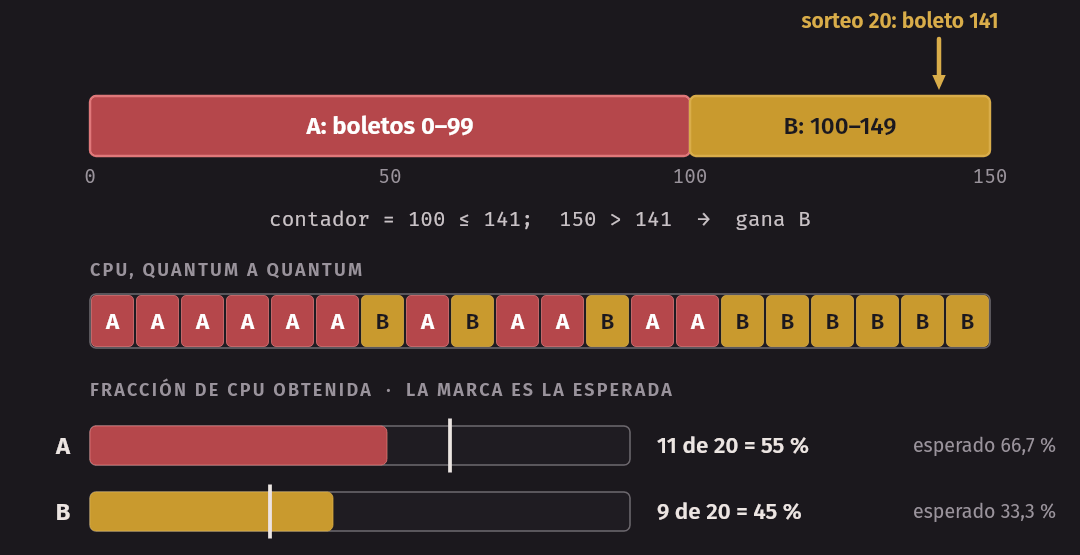
En 20 quanta, A recibió el 55 % en lugar del 66,7 %; en 10 000, la diferencia es de una décima. La lotería es justa en probabilidad. A cambio, casi no guarda estado: agregar un proceso es sumar sus boletos al total.
¿Qué tan justa es en el corto plazo?
Tomemos dos trabajos iguales (mismos boletos y duración) y definamos la
injusticia U como el instante en que termina el primero
dividido entre el instante en que termina el segundo. Si terminan juntos,
U = 1; si uno termina mucho antes, U se acerca a 0,5.
fairness.c promedia 2000 ensayos por duración:
| Duración (quanta) | U lotería | U stride |
|---|---|---|
| 1 | 0,500 | 0,500 |
| 10 | 0,823 | 0,950 |
| 100 | 0,943 | 0,995 |
| 1000 | 0,982 | 1,000 |
La lotería necesita trabajos largos para ser justa. La columna de stride la explicamos en la siguiente sección.
Moneda, transferencia e inflación
Los boletos sirven además como un “dinero” manipulable:
- Moneda (ticket currency). Cada usuario reparte boletos en su propia moneda entre sus procesos, y el sistema los convierte a boletos globales. Supongamos que Ana y Beto tienen 100 boletos globales cada uno. Ana reparte 500 de su moneda a A1 y 500 a A2; Beto da 10 de la suya a su único proceso B1. Al convertir, A1 y A2 valen 50 globales cada uno y B1 vale 100.
- Transferencia (ticket transfer). Un cliente que espera a un servidor le presta sus boletos, para que lo atienda rápido, y los recupera al terminar.
- Inflación (ticket inflation). Un proceso sube o baja sus propios boletos. Solo tiene sentido entre procesos que confían entre sí.
Queda una pregunta abierta: ¿cuántos boletos le doy a cada uno? El mecanismo reparte bien, pero no decide la proporción.
Idea clave. La lotería implementa una proporción con muy poco estado: boletos y un número aleatorio. El precio es la imprecisión en el corto plazo.
Stride: la lotería sin azar
Stride scheduling logra la misma proporción de forma determinista. Cada proceso tiene un stride (paso) inversamente proporcional a sus boletos, stride = L / boletos, donde L es una constante grande, y un contador pass que empieza en 0. La regla:
- Correr el proceso con menor
pass(en empate, el de menor índice). - Al terminar su quantum, sumarle su stride a su
pass.
Más boletos significa stride pequeño: el pass crece despacio y vuelve a ser
el menor más seguido.
Un ejemplo paso a paso
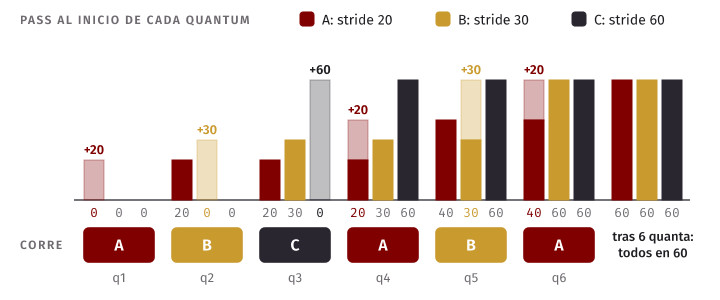
Tres procesos con boletos 3, 2 y 1, y L = 60. Los strides son
A = 60/3 = 20, B = 60/2 = 30 y C = 60/1 = 60.
stride.c imprime la traza:
$ ./stride 60 6 3 2 1
stride:  A=20  B=30  C=60

pass al inicio de cada quantum:
q      A       B       C   corre
1      0       0       0   A
2     20       0       0   B
3     20      30       0   C
4     20      30      60   A
5     40      30      60   B
6     40      60      60   A

veces que corrió:  A=3  B=2  C=1
Al inicio todos tienen pass 0 y por el desempate corre A, que pasa a 20.
Luego corren B (0 → 30) y C (0 → 60). En el cuarto quantum el menor es A (20),
en el quinto B (30) y en el sexto A (40). Tras 6 quanta, A corrió 3 veces, B 2
y C 1: exactamente 3 : 2 : 1, y los tres pass vuelven a valer 60. Por eso
stride es casi perfecto en la tabla de injusticia.
El costo: estado global
¿Con qué pass empieza un proceso que llega cuando los demás van en 10 000? Si
empieza en 0, acapara la CPU durante muchísimos quanta. La solución es
darle el pass mínimo de los procesos listos.
| Lotería | Stride | |
|---|---|---|
| Proporción | Correcta en promedio | Exacta en cada ciclo |
| Estado | Solo boletos | Un pass por proceso |
| Proceso nuevo | Sumar sus boletos | Darle el pass mínimo |
| Elegir | O(n) con una lista | O(log n) con un heap |
El planificador de Linux: CFS
El Completely Fair Scheduler (CFS) fue el planificador de procesos normales de Linux desde la versión 2.6.23 (2007) hasta la 6.5. Es, en esencia, stride con otros nombres.
vruntime
Cada proceso acumula un vruntime (virtual runtime): el tiempo de CPU que
lleva usado, medido en tiempo virtual. El planificador siempre elige al de
menor vruntime, que es el que menos CPU ha recibido. vruntime cumple el
papel de pass.
CFS no usa un quantum fijo: reparte un periodo, sched_latency, entre los n
procesos listos, con un mínimo, min_granularity, para que con muchos procesos
los cambios de contexto no dominen. OSTEP usa 48 ms y 6 ms como ejemplo; en
Linux real se escalaban según el número de CPUs.
Un proceso que durmió mucho tiene un vruntime muy bajo y, si volviera con
ese valor, acapararía la CPU. Por eso, al despertar, recibe como mínimo el
vruntime más bajo de los listos: el mismo problema del proceso nuevo en
stride, con la misma solución.
Pesos y nice
La prioridad se expresa con el valor nice, de −20 (más prioridad) a 19
(menos). Cada nivel se traduce en un peso, y el peso hace de boletos. La
tabla de Linux (sched_prio_to_weight, en kernel/sched/core.c) asigna 1024
a nice 0 y cambia en un factor de aproximadamente 1,25 por nivel:
nice |
−5 | 0 | 1 | 5 | 10 | 19 |
|---|---|---|---|---|---|---|
| peso | 3121 | 1024 | 820 | 335 | 110 | 15 |
Los pesos intervienen en dos lugares:
slice(i)     = sched_latency * peso(i) / (suma de todos los pesos)
vruntime(i) += tiempo_corrido(i) * 1024 / peso(i)
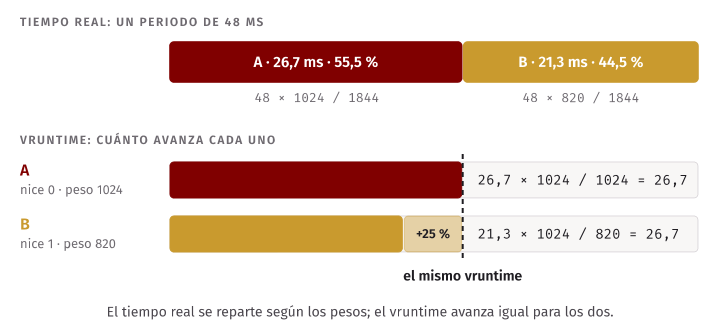
Ejemplo con números. A tiene nice 0 (peso 1024) y B nice 1 (peso 820).
La suma es 1844. Con un periodo de 48 ms:
- A corre 48 × 1024 / 1844 = 26,7 ms (55,5 %).
- B corre 48 × 820 / 1844 = 21,3 ms (44,5 %).
- El
vruntimede A sube 26,7 × 1024 / 1024 = 26,7. - El
vruntimede B sube 21,3 × 1024 / 820 = 26,7.
El tiempo real se reparte según los pesos, pero el tiempo virtual
avanza igual para los dos: la justicia de CFS consiste en igualar los
vruntime.
cfs.c simula la regla con un quantum fijo de 1 ms
(una simplificación):
$ ./cfs 30 0 1
ms  1: corre A   vruntime:  A=1.00  B=0.00
ms  2: corre B   vruntime:  A=1.00  B=1.25
ms  3: corre A   vruntime:  A=2.00  B=1.25
...
ms 12: corre A   vruntime:  A=7.00  B=6.24

$ ./cfs 1000 0 5 | tail -3
trabajo  nice   peso  esperado  obtenido
   A       0   1024     75.3%     75.3%
   B       5    335     24.7%     24.7%
B suma 1,25 de vruntime por milisegundo y A suma 1: por eso a veces A corre
dos veces seguidas. Con nice 5,
B recibe una cuarta parte de la CPU: 335 / (1024 + 335) = 24,7 %.
El árbol rojo-negro
CFS guarda los procesos listos (no los que duermen) en un árbol
rojo-negro ordenado por vruntime: un árbol binario balanceado donde
insertar y borrar cuestan O(log n). El siguiente es el nodo de más a la
izquierda, que Linux mantiene a mano. Si el árbol tiene 7, 12, 15, 20, 31 y
40, corre el de 7; si al terminar vale 25, se reinserta entre 20 y 31, y el
siguiente es el de 12.
Desde Linux 6.6: EEVDF
Desde Linux 6.6 (octubre de 2023), la clase de planificación de los procesos
normales (SCHED_NORMAL, en kernel/sched/fair.c) ya no elige como CFS sino
con EEVDF (Earliest Eligible Virtual Deadline First), un algoritmo
publicado por Ion Stoica y Hussein Abdel-Wahab en 1995. Mucho de lo anterior se
conserva: pesos, nice, vruntime y el árbol rojo-negro. Lo que cambia es la
regla de elección:
- Elegibilidad. El lag de un proceso es cuánta CPU se le debe respecto
de lo que le correspondía. Un proceso es elegible si su lag es mayor o igual
que cero, es decir, si su
vruntimeno supera el promedio ponderado de losvruntimede la cola. - Deadline virtual. Cada proceso tiene un deadline virtual igual a su
vruntimemás su slice escalado por el peso (slice × 1024 / peso). Entre los elegibles, corre el de deadline más temprano. En el kernel actual el árbol está ordenado por ese deadline.
Desaparecen sched_latency y min_granularity; queda un slice base (hoy de
unos 0,7 ms, escalado según el número de CPUs). En versiones posteriores a la
6.6, un proceso puede pedir un slice más corto con sched_setattr(): adelanta
su deadline y responde antes, sin recibir más CPU en total.
Idea clave. Lotería, stride, CFS y EEVDF dan a cada proceso una “moneda” (boletos, peso) y llevan la cuenta de cuánto ha recibido.
Planificación con varios CPUs
Cachés y coherencia
Cada CPU tiene su propia caché, pequeña y rápida (unos pocos nanosegundos frente a decenas en la memoria principal). Funciona por localidad temporal y espacial, y trae líneas de 64 bytes, no bytes sueltos.
Con varios CPUs, el mismo dato puede estar copiado en varias cachés. Sigamos un
ejemplo con x = 5 en memoria:
- CPU 1 y luego CPU 2 leen
x: hay dos copias. Mientras solo se lea, bien. - CPU 1 escribe
x = 6en su caché. Si nadie avisa, CPU 2 seguiría leyendo 5. - Con bus snooping, cada caché observa el bus: CPU 2 ve la escritura e invalida su copia.
- Cuando CPU 2 vuelve a leer
x, falla en su caché y obtiene el valor nuevo.
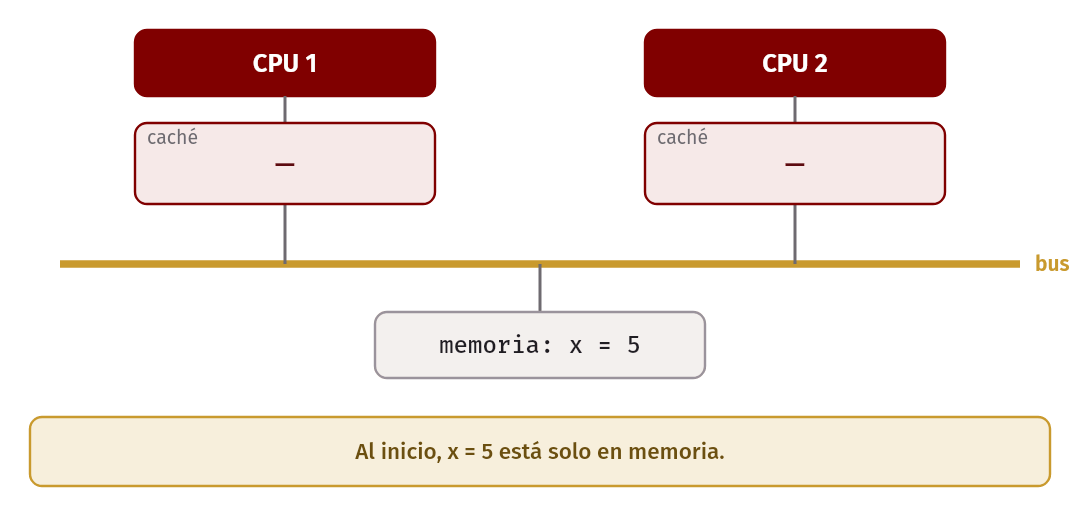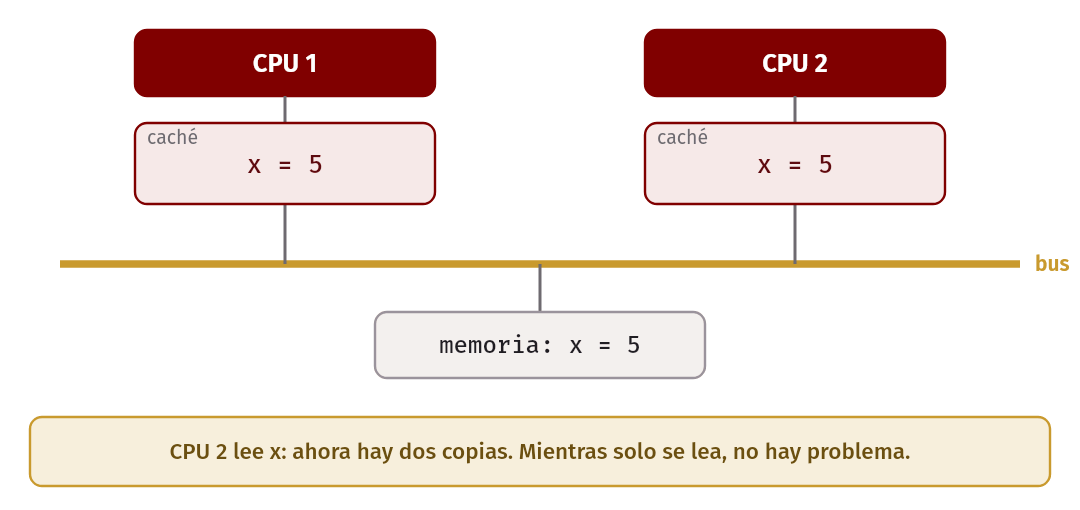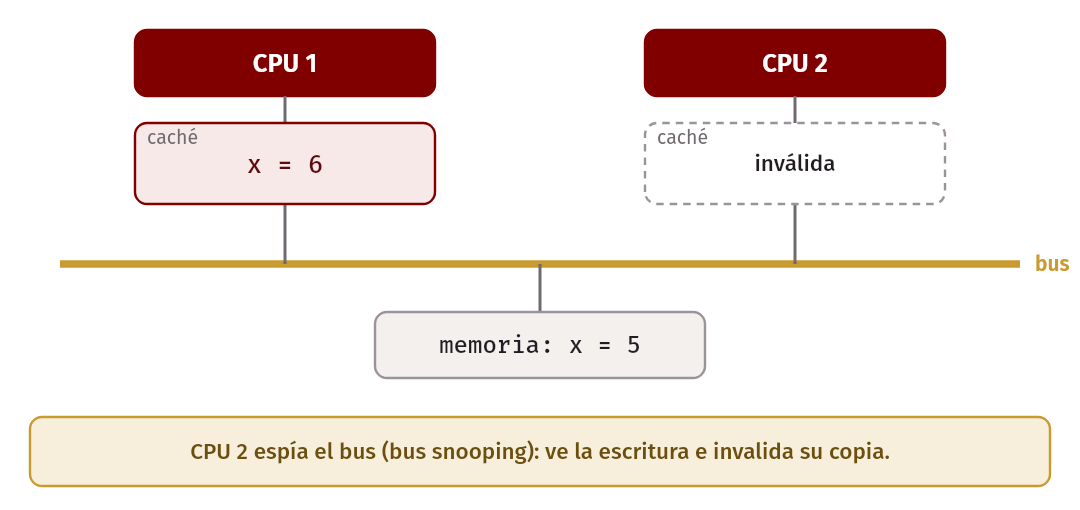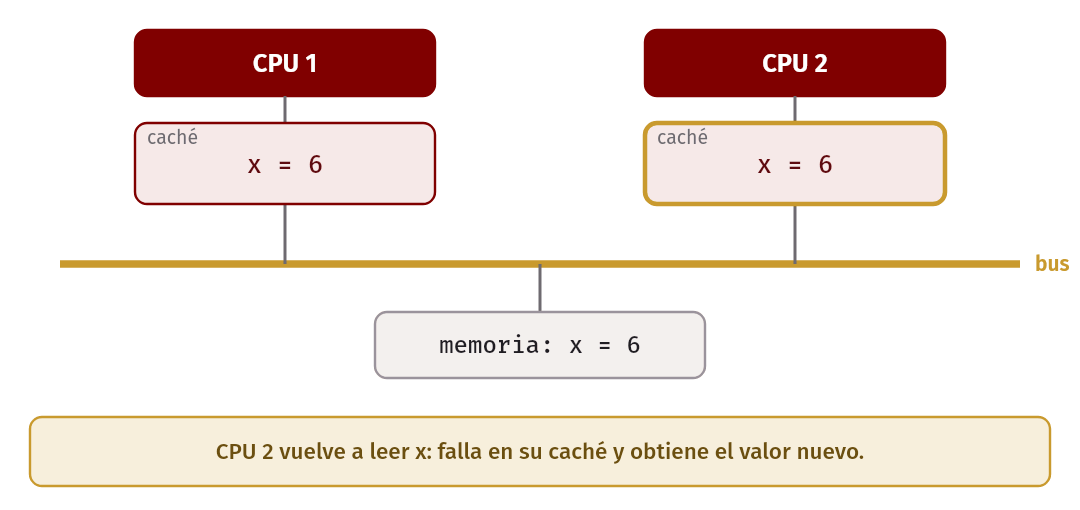
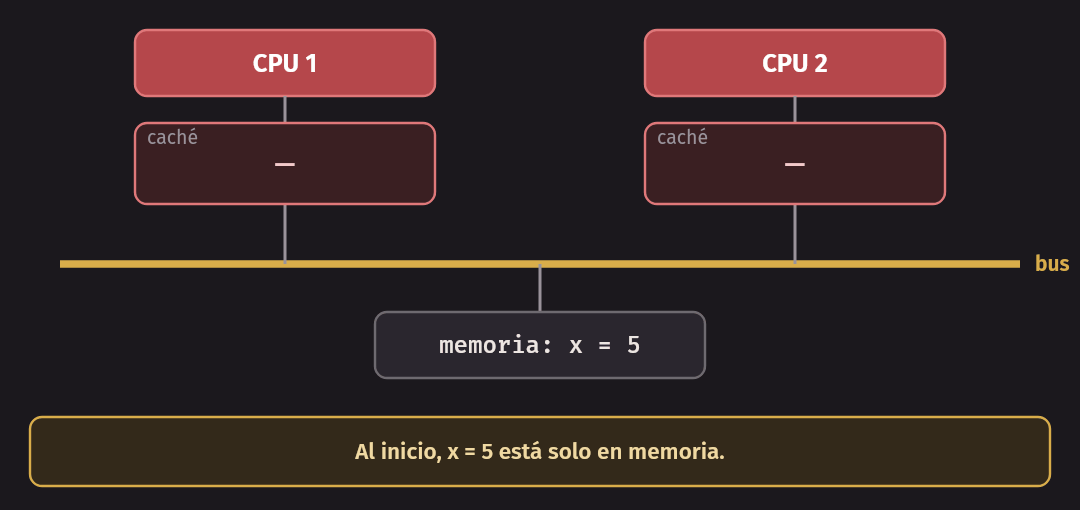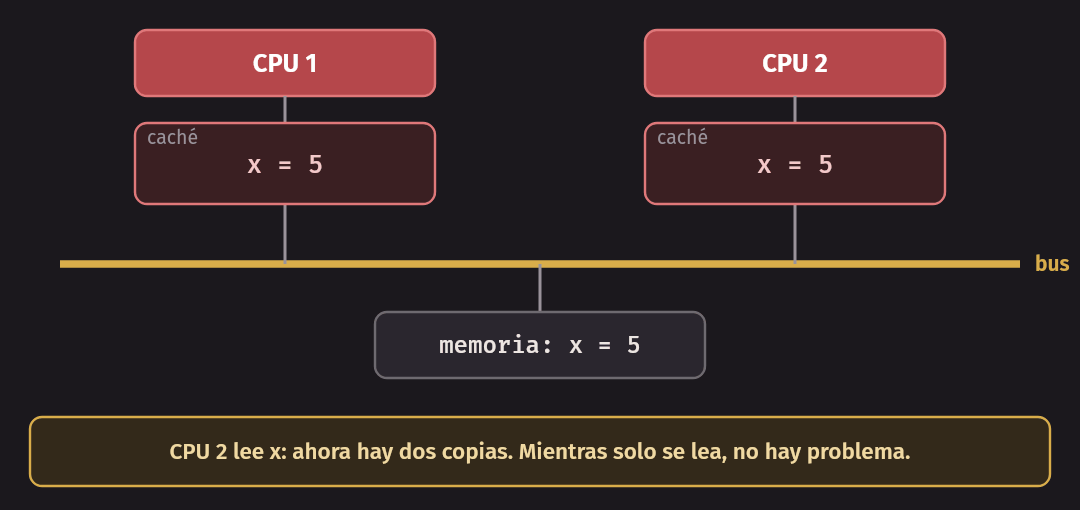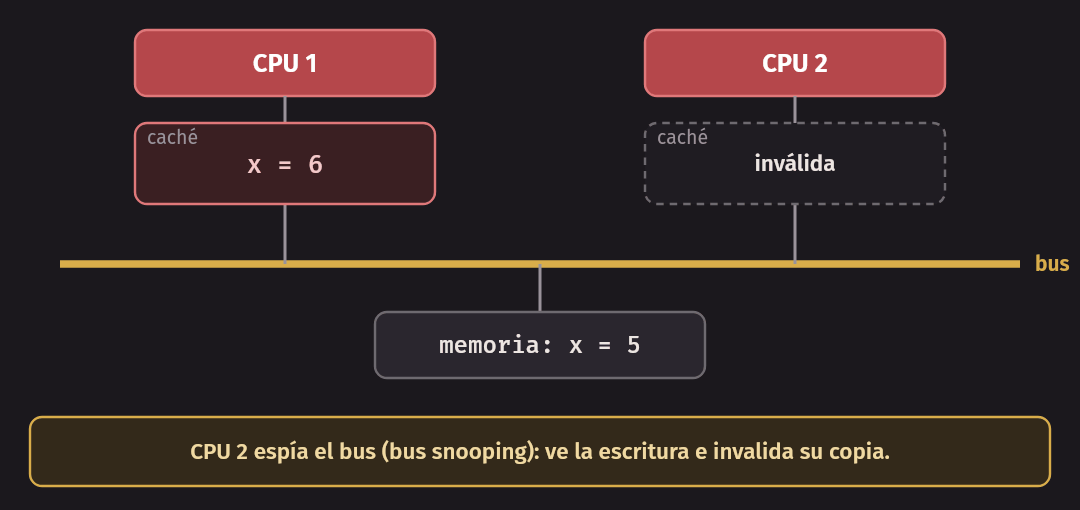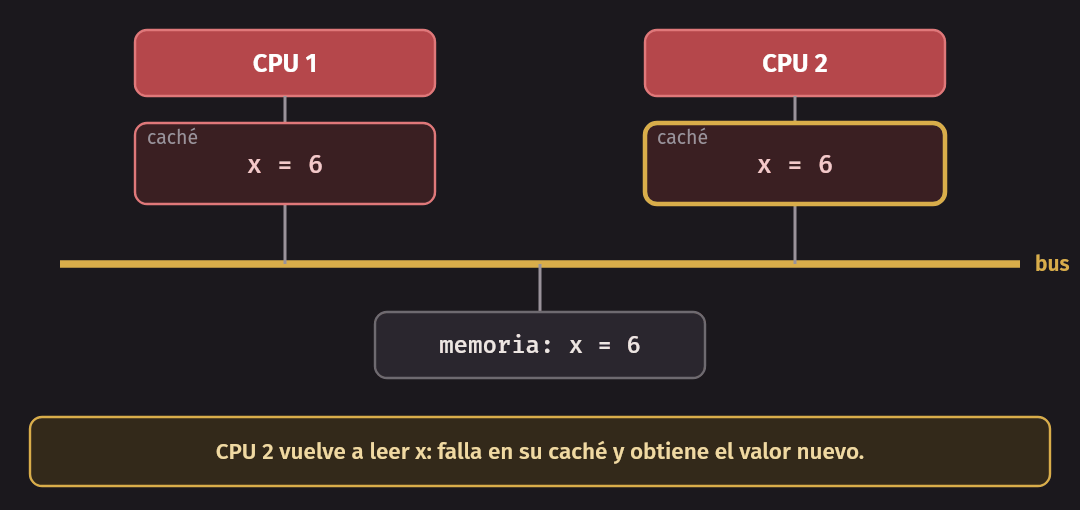
Esto es la coherencia de caché (cache coherence), garantizada por el
hardware, pero no es gratis. En falseshare.c
dos hilos en CPUs distintos incrementan cada uno su propio contador cien
millones de veces; solo cambia dónde están los contadores:
#define LINE 64
#define ALIGNED __attribute__((aligned(LINE)))

// Juntos: en la misma línea de caché.
static struct {
    long a;
    long b;
} ALIGNED together;

// Separados: cada uno en su línea.
static struct {
    long a;
    char pad[LINE - sizeof(long)];
    long b;
} ALIGNED apart;
$ ./falseshare 100
distancia entre contadores: juntos 8 bytes, separados 64 bytes
misma línea: 2.156 s
líneas distintas: 0.248 s
relación: 8.7xLos hilos no comparten datos, pero en la misma línea cada incremento invalida
la copia del otro CPU y la línea “rebota” entre cachés: casi nueve veces más
lento. Es el false sharing. La magnitud depende de la máquina y de su
carga: en el contenedor del curso sobre una Mac con Apple Silicon medimos entre
1,4x y 8,7x en distintas corridas. (El programa usa una suma atómica; con un
++ normal, algunos procesadores agrupan las escrituras y el efecto se nota
menos.)
Sincronización
La coherencia mantiene las copias iguales, pero no vuelve atómica la
secuencia leer–sumar–escribir: dos CPUs que hacen counter++ pueden perder
sumas, como en threads.c de la semana 1. Las estructuras compartidas, como
la cola de procesos listos, necesitan locks o instrucciones atómicas.
Afinidad de caché
Un proceso que corrió en CPU 2 dejó su estado (datos, instrucciones, entradas
del TLB) en las cachés de CPU 2. Si luego corre en CPU 0, no hay que copiar
nada, pero empieza con la caché fría y cada acceso falla hasta recargarla.
Por eso conviene preferir el CPU donde corrió antes: la afinidad de caché
(cache affinity). Linux la deja fijar con sched_setaffinity() o taskset.
pin.c muestrea sched_getcpu() mientras 28 hilos
de relleno compiten por los 14 CPUs del contenedor:
$ ./pin
CPUs en línea: 14
CPUs usados: 0 5 8 10
migraciones en 2000 muestras: 3

$ ./pin 3
fijado al CPU 3
CPUs en línea: 14
CPUs usados: 3
migraciones en 2000 muestras: 0
Sin fijarlo, migró pocas veces (Linux intenta respetar la afinidad); fijado, nunca.
Una sola cola: SQMS
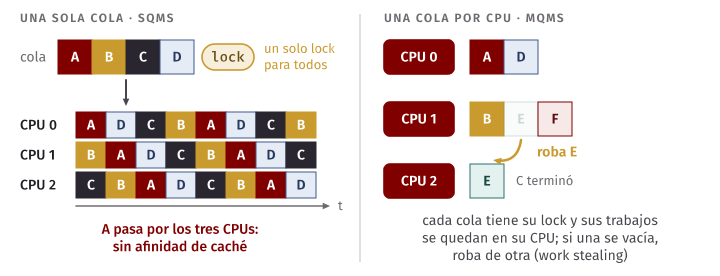
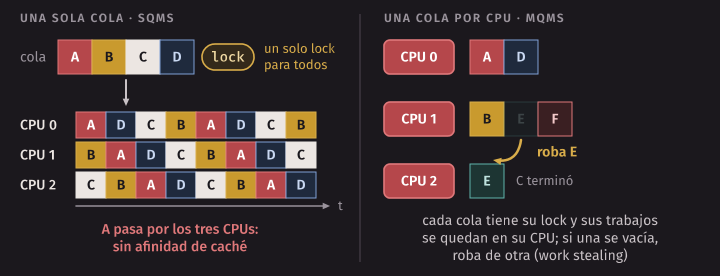
Lo más simple es una sola cola de procesos listos de la que toman trabajo todos los CPUs: single-queue multiprocessor scheduling (SQMS). Tiene dos problemas:
- Escalabilidad. La cola es compartida, así que necesita un lock. Con muchos CPUs, todos pasan tiempo esperando ese lock en lugar de trabajar.
- Afinidad. Cada CPU toma el siguiente de la cola, y los procesos saltan de CPU en CPU. Con cuatro trabajos A, B, C, D en tres CPUs, la secuencia del CPU 0 podría ser A, D, C, B, A, D… y cada trabajo pasa por los tres CPUs.
Se puede mejorar dejando a casi todos fijos y moviendo solo a uno (D rota por el CPU libre), pero la implementación se complica.
Una cola por CPU: MQMS
La alternativa es una cola por CPU: multi-queue multiprocessor scheduling (MQMS). Cada CPU planifica su cola por separado, con su propio lock: escala y respeta la afinidad.
El problema nuevo es el desbalance (load imbalance). Supongamos tres CPUs con colas {A, D}, {B, E, F} y {C}. Si C termina, CPU 2 queda ocioso mientras CPU 1 tiene tres trabajos. La solución es migrar procesos entre colas. Una técnica común es el robo de trabajo (work stealing): una cola con poco trabajo mira a otra y, si está más cargada, se lleva procesos (CPU 2 roba E). Mirar seguido cuesta overhead; mirar poco deja desbalances largos.
Los planificadores de Linux
Linux ha probado ambos enfoques:
| Planificador | Período | Colas |
|---|---|---|
| O(1), con prioridades | 2.6.0 a 2.6.22 (2003–2007) | Una por CPU (MQMS) |
| CFS | 2.6.23 a 6.5 (2007–2023) | Una por CPU (MQMS) |
| BFS, de Con Kolivas | 2009, fuera del kernel oficial | Una sola (SQMS) |
| EEVDF | Desde 6.6 (2023) | Una por CPU (MQMS) |
Linux balancea sus colas con migraciones periódicas por dominios (núcleos que comparten caché, sockets). Que BFS funcione bien en escritorios con una sola cola muestra que no hay un diseño ganador en todos los casos.
Cierre de la virtualización de la CPU
El diálogo del cap. 11 de OSTEP resume cuatro semanas. Los mecanismos (procesos, modos, traps, temporizador, cambio de contexto) permiten que el kernel pueda quitar la CPU; las políticas (FIFO, SJF, STCF, RR, MLFQ, lotería, stride, CFS) deciden a quién dársela. Ninguna es la mejor: cada una optimiza una métrica a costa de otra.
Primer contacto con xv6-riscv
Compilar y arrancar
Dentro del contenedor del curso:
git clone https://github.com/mit-pdos/xv6-riscv
cd xv6-riscv
make qemu           # compila el kernel y el sistema de archivos, y arranca
Aparece xv6 kernel is booting, cada CPU adicional anuncia hart N starting y al final sale el prompt $. Para salir de QEMU: Ctrl-a y luego
x. Por defecto arranca 3 CPUs; make qemu CPUS=1 usa uno.
Cómo arranca
En xv6. El arranque recorre seis funciones:
- QEMU carga el kernel en
0x80000000y todos los CPUs (harts) saltan a_entry, enkernel/entry.S, que prepara una pila por CPU y llama astart().start(), enkernel/start.c, corre en modo máquina: delega los traps al modo supervisor, programa el temporizador y conmretsalta amain()en modo supervisor.main(), enkernel/main.c: el CPU 0 inicializa memoria, tablas de páginas, procesos, traps y disco, y ponestarted = 1; los demás CPUs esperan esa bandera.userinit(), enkernel/proc.c, crea el primer proceso,RUNNABLEy todavía sin programa.- Cada CPU entra a
scheduler(), un Round Robin sobre el arregloproc[].- La primera vez que ese proceso corre,
forkret()monta el sistema de archivos y ejecutakexec("/init", ...);user/init.clanzash.
El viaje de una llamada al sistema
Sigamos en código la ejecución directa limitada de la semana 2, con read().
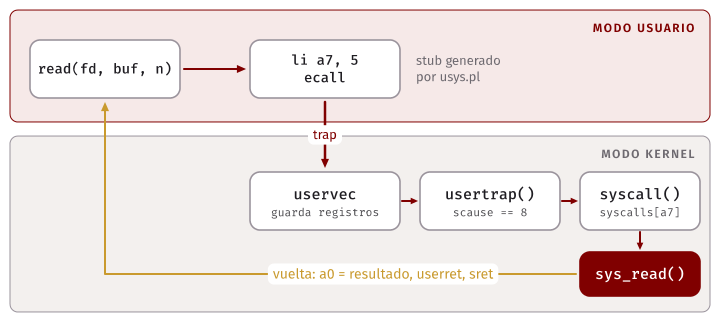
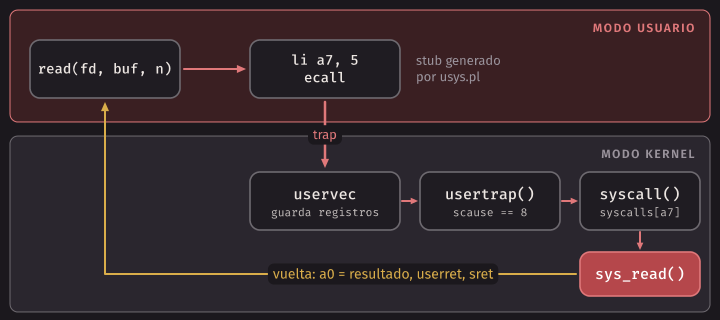
1. El stub de usuario. Las funciones como read() que usan los programas
de xv6 no están escritas en C: las genera el script user/usys.pl, que
produce user/usys.S. Para cada llamada imprime tres instrucciones:
.global read
read:
 li a7, SYS_read
 ecall
 ret
li a7, SYS_read pone el número de la llamada (5, según kernel/syscall.h) en
el registro a7. Los argumentos ya están en a0, a1 y a2, porque así los
pasa la convención de llamadas de RISC-V. ecall provoca el trap.
2. uservec. El hardware pasa a modo supervisor y salta a la dirección
del registro stvec: uservec, en kernel/trampoline.S. Ese código guarda
los registros del usuario en el trapframe del proceso (una página mapeada
en la dirección TRAPFRAME de cada proceso), carga la pila del kernel, cambia
a la tabla de páginas del kernel (csrw satp, t1) y salta a usertrap() con
jalr t0. Como cambia de tabla de páginas a mitad de camino, vive en la página
trampolín (trampoline), mapeada en la misma dirección en ambos espacios.
3. usertrap(). Ya en C, en kernel/trap.c, se averigua la causa del
trap con el registro scause. El valor 8 significa “llamada al sistema desde
modo usuario”:
  p->trapframe->epc = r_sepc();
  if (r_scause() == 8) {
    // system call
    if (killed(p))
      kexit(-1);
    p->trapframe->epc += 4;
    intr_on();
    syscall();
  }
sepc apunta al ecall; se le suman 4 bytes para volver a la instrucción
siguiente. Sin eso, el ecall se repetiría para siempre.
4. syscall(). En kernel/syscall.c, lee a7 del trapframe y usa el
número como índice de un arreglo de punteros a función:
  num = p->trapframe->a7;
  if (num > 0 && num < NELEM(syscalls) && syscalls[num]) {
    p->trapframe->a0 = syscalls[num]();
  } else {
    printk("%d %s: unknown sys call %d\n", p->pid, p->name, num);
    p->trapframe->a0 = -1;
  }
5. La función real. sys_read() está en kernel/sysfile.c; las de
procesos (sys_getpid, sys_fork…) en kernel/sysproc.c. Leen sus
argumentos del trapframe con argint(), argaddr() o argstr().
6. La vuelta. El resultado queda en p->trapframe->a0. usertrap() llama
a prepare_return(), y userret (en kernel/trampoline.S) restaura la tabla
de páginas y los registros del usuario y ejecuta sret.
Depurar con gdb
En una terminal, make qemu-gdb CPUS=1; en otra (en el mismo contenedor, con
docker exec), gdb-multiarch kernel/kernel. Si gdb no carga el .gdbinit
del directorio, sigan la instrucción que imprime (add-auto-load-safe-path):
(gdb) break syscall
(gdb) continue
Breakpoint 1, syscall () at kernel/syscall.c:140
(gdb) next 3
(gdb) p p->trapframe->a7
$1 = 15
(gdb) bt
#0  syscall () at kernel/syscall.c:145
#1  0x000000008000263e in usertrap () at kernel/trap.c:68
La primera llamada al sistema de xv6 la hace init: la 15, SYS_open, para
abrir la consola.
Ejercicio guiado: getreadcount()
Agreguemos getreadcount(), que retorna cuántas veces se llamó a read()
desde el arranque, en todos los procesos. Es la base técnica de P2. Hay que
tocar siete archivos:
kernel/syscall.h: el número,#define SYS_getreadcount 23.kernel/syscall.c: el prototipoextern uint64 sys_getreadcount(void);y la entrada[SYS_getreadcount] = sys_getreadcount,en el arreglosyscalls[].kernel/sysfile.c: el contador y el incremento al inicio desys_read().kernel/sysproc.c: la funciónsys_getreadcount().user/usys.pl:entry("getreadcount");, para que se genere el stub.user/user.h: el prototipoint getreadcount(void);.Makefile: agregar$U/_readcount\aUPROGS, para que el programa de prueba quede en el disco de xv6.
El contador y su incremento:
// Llamadas a read() desde el arranque.
uint64 readcount = 0;

uint64
sys_read(void)
{
  struct file *f;
  int n;
  uint64 p;

  // Varios CPUs a la vez: suma atómica.
  __atomic_fetch_add(&readcount, 1,
                     __ATOMIC_RELAXED);
  argaddr(1, &p);
  ...
¿Por qué atómica y no readcount++? Con tres CPUs, dos procesos pueden
ejecutar sys_read() a la vez y perder una suma: el problema de la sección de
sincronización. Un spinlock (acquire(), release()) también sirve. El
incremento va antes de validar el descriptor, así que cuenta también los
read() que fallan. Para leer basta una instrucción ld de 64 bits, que no
puede quedar a medias (eso lo garantiza el hardware RV64; para el estándar de
C sigue siendo una carrera, y una lectura atómica o con lock sería lo
estricto):
extern uint64 readcount; // en kernel/sysfile.c

uint64
sys_getreadcount(void)
{
  // Un solo ld de 64 bits: no se corta.
  return readcount;
}
El programa de prueba, user/readcount.c, lee README en bloques de 64
bytes:
int
main(void)
{
  char buf[64];
  int before = getreadcount();
  int fd = open("README", O_RDONLY);
  while (read(fd, buf, sizeof(buf)) > 0)
    ;
  close(fd);
  int after = getreadcount();
  printf("antes %d, despues %d\n", before, after);
  exit(0);
}
El cambio completo está en
xv6-getreadcount.patch. Se preparó
sobre el commit e93dabe de xv6-riscv y se aplica con git apply (en otras
versiones quizá haya que aplicarlo a mano). Intenten hacerlo primero ustedes.
Con make qemu:
$ readcount
antes 10, despues 50
$ wc README
48 336 2441 README
$ readcount
antes 76, despues 116
Cada número tiene explicación:
- 40.
READMEtiene 2441 bytes: 39read()con datos de a 64 y uno final que retorna 0. - 10. La shell lee lo que escriben un byte a la vez (
gets()llama aread(0, &c, 1)):readcountmás el Enter son 10 llamadas. - 76. 50 + 10 (
wc READMEy Enter) + 6 (wclee de a 512: 5 con datos y la final) + 10 (readcountotra vez).
En xv6. En P2, cada llamada nueva (por ejemplo, para fijar los boletos de un proceso) toca los mismos siete archivos, y el planificador a reemplazar es
scheduler(), enkernel/proc.c.
Resumen
- En la lotería, cada proceso tiene boletos y en cada quantum se sortea uno: la proporción es correcta en promedio, imprecisa en el corto plazo.
- Stride es determinista: corre el de menor
passy le suma su stride (L / boletos). Necesita estado global. - CFS es stride con pesos: corre el de menor
vruntime, que crece más despacio cuanto mayor es el peso (nicemás bajo). Los procesos listos están en un árbol rojo-negro. Desde Linux 6.6, la elección la hace EEVDF: entre los procesos elegibles, el de deadline virtual más temprano. - Con varios CPUs, la coherencia de las cachés tiene un costo (false sharing) y no hace atómicas las operaciones compuestas. Migrar un proceso cuesta por la afinidad de caché.
- SQMS (una cola) balancea solo pero escala mal; MQMS (una cola por CPU) escala, pero necesita migrar procesos (work stealing).
- En xv6-riscv, una llamada va del stub (
a7,ecall) auservec,usertrap(),syscall()ysys_*, y vuelve con el resultado ena0.
Ejercicios
- Con boletos 100 y 50, ¿qué fracción de la CPU espera recibir cada proceso?
Ejecuten
./lottery S 20 100 50con cinco semillas distintas y anoten la fracción de A. ¿Cuánto varía? Repitan con 2000 quanta. - Tres procesos con 50, 100 y 250 boletos y L = 1000. Calculen los strides
y hagan a mano la traza de stride de los primeros 8 quanta. Verifiquen con
./stride 1000 8 50 100 250. - En stride, un proceso nuevo llega cuando los
passde los demás son 400, 420 y 460. ¿Qué pasa si empieza conpass0 y tiene stride 20? ¿Cuántos quanta seguidos corre antes de que otro proceso vuelva a correr? ¿Quépassinicial le darían? - Con CFS, A tiene
nice0 y Bnice10. Usando la tabla de pesos, ¿qué fracción de la CPU recibe cada uno? ¿Cuánto avanza elvruntimede cada uno si los dos corren 10 ms reales? Verifiquen la fracción con./cfs. - Expliquen por qué
./falsesharees mucho más lento cuando los contadores están a 8 bytes de distancia. Ejecútenlo varias veces: ¿por qué la relación cambia entre corridas? - ¿Por qué migrar un proceso entre CPUs tiene costo aunque no haya que copiar nada? Relaciónenlo con la diferencia entre SQMS y MQMS.
- En xv6, con
make qemu-gdb CPUS=1, pongan un breakpoint condicional que solo se detenga enread():break kernel/syscall.c:145 if num == 5. Imprimanp->name,p->trapframe->a0yp->trapframe->a2. ¿Qué proceso hace el primerread(), de qué descriptor lee y cuántos bytes pide? ¿Por qué?