
Apuntes · Capítulo 5Memoria
Espacios de direcciones, traducción y segmentación
Espacios de direcciones, traducción y segmentación
Hasta ahora estudiamos cómo el sistema operativo virtualiza la CPU: con la ejecución directa limitada, la interrupción del temporizador y un planificador (scheduler), cada proceso cree tener un procesador para él solo. Esta semana empezamos la segunda mitad de la virtualización: la memoria. El objetivo es el mismo: que cada proceso crea tener una memoria privada, grande y que empieza en la dirección 0, aunque en realidad comparta la memoria física con decenas de otros procesos y con el propio kernel.
Veremos la abstracción (el espacio de direcciones, address space), la API de memoria de C con sus errores típicos y el mecanismo de traducción: base y límite, y luego segmentación. Al final, el laboratorio recorre el planificador de xv6-riscv, que van a modificar en el proyecto P2.
Ruta de lectura.
- Antes de clase (15–20 min): «De una memoria compartida a una memoria virtual», «El espacio de direcciones» y «Relocalización dinámica».
- En clase: sesión A, «La API de memoria» y «Errores típicos con la memoria»; sesión B, «Traducción de direcciones: base y límite» y «Segmentación»; laboratorio, «Laboratorio: el planificador de xv6 por dentro».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 13 a 16 y «Por debajo:
brk,sbrkymmap».
Lectura. Este capítulo acompaña a OSTEP cap. 13 The Abstraction: Address Spaces, cap. 14 Interlude: Memory API, cap. 15 Mechanism: Address Translation y cap. 16 Segmentation. El código está en
code/week-05y se compila conmakedentro del contenedor del curso.
De una memoria compartida a una memoria virtual
En los primeros sistemas, la memoria física tenía al sistema operativo y un programa que usaba todo lo demás. No había nada que proteger.
Con la multiprogramación apareció el problema: para aprovechar la CPU mientras un programa espera E/S, conviene tener varios procesos en la memoria al mismo tiempo, cada uno en un trozo distinto. Eso trae dos preguntas: ¿cómo evitar que el proceso A lea o escriba la memoria de B? Y si A fue compilado para empezar en la dirección 0, ¿cómo funciona si el kernel lo cargó en 64 KB?
El espacio de direcciones
La respuesta del sistema operativo es una abstracción: el espacio de direcciones. Es la memoria tal como la ve un proceso: un rango de direcciones que va de 0 hasta un máximo y que contiene todo el estado en memoria del programa. En un esquema simplificado de 16 KB:
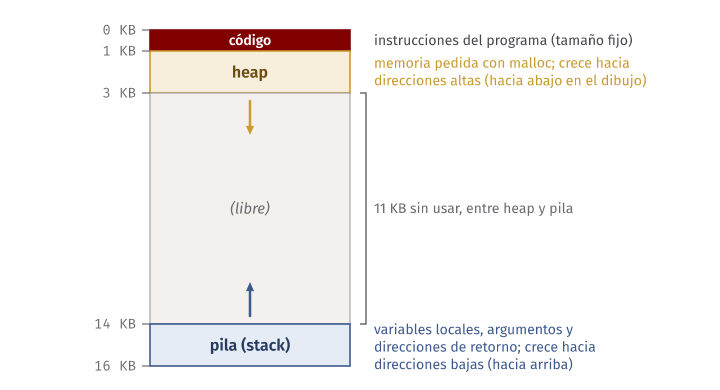
Hay tres regiones con comportamientos distintos:
- El código del programa no cambia de tamaño durante la ejecución. Junto a
él van los datos globales (
.datapara los inicializados,.bsspara los que empiezan en cero). - El heap guarda la memoria que el programa pide explícitamente con
malloc. Crece hacia direcciones más altas. - La pila (stack) guarda las variables locales, los argumentos y las direcciones de retorno de cada llamada a función. Crece hacia direcciones más bajas.
Heap y pila van en extremos opuestos para crecer sin chocar. Y este dibujo es una ilusión: en la memoria física, el proceso puede estar en cualquier lugar, partido en trozos o parcialmente en disco. Por eso toda dirección que ve un programa es virtual: si imprimen un puntero en C, ven una dirección virtual.
Tres metas
Un buen sistema de memoria virtual debe cumplir tres metas:
| Meta | Qué significa |
|---|---|
| Transparencia | El programa no nota que su memoria está virtualizada; se comporta como si tuviera memoria física propia. |
| Eficiencia | La traducción no debe hacer lento cada acceso ni gastar mucha memoria en estructuras del kernel. Requiere hardware (la MMU y, más adelante, la TLB). |
| Protección | Un proceso no puede leer ni escribir la memoria de otro ni la del kernel. Así un error en un programa no tumba a los demás: aislamiento. |
Verlo en un programa real
El programa layout.c imprime la dirección de
algo de cada región:
int global_init = 42;   // datos inicializados (.data)
int global_zero;        // datos en cero (.bss)

int main(void) {
    int local = 7;                       // en la pila
    int *small = malloc(16);             // heap (vía brk)
    int *big = malloc(1 << 20);          // 1 MiB: glibc usa mmap
    void *brk_end = sbrk(0);             // fin actual del heap

    printf("código  main()       %p\n", (void *)main);
    // ... una línea por región
}
En el contenedor del curso (aarch64), desactivando la aleatorización con
setarch -R:
$ setarch -R ./layout
código  main()       0xaaaaaaaa0918
datos   global_init  0xaaaaaaac0010
bss     global_zero  0xaaaaaaac0018
heap    malloc(16)   0xaaaaaaac12a0
heap    sbrk(0)      0xaaaaaaae2000
mmap    malloc(1MiB) 0xfffff7cef010
pila    local        0xfffffffffbcc
El orden coincide con el dibujo: código, datos, heap y, cerca del tope, la
pila. El bloque de 1 MiB está aparte porque la biblioteca lo pidió con mmap.
Y 0xfffffffffbcc está cerca de 2^48 bytes (256 TB): no es una posición de la
RAM del contenedor.
Si lo ejecutan sin setarch -R, las direcciones cambian en cada ejecución:
$ ./layout | grep -E 'main|local'
código  main()       0xaaaabe4a0918
pila    local        0xfffff929d1fc
$ ./layout | grep -E 'main|local'
código  main()       0xaaaac7280918
pila    local        0xffffd3370b6c
Es la aleatorización del espacio de direcciones (ASLR): el kernel coloca cada región en un lugar distinto para que un atacante no adivine dónde están el código o la pila. Es posible justamente porque las direcciones son virtuales.
Idea clave. El espacio de direcciones es una abstracción, como el proceso. El programa trabaja con direcciones virtuales; el sistema operativo y el hardware deciden dónde están físicamente los datos.
La API de memoria
Pila y heap
En un programa en C hay dos tipos de memoria. La memoria de la pila es
automática: el compilador la reserva al entrar a una función y la libera al
salir. La del heap es manual: ustedes la piden con malloc y ustedes la
devuelven con free. Por eso no se debe retornar un puntero a una
variable local, pero sí uno devuelto por malloc.
int *g(void) {
    int *x = malloc(sizeof(*x));
    return x;   // válido: quien llama deberá hacer free(x)
}
Las funciones
| Función | Qué hace |
|---|---|
malloc(n) |
Reserva n bytes sin inicializar. Retorna NULL si no puede. |
calloc(k, n) |
Reserva k elementos de n bytes, todos en cero. |
realloc(p, n) |
Cambia el tamaño del bloque; puede moverlo y retornar otra dirección. |
free(p) |
Devuelve el bloque. No recibe el tamaño: la biblioteca lo guarda en un encabezado. |
Hábitos útiles: calcular el tamaño con sizeof (malloc(sizeof(*p))), reservar
strlen(s) + 1 bytes para copiar una cadena y revisar si malloc retornó
NULL.
Por debajo: brk, sbrk y mmap
malloc y free no son llamadas al sistema: son funciones de la
biblioteca de C que administran el heap. Cuando se quedan sin espacio, le piden
memoria al kernel de dos formas:
brk/sbrkmueven el break del programa, la dirección donde termina el heap. Subir el break agrega memoria al final del heap. Enlayout.c,sbrk(0)retorna el break actual sin moverlo.mmapcrea una región nueva en cualquier parte del espacio de direcciones; conMAP_ANONYMOUSsirve como memoria. glibc usammappara los bloques grandes (desde 128 KB por defecto), y por eso el bloque de 1 MiB delayout.capareció lejos del heap.
Nunca llamen a brk directamente en un programa que use malloc: los dos
manipulan el mismo break y se confundirían.
En xv6. xv6-riscv tiene una sola llamada para hacer crecer la memoria de un proceso:
sbrk. En el kernel,sys_sbrk()(kernel/sysproc.c) tiene dos caminos. Si se pide memoria ansiosa (SBRK_EAGER) o se encoge, llama agrowproc()(kernel/proc.c), que reserva páginas físicas de inmediato conuvmalloc(). En el caso normal es perezosa: solo sumanap->sz, el tamaño de la memoria del proceso, y no reserva nada. Cuando el programa toca esas direcciones se produce un fallo de página yvmfault()reserva la página en ese momento.if (t == SBRK_EAGER || n < 0) { if (growproc(n) < 0) { return -1; } } else { // ... (verifica que no se pase de TRAPFRAME) myproc()->sz += n; }
user/umalloc.cimplementamallocsobre esta llamada.
Errores típicos con la memoria
Casi ninguno de estos errores lo detecta el compilador y muchos parecen funcionar: el programa corre bien en la computadora del estudiante y falla en la de quien lo califica. La lista clásica:
- Olvidar reservar.
char *d; strcpy(d, s);escribe en una dirección cualquiera. Con suerte, segmentation fault. - Reservar de menos.
malloc(strlen(s))seguido destrcpyescribe un byte más allá del bloque: un buffer overflow. Puede corromper el bloque vecino o la información interna demalloc. - No inicializar.
mallocno pone la memoria en cero; leerla sin escribir antes da basura. - Fuga de memoria (memory leak). Nunca llamar a
free. Al terminar, el kernel recupera todo; pero en un servidor que corre meses, la memoria crece hasta agotarse. - Puntero colgante (dangling pointer). Usar memoria después de liberarla
(use-after-free). El bloque puede haber sido reutilizado por otro
malloc. - Doble
free. Liberar dos veces el mismo bloque corrompe las estructuras internas de la biblioteca. freeinválido. Pasar afreeun puntero que no vino demalloc, o que apunta al medio de un bloque.
Para encontrarlos se usa valgrind (o compilar con -fsanitize=address),
que ejecuta el programa en un procesador simulado y revisa cada acceso a
memoria. Compilen con -g para ver archivo y línea:
gcc -Wall -Wextra -g prog.c -o prog
valgrind --leak-check=full --track-origins=yes ./prog
En code/week-05, make check ejecuta los cuatro ejemplos con ese comando.
Fuga: leak.c
leak.c llama diez veces a una función que reserva
64 bytes y nunca los libera (salida recortada, sin los prefijos ==PID==):
$ valgrind --leak-check=full ./leak
640 bytes in 10 blocks are definitely lost in loss record 1 of 1
   at malloc (...)
   by make_label (leak.c:9)
   by main (leak.c:18)
LEAK SUMMARY:
   definitely lost: 640 bytes in 10 blocks
Definitely lost significa que ya no queda ningún puntero a esos bloques: es
imposible liberarlos. La pila de llamadas indica dónde se reservaron
(leak.c:9, dentro de make_label), no dónde falta el free; eso lo tienen
que razonar ustedes.
Puntero colgante: uaf.c
En uaf.c, una función libera la estructura y el
llamador la sigue usando:
close_account(a);                       // hace free(a)
printf("saldo: %d\n", a->balance);      // línea 23
$ valgrind ./uaf
Invalid read of size 4
at main (uaf.c:23)
Address 0x4a7e044 is 4 bytes inside a block of size 8 free'd
by close_account (uaf.c:13)
Block was alloc'd at
by main (uaf.c:17)
saldo: 100El programa imprimió saldo: 100, el valor correcto: la memoria liberada
todavía conserva el dato viejo, y por eso el error pasa desapercibido. valgrind
dice dónde se leyó, dónde se liberó y dónde se reservó.
Memoria sin inicializar: uninit.c
uninit.c llena siete de ocho elementos de un
arreglo y después los suma todos:
$ valgrind --track-origins=yes ./uninit
Conditional jump or move depends on uninitialised value(s)
   at main (uninit.c:18)
 Uninitialised value was created by a heap allocation
   by main (uninit.c:9)
...
suma: 21
valgrind no se queja en la línea 17, donde se suma la basura, sino en la
18, donde un if decide algo con ese valor. --track-origins=yes agrega de
dónde vino: el malloc de la línea 9.
Doble free: doublefree.c
$ valgrind ./doublefree
Invalid free() / delete / delete[] / realloc()
   by main (doublefree.c:19)
 Address 0x4a7e040 is 0 bytes inside a block of size 32 free'd
   by cleanup (doublefree.c:9)
Sin valgrind, glibc detecta este caso y aborta (free(): double free detected in tcache 2), pero otros patrones corrompen el heap en silencio.
Traducción de direcciones: base y límite
La técnica general es la traducción de direcciones (address translation): en cada acceso a memoria, el hardware convierte la dirección virtual en una física. Lo hace la MMU (memory management unit), dentro del procesador; el sistema operativo la configura y lleva la cuenta de la memoria libre. Es el patrón de la ejecución directa limitada: el programa corre directo, el hardware impone los límites y el kernel interviene solo en momentos clave.
Relocalización dinámica
Supongamos que el espacio de direcciones de un proceso mide 4 KB y el kernel lo coloca en la memoria física a partir de 16 KB. Una opción sería que el cargador reescriba todas las direcciones del programa sumándoles 16 KB antes de ejecutarlo (relocalización estática). No sirve: no protege nada (el programa puede generar cualquier dirección) y una vez cargado el proceso ya no se puede mover.
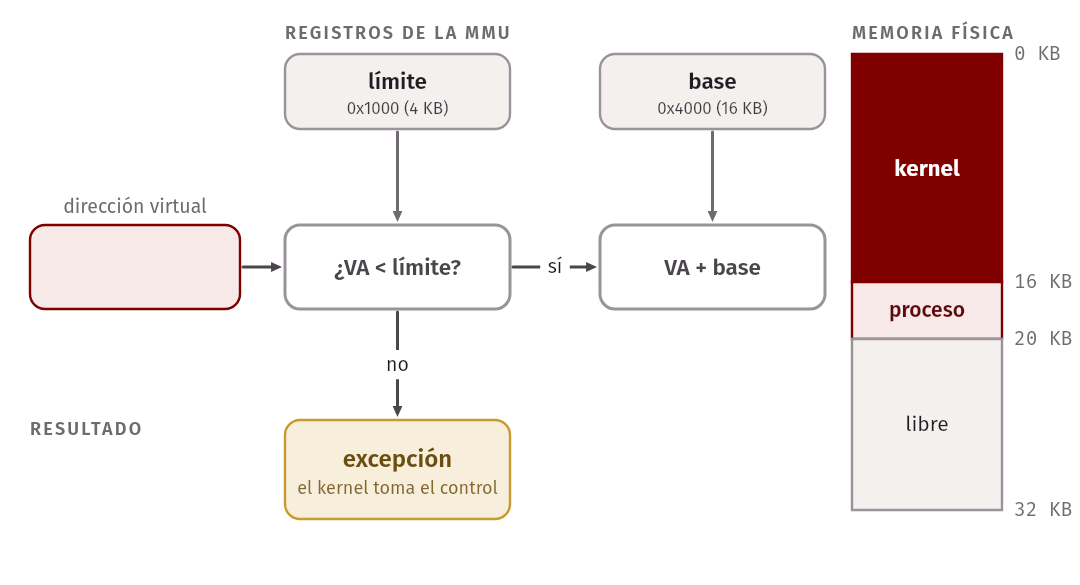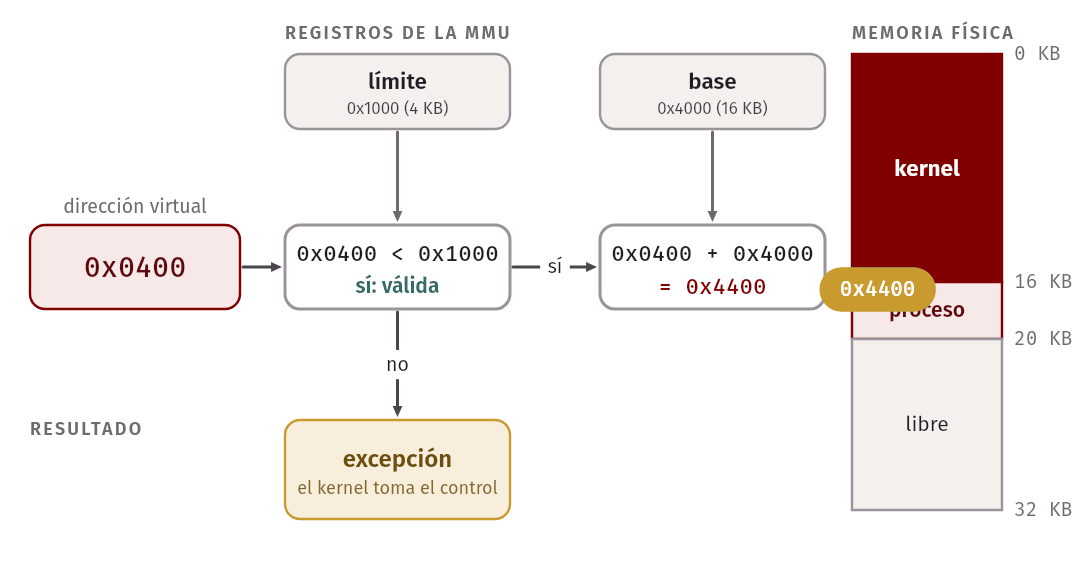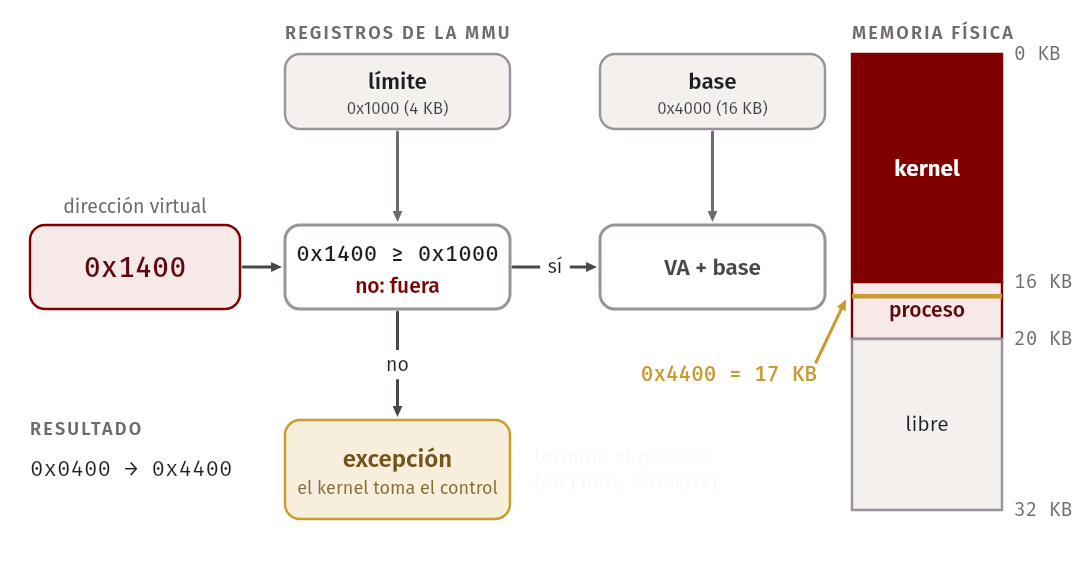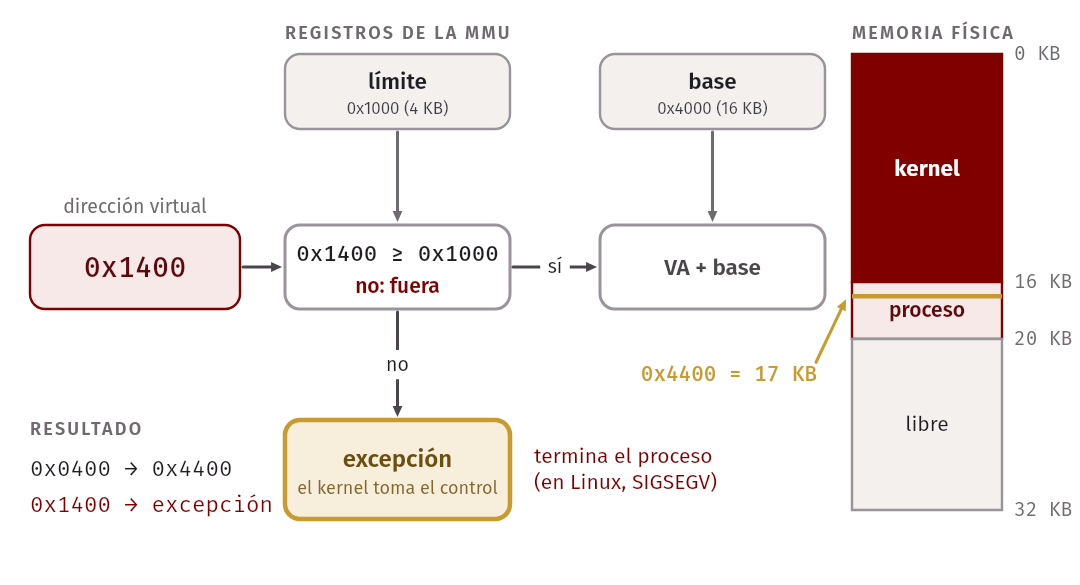
La solución es la relocalización dinámica (dynamic relocation), con dos registros de hardware por CPU:
- base: dónde empieza el proceso en la memoria física;
- límite (bounds): el tamaño de su espacio de direcciones.
En cada acceso la MMU hace:
si dirección_virtual >= límite:
    excepción  -> el kernel toma el control
si no:
    dirección_física = dirección_virtual + base
En este curso el límite es el tamaño del espacio de direcciones y se compara con la dirección virtual, antes de sumar la base. (Otra variante guarda en el límite la dirección física final; es equivalente.)
Ejemplo resuelto
Base = 16 KB = 0x4000 (16 384), límite = 4 KB = 0x1000 (4096).
Dirección virtual 1 KB = 0x0400 = 1024.
- ¿
0x0400<0x1000? Sí, 1024 < 4096: el acceso es válido. - Sumar la base. En binario, con 16 bits:
  0000 0100 0000 0000   0x0400
+ 0100 0000 0000 0000   0x4000
  -------------------
  0100 0100 0000 0000   0x4400
La dirección física es 0x4400 = 17 408 = 17 KB. No hay acarreos porque la
base solo tiene encendido el bit 14, que en la dirección virtual está en cero.
Dirección virtual 5 KB = 0x1400 = 5120.
- ¿
0x1400<0x1000? No, 5120 ≥ 4096. - La MMU no suma nada: lanza una excepción. El kernel toma el control y, en
general, termina el proceso (en Linux, con la señal
SIGSEGV).
Ojo con el borde: la dirección 0x1000 (4096) también está fuera, porque el
último byte válido es 0x0FFF.
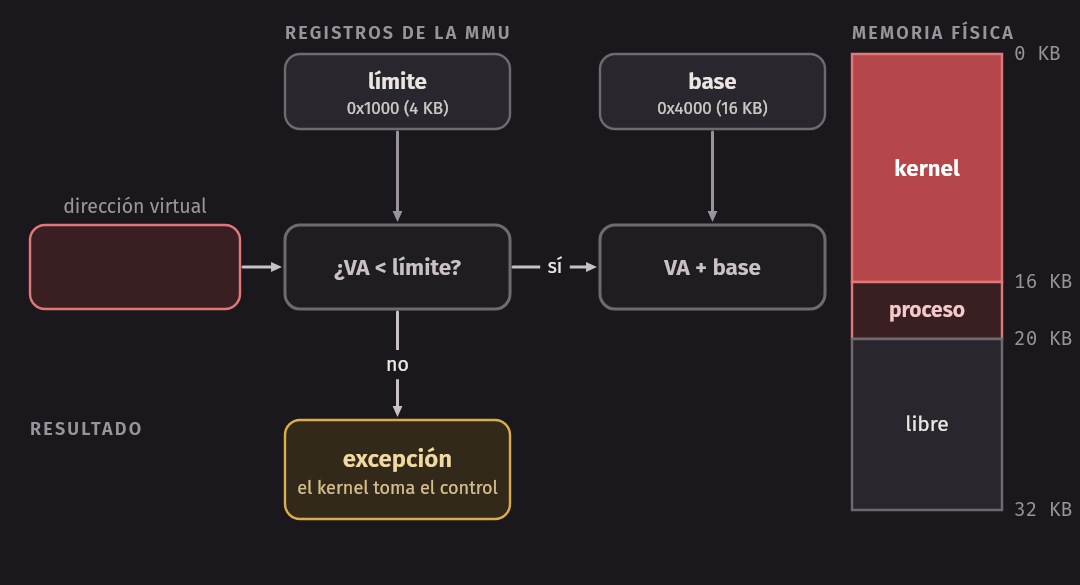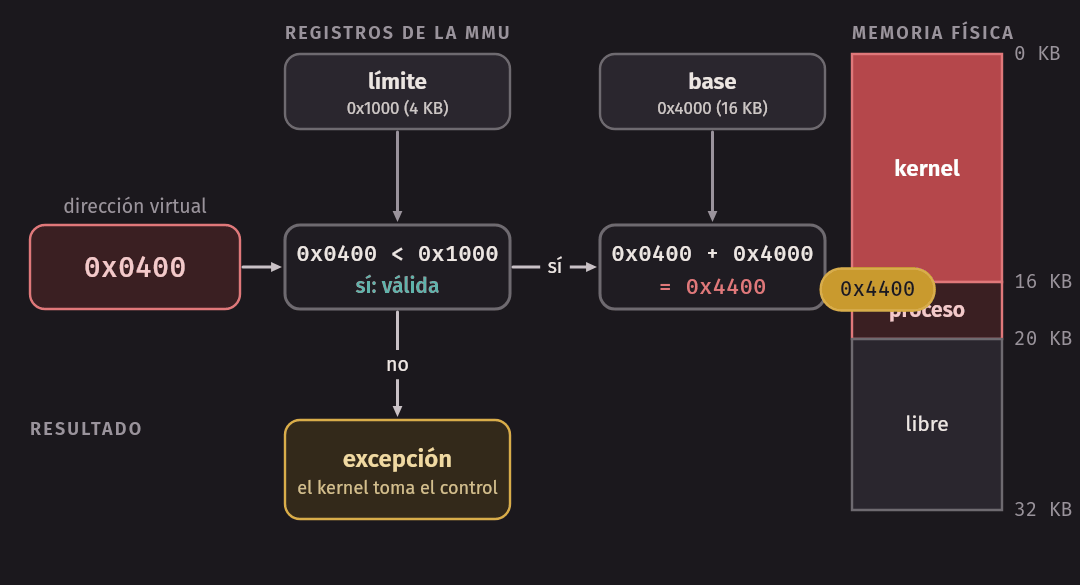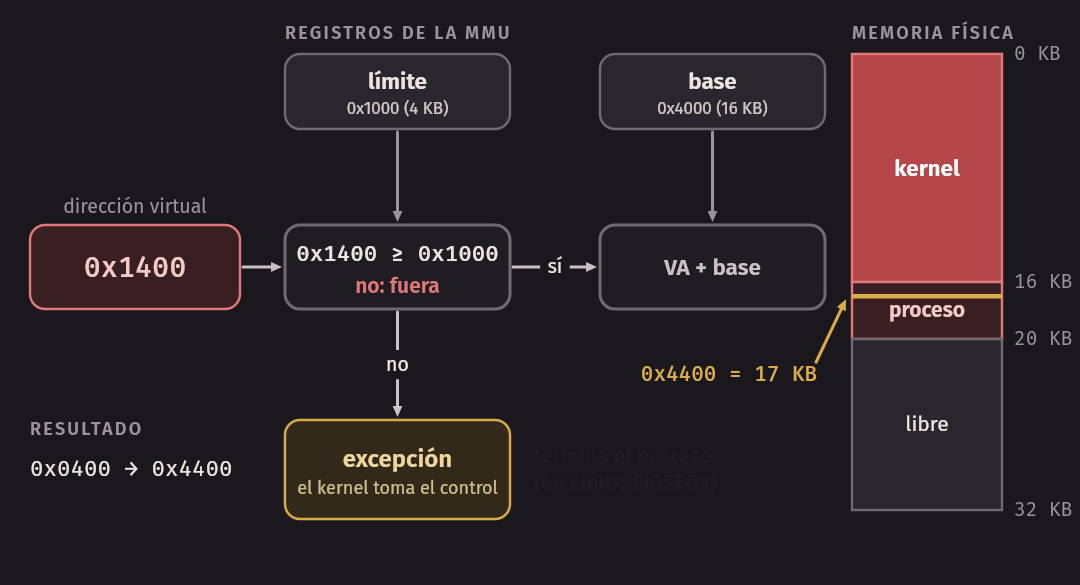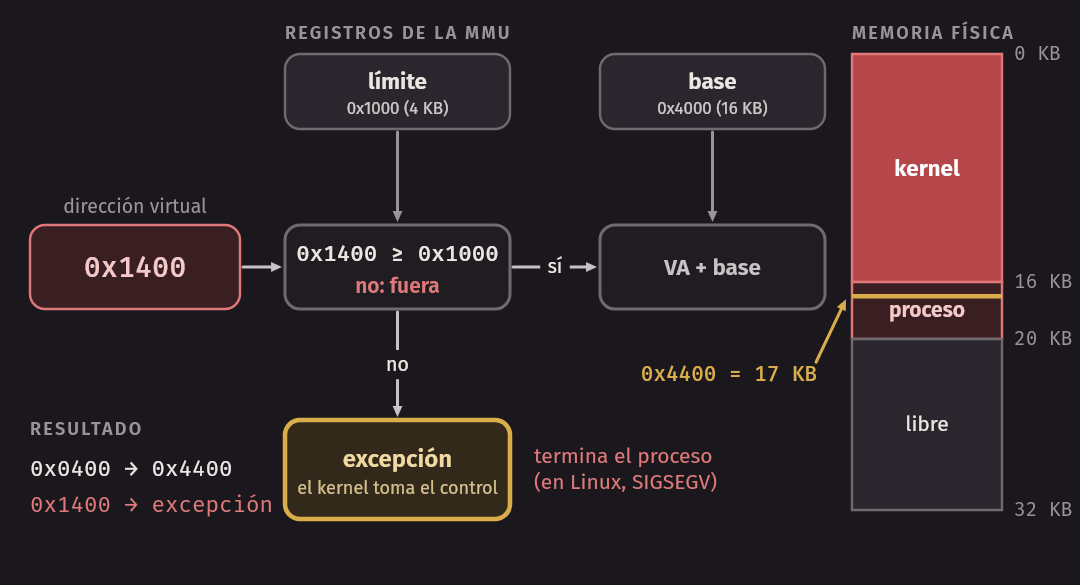
El hardware necesita poco: los dos registros dentro de la MMU, un sumador y un comparador, instrucciones privilegiadas para escribir los registros (solo en modo kernel) y la posibilidad de lanzar una excepción. Una suma y una comparación se hacen en paralelo con el resto de la instrucción: la traducción no hace más lento el programa.
Qué hace el sistema operativo
El hardware traduce; el kernel administra. Tiene que intervenir en cuatro momentos:
- Al crear un proceso, buscar espacio para su espacio de direcciones en la lista libre (free list), la estructura donde lleva los trozos de memoria física sin usar, y marcarlo como ocupado.
- Al terminar un proceso, devolver su memoria a la lista libre.
- En cada cambio de contexto, guardar los valores de base y límite del
proceso que sale (en su estructura de proceso, como
struct proc) y cargar los del que entra. Hay un solo par de registros por CPU. Además, mientras un proceso no está ejecutando, el kernel puede moverlo a otra zona de la memoria física: copia los bytes y actualiza su base guardada. - Al arrancar, instalar los manejadores de excepciones; cuando un proceso se sale de su límite, el manejador lo termina.
El problema de base y límite
Con un solo par de registros, el espacio de direcciones entero tiene que estar
contiguo en la memoria física. En el dibujo de 16 KB, el hueco entre el
heap y la pila (11 KB) ocupa memoria física aunque nadie lo use. Ese
desperdicio dentro del espacio asignado se llama fragmentación interna
(internal fragmentation). Con los espacios de direcciones reales (los 256 TB que
vimos en layout.c), reservar todo de forma contigua es imposible.
Idea clave. Base y límite consigue protección y transparencia con un hardware mínimo, pero obliga a reservar el espacio de direcciones completo, incluido lo que no se usa.
Segmentación
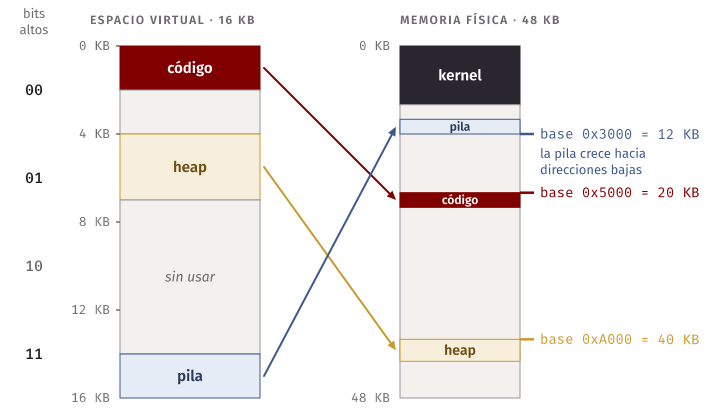
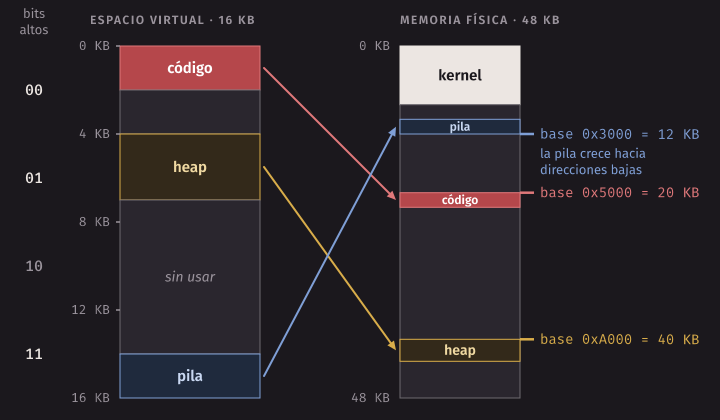
La idea siguiente es natural: en vez de un par base/límite para todo el espacio de direcciones, usar un par por cada segmento lógico: código, heap y pila. Cada segmento se coloca en la memoria física donde haya espacio, de forma independiente, y el hueco entre heap y pila no ocupa memoria física. Esto permite espacios de direcciones dispersos (sparse): grandes, pero con poca memoria realmente usada.
La tabla de segmentos
Usaremos un espacio de direcciones de 16 KB, con direcciones virtuales de 14 bits. Los 2 bits más altos indican el segmento y los 12 restantes son el offset dentro de él (hasta 4 KB). La MMU tiene una tabla con una fila por segmento:
| Segmento | Bits | Base | Tamaño | Crece hacia | Protección |
|---|---|---|---|---|---|
| Código | 00 |
0x5000 (20 KB) |
0x800 (2 KB) |
+ | r-x |
| Heap | 01 |
0xA000 (40 KB) |
0xC00 (3 KB) |
+ | rw- |
| Pila | 11 |
0x3000 (12 KB) |
0x800 (2 KB) |
− | rw- |
La pila crece hacia direcciones bajas, así que su base es el tope de su
región física: ocupa de 0x2800 (10 KB) a 0x3000 (12 KB). El hardware
necesita saberlo, de modo que cada segmento lleva además un bit que indica el
sentido de crecimiento.
Ejemplo: una dirección del heap
Dirección virtual 0x1068 = 4200.
- En binario, con 14 bits:
01 0000 0110 1000. Los dos bits altos son01: segmento heap. - Offset =
0x1068 & 0xFFF=0x068= 104. - ¿104 < 3072 (
0xC00)? Sí, válido. - Física =
0xA000+0x068=0xA068= 41 064.
Ojo: la física no es 0xA000 + 0x1068; los bits del segmento solo eligen
la fila de la tabla.
Con 0x1E00 (01 1110 0000 0000) el segmento también es el heap, pero el
offset es 0xE00 = 3584 ≥ 3072: fuera del segmento. El hardware lanza una
excepción. De aquí viene el nombre segmentation fault, que se sigue usando
aunque los sistemas modernos ya no usan segmentación.
Ejemplo: la pila
Dirección virtual 0x3C00 = 15 360.
- En binario:
11 1100 0000 0000. Segmento11: pila, que crece hacia abajo. - Offset =
0xC00= 3072. - Como el segmento crece hacia abajo, el offset se convierte en negativo
restándole el tamaño máximo de un segmento (4 KB =
0x1000):0xC00 − 0x1000= −0x400= −1024. - ¿|−1024| ≤ 2048 (el tamaño de la pila)? Sí, válido.
- Física =
0x3000−0x400=0x2C00= 11 264, dentro de la región de la pila (0x2800–0x3000).
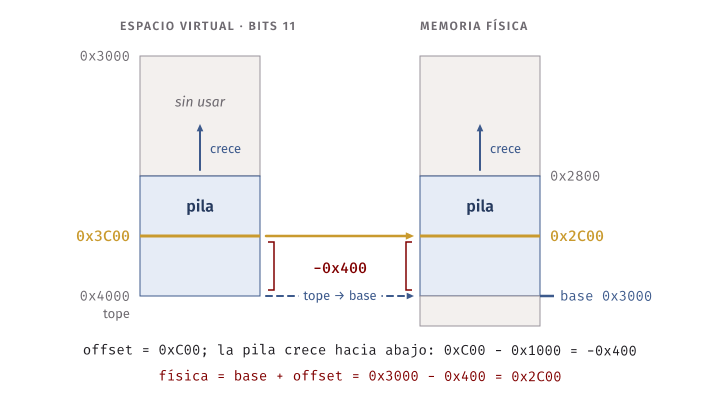
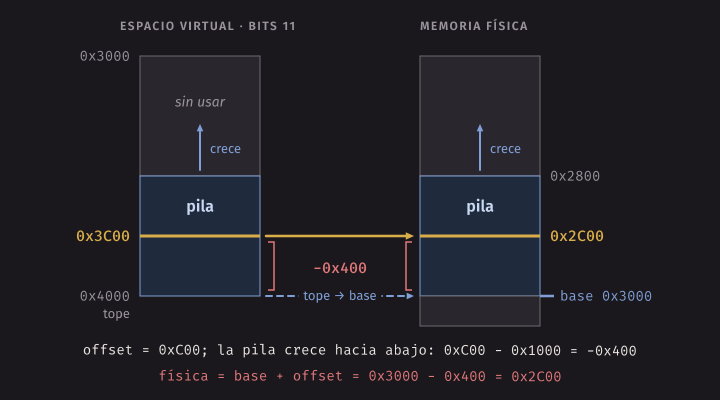
El hardware, en pseudocódigo
seg    = (va >> 12) & 0x3;   // 2 bits altos
offset = va & 0xFFF;         // 12 bits bajos
if (grows_neg[seg]) {
    offset = offset - 0x1000;          // offset negativo
    bad = -offset > size[seg];
} else
    bad = offset >= size[seg];
if (bad || !allowed(prot[seg], op))
    raise_exception(SEGFAULT);
pa = base[seg] + offset;
Desplazar y enmascarar bits es casi gratis en hardware: la segmentación sigue
siendo rápida. (Con 2 bits y 3 segmentos, el valor 10 queda sin usar.)
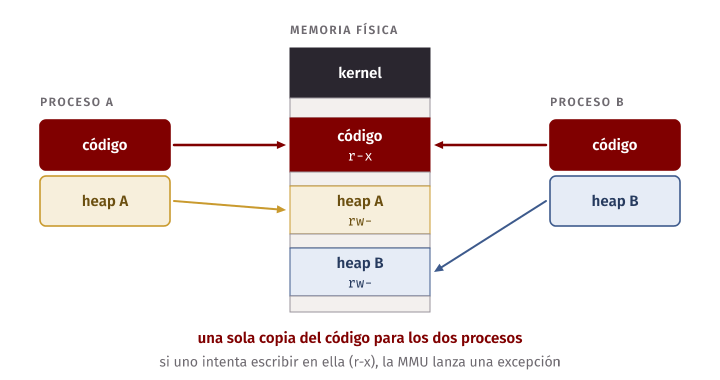
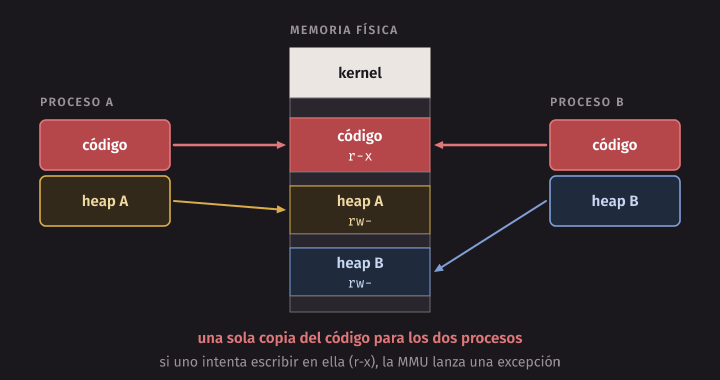
Compartir y proteger
Si dos procesos ejecutan el mismo programa, sus segmentos de código pueden
apuntar a la misma región física: una sola copia para todos. Para que sea
seguro, cada segmento tiene bits de protección (lectura, escritura,
ejecución) que la MMU verifica en cada acceso. El código se marca r-x: si un
proceso intenta escribir en él, excepción.
Fragmentación externa
La segmentación resuelve el desperdicio del hueco entre heap y pila, pero crea un problema nuevo. Los segmentos tienen tamaños distintos. A medida que se crean y terminan procesos, la memoria física libre queda partida en huecos de tamaños variados:
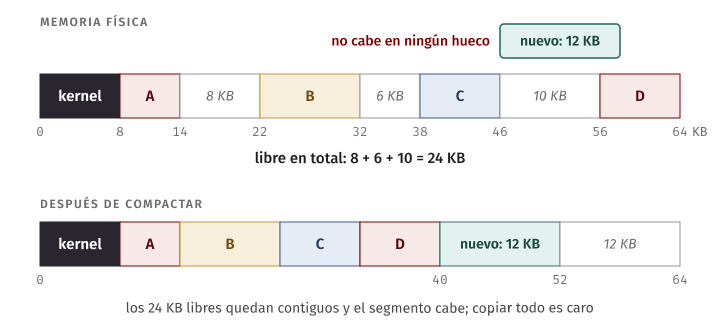
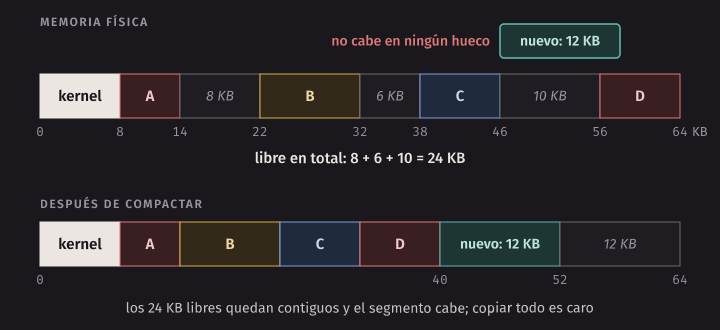
Hay 8 + 6 + 10 = 24 KB libres, pero un segmento nuevo de 12 KB no cabe en ningún hueco. Esto es la fragmentación externa (external fragmentation): hay memoria suficiente en total, pero no contigua.
Una salida es compactar: copiar los segmentos uno junto a otro y actualizar sus bases, dejando un único hueco de 24 KB; funciona, pero es caro. Otra es elegir bien el hueco (best fit, first fit, buddy…), tema de la semana que viene.
Idea clave. El origen de la fragmentación externa son los trozos de tamaño variable. Si toda la memoria se divide en trozos del mismo tamaño, desaparece. Esa es la idea de la paginación, el tema de la semana 6 y el mecanismo que usan xv6-riscv, Linux y casi todos los sistemas actuales.
En xv6. RISC-V no tiene segmentación: cada proceso de xv6 tiene una tabla de páginas (
p->pagetable) yp->szmarca el fin de su memoria. Al volver a modo usuario, el kernel carga esa tabla en el registrosatp: el equivalente a cargar base y límite.
Laboratorio: el planificador de xv6 por dentro
El laboratorio de esta semana vuelve a la CPU y prepara el proyecto P2 (planificador por lotería). La idea es leer el código real que decide qué proceso corre en xv6-riscv y verlo funcionar.
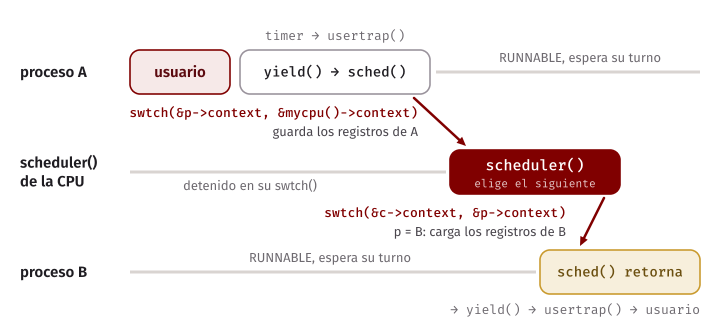
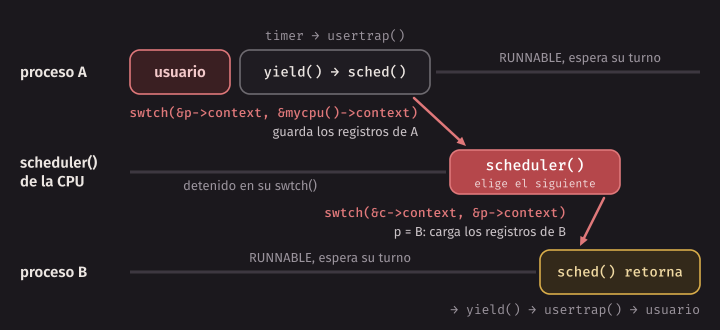
Del temporizador a sched()
Cada 0,1 s, aproximadamente, el temporizador interrumpe a la CPU y el trap llega
a usertrap() en kernel/trap.c. Esta llama a devintr(), que reconoce la
causa y retorna 2; al final, usertrap() hace if (which_dev == 2) yield();
(kerneltrap() hace lo mismo si corría el kernel). yield(), en
kernel/proc.c, toma p->lock, pone p->state = RUNNABLE y llama a
sched(), que tras unas verificaciones ejecuta
swtch(&p->context, &mycpu()->context): guarda los registros del proceso y
carga los del hilo planificador de esa CPU.
scheduler()
Cada CPU ejecuta, desde que arranca, un bucle infinito:
for (;;) {
  // ... intr_on(); intr_off();
  int found = 0;
  for (p = proc; p < &proc[NPROC]; p++) {
    acquire(&p->lock);
    if (p->state == RUNNABLE) {
      p->state = RUNNING;
      c->proc = p;
      swtch(&c->context, &p->context);
      // ...
      c->proc = 0;
      found = 1;
    }
    release(&p->lock);
  }
  if (found == 0) {
    asm volatile("wfi");
  }
}
(Se omitieron comentarios y el manejo de interrupciones.) Recorre proc[NPROC] en
orden y le da un quantum a cada proceso RUNNABLE: es un round robin. El
swtch retorna recién cuando ese proceso vuelve a llamar a sched(). Si no
hay nadie listo, wfi (wait for interrupt) detiene la CPU hasta la próxima
interrupción. En P2, este bucle sortea un boleto y corre solo al ganador.
kfork()
kfork(), la implementación de fork en el kernel, toma una entrada UNUSED
con allocproc(), copia la memoria del padre con uvmcopy() y su trapframe, y
pone a0 = 0 para que fork retorne 0 en el hijo. Al final:
acquire(&np->lock);
np->state = RUNNABLE;
release(&np->lock);

return pid;
En P2, aquí es donde el hijo debe heredar los boletos del padre.
Actividad: ver el orden de ejecución
Agreguen una línea en scheduler(), justo dentro del if (p->state == RUNNABLE). En xv6-riscv se imprime desde el kernel con printk (no con
printf, que es la función de usuario):
printk("[%d %s] ", p->pid, p->name);Con make qemu CPUS=1 y el comando echo hola se obtiene algo así:
init: starting sh
[2 init] [2 init] ... $ echo hola
[2 sh] [3 sh] [3 sh] [3 sh] [3 sh] [3 sh] [3 sh] hola
[2 sh] $
La shell (PID 2) hace fork; el hijo (PID 3) todavía se llama sh mientras
exec lee echo del disco. Cada [3 sh] es una vuelta del planificador: el
hijo se duerme esperando al disco y vuelve a quedar RUNNABLE cuando llega la
interrupción. Prueben también con CPUS=3 y con procesos que hagan un bucle
largo: xv6 no trae uno, así que escriban user/spin.c y agréguenlo como
$U/_spin a UPROGS en el Makefile.
Resumen
- El espacio de direcciones es la memoria tal como la ve un proceso: código, heap y pila, de 0 a un máximo. Es una ilusión; toda dirección que ve un programa es virtual.
- Las metas de la memoria virtual son transparencia, eficiencia y protección.
malloc,calloc,reallocyfreeson funciones de biblioteca que administran el heap; por debajo usanbrk/sbrkymmap.- Los errores de memoria (fugas, punteros colgantes, memoria sin inicializar,
doble
free) rara vez fallan de inmediato. valgrind los encuentra y dice dónde se reservó, se liberó y se usó cada bloque. - Con base y límite, la MMU calcula física = virtual + base y verifica virtual < límite en cada acceso. El kernel administra la lista libre y guarda y restaura los registros en cada cambio de contexto.
- La segmentación usa un par base/límite por segmento, con bits para elegir el segmento, un bit de sentido de crecimiento y bits de protección. Evita reservar los huecos y permite compartir código, pero sufre fragmentación externa.
- En xv6-riscv, la interrupción del temporizador lleva a
yield()→sched()→swtch()→scheduler(), un round robin sobreproc[NPROC].
Ejercicios
- Con base = 16 KB y límite = 4 KB, traduzcan las direcciones virtuales 0, 2000, 4095, 4096 y 5000 (en decimal). Para cada una, indiquen la dirección física en hexadecimal o si se produce una excepción.
- Con la tabla de segmentos de este capítulo, traduzcan
0x0123,0x0900,0x1BFF,0x3800y0x3700. Muestren la separación en bits, el offset y la comparación con el tamaño. (Pista: dos de ellas son inválidas.) - Un sistema usa base y límite y tiene 64 KB de memoria física, de los cuales el kernel usa los primeros 16 KB. Llegan, en orden, procesos de 12, 20 y 8 KB; luego termina el de 20 KB y llega uno de 24 KB. Dibujen la memoria después de cada paso. ¿Cabe el último? ¿Cuánta memoria libre hay en total?
- Modifiquen
leak.cpara que no tenga fugas y verifiquen con valgrind que el resumen dice All heap blocks were freed. Hagan lo mismo con los otros tres programas. - Escriban un programa que reserve
strlen(s)bytes (sin el+ 1) y copiesconstrcpy. ¿Qué mensaje da valgrind? ¿Qué pasa si lo compilan con-fsanitize=addressy lo ejecutan sin valgrind? - Ejecuten
layoutconsetarch -Ry lean/proc/self/mapsdesde el mismo programa (pueden agregarsystem("cat /proc/<pid>/maps")congetpid()). Identifiquen la región de cada dirección impresa. - En xv6-riscv, agreguen el
printkde la actividad, pero imprimiendo solo cuando el PID elegido sea distinto del anterior en esa CPU. Ejecuten dos procesos que hagan un bucle largo conCPUS=1y expliquen la secuencia que observan.