
Apuntes · Capítulo 6Memoria
Espacio libre y paginación
Espacio libre y paginación
La semana pasada vimos dos formas de repartir la memoria: malloc y free
administran el heap de un proceso, y la segmentación reparte la memoria física
entre los segmentos de todos los procesos. Las dos tienen algo en común:
entregan pedazos de tamaño variable. Y las dos sufren el mismo problema,
la fragmentación externa: después de un rato, la memoria libre queda partida
en muchos huecos chicos y una petición grande falla aunque, sumando, haya
espacio de sobra.
En la primera mitad estudiamos cómo se administra espacio libre de tamaño variable: la lista libre (free list), la división (splitting), la fusión (coalescing), el encabezado y las estrategias para elegir un hueco, más asignadores especializados y el de xv6. En la segunda mitad tomamos el camino opuesto: si los tamaños variables traen fragmentación, partimos todo en pedazos del mismo tamaño. Eso es la paginación, la base de la memoria virtual de todos los sistemas operativos modernos.
Ruta de lectura.
- Antes de clase (15–20 min): «El problema: huecos de tamaño variable», la primera parte de «La lista libre» (hasta «El encabezado: por qué
freeno pide el tamaño»), y «Páginas y marcos» y «VPN y offset», de «Paginación».- En clase: sesión A, «La lista libre», «Estrategias: ¿qué hueco elegir?», «Asignadores especializados» y «En xv6:
kallocykfree»; sesión B, «Paginación» y «Paginación en xv6-riscv: Sv39».- Después de clase: repasar el «Resumen», rehacer sin mirar «Un ejemplo más grande:
0x3229» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 17 y 18, «Slab allocator» y «Buddy allocator».
Lectura. Este capítulo acompaña a OSTEP cap. 17 Free-Space Management y cap. 18 Paging: Introduction. El código está en
code/week-06y se compila conmakedentro del contenedor del curso.
El problema: huecos de tamaño variable
Imaginen un heap de 64 KB en el que, después de varias asignaciones y
liberaciones, quedan tres huecos libres de 8, 12 y 10 KB, separados por
bloques en uso. Hay 30 KB libres, pero malloc(16 KB) falla: ningún hueco por
sí solo alcanza. Eso es fragmentación externa.
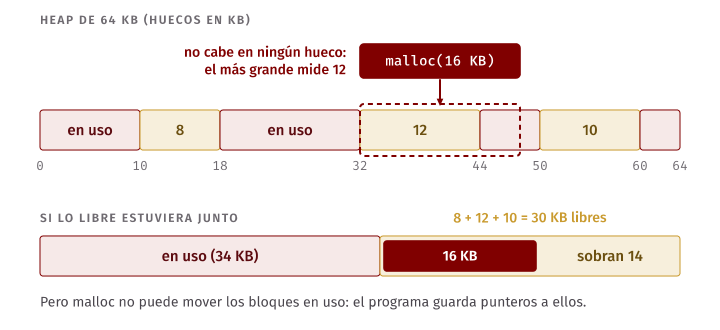
¿Por qué no juntar los bloques en uso para que lo libre quede contiguo? Porque
malloc no puede mover un bloque ya entregado: el programa guarda punteros
a él y el asignador no sabe dónde están.
Así que trabajamos con estos supuestos: la interfaz es malloc(size) y
free(ptr); el asignador administra una región contigua de bytes; y un bloque
entregado se queda donde está hasta que el programa lo libere.
La lista libre
La estructura básica es una lista libre (free list): una lista enlazada con
un nodo por cada hueco, que dice dónde empieza y cuánto mide. La pregunta
incómoda es dónde se guardan esos nodos. Un asignador no puede llamar a
malloc para pedir memoria para sus propias estructuras. La respuesta es
elegante: el nodo vive dentro del propio hueco. Los primeros bytes de cada
trozo libre guardan su tamaño y un puntero al siguiente trozo libre. Si el
hueco está libre, nadie más está usando esos bytes.
typedef struct node {
    size_t size;        // bytes libres después de este nodo
    struct node *next;  // siguiente trozo libre (por dirección)
} node_t;
En mymalloc.c implementamos un asignador
completo con esta idea, sobre una arena estática de 512 bytes. Al inicio
(mm_init) toda la arena es un solo trozo libre: un nodo de 16 bytes seguido de
496 bytes libres.
El encabezado: por qué free no pide el tamaño
free(ptr) recibe solo un puntero. Para devolver el bloque a la lista
necesita saber cuánto mide. La solución es que malloc guarde un
encabezado (header) justo antes del bloque que entrega:
typedef struct header {
    size_t size;   // bytes útiles del bloque
    size_t magic;  // MAGIC: sirve para detectar punteros inválidos
} header_t;
malloc devuelve la dirección que sigue al encabezado (h + 1), y free
retrocede para leerlo:
header_t *h = (header_t *)ptr - 1;
if (h->magic != MAGIC) abort();
Así, malloc(n) consume en realidad n + 16 bytes (y nuestro asignador
redondea n a 16 para mantener la alineación). El número mágico atrapa muchos
free con punteros que no vinieron de malloc o que apuntan al medio de un
bloque.
Noten que el encabezado y el nodo libre miden lo mismo (16 bytes) y ocupan el
mismo lugar. Cuando un trozo libre se asigna, su nodo se convierte en
encabezado; cuando se libera, el encabezado se convierte en nodo y el campo
magic queda pisado por next.
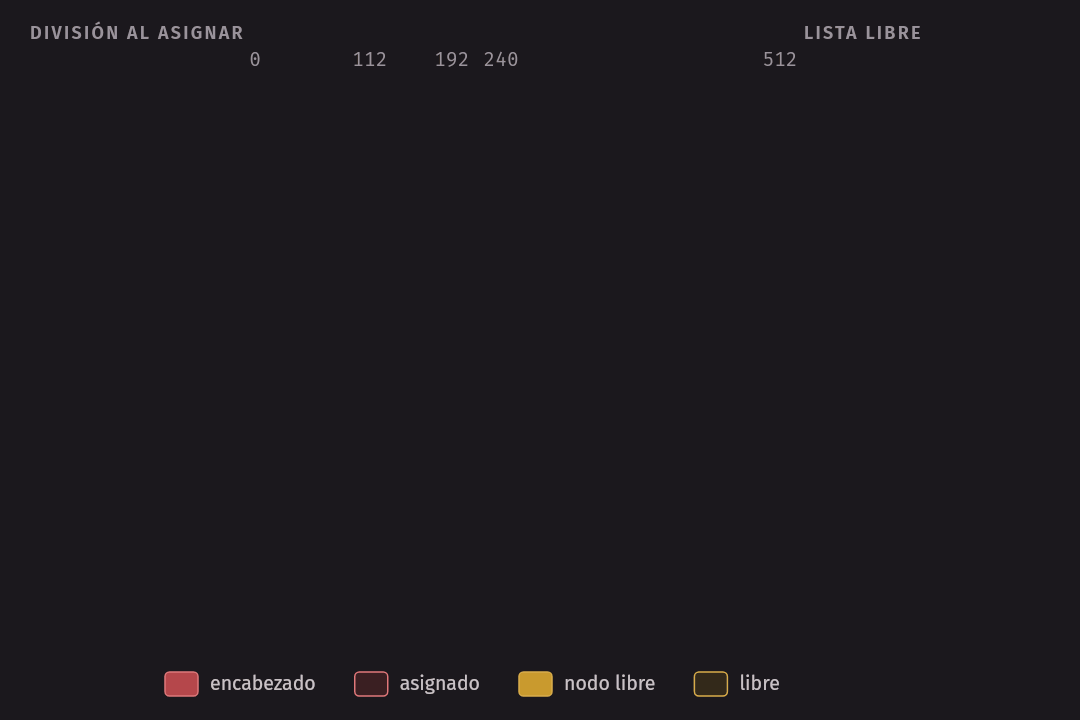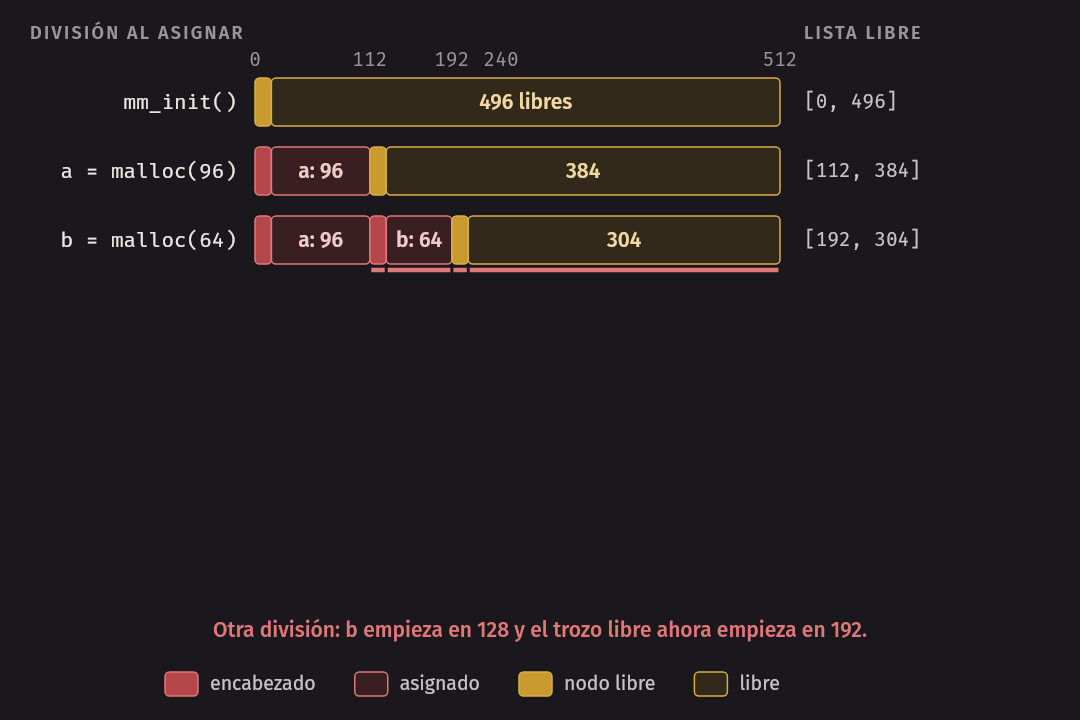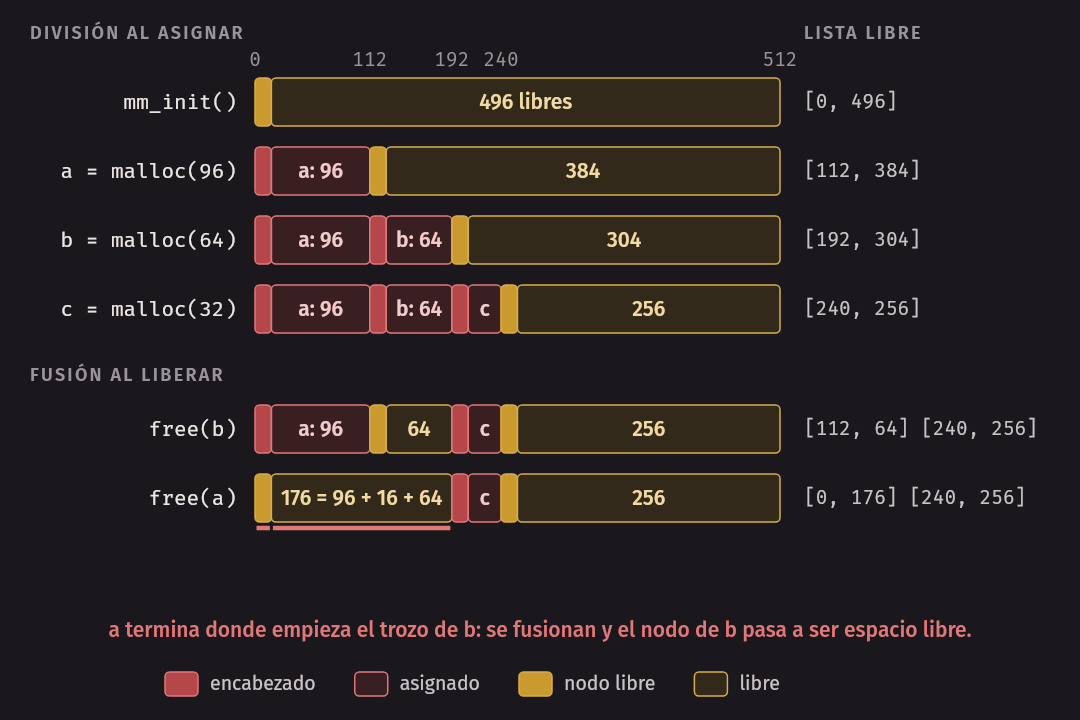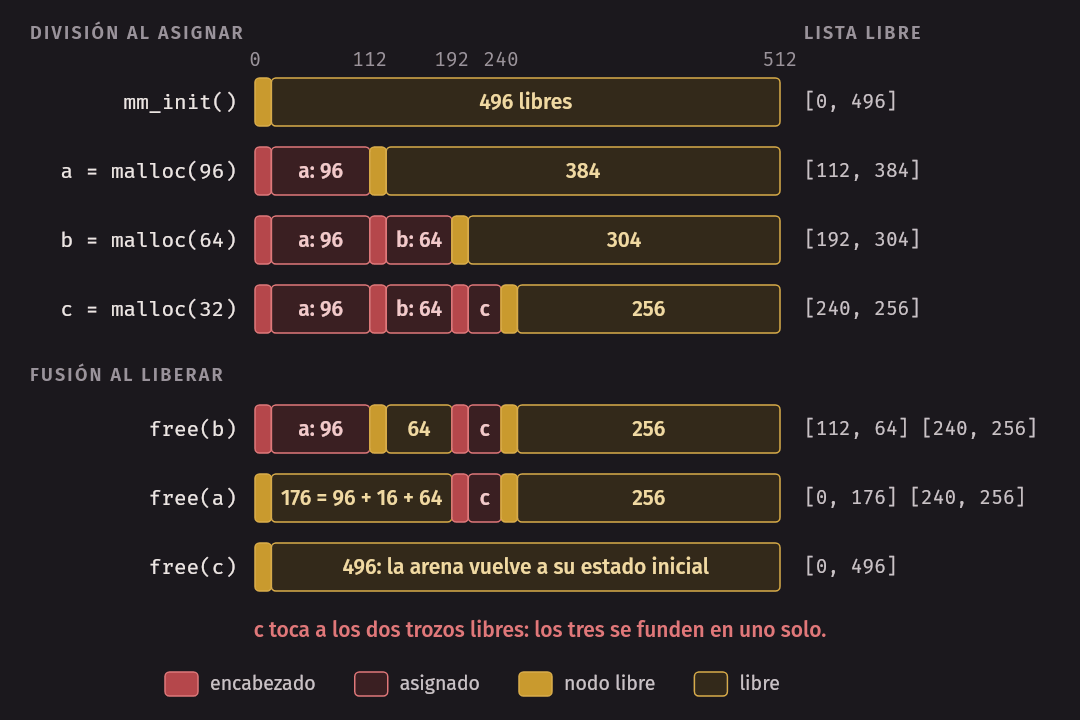
División al asignar
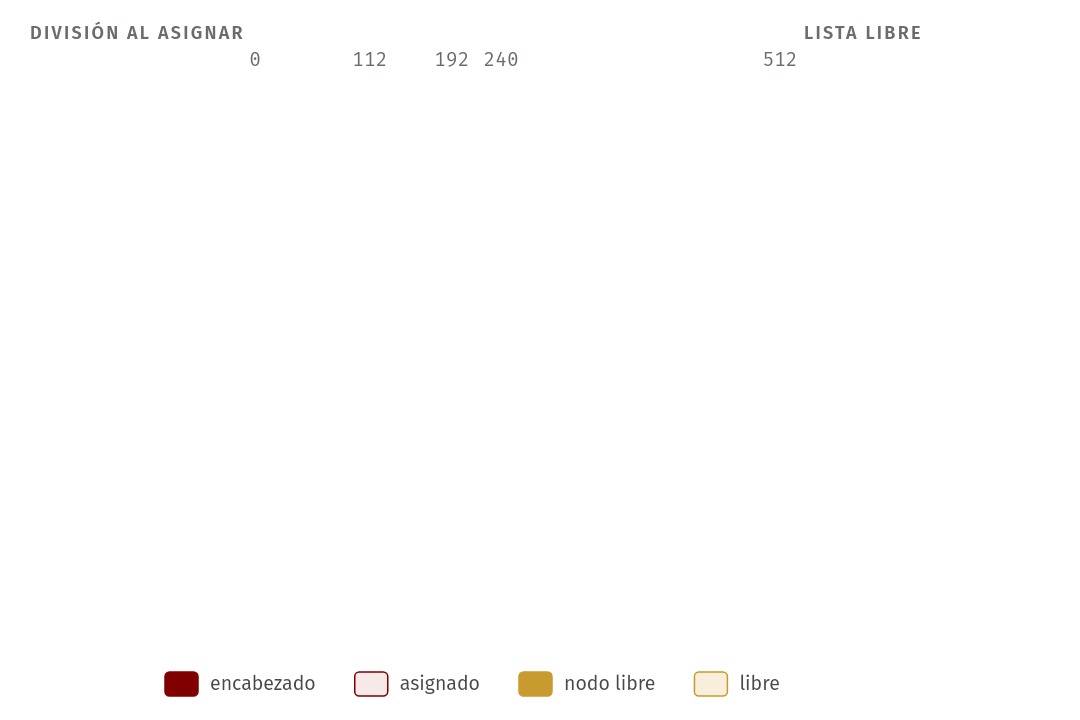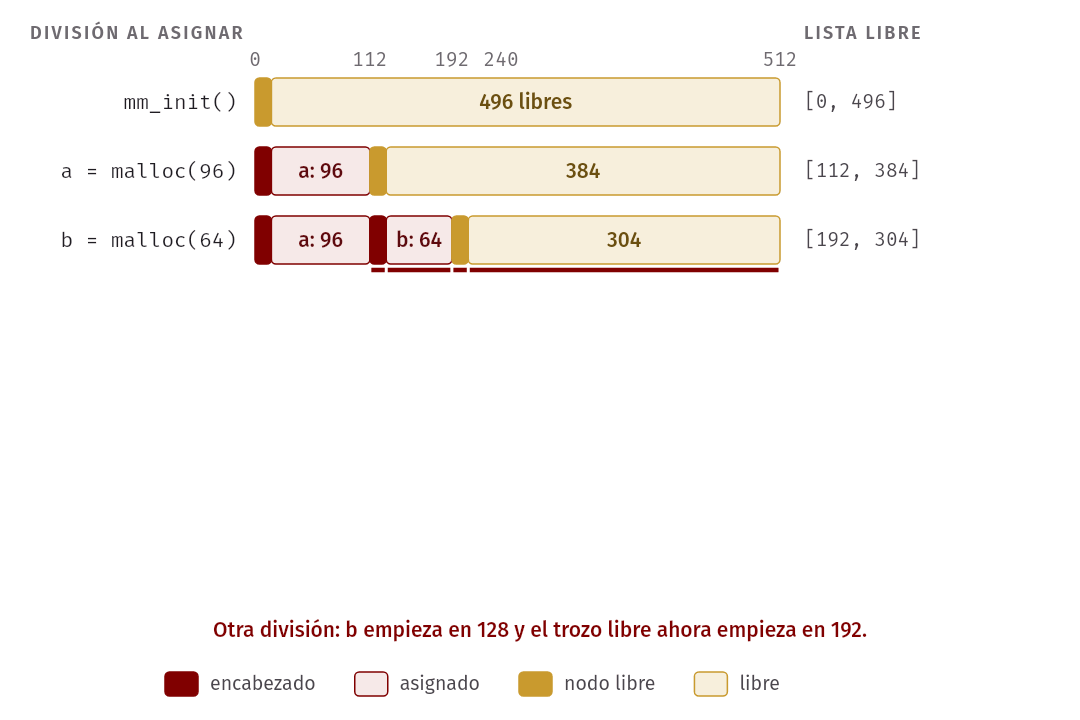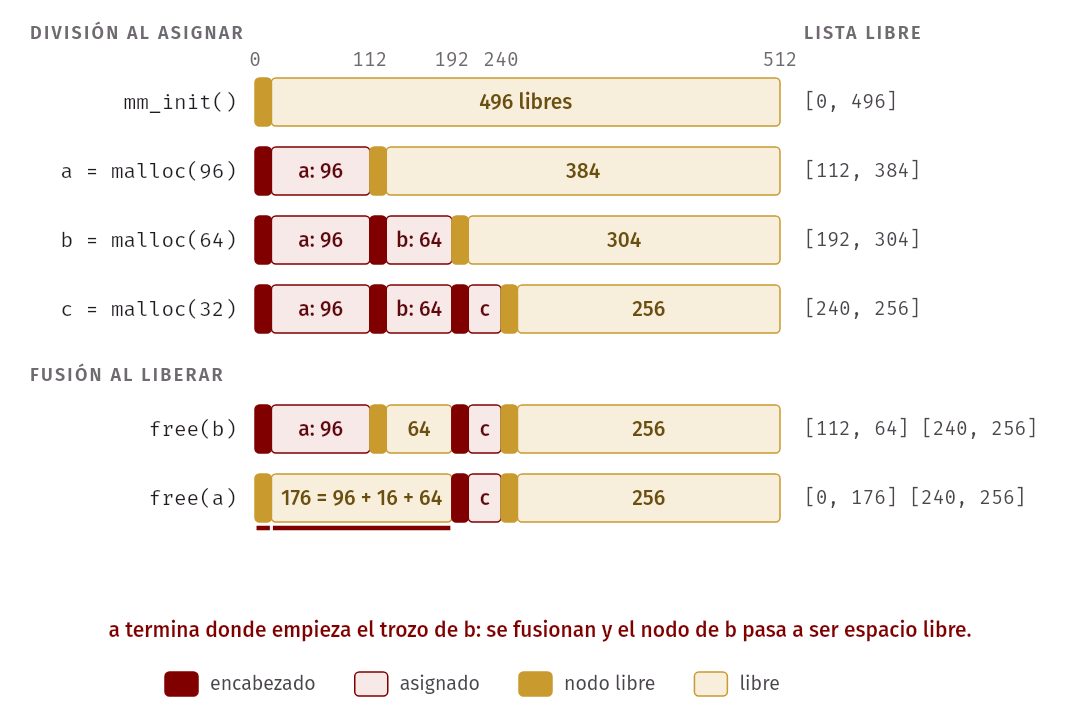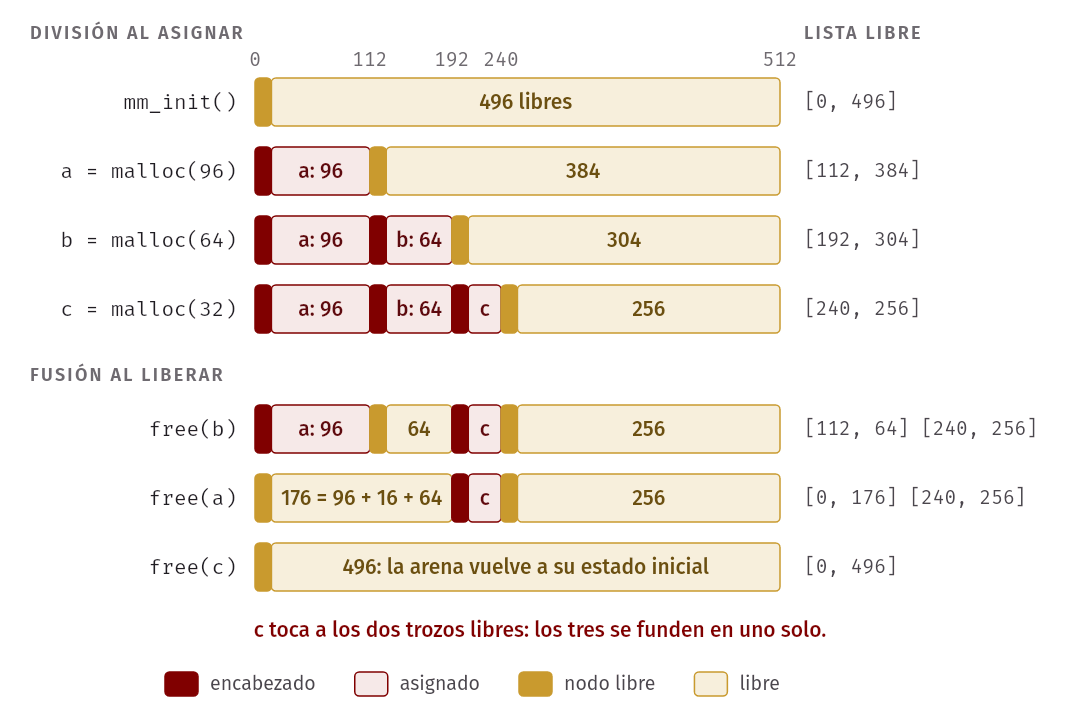
Cuando llega malloc(96), el asignador busca un trozo libre de al menos 96
bytes. El único trozo tiene 496: le sobran muchos. En vez de entregarlo
completo, lo divide (splitting): los primeros 16 + 96 bytes forman el
bloque asignado y el resto se convierte en un trozo libre nuevo, con su propio
nodo. Esta es la traza que imprime ./heapdemo:
arena de 512 bytes, fusión activada
  lista libre: [0, size 496]
a = malloc(96) -> 16 (encabezado en 0)
  lista libre: [112, size 384]
b = malloc(64) -> 128 (encabezado en 112)
  lista libre: [192, size 304]
c = malloc(32) -> 208 (encabezado en 192)
  lista libre: [240, size 256]
Cada número entre corchetes es el desplazamiento del nodo dentro de la arena y
el tamaño libre que sigue. Verifiquen la aritmética: después de a, el trozo
libre empieza en 0 + 16 + 96 = 112 y tiene 496 - 96 - 16 = 384 bytes (los
96 que se llevó a y los 16 del nodo nuevo).
¿Y si sobra muy poco? Si después de dividir quedaran, digamos, 8 bytes, no alcanzan ni para el nodo. El asignador solo divide si el resto alcanza para un nodo y al menos 16 bytes de datos; si no, entrega el trozo completo. Esos bytes de más dentro de un bloque asignado son fragmentación interna: memoria entregada que el programa no pidió. El redondeo a 16 también es fragmentación interna.
En el código, mm_malloc recorre la lista con un puntero link al campo
next del nodo anterior (o a head), así puede reemplazar o quitar un nodo
sin un caso especial para la cabeza de la lista.
Fusión al liberar
Ahora liberamos los tres bloques en el orden b, a, c:
free(b)
  lista libre: [112, size 64] [240, size 256]
free(a)
  lista libre: [0, size 176] [240, size 256]
free(c)
  lista libre: [0, size 496]
Al liberar b aparece un trozo nuevo. Al liberar a, el asignador nota que
a termina exactamente donde empieza el trozo de b (0 + 16 + 96 = 112) y los
fusiona (coalescing) en uno solo de 96 + 16 + 64 = 176 bytes: se suman los
dos tamaños y además el nodo que sobra. Al liberar c, este queda pegado al
trozo de la izquierda y al de la derecha: los tres se funden y la arena vuelve
a su estado inicial.
Para fusionar hace falta saber quiénes son los vecinos, y la forma más simple es
mantener la lista ordenada por dirección. mm_free inserta el nodo en su
lugar y luego compara con el siguiente y con el anterior:
if (cur != NULL && adjacent(n, cur)) {     // vecino derecho
    n->size += sizeof(node_t) + cur->size;
    n->next = cur->next;
}
if (prev != NULL && adjacent(prev, n)) {   // vecino izquierdo
    prev->size += sizeof(node_t) + n->size;
    prev->next = n->next;
}
El precio es que liberar cuesta O(n): hay que recorrer la lista para encontrar el lugar.
¿Qué pasa sin fusión? ./heapdemo -n repite la traza con la fusión desactivada:
free(c)
  lista libre: [0, size 96] [112, size 64] [192, size 32] [240, size 256]
d = malloc(300) -> NULL
Hay 448 bytes libres, pero partidos en cuatro trozos, y una petición de 300 falla. El asignador fabricó su propia fragmentación externa. Con fusión, la misma petición tiene éxito.
Idea clave. Una lista libre vive dentro del espacio que administra. Se divide al asignar para no desperdiciar, y se fusiona al liberar para que los huecos vuelvan a crecer. El encabezado guarda lo que
freenecesita saber.
Las pruebas de heaptest.c (make test)
verifican la división, que no se creen trozos de cero bytes, que liberar tres
bloques vecinos en los seis órdenes posibles siempre devuelve un solo trozo,
que sin fusión la arena queda fragmentada, y que el número mágico detecta un
puntero al medio de un bloque.
Un asignador real, además, pide más memoria al sistema operativo (con sbrk
o mmap) cuando la lista no alcanza; el nuestro devuelve NULL.
Estrategias: ¿qué hueco elegir?
Si varios huecos alcanzan, ¿cuál se usa? Hay cuatro estrategias clásicas:
| Estrategia | Regla | Costo de búsqueda |
|---|---|---|
| First fit | el primer hueco que alcance | hasta encontrar uno |
| Best fit | el hueco más chico que alcance | toda la lista |
| Worst fit | el hueco más grande | toda la lista |
| Next fit | como first fit, pero empieza donde terminó la búsqueda anterior | hasta encontrar uno |
Best fit intenta desperdiciar lo menos posible en cada petición; worst fit, que la sobra siga siendo grande y útil. Next fit reparte el desgaste: first fit tiende a llenar de astillas el principio de la lista.
Comparémoslas con un ejemplo. Hay cuatro huecos de 10, 20, 6 y 14 KB (h0 a h3,
en orden de dirección) y llegan las peticiones 4, 8, 4 y 16. Usamos un
modelo simplificado, como el simulador malloc.py de OSTEP: sin encabezados ni
fusión, cada petición se toma del inicio del hueco elegido, y ante un empate
gana el hueco de menor dirección. El programa fits.c
hace la simulación:
$ ./fits 10,20,6,14 4,8,4,16
huecos iniciales [10 20  6 14]

política    4   8   4  16   huecos al final
best       h2  h0  h3  h1   [ 2  4  2 10]
worst      h1  h1  h3  --   [10  8  6 10]  1 sin hueco
first      h0  h1  h0  --   [ 2 12  6 14]  1 sin hueco
next       h0  h1  h1  --   [ 6  8  6 14]  1 sin hueco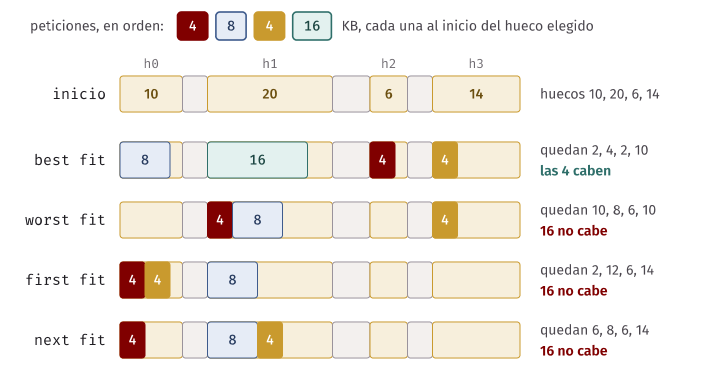
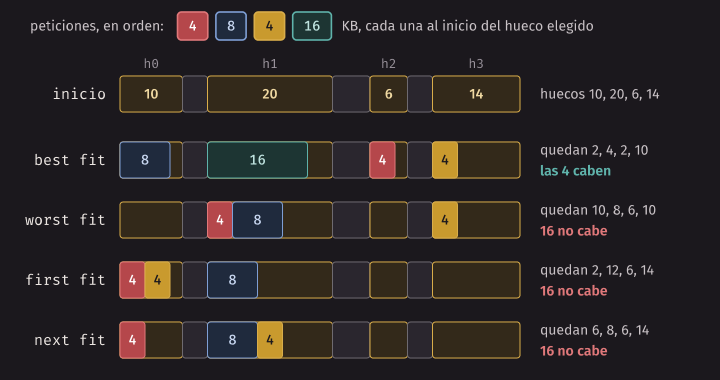
Sigamos una a mano, best fit. Para 4, el hueco más chico que alcanza es h2 (6), que queda en 2. Para 8, el más chico que alcanza es h0 (10), que queda en 2. Para 4, quedan h1 (20) y h3 (14): elige h3, que queda en 10. Para 16, solo h1 alcanza. Las cuatro peticiones caben.
Worst fit, en cambio, gasta el hueco de 20 en las dos primeras peticiones (20 → 16 → 8) y cuando llega la de 16 ya no hay ningún hueco de ese tamaño. First fit y next fit coinciden en las dos primeras peticiones y se separan en la tercera: first fit vuelve a h0, mientras que next fit sigue buscando desde h1, donde asignó la última vez. Ninguna de las dos deja un hueco de 16.
En este ejemplo gana best fit, pero no conviene sacar conclusiones generales: es fácil construir secuencias donde best fit falla y worst fit no. Best fit tiende a dejar astillas (los huecos de 2 KB del ejemplo) que nadie llega a usar. La lección: no hay una estrategia ganadora; todas sufren fragmentación externa y la mejor depende de la carga.
Asignadores especializados
Listas segregadas
Muchos programas piden una y otra vez los mismos tamaños: nodos de una lista, estructuras de un árbol. Las listas segregadas (segregated lists) mantienen una lista aparte por clase de tamaño (16, 32, 64, 128 bytes…). Pedir 24 bytes es sacar el primer elemento de la lista de 32: O(1), sin buscar ni dividir, y liberar es devolverlo a esa misma lista. Lo que no cae en ninguna clase se deriva a un asignador general.
La dificultad es decidir cuánta memoria dedicar a cada clase. Si la lista de 64 se vacía mientras la de 16 tiene cientos de elementos libres, hay que poder mover memoria de una clase a otra.
Slab allocator
El slab allocator (Bonwick, Solaris, 1994; hoy también en Linux) aplica la idea a los objetos del kernel. Hay un cache por tipo de objeto (procesos, inodos, locks…). Cada cache tiene uno o más slabs: unas pocas páginas partidas en objetos de exactamente ese tamaño. Si un cache se queda sin objetos libres, pide páginas nuevas al asignador general para armar otro slab; si la memoria escasea, el asignador general puede pedir de vuelta los slabs vacíos.
Además, los objetos libres se guardan ya inicializados: armar un objeto del kernel (sus locks, sus listas) puede costar más que asignarlo, y reusar uno ya armado ahorra ese trabajo.
Buddy allocator
El buddy allocator busca que fusionar sea barato. Todos los bloques miden una potencia de 2. Partimos de una arena de 64 KB y llega un pedido de 7 KB. El asignador divide a la mitad hasta llegar al bloque más chico que alcance:
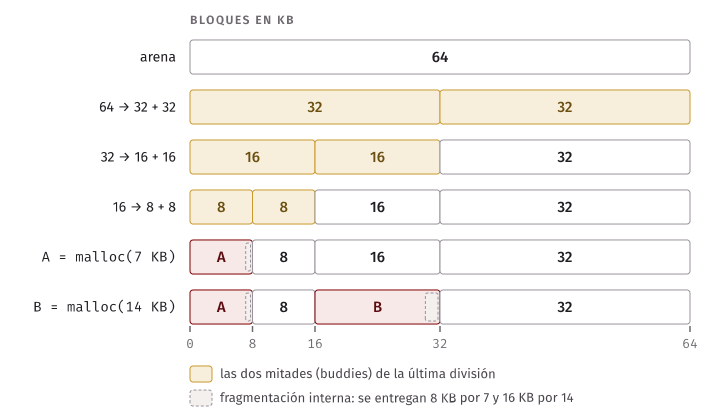
Las dos mitades que salen de una división son buddies (compañeros). Se entregaron 8 KB para un pedido de 7: 1 KB de fragmentación interna. Si después llega un pedido de 14 KB, el bloque libre de 16 KB (en la dirección 16) alcanza sin dividir.
La gracia está al liberar. Un bloque de tamaño s en la dirección a tiene a su
buddy en a XOR s: las direcciones de dos buddies difieren en un solo bit.
Continuemos el ejemplo liberando A (el bloque de 8 en la dirección 0):
| Bloque | Buddy (a XOR s) |
¿Libre? |
|---|---|---|
| A: a = 0, s = 8 | 000000 XOR 001000 = 8 |
sí: fusionar en a = 0, s = 16 |
| a = 0, s = 16 | 000000 XOR 010000 = 16 |
no (es B): parar |
Al liberar después B (a = 16, s = 16), su buddy es 16 XOR 16 = 0, que está
libre: se fusionan en un bloque de 32 en la dirección 0, cuyo buddy es
0 XOR 32 = 32, también libre. Resultado: de vuelta un bloque de 64 KB.
Fusionar es rápido y recursivo, sin recorrer listas largas. El precio es la fragmentación interna: un pedido de 33 KB se lleva un bloque de 64.
En xv6: kalloc y kfree
El kernel de xv6-riscv necesita memoria física para las páginas de los procesos, las pilas del kernel, las propias tablas de páginas y los buffers de los pipes. Toda esa memoria se pide en páginas de 4096 bytes a un asignador muy simple.
En xv6.
kernel/kalloc.ces una lista libre real. Al arrancar,kinit()llama afreerange(end, (void *)PHYSTOP), que pasa porkfreecada página entre el final del kernel (end) y el final de la RAM (PHYSTOP,0x88000000).kfreellena la página de basura (para que un puntero colgante se note) y la empuja al inicio de la lista. Igual que en nuestro asignador, el nodo vive dentro de la página libre:struct run { struct run *next; }; ... r = (struct run *)pa; acquire(&kmem.lock); r->next = kmem.freelist; kmem.freelist = r; release(&kmem.lock);
kalloc()hace lo inverso: saca la cabeza de la lista. La lista es una pila (LIFO): la última página liberada porkinit,PHYSTOP - 4096 = 0x87fff000, es la primera que se entrega. El spinlockkmem.lockprotege la lista porque varias CPUs pueden pedir páginas a la vez.
Fíjense en lo que no tiene: ni división, ni fusión, ni estrategia de
búsqueda, ni encabezado. Todos los bloques miden lo mismo, así que cualquier
página libre sirve para cualquier pedido y kfree no necesita saber el tamaño.
No hay fragmentación externa. Esa es exactamente la idea de la paginación.
Paginación
Páginas y marcos
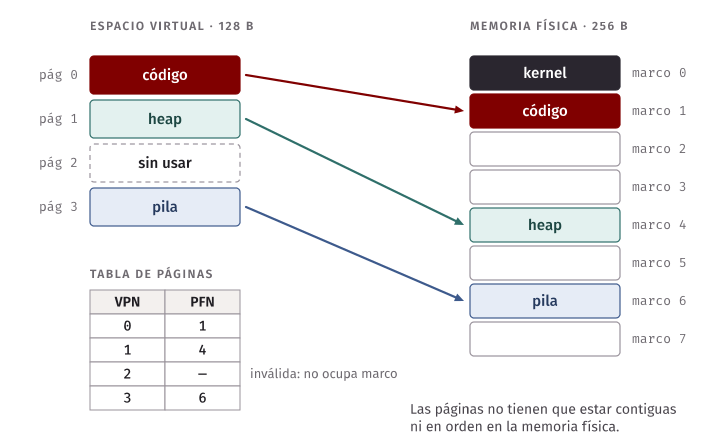
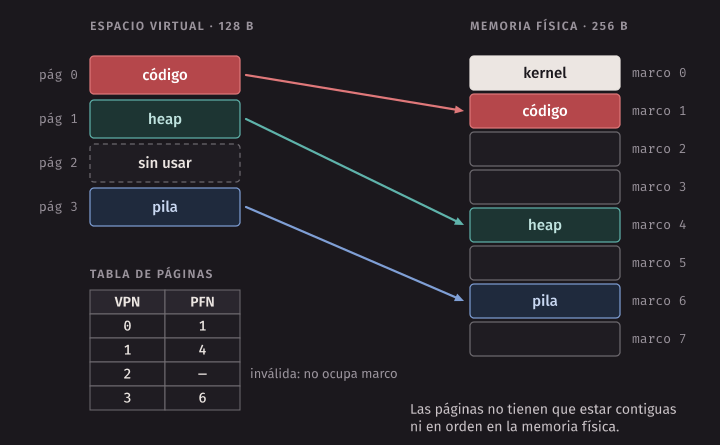
La paginación parte el espacio de direcciones de cada proceso en páginas (pages) de tamaño fijo, y la memoria física en marcos de página (page frames) del mismo tamaño. Cualquier página puede ir en cualquier marco libre: las páginas de un proceso no tienen que estar contiguas en memoria física ni en orden. Para cada proceso, una tabla de páginas (page table) registra en qué marco está cada página.
Un ejemplo de juguete: un espacio de direcciones de 128 bytes con páginas de 32 bytes (4 páginas), en una memoria física de 256 bytes (8 marcos). El código (página 0) está en el marco 1, el heap (página 1) en el marco 4 y la pila (página 3) en el marco 6. La página 2, entre el heap y la pila, no se usa y no ocupa ningún marco. El marco 0 lo usa el kernel. La tabla de páginas es:
| VPN | PFN |
|---|---|
| 0 | 1 |
| 1 | 4 |
| 2 | — (inválida) |
| 3 | 6 |
VPN y offset
Como las páginas miden una potencia de 2, separar una dirección virtual en “qué página” y “dónde dentro de la página” es cortar bits. Con páginas de 32 = 2^5 bytes, los 5 bits bajos son el offset y los bits restantes son el número de página virtual (virtual page number, VPN).
Traduzcamos la dirección virtual 0x7b (123) en el ejemplo de juguete. Las
direcciones tienen 7 bits (128 = 2^7):
0x7b = 11 | 11011
VPN = 11 (binario) = 3, offset = 11011 (binario) = 27
PTE[3]: PFN = 6 = 110 (binario)
PA = 110 | 11011 = 0xdb = 219
Solo se traduce el VPN; el offset pasa tal cual, porque una página entera va a un marco entero y el byte 27 de la página es el byte 27 del marco. En C:
vpn    = va >> 5;
offset = va & 0x1f;
pa     = (pfn << 5) | offset;
Un ejemplo más grande: 0x3229
Esta es la pregunta de repaso 2. Páginas de 1 KB y un espacio de direcciones de 16 páginas (16 KB, direcciones de 14 bits). La tabla de páginas del proceso:
| VPN | PFN | VPN | PFN |
|---|---|---|---|
| 0 | 5 | 8 | — |
| 1 | 12 | 9 | — |
| 2 | — | 10 | — |
| 3 | — | 11 | — |
| 4 | 30 | 12 | 29 |
| 5 | — | 13 | — |
| 6 | — | 14 | — |
| 7 | — | 15 | 7 |
Paso a paso:
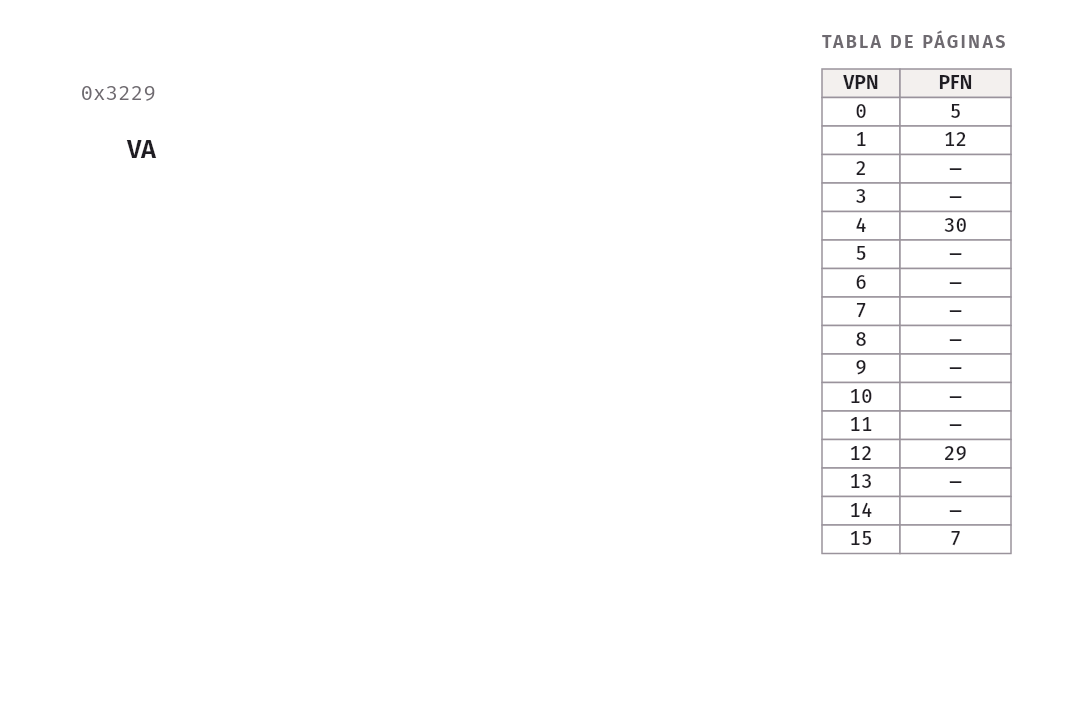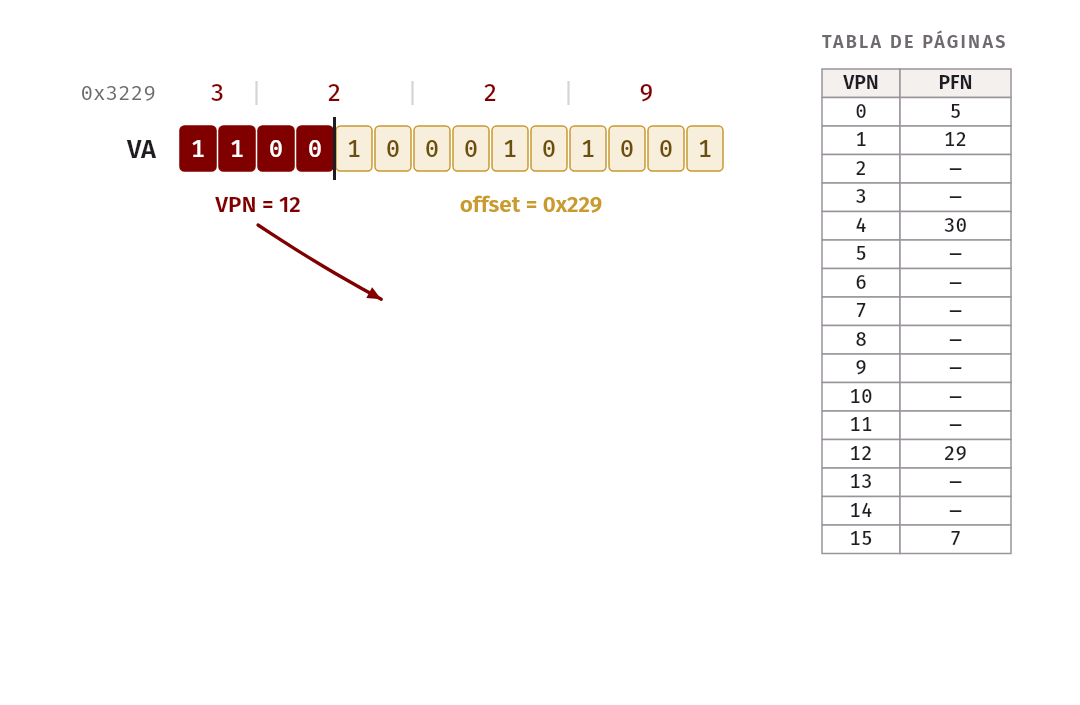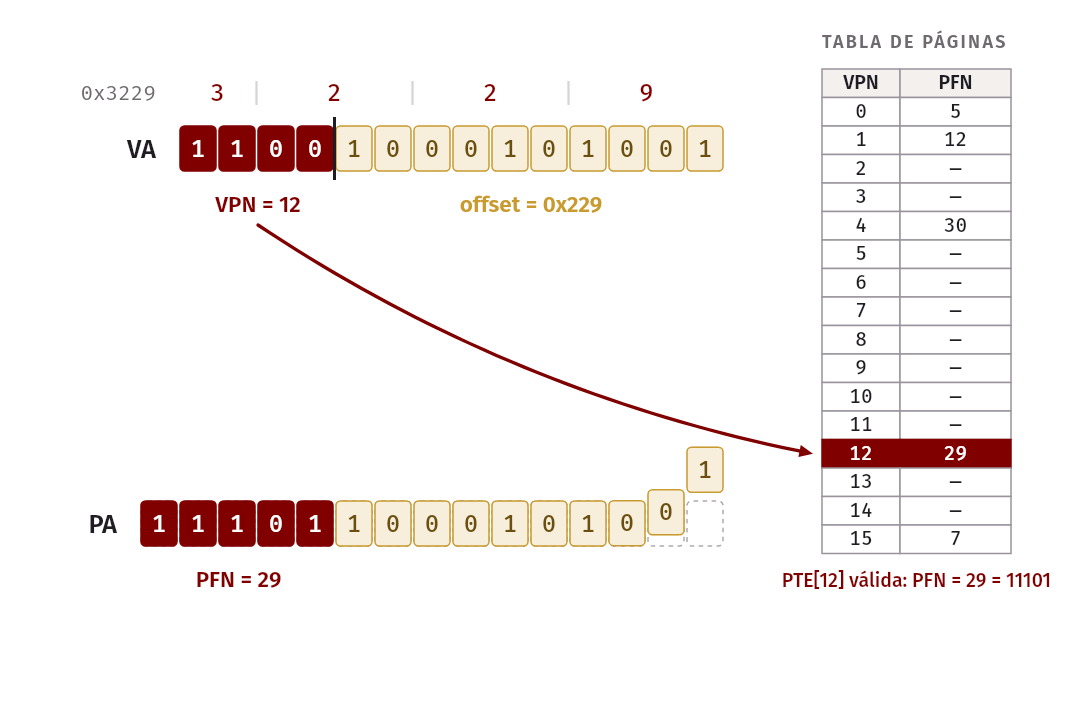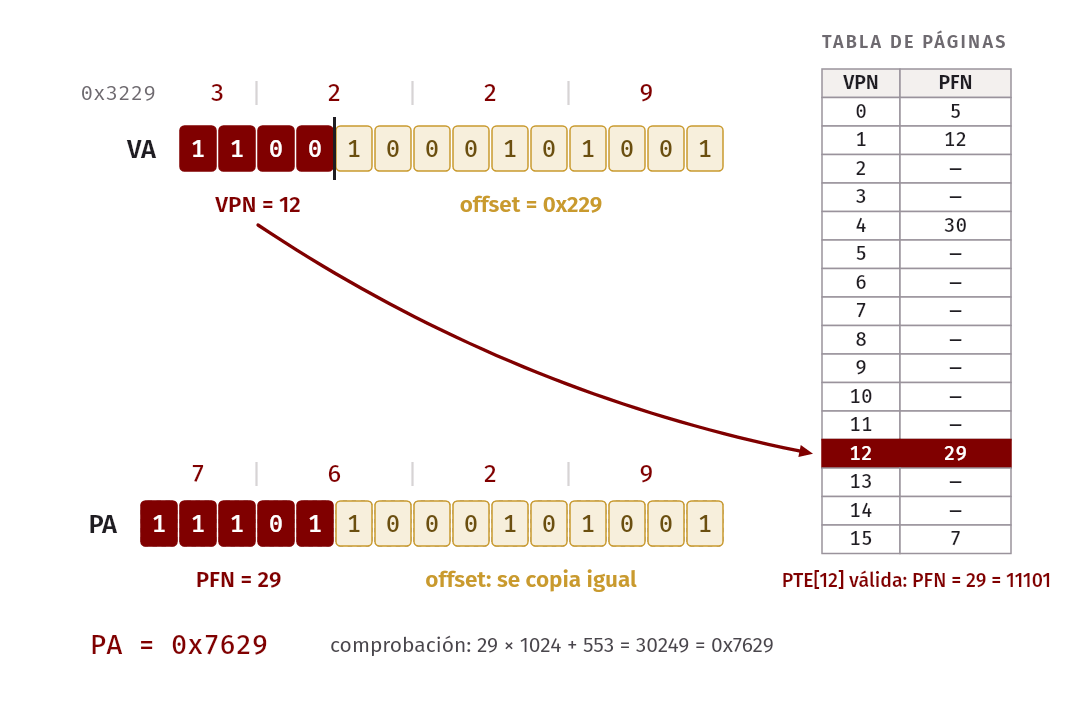
- Hexadecimal a binario. Cada dígito hexadecimal son 4 bits:
3= 0011,2= 0010,2= 0010,9= 1001. Con 14 bits:11 0010 0010 1001. - Separar. Páginas de 1 KB = 2^10 bytes: 10 bits de offset y 4 de VPN.
VPN =
1100= 12. Offset =10 0010 1001=0x229= 553. - Buscar en la tabla. PTE[12] es válida y tiene PFN = 29 =
11101. - Pegar. PA =
11101seguido de1000101001=111 0110 0010 1001=0x7629. Comprobación en decimal: 29 × 1024 + 553 = 30249 =0x7629.
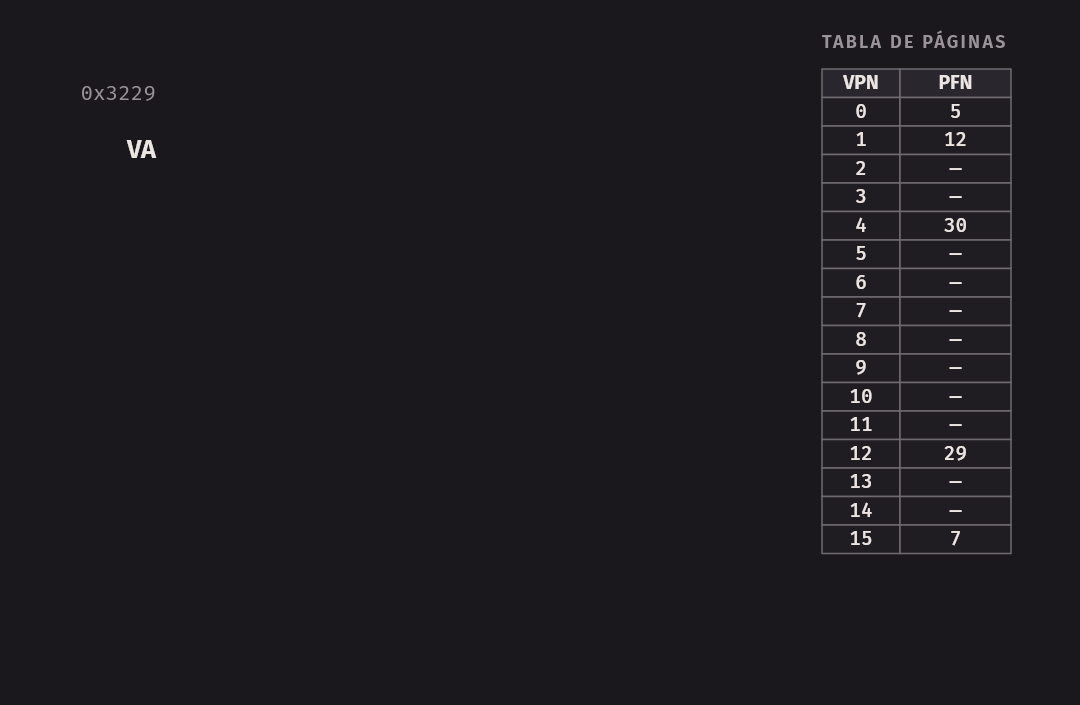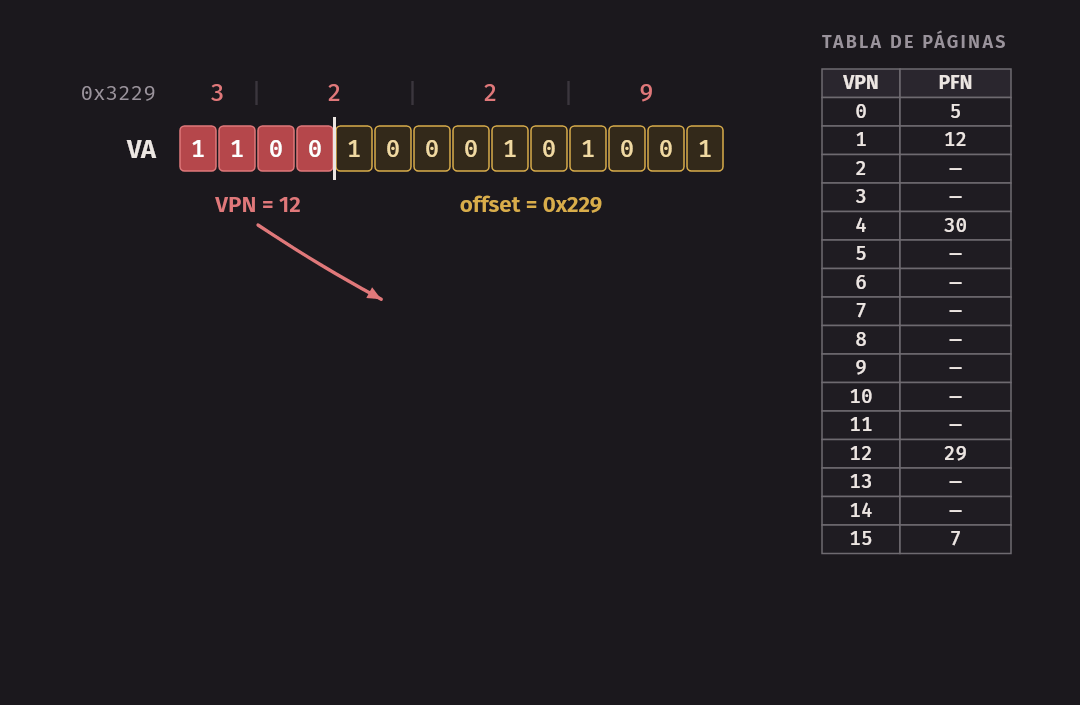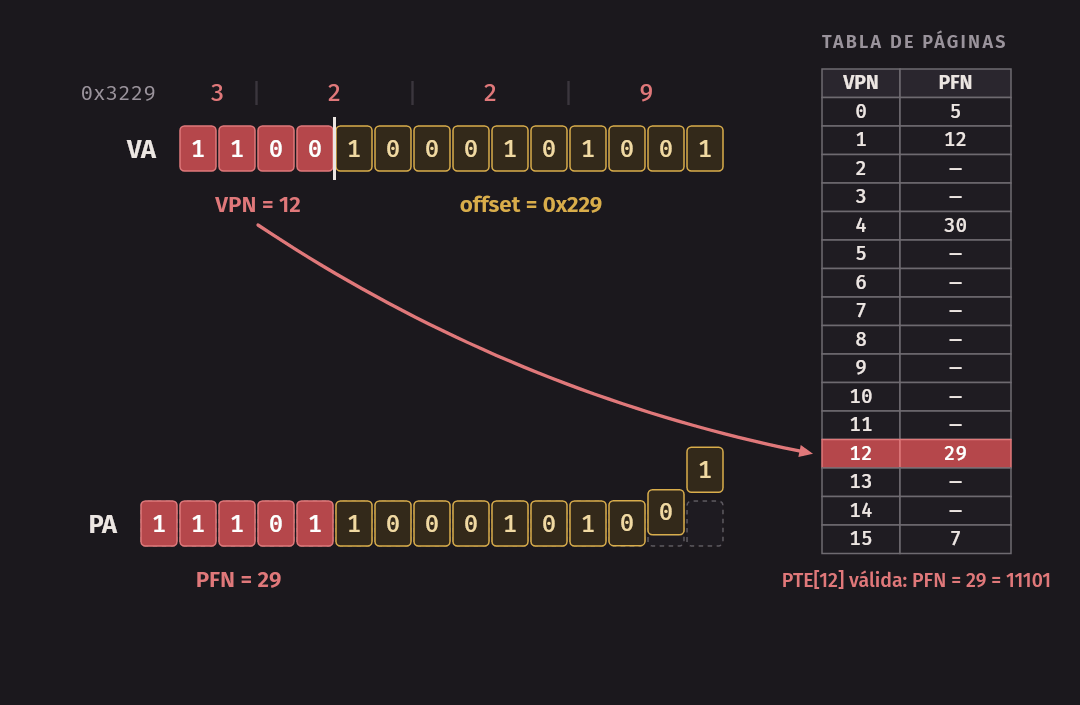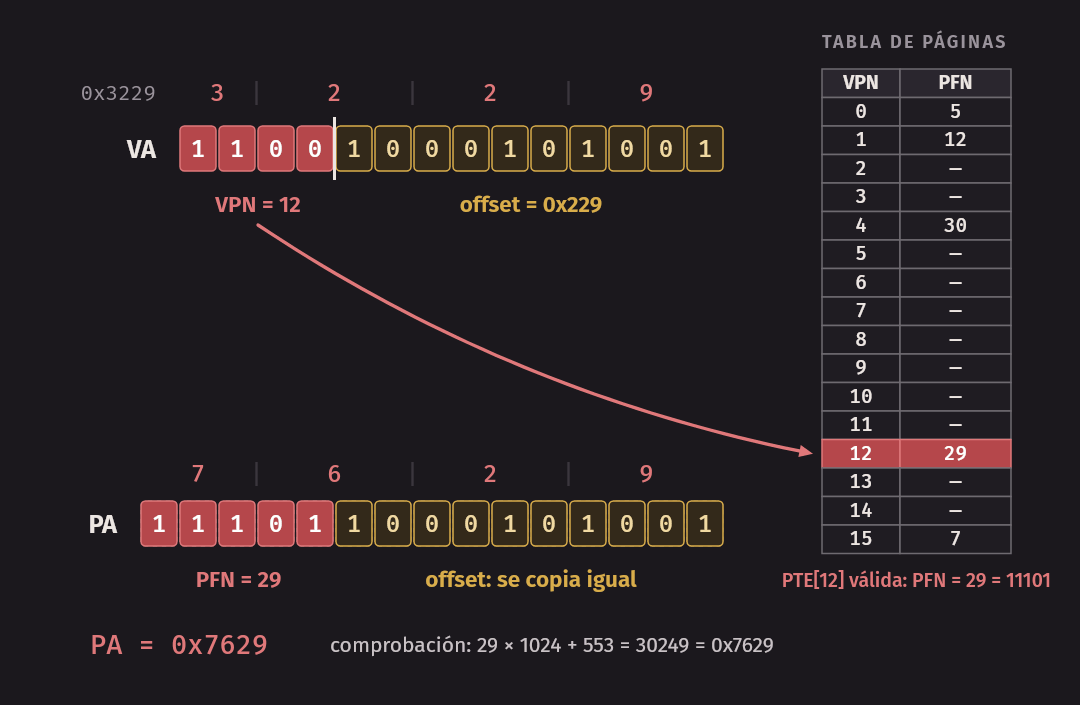
El programa translate.c hace lo mismo con
cualquier tabla. Prueben primero a mano y luego verifiquen:
$ ./translate 1024 5,12,-,-,30,-,-,-,-,-,-,-,29,-,-,7 0x3229 0x13ff 0x0a0f
...
VA 0x3229 = 1100 | 1000101001
  VPN = 12, offset = 0x229
  PTE[12]: PFN = 29 = 0x1d
  PA = 11101 | 1000101001 = 0x7629

VA 0x13ff = 0100 | 1111111111
  VPN = 4, offset = 0x3ff
  PTE[4]: PFN = 30 = 0x1e
  PA = 11110 | 1111111111 = 0x7bff

VA 0x0a0f = 0010 | 1000001111
  VPN = 2, offset = 0x20f
  PTE[2] inválida -> excepción (fallo de segmentación)
0x13ff es el último byte de la página 4 y cae en el último byte del marco 30.
0x0a0f está en la página 2, que no está en uso: la MMU no puede traducirla y
lanza una excepción. El kernel decide qué hacer; normalmente, terminar el
proceso con un segmentation fault.
Qué hay en una PTE
Cada entrada de la tabla de páginas (page table entry, PTE) guarda el número de marco (physical frame number, PFN) y varios bits de control:
- Válido (valid): ¿la página existe en el espacio de direcciones? Gracias a este bit, las páginas sin usar entre el heap y la pila no gastan ningún marco.
- Protección: ¿se puede leer, escribir, ejecutar? ¿Desde modo usuario o solo desde el kernel? Un acceso que viola la protección también genera una excepción.
- Presente (present): ¿la página está en memoria física o fue enviada a disco (swap)? Lo usaremos en las semanas 9 y 10.
- Sucio (dirty): ¿se escribió en la página desde que se cargó? Si hay que sacarla de memoria, solo las páginas sucias necesitan guardarse en disco.
- Referencia (accessed): ¿se usó hace poco? Ayuda a elegir qué página reemplazar cuando falta memoria.
Dónde vive la tabla y el costo en tiempo
La tabla de páginas es demasiado grande para guardarla dentro de la MMU, así
que vive en memoria física, en páginas que administra el kernel. Un registro
de la CPU, el page table base register (PTBR), dice dónde empieza la tabla
del proceso actual; en RISC-V ese registro se llama satp. En cada cambio de
contexto, el kernel cambia el registro: cada proceso tiene su propia tabla.
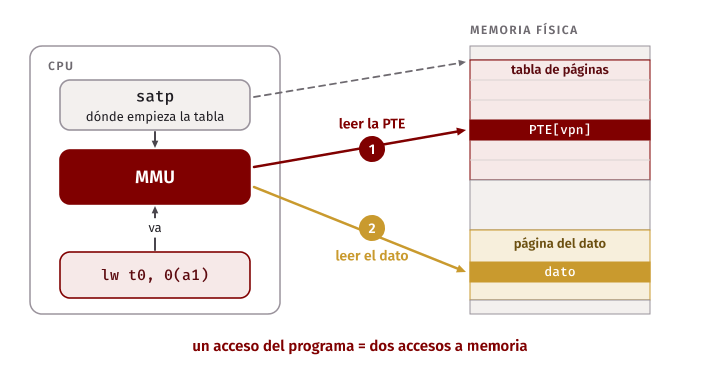
En cada acceso a memoria, la MMU hace algo así:
vpn    = va >> OFFSET_BITS;
offset = va & (PAGE_SIZE - 1);
pte    = mem[ptbr + vpn * sizeof(pte)];   // ¡un acceso extra!
if (!pte.valid)
    trap(PAGE_FAULT);
if (!permitted(pte, kind_of_access))
    trap(PROTECTION_FAULT);
pa  = (pte.pfn << OFFSET_BITS) | offset;
val = mem[pa];                            // el acceso que pidió el programa
El problema está en la tercera línea: para hacer un acceso a memoria, hay que hacer dos, porque antes hay que leer la PTE. Y esto vale para todo acceso, incluida la lectura de cada instrucción. Tomen este bucle:
for (i = 0; i < 1000; i++)
    sum += a[i];
compilado a algo como cuatro instrucciones RISC-V (lw, add, addi, bne).
Cada vuelta lee 4 instrucciones y 1 dato: 5 accesos a memoria. Con paginación
lineal, cada uno necesita antes su PTE: 10 accesos por vuelta, 10 000 en vez de
5000 en todo el bucle. La mitad del trabajo de memoria solo sirve para
traducir. La próxima semana veremos cómo la TLB, una caché de traducciones,
elimina casi todos esos accesos extra.
El costo en espacio
Calculemos el tamaño de una tabla de páginas lineal (un arreglo con una PTE por página virtual). Esta es la pregunta de repaso 1: direcciones de 32 bits, páginas de 4 KB y PTEs de 4 bytes.
- Offset: 4 KB = 2^12 bytes, así que 12 bits.
- VPN: 32 − 12 = 20 bits, así que 2^20 PTEs (más o menos un millón).
- Tamaño: 2^20 × 4 bytes = 2^22 bytes = 4 MB por proceso.
Con 100 procesos, 400 MB solo en tablas de páginas, y casi todas sus PTEs son inválidas, porque un proceso típico usa una fracción mínima de sus 4 GB de espacio de direcciones. En 64 bits la situación es absurda:
| Espacio de direcciones | Página | PTE | Tamaño de la tabla lineal |
|---|---|---|---|
| 32 bits | 4 KB | 4 B | 2^20 × 4 = 4 MB |
| 39 bits (Sv39, xv6) | 4 KB | 8 B | 2^27 × 8 = 1 GB |
| 48 bits (x86-64) | 4 KB | 8 B | 2^36 × 8 = 512 GB |
| 64 bits completos | 4 KB | 8 B | 2^52 × 8 = 32 PB |
Verifíquenlo con ptsize.c:
$ ./ptsize 32 4096 4
offset: 12 bits, VPN: 20 bits
entradas: 2^20
tabla:    2^20 x 4 bytes = 2^22 bytes = 4 MiB por proceso
Por eso ningún sistema real usa tablas lineales en 64 bits: usan tablas multinivel, en las que solo existen las partes de la tabla que corresponden a regiones en uso. Es el tema de la semana 7 y del proyecto P3.
¿Qué fragmentación tiene la paginación?
Pregunta de repaso 3. La paginación no tiene fragmentación externa: todo marco libre sirve para cualquier página, así que nunca hay un hueco “demasiado chico”. Sí tiene fragmentación interna: la memoria se entrega por páginas enteras. Un heap de 4097 bytes ocupa dos páginas de 4096 y desperdicia 4095 bytes de la segunda. En promedio se pierde media página por región (código, heap, pila…). A eso se suma el espacio de las propias tablas de páginas.
La segmentación es lo opuesto: cada segmento mide exactamente lo que necesita (sin fragmentación interna), pero los huecos entre segmentos producen fragmentación externa.
Paginación en xv6-riscv: Sv39
xv6 usa el modo Sv39 de RISC-V. Las direcciones virtuales tienen 39 bits, las páginas miden 4 KB y la tabla de páginas tiene tres niveles. Cada nivel es una página con 512 PTEs de 8 bytes (512 × 8 = 4096). Una dirección se parte así:
| Bits | 38–30 | 29–21 | 20–12 | 11–0 |
|---|---|---|---|---|
| Campo | índice nivel 2 | índice nivel 1 | índice nivel 0 | offset |
9 + 9 + 9 + 12 = 39. Los tres índices de 9 bits juntos son el VPN; cada uno elige una de las 512 entradas de un nivel. Esta semana nos quedamos con el formato; la caminata por los tres niveles la estudiamos la semana que viene.
En xv6. Las macros de paginación están en
kernel/riscv.h:#define PTE_V (1L << 0) // valid #define PTE_R (1L << 1) #define PTE_W (1L << 2) #define PTE_X (1L << 3) #define PTE_U (1L << 4) // user can access #define PA2PTE(pa) ((((uint64)pa) >> 12) << 10) #define PTE2PA(pte) (((pte) >> 10) << 12) #define PX(level, va) ((((uint64)(va)) >> PXSHIFT(level)) & PXMASK)
PX(level, va)extrae el índice de 9 bits del nivel pedido.walk()enkernel/vm.clo usa para bajar del nivel 2 al 0, ymappages()arma cada PTE de hoja con*pte = PA2PTE(pa) | perm | PTE_V;.
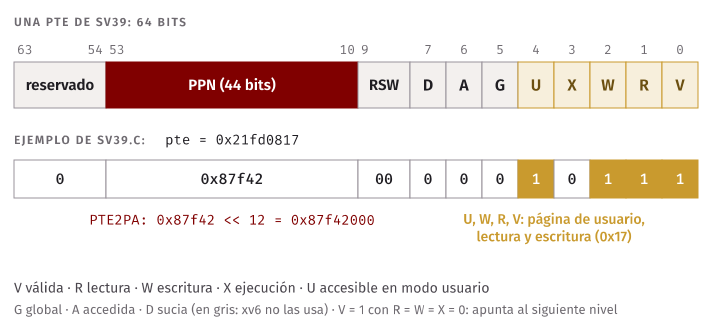
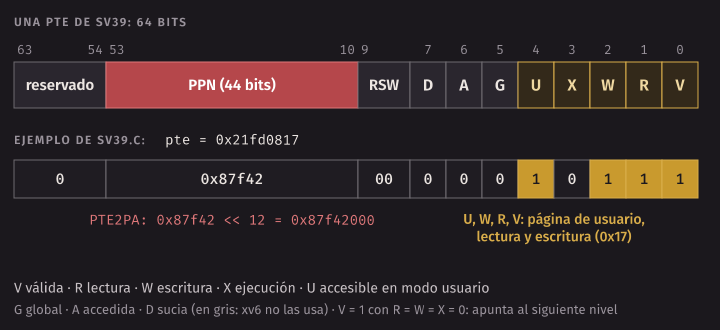
Una PTE de Sv39 mide 64 bits: los 10 bits más altos están reservados, los bits 53–10 son el número de página física (PPN, 44 bits), los bits 9–8 quedan libres para el software y los 8 bits bajos son flags: D (sucio), A (referencia), G (global), U, X, W, R y V. Algunas observaciones:
- RISC-V no tiene un bit presente separado del bit válido: V cumple los dos papeles.
- Si V = 1 y R = W = X = 0, la PTE no es una hoja: apunta al siguiente nivel
de la tabla.
walk()cuenta con eso: las PTEs de los niveles 2 y 1 se crean con soloPTE_V. - Los bits A y D existen en el hardware, pero
riscv.hno los define: xv6 no hace swap y no los necesita.
El programa sv39.c copia esas macros fuera del
kernel para verlas con números:
$ ./sv39
0x1234      PX(2,1,0) =   0   0   1  offset 0x234
0x40201abc  PX(2,1,0) =   1   1   1  offset 0xabc
TRAMPOLINE  PX(2,1,0) = 255 511 511  offset 0x000
TRAMPOLINE = 0x3ffffff000, MAXVA = 0x4000000000

pa          = 0x87f42000
PA2PTE(pa)  = 0x21fd0800
pte         = 0x21fd0817  U-WRV
PTE_FLAGS   = 0x017
PTE2PA(pte) = 0x87f42000
PA2PTE hace >> 12 para quitar el offset (queda el PPN 0x87f42) y luego
<< 10 para dejarlo por encima de los 10 bits de flags. Con | 0x17 se agregan
U, W, R y V. PTE2PA hace el camino inverso. Un detalle: PX(2) de
TRAMPOLINE da 255 y no 511. xv6 define MAXVA como 2^38, un bit menos que lo
que permite Sv39, para no lidiar con la extensión de signo de las direcciones
que tienen el bit 38 en 1.
Resumen
- Un asignador de tamaño variable mantiene una lista libre cuyos nodos viven dentro de los propios huecos. Divide los trozos al asignar y los fusiona al liberar; para fusionar conviene mantener la lista ordenada por dirección.
mallocguarda un encabezado antes de cada bloque con su tamaño y un número mágico; por esofreeno necesita el tamaño.- Best, worst, first y next fit: ninguna gana siempre. Listas segregadas y slab
atienden tamaños frecuentes en O(1); buddy fusiona rápido (
a XOR s) a cambio de fragmentación interna.kallocde xv6 es una lista de páginas de 4096 bytes, sin división ni fusión. - La paginación parte la memoria en páginas y marcos del mismo tamaño. La dirección virtual es VPN | offset; la tabla de páginas da el PFN; la física es PFN | offset. No tiene fragmentación externa, sí interna.
- Una tabla lineal cuesta 4 MB por proceso en 32 bits (imposible en 64 bits) y duplica los accesos a memoria. La TLB y las tablas multinivel (semana 7) resuelven esos dos problemas.
- En Sv39, una PTE de 64 bits lleva el PPN y los flags V, R, W, X, U; xv6 las
manipula con
PA2PTE,PTE2PA,PTE_FLAGSyPXdekernel/riscv.h.
Ejercicios
- Con
heapdemocomo guía, dibujen la arena de 512 bytes después dea = malloc(40); b = malloc(40); free(a); c = malloc(16);. ¿En qué desplazamiento quedac? ¿Cuántos trozos libres hay? Verifíquenlo agregando esas llamadas aheapdemo.c. - Modifiquen
mm_mallocpara que use best fit en lugar de first fit. Agreguen aheaptest.cuna prueba en la que best fit y first fit devuelvan bloques distintos. - Encuentren una lista de huecos y una secuencia de peticiones en la que
worst fit satisfaga todas las peticiones y best fit falle. Compruébenlo
con
./fits. - En un buddy allocator con una arena de 128 KB, se piden en orden 20 KB,
10 KB y 40 KB. Dibujen las divisiones, indiquen la fragmentación interna
total y luego liberen los tres bloques mostrando cada fusión con la regla
a XOR s. - Direcciones virtuales de 16 bits, páginas de 256 bytes y PTEs de 2 bytes.
¿Cuántos bits tiene el offset y cuántos el VPN? ¿Cuánto mide la tabla
lineal? Con la tabla VPN 0x12 → PFN 0x05 y VPN 0x34 → PFN 0x1f, traduzcan a
mano
0x12a7,0x34ffy0x3400. - Con páginas de 16 KB en vez de 4 KB y direcciones de 32 bits y PTEs de 4
bytes, ¿cuánto mide la tabla lineal? ¿Qué se gana y qué se pierde con
páginas más grandes? Usen
./ptsizepara verificar. - Calculen a mano
PX(2, va),PX(1, va),PX(0, va)y el offset parava = 0x80001234y verifiquen modificandosv39.c. Luego construyan la PTE de una página de usuario de solo lectura y ejecutable en la dirección física0x80123000.