
Apuntes · Capítulo 7Memoria
TLB y tablas de páginas avanzadas
TLB y tablas de páginas avanzadas
La semana pasada vimos la paginación: una tabla de páginas (page table) dice en qué marco de página (page frame) está cada página virtual. Tiene dos defectos. Uno de tiempo: cada acceso del programa necesita otro acceso para leer la entrada de la tabla (PTE). Otro de espacio: con direcciones de 32 bits y páginas de 4 KB, la tabla lineal de un proceso ocupa 4 MB, casi toda de entradas inválidas.
Para el tiempo, el hardware agrega una caché de traducciones: la TLB. Para el espacio, la solución que usan casi todos los procesadores actuales es la tabla multinivel (multi-level page table). Terminamos con el esquema Sv39 de xv6-riscv.
Ruta de lectura.
- Antes de clase (15–20 min): «El algoritmo de control» y «Ejemplo: recorrer un arreglo», de «La TLB: una caché de traducciones», y la primera parte de «Tablas más pequeñas» (hasta «Páginas más grandes»).
- En clase: sesión A, «La TLB: una caché de traducciones», «¿Quién atiende un fallo de TLB?» y «Una entrada de TLB y el cambio de contexto»; sesión B, «Tablas más pequeñas» y «En xv6: Sv39»; laboratorio, «Medir la TLB de su computadora».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 19 y 20, «Una entrada real: MIPS R4000», «Tablas invertidas» y «Superpages: adelanto de P3».
Lectura. Este capítulo acompaña a OSTEP cap. 19 Paging: Faster Translations (TLBs) y cap. 20 Paging: Smaller Tables. El código está en
code/week-07y se compila conmakedentro del contenedor del curso.
La TLB: una caché de traducciones
Con paginación lineal, la MMU lee la PTE en PTBR + VPN × tamaño(PTE) antes
de cada acceso. Como también hay que buscar cada instrucción, un programa
correría a la mitad de velocidad. La solución es la de siempre: una caché. La
TLB (translation lookaside buffer) es una memoria pequeña dentro de la MMU
que guarda traducciones recientes VPN → PFN. Tiene desde decenas hasta unos
pocos miles de entradas y se busca en todas a la vez (es totalmente
asociativa), así que responde en un ciclo o poco más.
El algoritmo de control
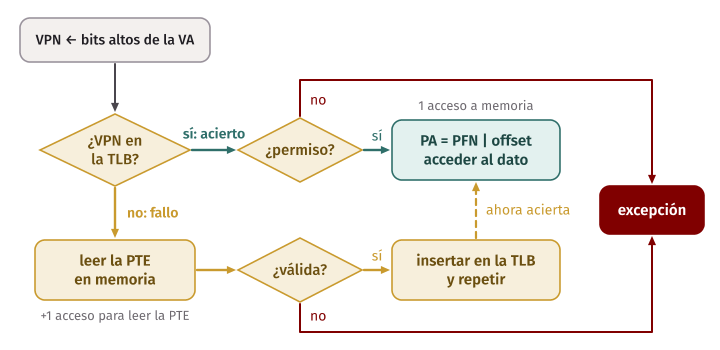
Con TLB, la MMU hace esto en cada acceso:
vpn = (va & VPN_MASK) >> SHIFT;
(hit, e) = tlb_lookup(vpn);
if (hit) {                         // acierto (TLB hit)
    check(e.prot);                 // o PROTECTION_FAULT
    pa = (e.pfn << SHIFT) | (va & OFFSET_MASK);
    access(pa);
} else {                           // fallo (TLB miss)
    pte = read_memory(PTBR + vpn * PTE_SIZE);   // acceso extra
    if (!pte.valid)
        raise(SEGFAULT);
    check(pte.prot);
    tlb_insert(vpn, pte.pfn, pte.prot);
    retry_instruction();
}
En un acierto (TLB hit) la traducción sale de la TLB y el único acceso a memoria es el del dato. En un fallo de TLB (TLB miss) se lee la PTE, se guarda la traducción en la TLB y se repite la instrucción, que esta vez acierta. La TLB funciona si los fallos son raros, como cualquier caché.
Ejemplo: recorrer un arreglo
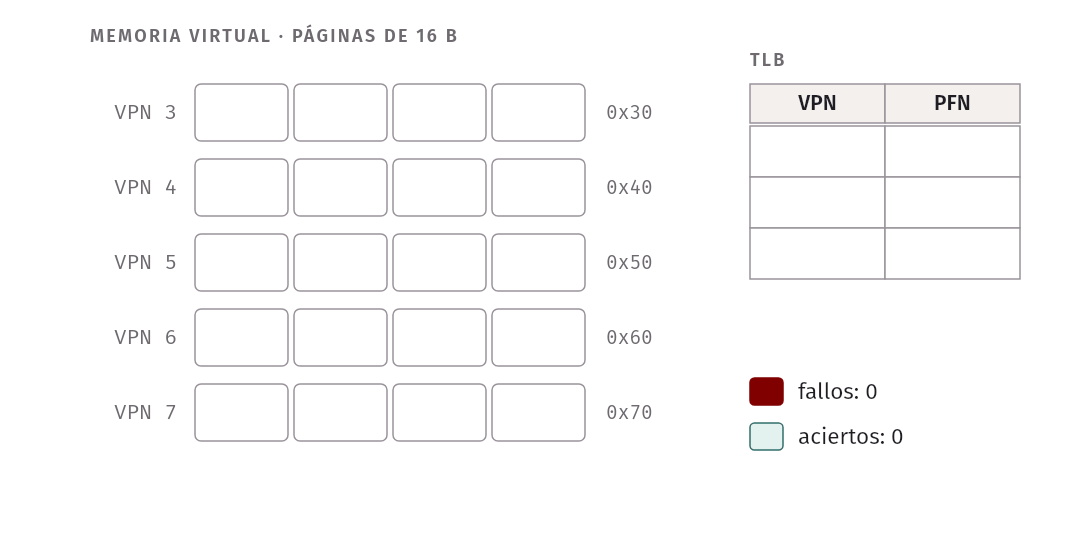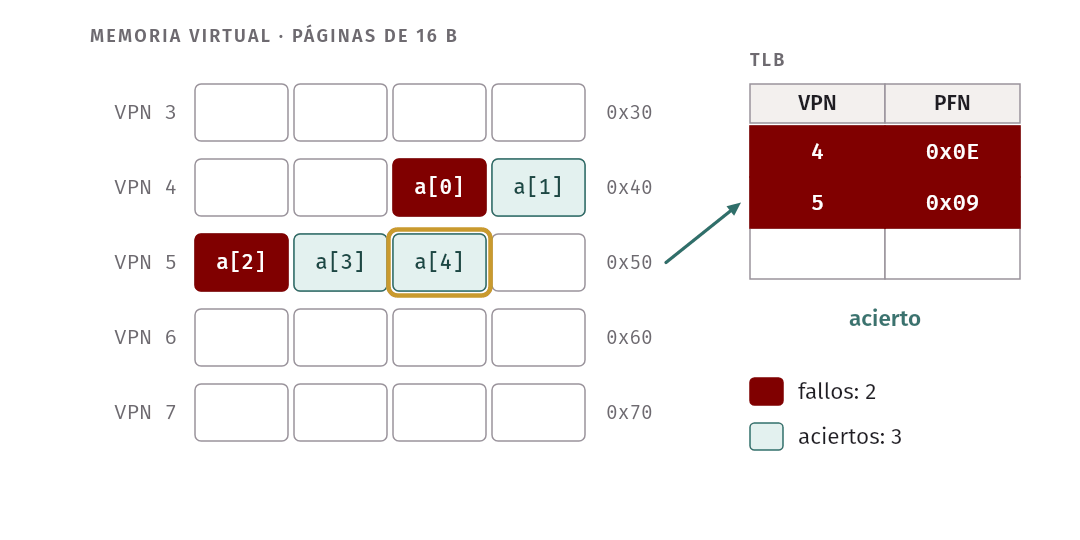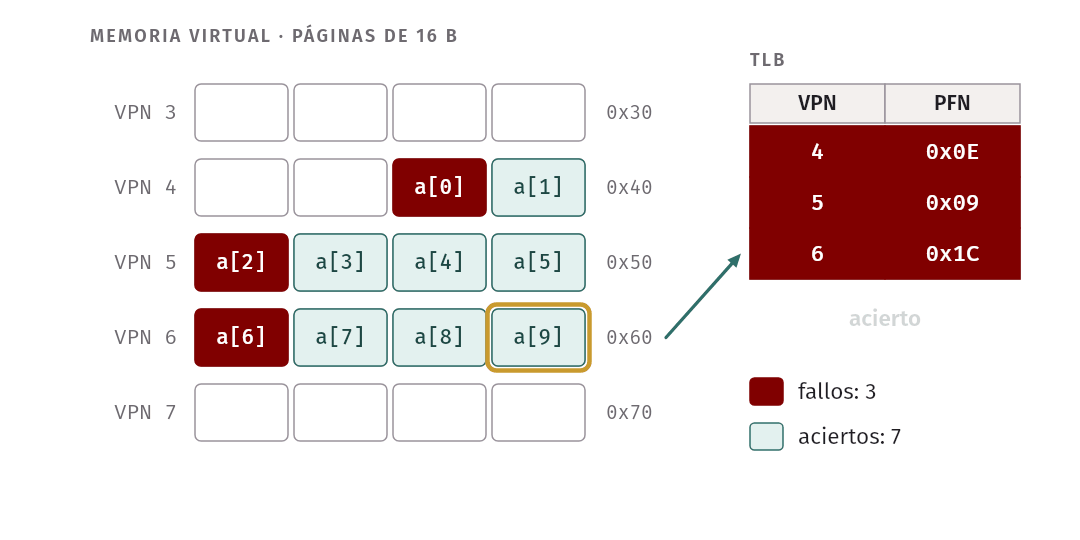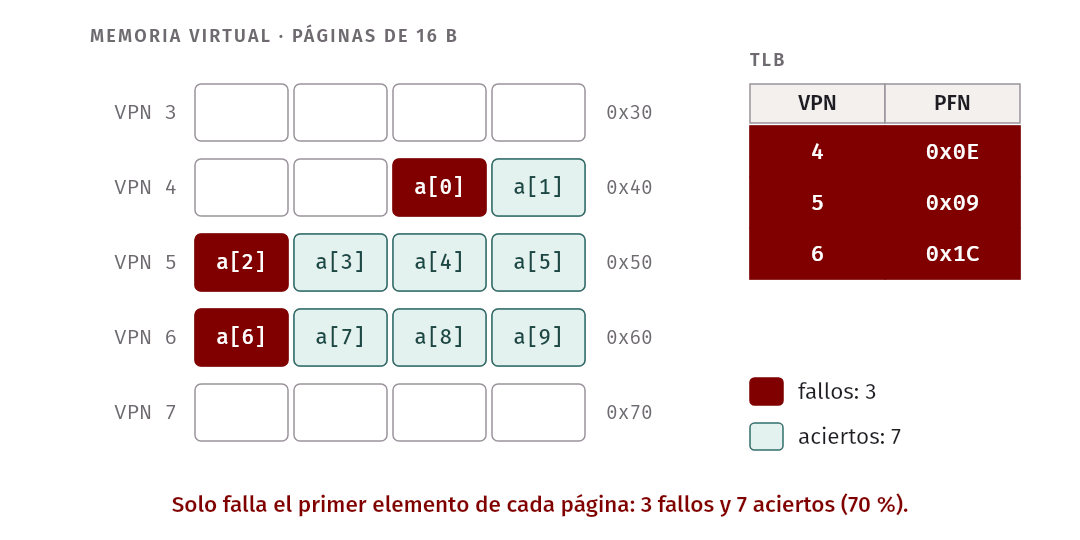
Supongamos un espacio de direcciones diminuto de 8 bits con páginas de 16
bytes: 4 bits de VPN y 4 de offset. Un arreglo int a[10] (enteros de 4
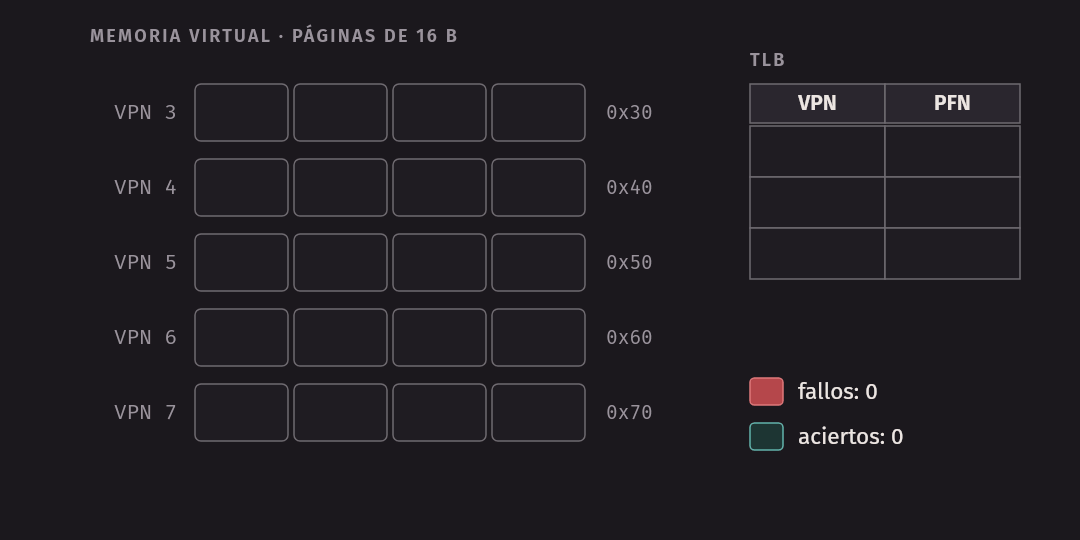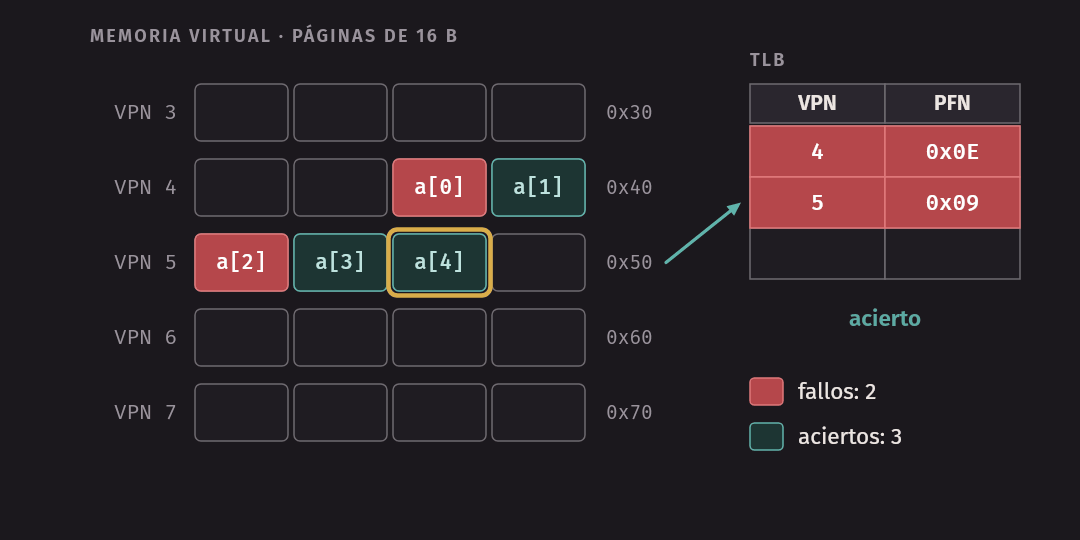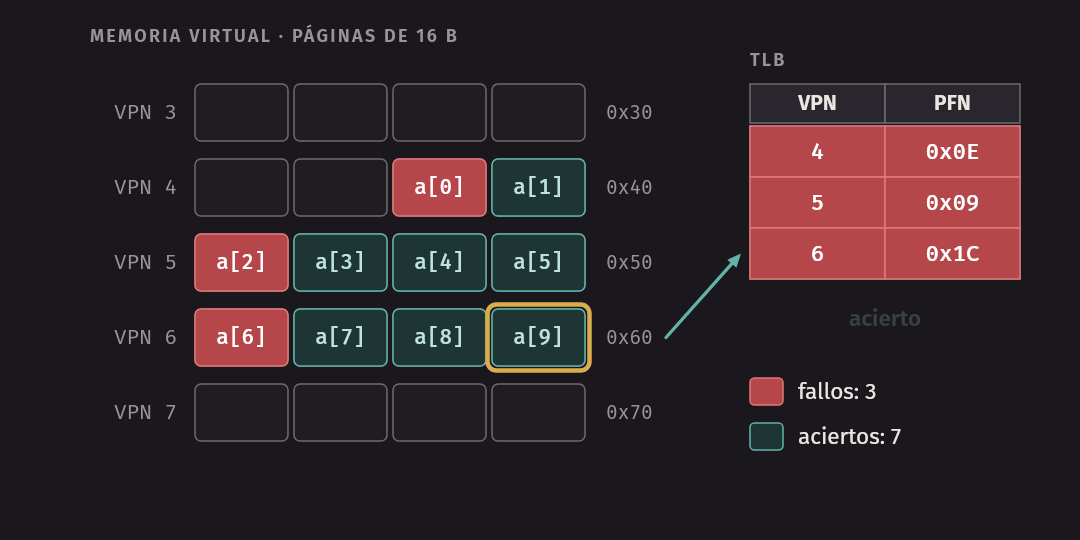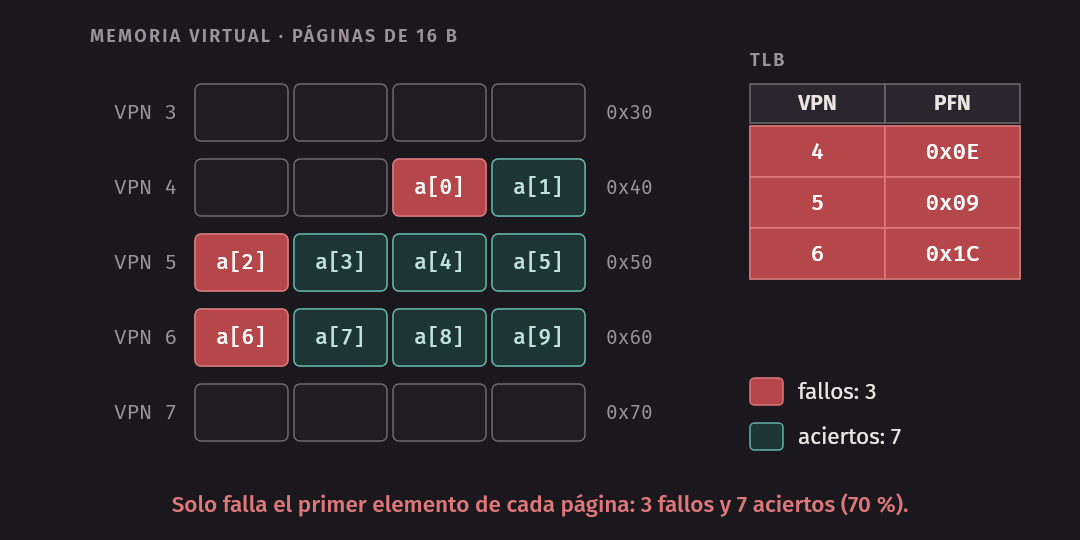
bytes) empieza en 0x48: a[0] y a[1] están en la VPN 4, a[2] a a[5]
en la VPN 5 y a[6] a a[9] en la VPN 6.
El bucle for (i = 0; i < 10; i++) sum += a[i]; empieza con la TLB vacía (y,
para simplificar, solo contamos los accesos al arreglo):
| Acceso | VPN | Resultado |
|---|---|---|
a[0] |
4 | fallo: se carga VPN 4 |
a[1] |
4 | acierto |
a[2] |
5 | fallo: se carga VPN 5 |
a[3], a[4], a[5] |
5 | aciertos |
a[6] |
6 | fallo: se carga VPN 6 |
a[7], a[8], a[9] |
6 | aciertos |
Resultado: 3 fallos y 7 aciertos, una tasa de aciertos del 70 %. Solo se falla con el primer elemento de cada página: el arreglo cruza tres páginas. Si el programa vuelve a recorrer el arreglo y la TLB todavía tiene las tres entradas, la segunda pasada tiene 10 aciertos de 10.
Localidad
- Localidad espacial: si se usa una dirección, pronto se usarán las cercanas. Los elementos del arreglo comparten página y entrada de la TLB.
- Localidad temporal: si se usa una dirección, pronto se volverá a usar. Por eso la segunda pasada acierta siempre.
El tamaño de página importa: con páginas de 32 bytes, el mismo arreglo cruza solo las páginas 2 y 3 (80 % de aciertos); con páginas de 4 KB, una sola (90 %). Y las instrucciones de un bucle suelen estar en una o dos páginas.
¿Cuánto se gana?
Supongamos que buscar en la TLB no cuesta casi nada y que un acceso a memoria cuesta 100 ns. Un acierto cuesta 100 ns (solo el dato); un fallo con tabla lineal cuesta 200 ns (PTE más dato). Con una tasa de aciertos h, el tiempo efectivo de acceso es:
T = h × 100 + (1 − h) × 200Sin TLB, 200 ns; con h = 90 %, 110 ns; con h = 99 %, 101 ns: la paginación cuesta casi lo mismo que no tenerla.
Idea clave. La TLB no cambia qué traducción se hace, solo dónde se encuentra. La tabla de páginas sigue siendo la verdad; la TLB es una copia rápida de las entradas que se usan ahora.
¿Quién atiende un fallo de TLB?
Hay dos diseños.
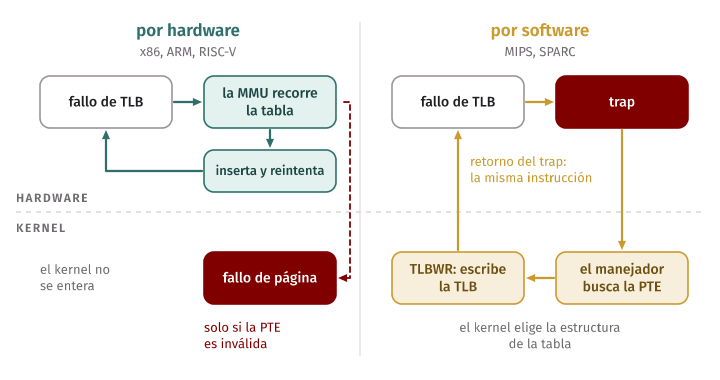
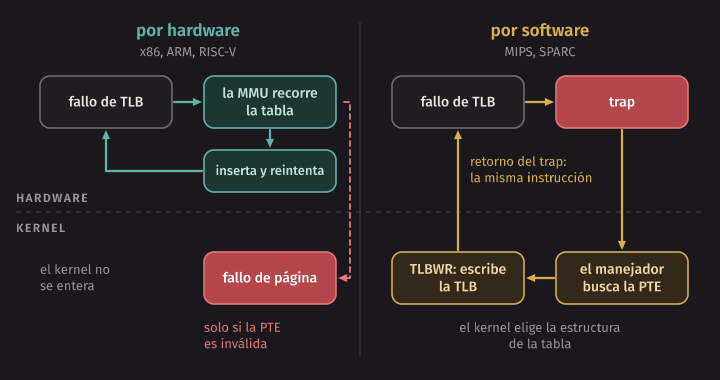
TLB manejada por hardware (hardware-managed). El hardware conoce el
formato exacto de la tabla de páginas y dónde está: el registro CR3 en x86,
satp en RISC-V. En un fallo, la MMU recorre la tabla sola (page walk),
inserta la entrada y reintenta. El kernel solo se entera si la PTE es
inválida (fallo de página, page fault). Así funcionan x86, ARM y RISC-V.
TLB manejada por software (software-managed). El hardware solo levanta una excepción. El kernel busca la PTE en la estructura que él quiera, escribe la entrada en la TLB con instrucciones privilegiadas y retorna del trap. Así funcionaban MIPS y SPARC. La ventaja es la flexibilidad: el hardware no impone el formato de la tabla. Hay dos detalles delicados:
- El retorno del trap es distinto. Tras una llamada al sistema se sigue con la instrucción siguiente; tras un fallo de TLB se repite la misma. El hardware debe guardar el PC adecuado según la causa.
- Fallos en cadena. Si el manejador también falla en la TLB, se llamaría a sí mismo sin fin. Se evita poniéndolo en memoria que no se traduce, o en entradas fijas (wired) de la TLB que nunca se reemplazan.
Una entrada de TLB y el cambio de contexto
Una entrada de TLB tiene el VPN (la etiqueta que se busca), el PFN, bits copiados de la PTE (protección, sucio) y un bit válido que significa “esta entrada contiene una traducción”, no “la página está asignada”.
El problema del cambio de contexto
La TLB guarda traducciones de un espacio de direcciones. Si el proceso P1
tiene la VPN 10 en el marco 100 y P2 tiene su VPN 10 en el marco 170, ¿qué
pasa cuando el planificador cambia de P1 a P2? Si la TLB conserva la entrada
10 → 100, P2 leería la memoria de P1. Hay dos soluciones:
- Vaciar la TLB (flush) en cada cambio de contexto: poner todos los bits válidos en 0. Es simple, pero el proceso que entra empieza con puros fallos.
- ASID (address space identifier): cada entrada lleva un identificador del espacio de direcciones al que pertenece. El kernel escribe el ASID del proceso actual en un registro privilegiado, y la TLB solo acierta si el ASID de la entrada coincide. Así las entradas de varios procesos conviven:
| VPN | PFN | válido | ASID |
|---|---|---|---|
| 10 | 100 | 1 | 1 |
| 10 | 170 | 1 | 2 |
| 50 | 101 | 1 | 1 |
| 50 | 101 | 1 | 2 |
Las dos últimas filas muestran que dos procesos pueden mapear el mismo marco (una biblioteca compartida, por ejemplo). Los ASID son pocos (8 bits en MIPS, 16 en RISC-V): con más procesos, el kernel los recicla.
Política de reemplazo
Cuando la TLB está llena y llega una traducción nueva, hay que sacar una. Las dos políticas típicas son LRU (least recently used: sacar la que lleva más tiempo sin usarse) y aleatoria. LRU aprovecha la localidad, pero tiene un caso patológico: con una TLB de n entradas y un bucle que recorre n + 1 páginas, LRU siempre saca justo la página que se va a necesitar y falla en todos los accesos. La aleatoria no tiene ese problema y es más simple. Volveremos a estas políticas en la semana 8.
Una entrada real: MIPS R4000
El MIPS R4000 tiene TLB por software y direcciones de 32 bits con páginas de 4 KB. Una entrada (simplificada) ocupa 64 bits:
| Campo | Bits | Para qué |
|---|---|---|
| VPN | 19 | La mitad alta del espacio es del kernel: basta con 19 bits, no 20 |
| G (global) | 1 | La entrada vale para todos los procesos; se ignora el ASID |
| ASID | 8 | A qué espacio de direcciones pertenece |
| PFN | 24 | Hasta 2^24 marcos de 4 KB: 64 GB de memoria física |
| C | 3 | Cómo cachea el hardware esa página |
| D | 1 | Sucia: la página fue escrita |
| V | 1 | La entrada tiene una traducción válida |
El kernel maneja la TLB con instrucciones privilegiadas: TLBP (buscar),
TLBR (leer), TLBWI (escribir una entrada dada) y TLBWR (escribir una al
azar). El registro wired dice cuántas entradas reserva para sí, justo para
evitar los fallos en cadena del manejador.
En xv6. RISC-V tiene TLB por hardware, y el registro
satptiene un campo ASID de 16 bits. Pero xv6 no lo usa:MAKE_SATPenkernel/riscv.hdeja el ASID en 0. Por esokernel/trampoline.Sejecutasfence.vma zero, zeroalrededor de cadacsrw satp, al entrar al kernel desde modo usuario (enuservec) y al volver (enuserret): vacía la TLB en cada trap de usuario, no solo en cada cambio de contexto.
Medir la TLB de su computadora
¿Cuánto cuesta de verdad un fallo de TLB? La tarea de código del cap. 19 de
OSTEP propone medirlo: recorrer N páginas una y otra vez y medir el tiempo
promedio por acceso. Mientras las N páginas quepan en la TLB, todo acierta;
cuando N supera lo que cubre la TLB, el tiempo sube. El programa
tlb.c hace eso:
char *buf = mmap(...);              // N páginas, alineadas a 2 MB
madvise(buf, len, MADV_NOHUGEPAGE); // páginas de 4 KB de verdad
memset(buf, 1, len);                // tocar todas antes de medir
// cada página guarda dónde está la siguiente
for (long i = 0; i < pages; i++)
    *(long *)(buf + slot(i, pgsz)) = slot((i + 1) % pages, pgsz);

double t0 = now_ns();               // clock_gettime(CLOCK_MONOTONIC)
for (long t = 0; t < trials; t++)
    for (long i = 0; i < pages; i++)
        cur = *(volatile long *)(buf + cur);
ns = (now_ns() - t0) / (trials * pages);- Fijar la CPU con
sched_setaffinity: cada núcleo tiene su propia TLB. - Tocar las páginas antes de medir, para dejar fuera del tiempo los fallos de página.
- Pedir páginas de 4 KB. El Linux del contenedor tiene transparent huge
pages (THP) activado y podría usar páginas de 2 MB sin que el programa lo
pida.
MADV_NOHUGEPAGElo evita, y el programa imprime cuántos KB quedaron en páginas grandes (leyendo/proc/self/smaps) para comprobarlo. - Accesos dependientes (pointer chasing): cada página guarda la posición de la siguiente, así que cada lectura espera a la anterior. Con lecturas independientes, el procesador ejecuta varias a la vez y esconde los fallos: una versión así midió entre 0.35 y 6 ns en esta misma máquina.
volatile, para que el compilador no borre el bucle, y el mínimo de 5 repeticiones, para filtrar interrupciones.
El script run-tlb.sh (o make bench) ejecuta
el programa para 1, 2, 4, … 32768 páginas, con páginas de 4 KB y pidiendo
páginas grandes (./tlb N intentos huge). La última columna dice cuántos KB
quedaron de verdad en páginas grandes: una región de menos de 2 MB no puede
usarlas. Esto se midió en el contenedor del curso (filas seleccionadas):
páginas    memoria   ns 4KB   ns THP  KB en THP
      2       8 KB     1.41     1.40          0
    128     512 KB     1.40     1.40          0
    256    1024 KB     3.52     3.52          0
    512    2048 KB     9.95     6.80       2048
   1024    4096 KB    12.41    10.07       4096
   2048    8192 KB    12.64    10.02       8192
   4096   16384 KB    43.84    10.03      16384
   8192   32768 KB    43.39    10.29      32768
  16384   65536 KB    42.68    18.37      65536
  32768  131072 KB    43.07    38.75     131072
Con páginas de 4 KB hay escalones en 1.4 ns (hasta 128 páginas), 10–12 ns (de 512 a 2048) y unos 43 ns desde 4096 páginas (16 MB), treinta veces un acierto. Comparar las dos columnas permite separar causas, porque tocan los mismos datos y solo cambia el tamaño de página:
- El escalón de 10–12 ns aparece casi igual con THP, donde esa memoria son apenas 1 a 4 páginas grandes, que caben en cualquier TLB. Ese escalón no lo explica el tamaño de página: puede venir de las cachés o de la traducción de la máquina virtual. No se lo atribuyan a la TLB.
- El salto a 43 ns sí depende de la traducción: con THP, los mismos datos siguen en 10 ns hasta los 32 MB. Con 4 KB, cada acceso paga un recorrido de la tabla.
- En teoría, una entrada de 2 MB cubre 512 veces más memoria que una de 4 KB. Pero el salto con THP llegó solo 4 a 8 veces más tarde (a 64–128 MB). Con estos datos no podemos saber qué lo limita: quizá la TLB tiene menos entradas para páginas grandes, quizá la traducción del anfitrión usa páginas más pequeñas.
Hay que ser honestos con estos números. Se midieron en un contenedor Linux aarch64 dentro de la máquina virtual de Docker, sobre una Apple M4 Max: hay dos traducciones (la del invitado y la del anfitrión) y núcleos de dos tipos. Al repetir, los escalones aparecen en los mismos lugares, pero los valores cambian (en una corrida, 8192 páginas dio 67 ns). En su computadora los escalones estarán en otro lugar.
Tablas más pequeñas
Pasemos al segundo problema. Con VA de 32 bits, páginas de 4 KB y PTE de 4 bytes, el VPN tiene 20 bits y la tabla lineal tiene 2^20 entradas: 4 MB por proceso. Cien procesos gastan 400 MB solo en tablas. Con Sv39 (VA de 39 bits, PTE de 8 bytes) el VPN tiene 27 bits y la tabla lineal ocuparía 1 GB. Y casi todo eso son PTE inválidas: el hueco enorme entre el heap y la pila.
Páginas más grandes
Con páginas de 16 KB, el VPN tiene 18 bits y la tabla ocupa 1 MB; con páginas de 4 MB, 4 KB. El costo es la fragmentación interna: con páginas de 4 MB, cada región pequeña desperdicia megabytes. Por eso los sistemas reales usan páginas de 4 KB y, para regiones grandes, páginas grandes (superpages) de 2 MB o 1 GB. Estas ayudan más a la TLB que al tamaño de la tabla.
Híbrido: segmentación más paginación
Otra idea: una tabla de páginas por segmento (código, heap, pila). Los bits altos de la VA eligen el segmento; su registro base apunta a la tabla y su límite dice cuántas PTE tiene. El hueco entre heap y pila no ocupa nada. Pero un heap grande y disperso desperdicia igual, y las tablas son de tamaño variable: reaparece la fragmentación externa.
Tablas multinivel
La idea que se impuso es paginar la tabla de páginas. Se corta la tabla lineal en trozos del tamaño de una página. Si un trozo tiene solo PTE inválidas, simplemente no se reserva. Para saber qué trozos existen y dónde están, se agrega un directorio de páginas (page directory): una tabla con una entrada (PDE, page directory entry) por cada trozo, con un bit válido y el PFN de la página que guarda ese trozo.
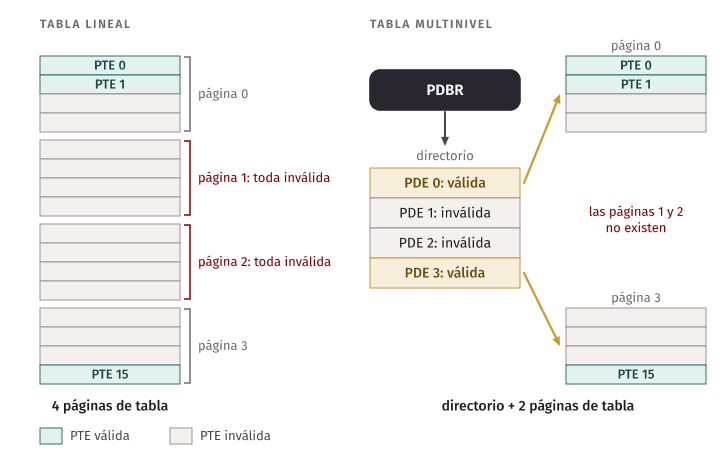
El ejemplo clásico es x86 de 32 bits. Una página de 4 KB guarda 4096/4 = 1024 = 2^10 PTE, así que el índice dentro de un trozo usa 10 bits. Los otros 10 bits del VPN eligen la PDE. La VA se parte en 10 + 10 + 12:
| Bits | 31–22 | 21–12 | 11–0 |
|---|---|---|---|
| Campo | índice del directorio (PDI) | índice de la tabla (PTI) | offset |
El directorio también ocupa exactamente una página, y el registro de la tabla
(el PDBR, CR3 en x86) apunta a él.
Ejemplo resuelto. Traduzcamos VA = 0x00403A7C con el directorio en
0x00123000:
- Partir la VA:
0x00403A7C=0000000001 0000000011 101001111100en binario, así que PDI = 1, PTI = 3 y offset =0xA7C. - Leer la PDE: dirección
0x00123000 + 1 × 4 = 0x00123004(acceso 1). Supongamos que es válida con PFN0x456: el trozo de tabla está en0x00456000. - Leer la PTE: dirección
0x00456000 + 3 × 4 = 0x0045600C(acceso 2). Supongamos que es válida con PFN0x0789A. - Armar la PA:
0x0789A << 12 | 0xA7C = 0x0789AA7Cy leer el dato (acceso 3).
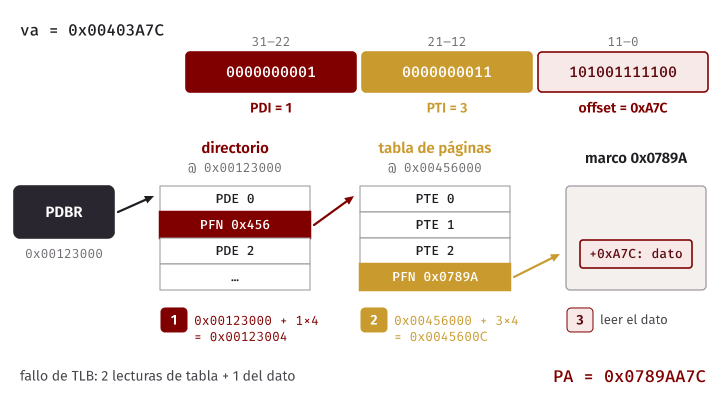
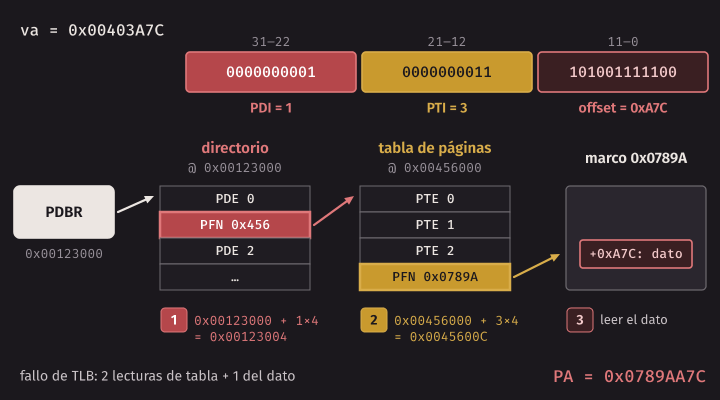
Con la VPN 0x00403 en la TLB, bastaría el acceso 3.
¿Cuánto se ahorra? Un proceso usa 3 páginas de código desde 0x00400000,
una de heap en 0x08000000 y una de pila en 0xBFFFF000. Sus PDI son 1,
0x20 y 0x2FF: el directorio más tres páginas de PTE suman 16 KB,
contra 4 MB de la lineal. La calculadora
ptcalc.c hace la cuenta:
$ ./ptcalc 32 4096 4 0x00400000 0x00401000 0x00402000 0x08000000 0xbffff000
...
niveles: 2   bits por índice: 10 10
tabla lineal: 2^20 PTE x 4 B = 4 MB
...
nivel 1: 1 página(s)
nivel 0: 3 página(s)
multinivel: 4 páginas x 4096 B = 16 KB
fallo de TLB: 2 accesos a la tabla + 1 al dato = 3 accesos a memoria
El ahorro depende de que el espacio sea disperso (sparse): si el proceso usara todas sus páginas, la multinivel ocuparía 4 MB + 4 KB, algo más que la lineal.
Además, cada trozo de la tabla es una página que el kernel saca de su lista de marcos libres: no hace falta encontrar 4 MB contiguos. El precio: un fallo de TLB cuesta ahora dos lecturas de tabla en vez de una. Es un ejemplo típico de intercambio tiempo/espacio (time-space trade-off): menos memoria a cambio de fallos más caros. Como la TLB acierta casi siempre, el precio casi no se nota.
Idea clave. Una tabla multinivel ocupa memoria en proporción a lo que el proceso usa, no al tamaño de su espacio de direcciones. Las PDE inválidas representan, cada una, 1024 PTE inválidas que no existen.
Más de dos niveles
La regla de diseño es que cada nodo de la tabla quepa en una página. Con Sv39, una página de 4 KB guarda 512 PTE de 8 bytes, así que cada nivel usa 9 bits. El VPN tiene 27 bits = 9 + 9 + 9: tres niveles. Con dos niveles, el directorio tendría 2^18 entradas (2 MB) y no cabría en una página. x86-64 usa direcciones de 48 bits partidas en 9 + 9 + 9 + 9 + 12: cuatro niveles (y los procesadores más nuevos admiten cinco).
¿Cuánto cuesta un fallo de TLB con tres niveles? Hay que leer una PTE en cada nivel y después el dato: 3 + 1 = 4 accesos a memoria, contra 1 en un acierto. Con 100 ns por acceso:
T = h × 100 + (1 − h) × 400Con h = 99 %, T = 103 ns (contra 101 con tabla lineal); con 90 %, 130 ns (contra 110). Además, el fallo suele costar menos de 4 accesos a la RAM: las cachés de datos guardan las PTE más usadas.
Tablas invertidas
Una idea distinta: una sola tabla para todo el sistema, con una entrada por marco físico que dice qué proceso y qué VPN lo usan. Su tamaño es proporcional a la memoria física. Para traducir se busca (PID, VPN) con una tabla hash, con cadenas para las colisiones; el índice de la entrada encontrada es el PFN. PowerPC usa este esquema. Compartir páginas es incómodo: cada marco tiene una sola entrada.
De todas estas ideas, la que usan x86-64, ARM64 y RISC-V (y xv6) es la tabla multinivel con TLB por hardware y algunas superpages.
En xv6: Sv39
xv6-riscv usa el esquema Sv39 de RISC-V: direcciones virtuales de 39 bits,
tres niveles de 9 bits y offset de 12. Los bits 39 a 63 deben ser copia del
bit 38; xv6 se simplifica la vida usando solo 38 bits (MAXVA en
kernel/riscv.h) para que siempre sean cero. Las macros que parten la VA
están en kernel/riscv.h:
// extract the three 9-bit page table indices from a virtual address.
#define PXMASK         0x1FF // 9 bits
#define PXSHIFT(level) (PGSHIFT + (9 * (level)))
#define PX(level, va)  ((((uint64)(va)) >> PXSHIFT(level)) & PXMASK)
PX(2, va) toma los bits 30–38, PX(1, va) los 21–29 y PX(0, va) los
12–20. Por ejemplo, va = 0x80604567 da L2 = 2, L1 = 3, L0 = 4 y offset
0x567 (./ptcalc 39 4096 8 0x80604567 lo confirma; en la semana 6,
sv39.c mostró estas mismas macros con otros
ejemplos).
La función walk() de kernel/vm.c hace en software el mismo recorrido que
la MMU hace en hardware. El kernel la usa para leer y modificar tablas de
páginas:
pte_t *
walk(pagetable_t pagetable, uint64 va, int alloc)
{
  if (va >= MAXVA)
    panic("walk");

  for (int level = 2; level > 0; level--) {
    pte_t *pte = &pagetable[PX(level, va)];
    if (*pte & PTE_V) {
      pagetable = (pagetable_t)PTE2PA(*pte);
    } else {
      if (!alloc || (pagetable = (pde_t *)kalloc()) == 0)
        return 0;
      memset(pagetable, 0, PGSIZE);
      *pte = PA2PTE(pagetable) | PTE_V;
    }
  }
  return &pagetable[PX(0, va)];
}
En los niveles 2 y 1, si la PTE es válida, baja a la página de tabla a la que
apunta. Si no lo es y alloc vale 1, pide una página con kalloc(), la llena
de ceros y la enlaza: así la tabla crece solo donde hace falta, exactamente
la idea de la tabla multinivel. Al final retorna la dirección de la PTE de
nivel 0; mappages() la usa para escribir el PFN y los permisos.
Para 0x80604567, el recorrido lee la entrada 2 de la raíz, la 3 del nivel 1
y la 4 del nivel 0: 3 lecturas de tabla y 1 del dato.
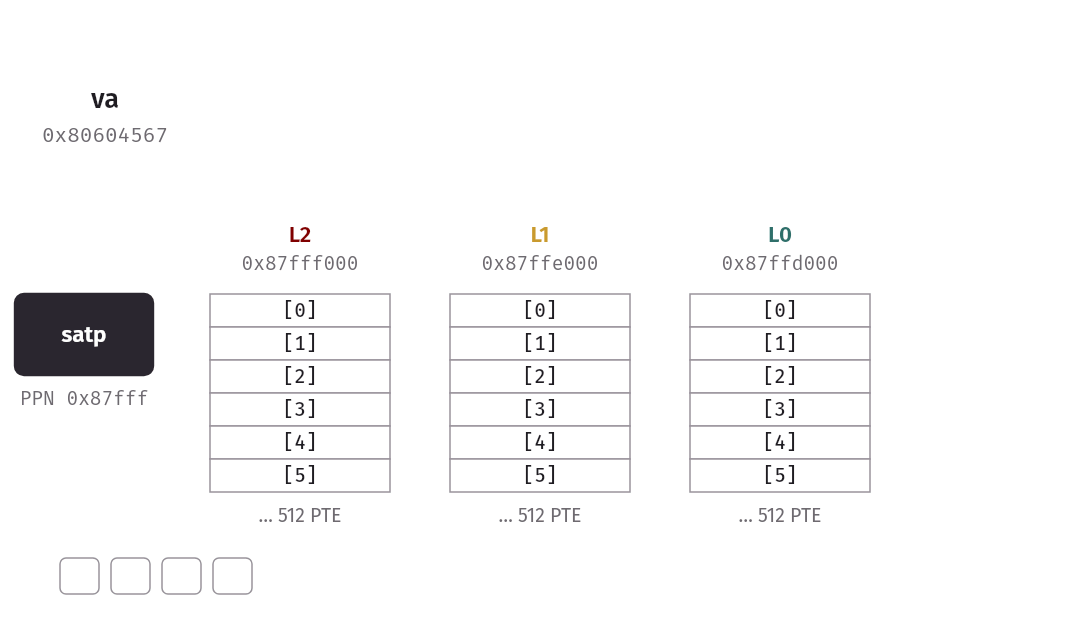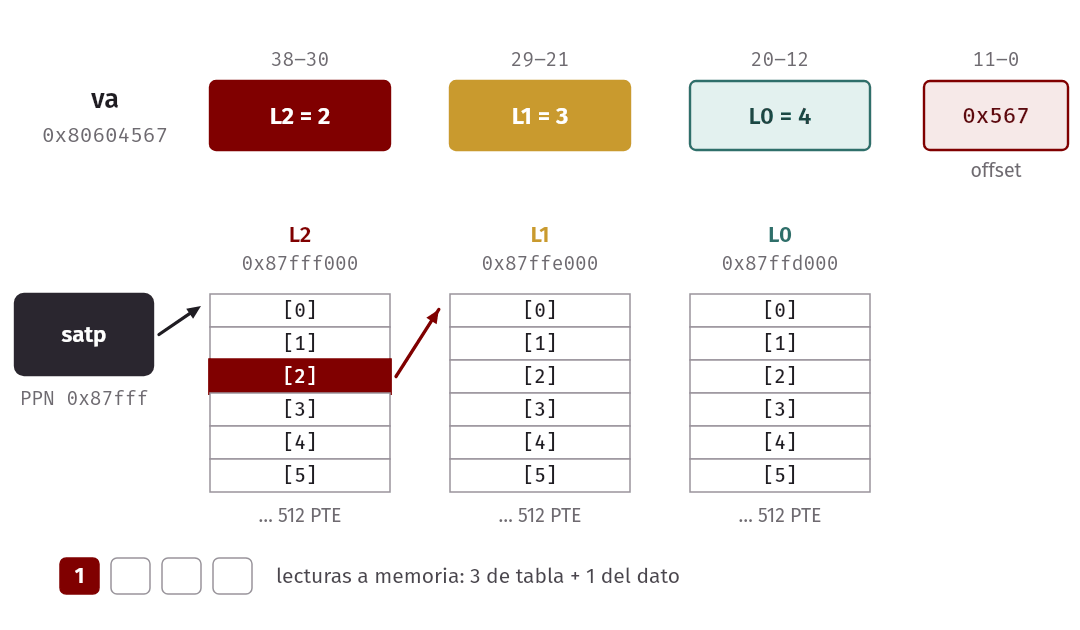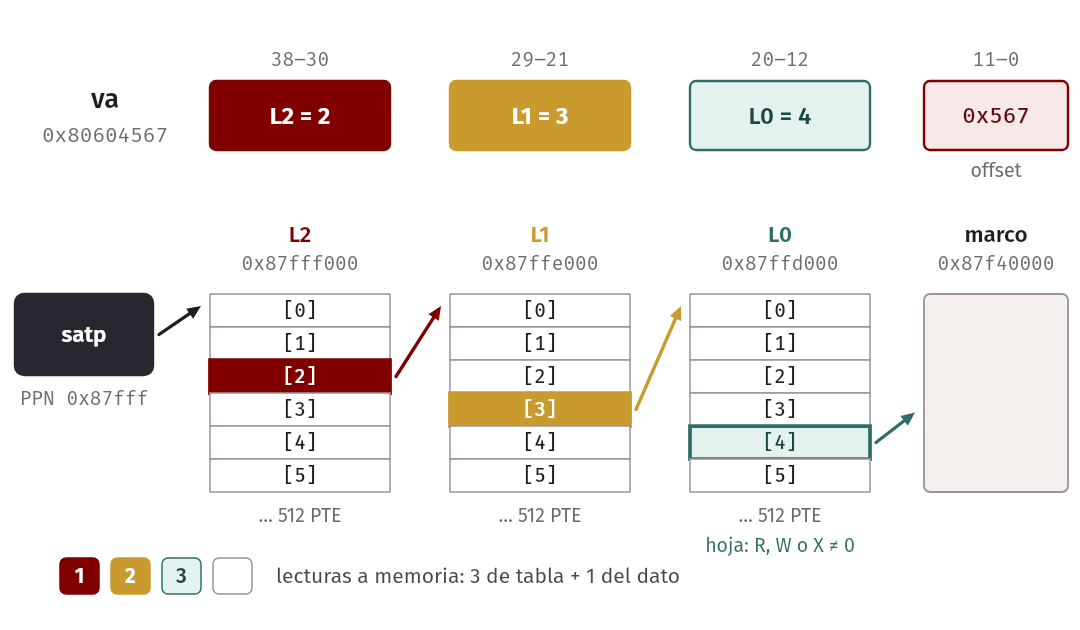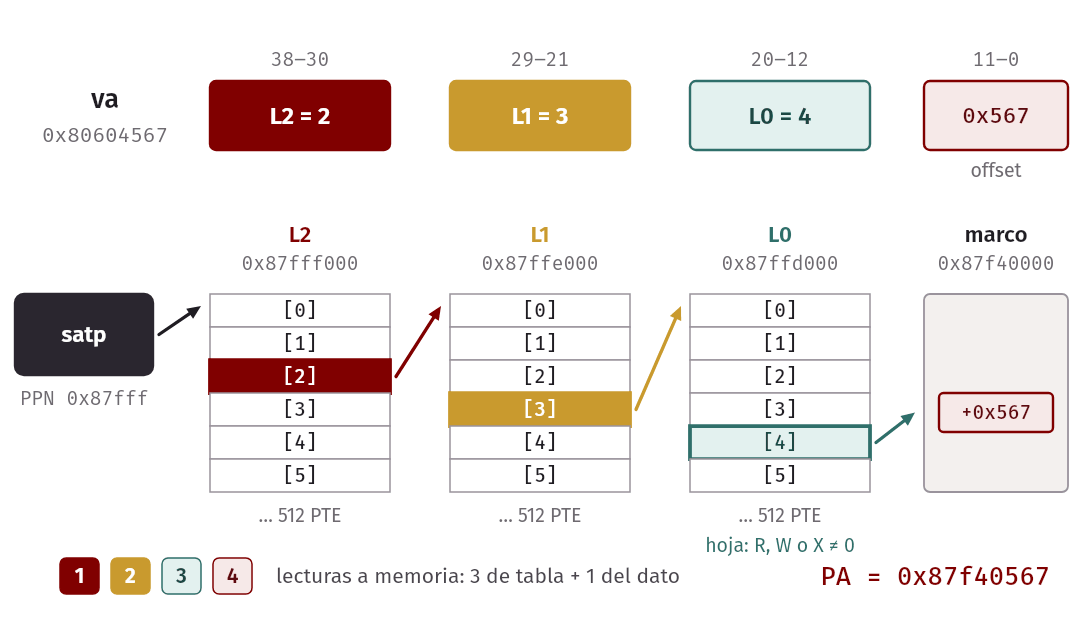
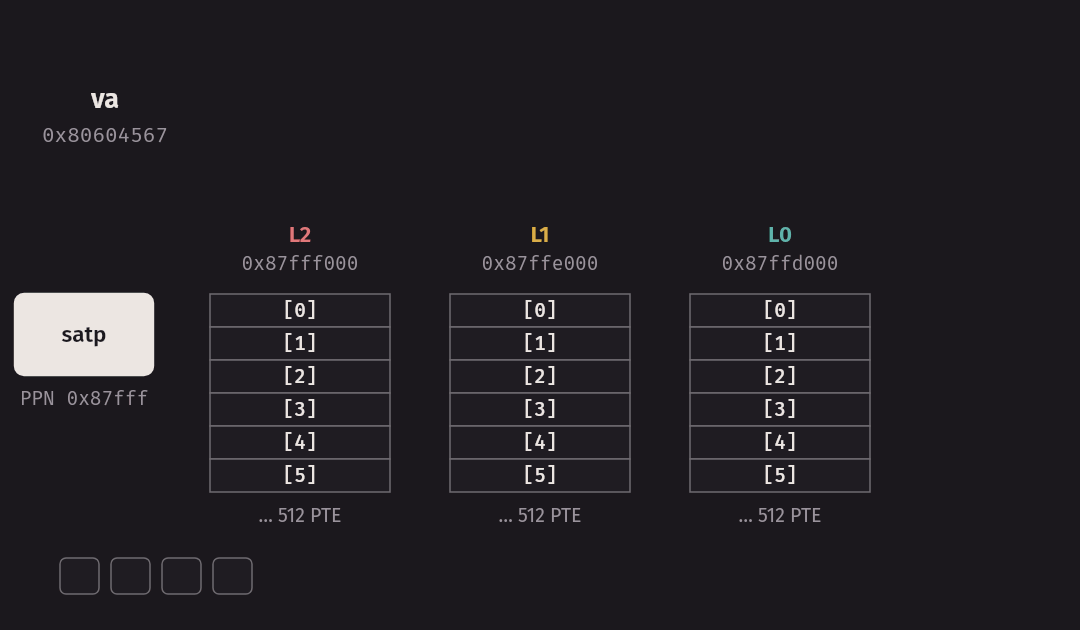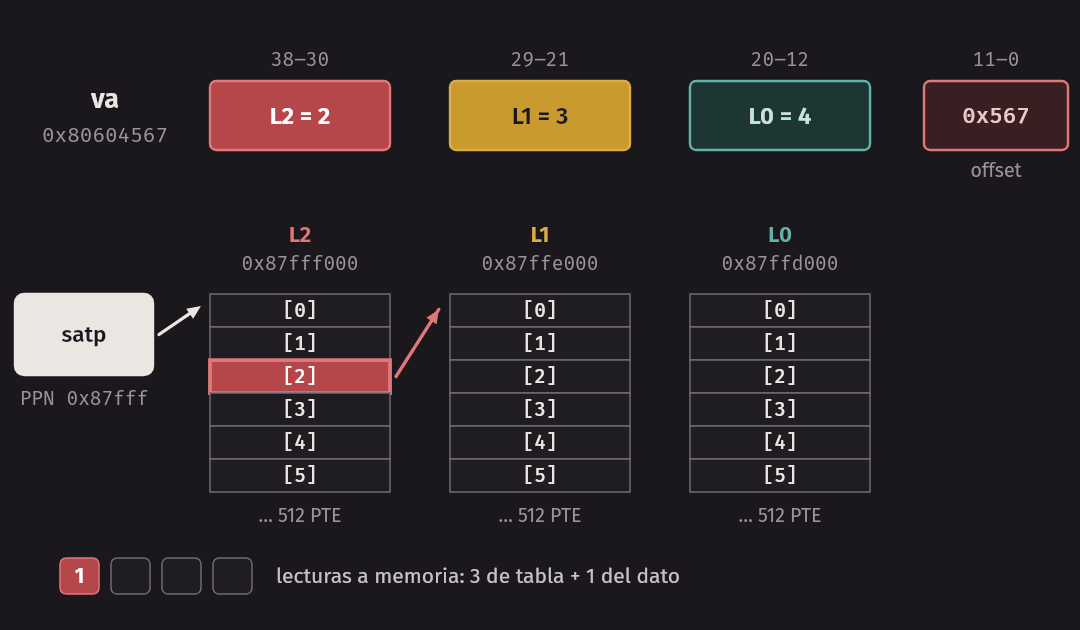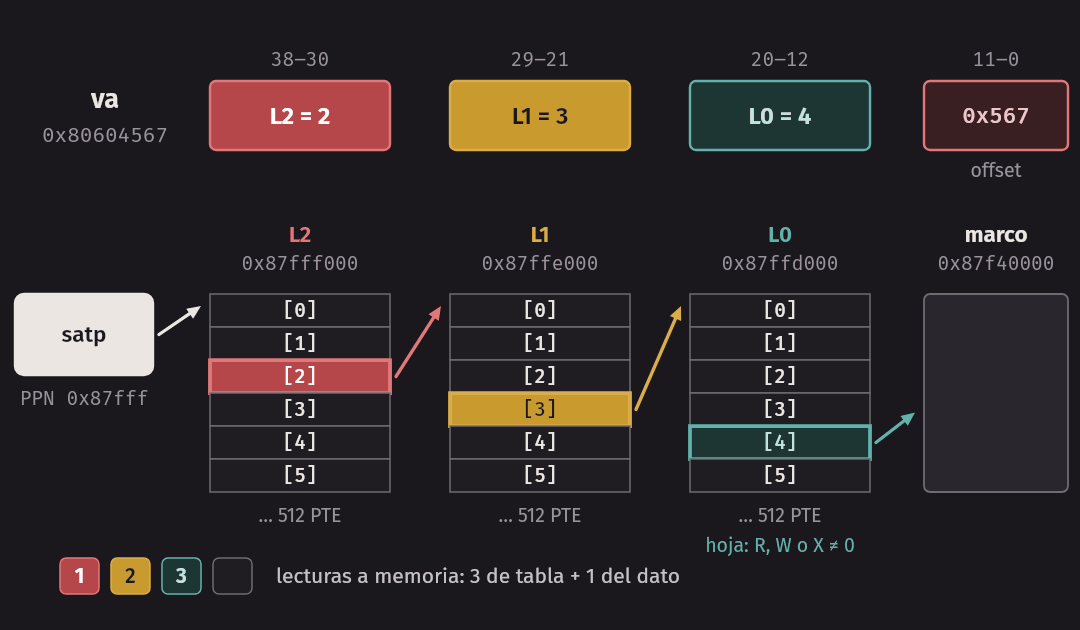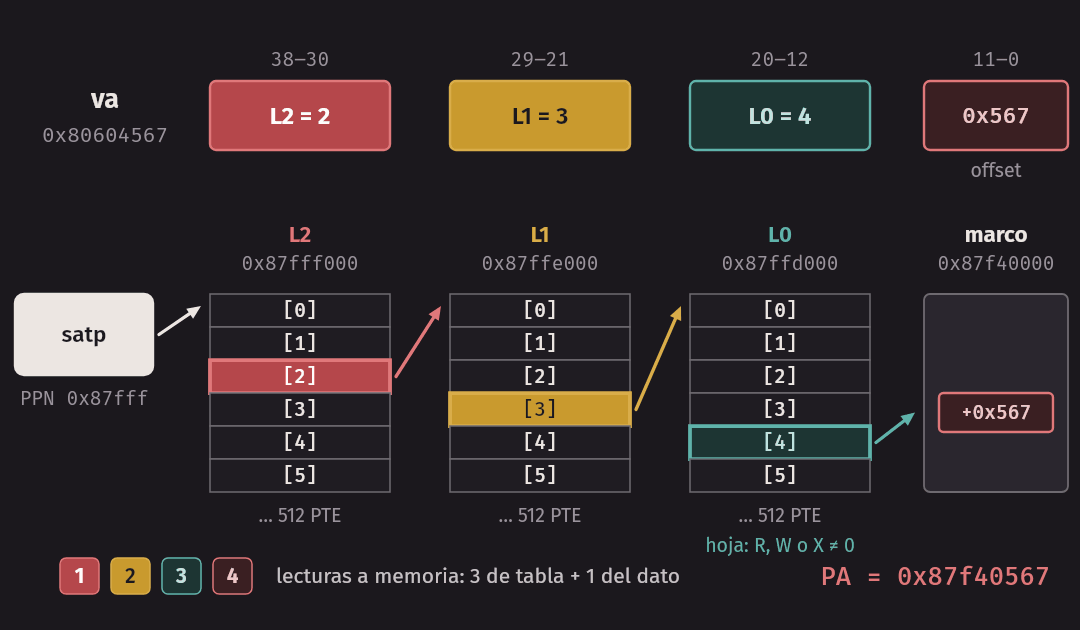
En xv6. El registro
satple dice a la MMU dónde está la raíz: el modo (8 = Sv39) en los bits 60–63, un ASID en los bits 44–59 y el PPN de la raíz en los bits 0–43.MAKE_SATPenkernel/riscv.harma ese valor, con el ASID en 0. La instrucciónsfence.vma zero, zero(funciónsfence_vma()) vacía la TLB.kvminithart()enkernel/vm.cla usa dos veces: antes de escribirsatp, para que terminen las escrituras pendientes a la tabla, y después, para descartar traducciones viejas. Lean tambiénuservecyuserretenkernel/trampoline.S.
Superpages: adelanto de P3
En Sv39, una PTE válida es una hoja si tiene alguno de los bits R, W o X;
si no tiene ninguno, apunta a la tabla del siguiente nivel. freewalk() en
kernel/vm.c usa exactamente esa prueba:
if ((pte & PTE_V) && (pte & (PTE_R | PTE_W | PTE_X)) == 0) {
  // this PTE points to a lower-level page table.
La MMU de RISC-V permite hojas en niveles altos. Una hoja en el nivel 1 mapea
2 MB (los 9 bits de L0 pasan a ser parte del offset) y una en el nivel 2,
1 GB. En teoría, una entrada de TLB cubre así 512 páginas normales (en la
medición, el salto llegó 4 a 8 veces más tarde). El walk() de xv6 siempre baja hasta
el nivel 0, así que xv6 no usa superpages. En el proyecto P3 (lab pgtbl
del MIT) las agregarán.
Resumen
- La TLB guarda traducciones recientes dentro de la MMU. Por la localidad acierta casi siempre, y con 99 % de aciertos la paginación cuesta casi nada.
- El fallo de TLB lo atiende el hardware (x86, ARM, RISC-V) o el software
(MIPS). En un cambio de contexto se vacía la TLB o se usan ASIDs; xv6
la vacía con
sfence.vmay no usa ASIDs. - En el contenedor del curso, un acceso pasa de 1.4 ns a unos 43 ns cuando las páginas tocadas superan el alcance de la TLB; con páginas grandes, el salto llega mucho más tarde.
- Las tablas multinivel solo reservan las páginas de tabla que se usan (16 KB en vez de 4 MB en el ejemplo), a cambio de una lectura más por nivel en cada fallo. Otras ideas: páginas grandes, híbrido, tablas invertidas.
- xv6-riscv usa Sv39: tres niveles de 9 bits,
PX(),walk(),satpysfence.vma.
Ejercicios
- Un programa recorre
int a[10]que empieza en la dirección0x3C, con páginas de 16 bytes y la TLB vacía. ¿Cuántos fallos y aciertos de TLB hay en la primera pasada? ¿Y en una segunda pasada inmediata? ¿Y si entre las dos pasadas hubo un cambio de contexto en xv6? - Con 100 ns por acceso a memoria y una tabla de cuatro niveles, ¿qué tasa de aciertos de TLB hace falta para que el tiempo efectivo de acceso no supere los 105 ns?
- Una TLB de 4 entradas con política LRU recibe las VPN
0 1 2 3 4 0 1 2 3 4. ¿Cuántos fallos hay? ¿Qué pasaría con 5 entradas? Expliquen por qué una política aleatoria puede hacerlo mejor. - Un sistema tiene VA de 30 bits, páginas de 512 bytes y PTE de 4 bytes.
¿Cuántos niveles necesita una tabla multinivel en la que cada nodo quepa en
una página? ¿Cómo se parte la VA? Verifiquen con
ptcalc. - Con el esquema 10/10/12 y el directorio en
0x00200000, traduzcan0x00C01234sabiendo que la PDE que corresponde tiene PFN0x00305y que la PTE tiene PFN0x1A2B3. Escriban la dirección de la PDE, la de la PTE y la PA final. - Ejecuten
make benchen su computadora. ¿Dónde están los escalones? ¿Qué alcance (en KB o MB) tiene la TLB? Comparen con la columna THP: ¿qué escalones cambian y cuáles no? - En xv6-riscv, ¿qué condiciones de alineación deben cumplir la VA y la PA
para mapear una superpage de 2 MB con una hoja en el nivel 1? ¿Qué tendría
que cambiar en
walk()para encontrar esa hoja?