
Apuntes · Capítulo 8Memoria
Más allá de la memoria física: swapping y sistemas de memoria virtual completos
Más allá de la memoria física: swapping y sistemas de memoria virtual completos
En las semanas 5 a 7 construimos la memoria virtual pieza por pieza: el espacio de direcciones, la paginación, la TLB y las tablas multinivel. En todas ellas hicimos una suposición cómoda: todas las páginas de todos los procesos tienen un marco de página (page frame) en la memoria física. Esta semana la quitamos. ¿Qué pasa cuando la suma de lo que piden los procesos es mayor que la RAM?
La respuesta es usar el disco como un nivel más de la jerarquía de memoria. Las páginas que no se están usando esperan en el disco, en el espacio de swap, y vuelven a la RAM cuando alguien las necesita. Para que esto funcione hacen falta un mecanismo (el bit presente y el manejo del fallo de página) y una política (qué página sacar cuando no hay espacio). Al final veremos cómo combinan todas estas ideas dos sistemas reales, VAX/VMS y Linux, y qué hace xv6-riscv con los fallos de página.
Ruta de lectura.
- Antes de clase (15–20 min): «Espacio de swap», «El bit presente» y «Qué pasa en un fallo de página», de «El mecanismo: el bit presente y el fallo de página».
- En clase: sesión A (la sesión B es el examen parcial), «Cuánto cuesta un fallo», «La política: qué página expulsar», «Aproximar LRU: el algoritmo del reloj», «Thrashing y conjunto de trabajo» y «Sistemas reales»; laboratorio, «Experimento: presión de memoria en el contenedor» y «Fallos de página en xv6-riscv».
- Después de clase: repasar el «Resumen» y el «Repaso para el examen parcial», y resolver los «Ejercicios». Para ampliar: OSTEP cap. 21 a 23.
Lectura. Este capítulo acompaña a OSTEP cap. 21 Beyond Physical Memory: Mechanisms, cap. 22 Beyond Physical Memory: Policies, cap. 23 Complete Virtual Memory Systems y el diálogo del cap. 24. El código está en
code/week-08y se compila conmakedentro del contenedor del curso. La sesión B de esta semana es el examen parcial; al final del capítulo hay una sección de repaso.
El mecanismo: el bit presente y el fallo de página
Espacio de swap
El kernel reserva una zona del disco (una partición o un archivo) dividida en bloques del tamaño de una página: el espacio de swap (swap space). Cuando una página sale de la RAM, se escribe en un bloque libre y el kernel anota cuál. El código no necesita swap: si se expulsa, se vuelve a leer del ejecutable. El swap es para el heap, la pila y todo lo que no tiene otra copia en el disco.
El bit presente
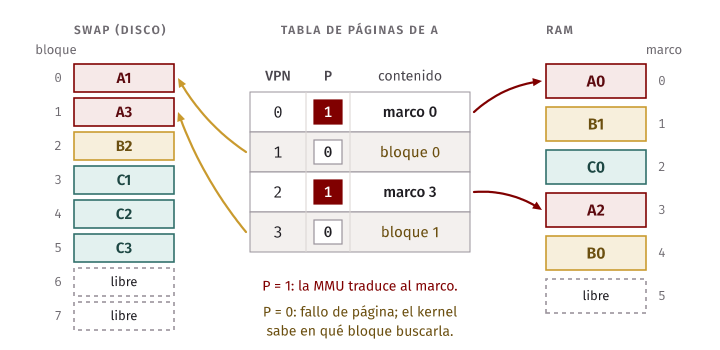
Con swap, cada entrada de la tabla de páginas (page table entry, PTE) debe decir además si la página está en memoria o en disco. Para eso está el bit presente (present bit):
- Presente en 1: la MMU traduce como siempre.
- Presente en 0: la MMU no puede traducir. Lanza una excepción, un fallo de página (page fault), y le pasa el problema al kernel.
Con la página fuera, el número de marco no sirve, y el kernel usa esos bits para guardar el bloque de swap donde quedó.
En xv6. RISC-V no tiene un bit “presente” separado. La PTE de Sv39 tiene los bits
V,R,W,X,U,G,A,Dy dos bitsRSWreservados para el software (verkernel/riscv.h). SiVes 0, la MMU lanza un fallo de página, así queVcumple el papel del bit presente. Un kernel con swap sobre RISC-V guardaría el bloque de swap en los bits restantes de una PTE conV = 0. xv6 no tiene swap, pero sí atiende fallos de página: lo vemos al final.
Qué pasa en un fallo de página
Sigamos un acceso a memoria de principio a fin:
- La MMU busca la traducción en la TLB; si no está, recorre la tabla de páginas. Si la PTE es válida y presente, todo lo resuelve el hardware.
- Si la página es válida pero no presente, la MMU lanza un fallo de página: un trap al kernel.
- El kernel busca un marco libre. Si no hay, elige una víctima con la política de reemplazo (y la escribe al swap si está modificada).
- El kernel lee la página del swap. Esto toma milisegundos: el proceso se bloquea y la CPU pasa a otro.
- Al terminar la E/S, el kernel actualiza la PTE (marco y presente en 1) y la instrucción que falló se reintenta.
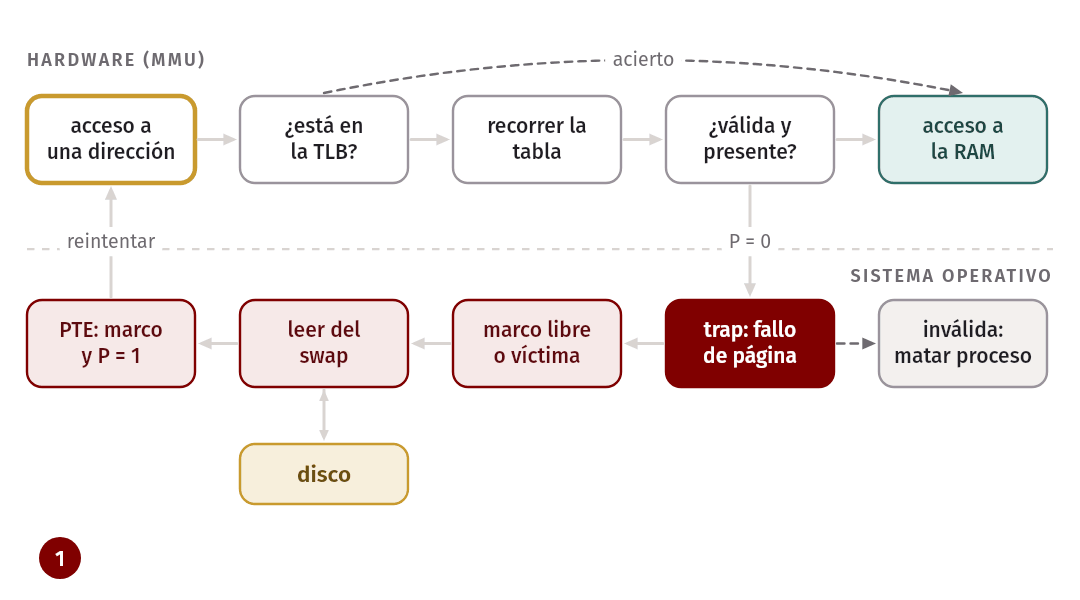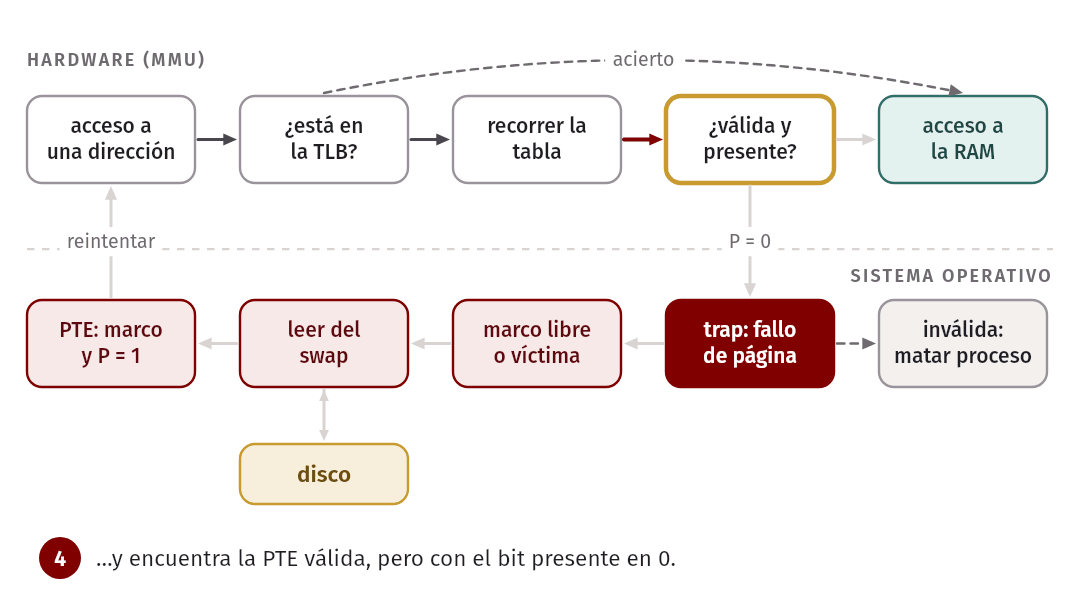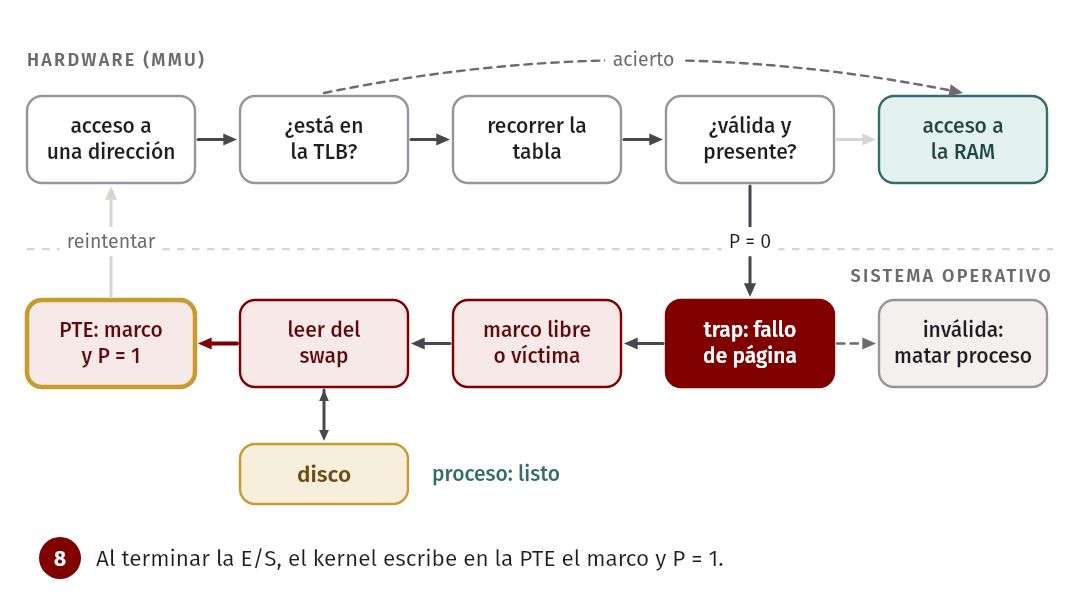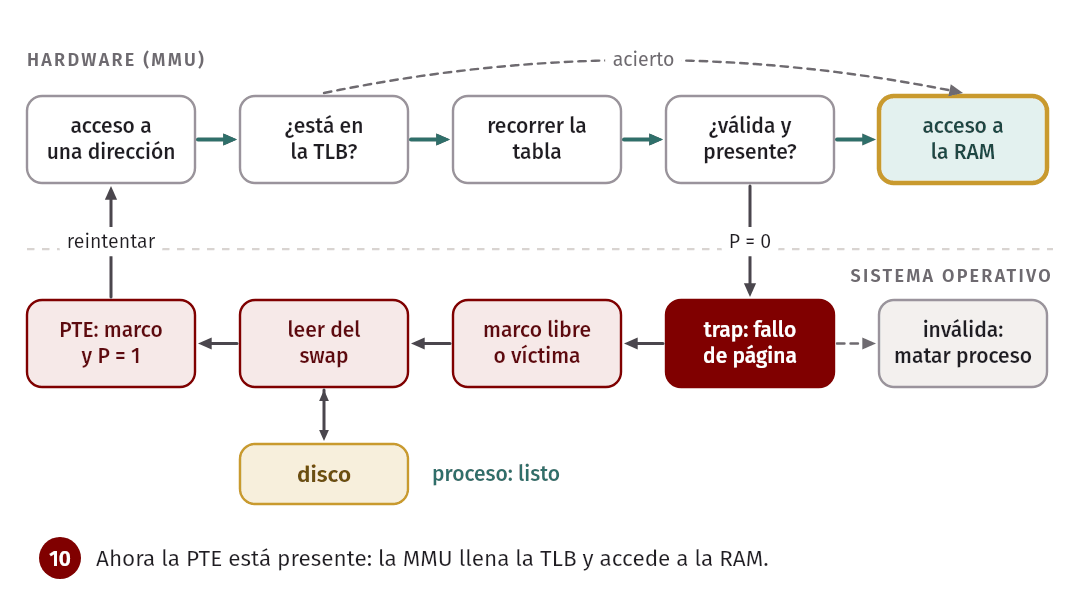
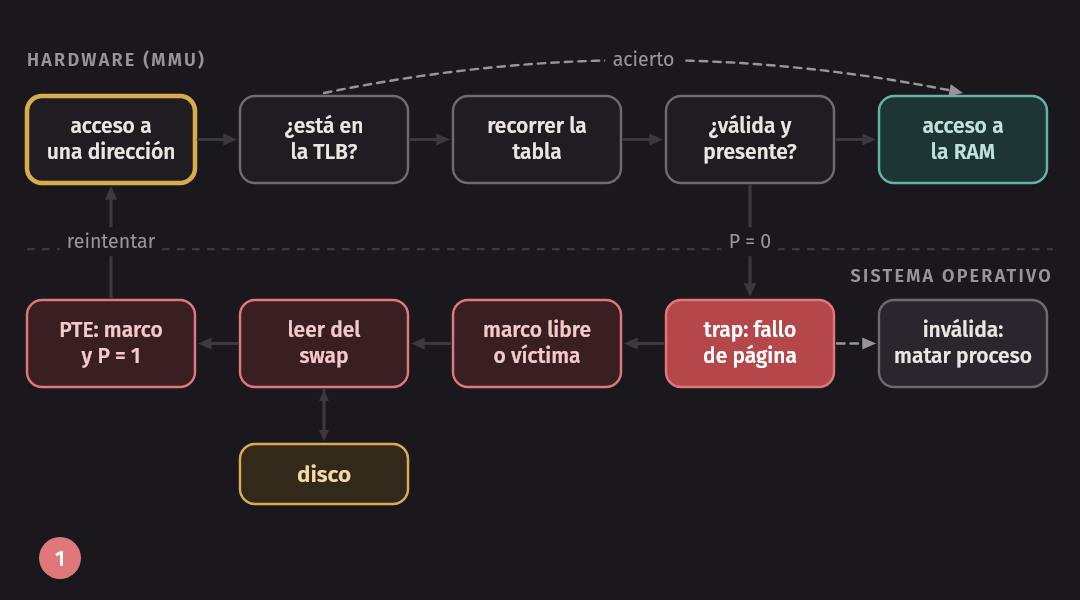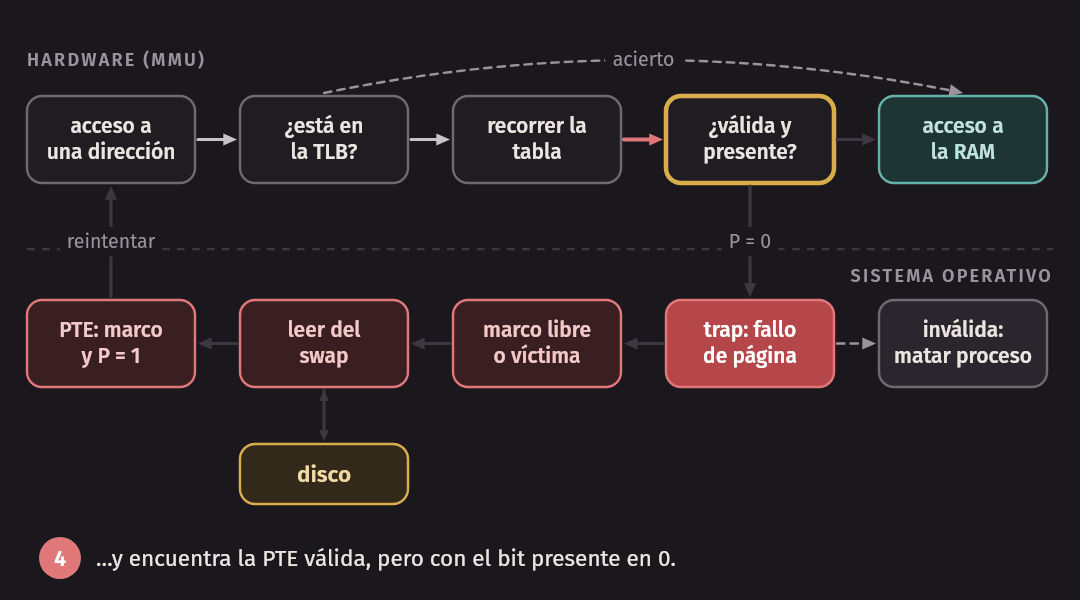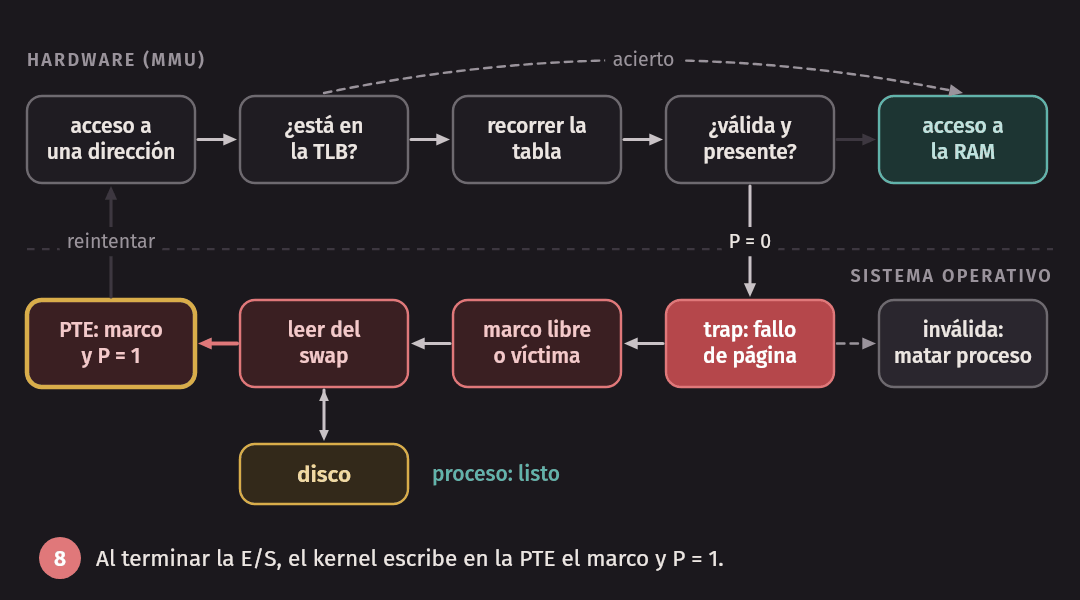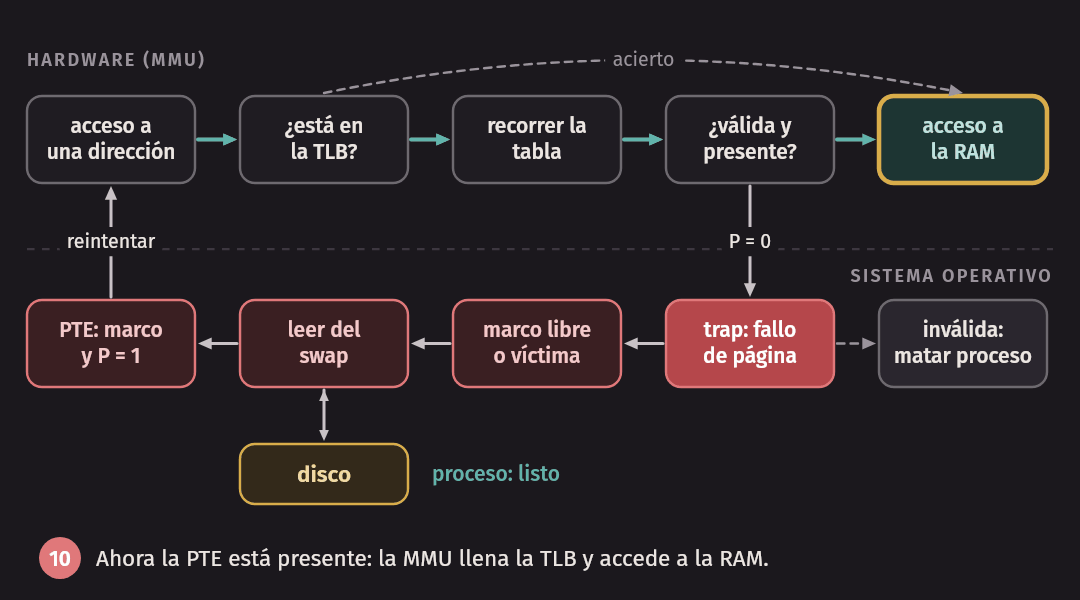
Si la dirección ni siquiera es válida, no hay nada que traer: el kernel
termina al proceso (Segmentation fault). El fallo lo atiende el kernel y no el
hardware porque, al lado de los milisegundos del disco, el trap y la lógica en
software no cuestan nada, y el kernel sabe dónde está cada bloque y qué
conviene expulsar.
Cuánto cuesta un fallo
Sea p la probabilidad de que un acceso cause un fallo de página. El tiempo
efectivo de acceso es
T_efectivo = (1 - p) * T_RAM + p * T_falloCon T_RAM = 100 ns y T_fallo = 10 ms (un disco duro):
- Si
p = 1/1000:0.999 * 100 + 0.001 * 10 000 000 ≈ 10 100 ns. La memoria se vuelve 100 veces más lenta. - Para perder solo un 10 %:
p * 10 000 000 ≤ 10, es decirp ≤ 10^-6. Un fallo cada millón de accesos.
Con un SSD es más barato, pero no tanto: más abajo medimos unos 41 µs de pasada por cada fallo mayor.
Idea clave. El swap solo funciona si los fallos de página son rarísimos. Por eso la política de reemplazo importa tanto: un pequeño cambio en la tasa de fallos es un cambio enorme en el rendimiento.
Marcas de agua y el demonio de swap
Los sistemas reales no esperan a quedarse sin marcos: expulsan por
adelantado. Hay dos marcas de agua, una baja (low watermark, LW) y una alta
(high watermark, HW). Cuando quedan menos de LW páginas libres, despierta el
demonio de swap (swap daemon), un hilo del kernel que expulsa páginas hasta
tener HW libres. Como expulsa muchas a la vez, puede agrupar (clustering)
las escrituras en pocas operaciones grandes, que el disco atiende mucho mejor.
En Linux el demonio es kswapd; en el contenedor del curso,
/proc/zoneinfo muestra low 13232 y high 16755 páginas: despierta bajo
52 MB libres y para en 65 MB.
La política: qué página expulsar
La memoria como caché
La RAM es una caché de las páginas que viven en el disco. Una caché se mide por su tasa de aciertos (hits) y de fallos (misses), y el tiempo medio de acceso es
AMAT = T_M + P_fallo * T_Ddonde T_M es el tiempo de un acceso a memoria y T_D el de un acceso a
disco. Los fallos de una caché se clasifican en las 3 C:
- Compulsivos (cold-start): la primera vez que se usa una página. Ninguna política los evita.
- De capacidad: la página estuvo en memoria, pero se expulsó porque no cabía todo.
- De conflicto: en las cachés de hardware, una dirección solo puede ir a ciertas posiciones. La memoria del sistema operativo es totalmente asociativa: una página puede ir a cualquier marco, así que no hay fallos de conflicto.
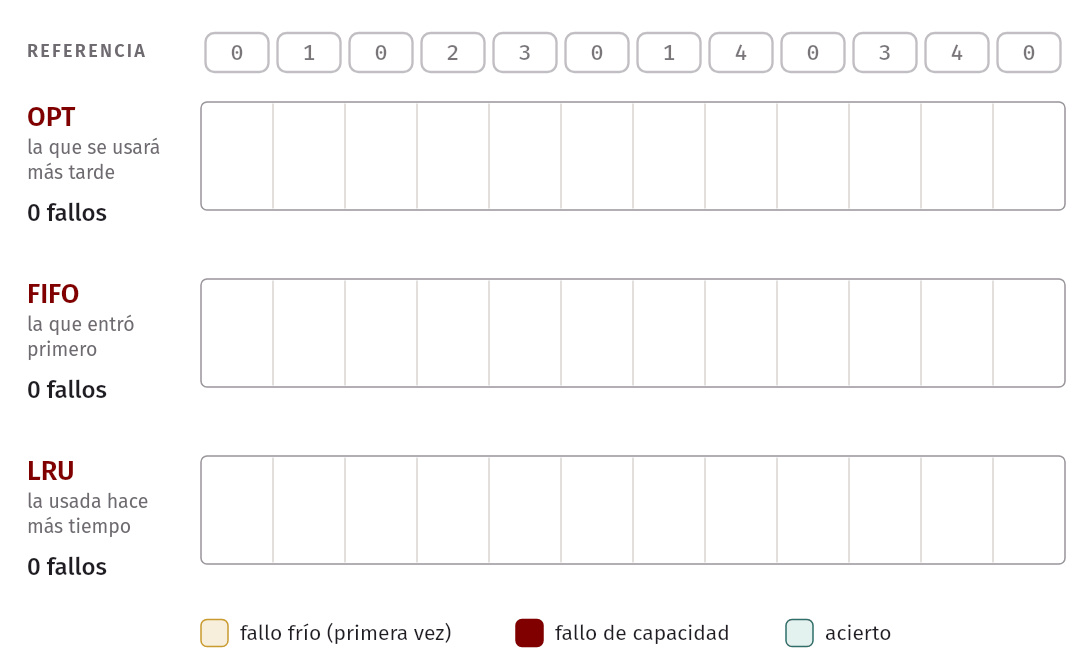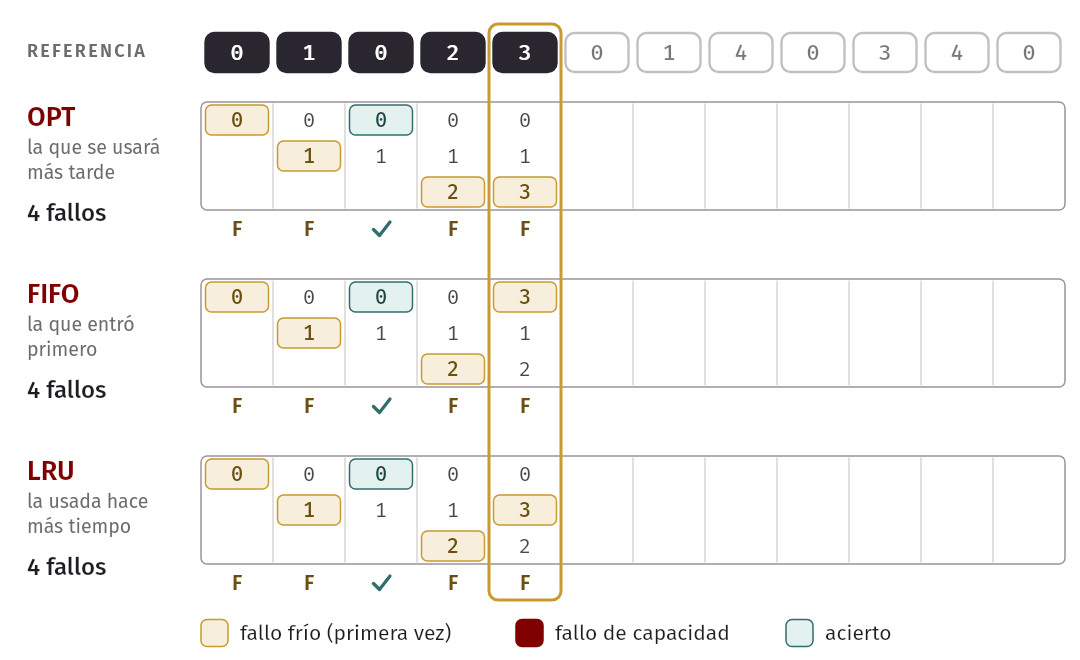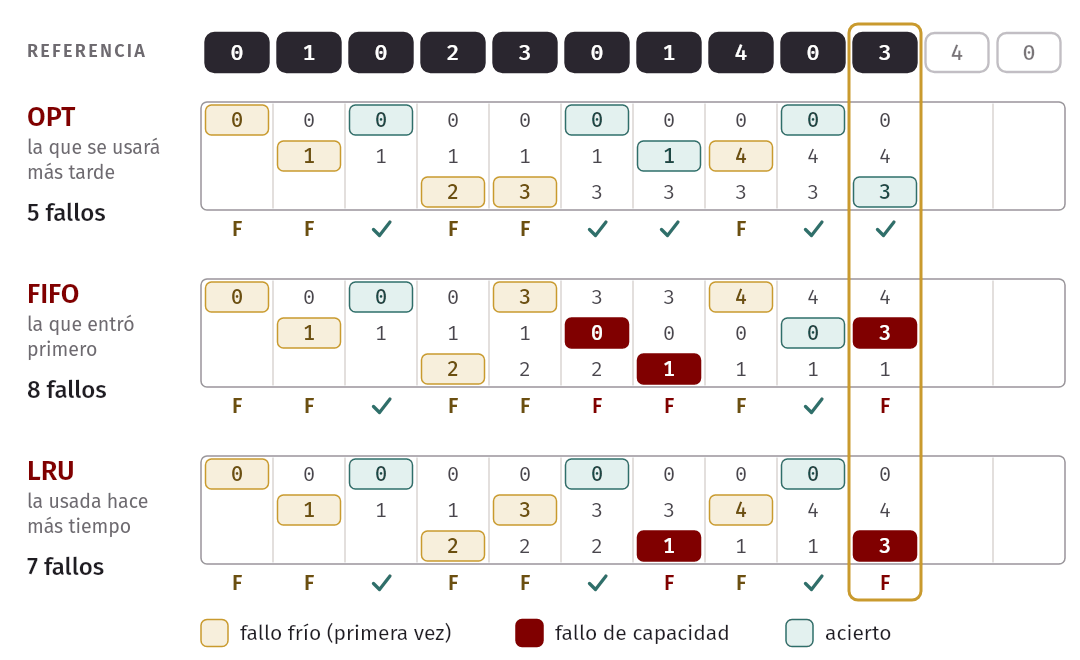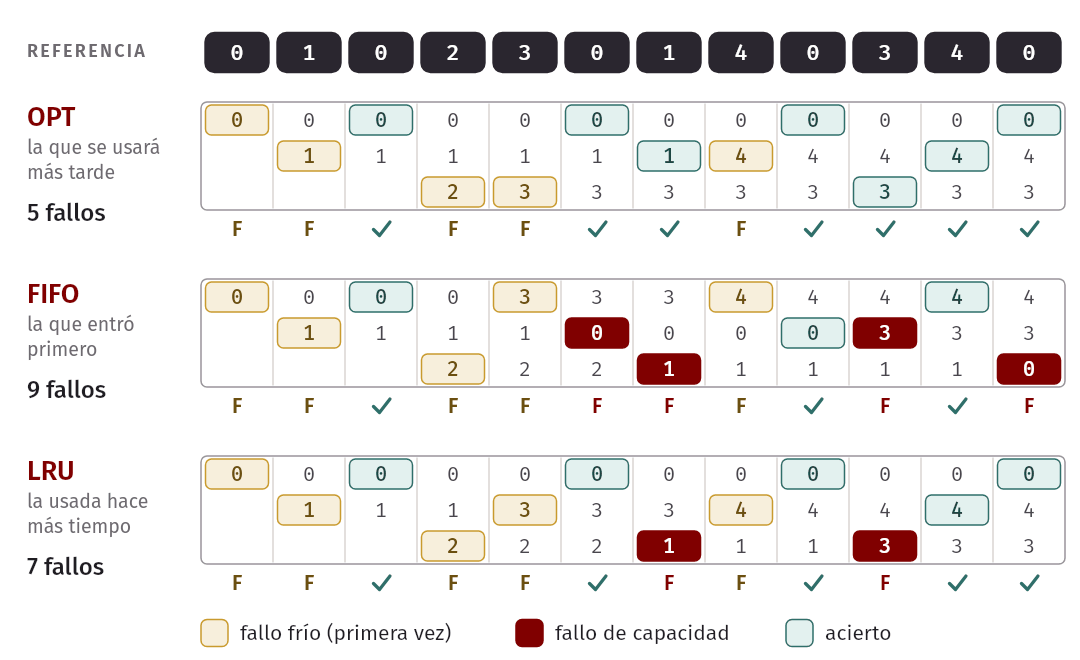
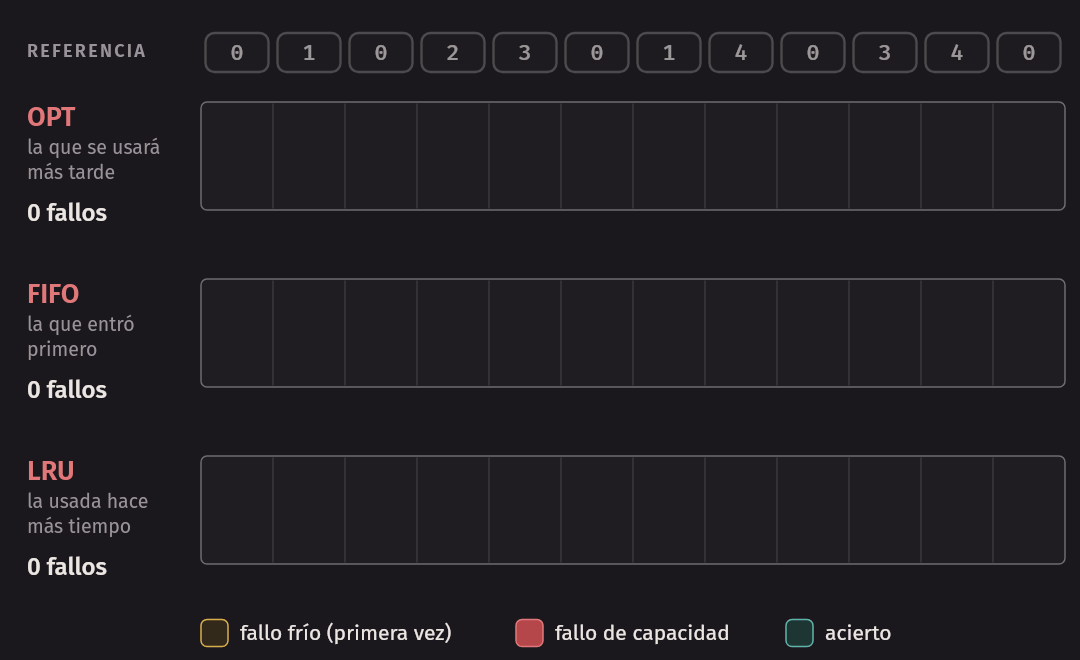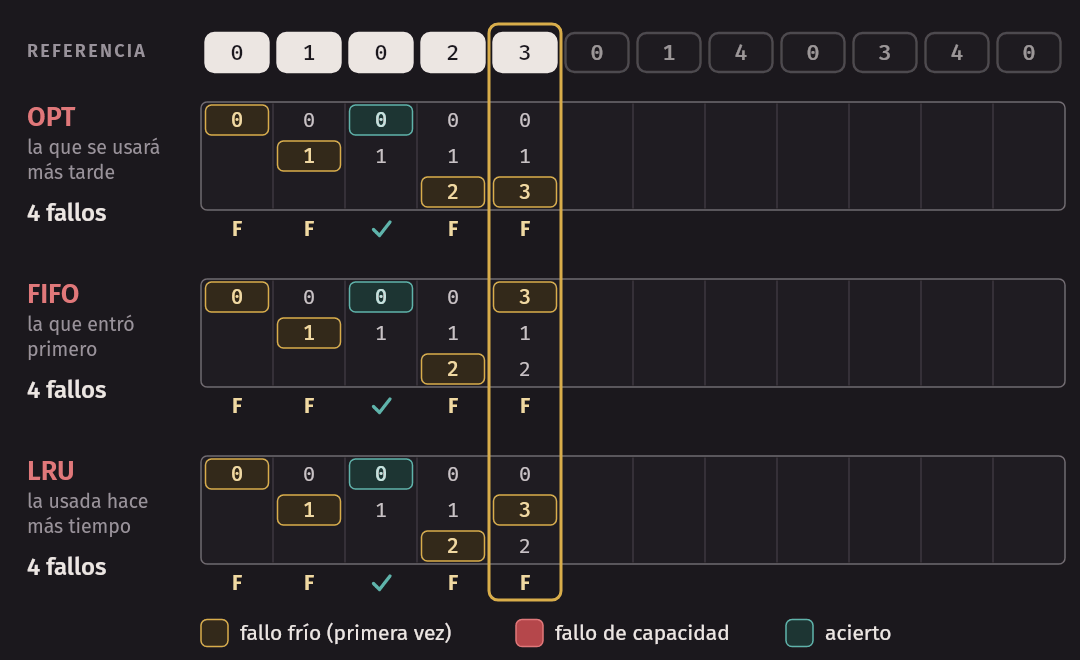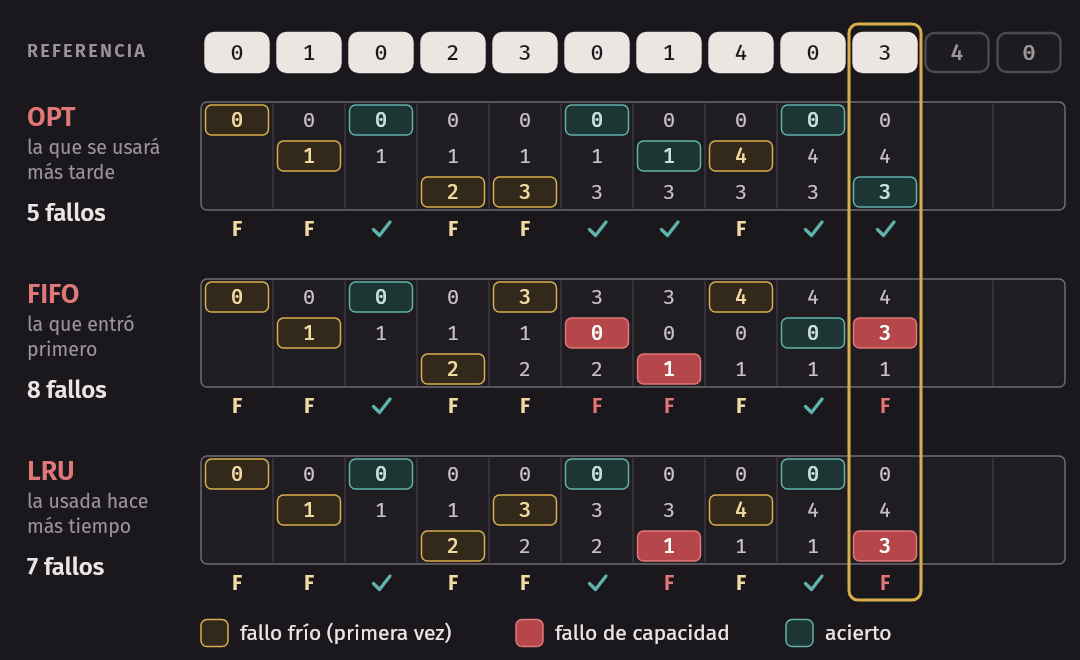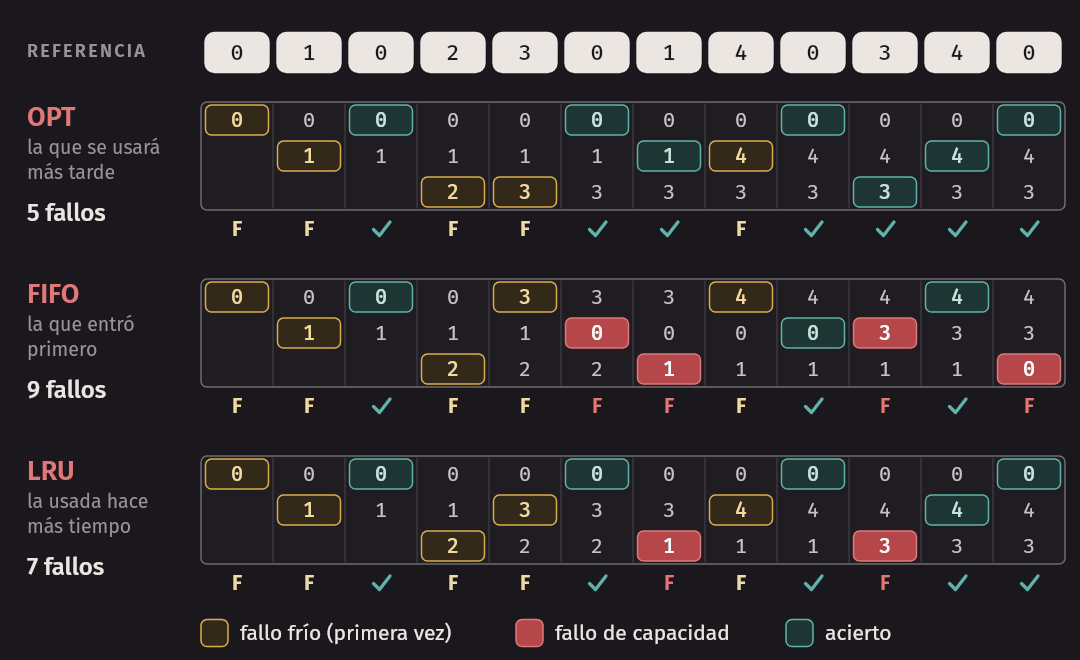
Para comparar políticas usaremos una misma secuencia de 12 referencias a páginas y una memoria de 3 marcos:
0 1 0 2 3 0 1 4 0 3 4 0Hay 5 páginas distintas y la 0 es la más popular. Todo se verificó con
paging.c.
OPT: la política óptima
La política óptima (Belady, 1966) expulsa la página que se usará más lejos en el futuro. Los cuatro primeros accesos cargan 0, 1 y 2. Cuando llega 3, los próximos usos son: 0 en la posición 6, 1 en la 7 y 2 nunca. Se expulsa 2. Cuando llega 4: 0 en 9, 1 nunca y 3 en 10. Se expulsa 1.
Resultado: 5 fallos, todos compulsivos: no se puede hacer mejor. Pero OPT necesita conocer el futuro; solo sirve como referencia.
FIFO
FIFO expulsa la página que entró primero; solo necesita una cola. Cuando llega 3, la más antigua es 0, justo la más usada. Al siguiente acceso 0 falla, expulsa a 1, que falla enseguida, y así. Resultado: 9 fallos, 4 de capacidad más que OPT. FIFO no mira cuánto se usa una página, solo cuándo llegó.
RAND
La política aleatoria expulsa una página cualquiera. Su resultado depende de la suerte; en 10 000 corridas:
| Fallos | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|
| Corridas | 1066 | 1493 | 2391 | 2721 | 1657 | 599 | 73 |
Promedio: 7.45 fallos, a veces como OPT y a veces peor que FIFO.
LRU
LRU (least recently used) expulsa la página que se usó hace más tiempo. Se apoya en la localidad: lo que no se usó hace rato probablemente no se use pronto.
| Ref. | Resultado | Expulsa | Marcos |
|---|---|---|---|
| 0 | fallo (frío) | 0 - - | |
| 1 | fallo (frío) | 0 1 - | |
| 0 | acierto | 0 1 - | |
| 2 | fallo (frío) | 0 1 2 | |
| 3 | fallo (frío) | 1 | 0 3 2 |
| 0 | acierto | 0 3 2 | |
| 1 | fallo | 2 | 0 3 1 |
| 4 | fallo (frío) | 3 | 0 4 1 |
| 0 | acierto | 0 4 1 | |
| 3 | fallo | 1 | 0 4 3 |
| 4 | acierto | 0 4 3 | |
| 0 | acierto | 0 4 3 |
Cuando llega 3, LRU expulsa 1 (usada en la posición 2) y salva a 0.
Resultado: 7 fallos, mejor que FIFO y que RAND, peor que OPT.
./paging -p all 0 1 0 2 3 0 1 4 0 3 4 0 imprime la comparación completa.
Depende de la carga de trabajo
Sin localidad (accesos al azar), todas las políticas realistas dan casi lo
mismo. Con una carga 80-20 (el 20 % de las páginas recibe el 80 % de los
accesos), LRU gana porque guarda las páginas calientes.
Con un ciclo de N+1 páginas y N marcos, LRU y FIFO siempre expulsan la
página que viene después: con 0 1 2 3 tres veces y 3 marcos fallan las 12
veces, y RAND solo 7.83 en promedio.
La anomalía de Belady
Con FIFO, más memoria puede dar más fallos. Con 0 1 2 3 0 1 4 0 1 2 3 4:
| Marcos | FIFO | LRU |
|---|---|---|
| 3 | 9 | 10 |
| 4 | 10 | 8 |
Con 4 marcos, FIFO acierta en 0 y 1, pero luego 4 expulsa a 0 y empieza una
cadena de fallos. LRU y OPT no sufren esta anomalía de Belady porque tienen
la propiedad de pila (stack property): lo que está en N marcos también está
en N+1. Se verifica con ./paging -p fifo -c 5 ....
Aproximar LRU: el algoritmo del reloj
LRU exacto exige actualizar una marca de tiempo en cada acceso y buscar la
mínima entre millones de páginas: demasiado caro. El hardware ofrece algo más
barato, un bit de referencia (use bit): la MMU lo pone en 1 al usar la
página y solo el OS lo vuelve a 0. En RISC-V es el bit A de la PTE.
El algoritmo del reloj (clock) imagina las páginas en un círculo con una manecilla. Al buscar una víctima:
- Si la página apuntada tiene el bit en 1, se le da una segunda oportunidad: el bit pasa a 0 y la manecilla avanza.
- Si tiene el bit en 0, no se usó desde la última vuelta: se expulsa.
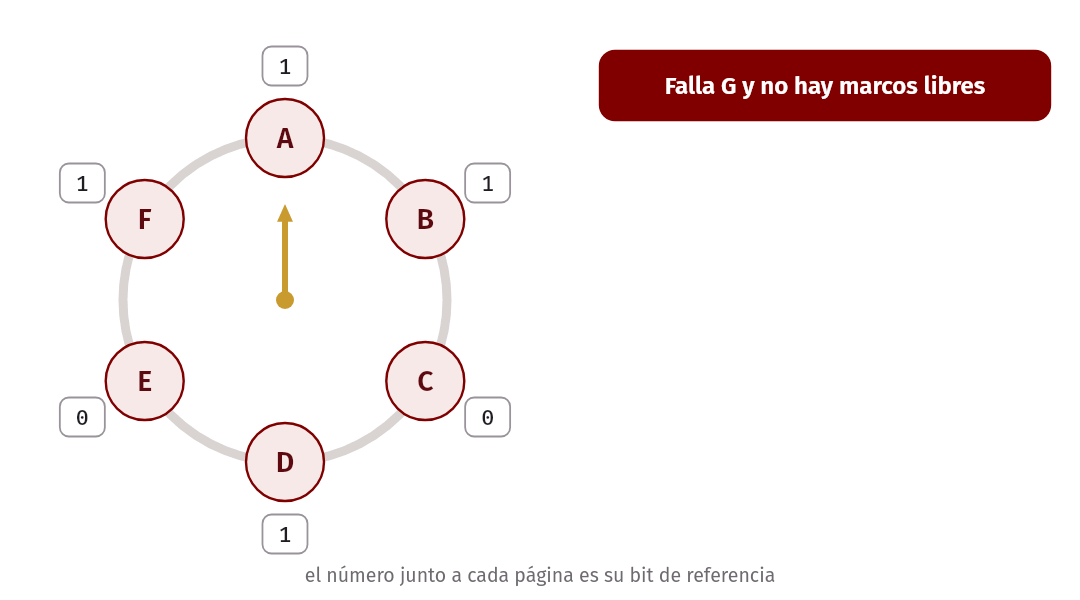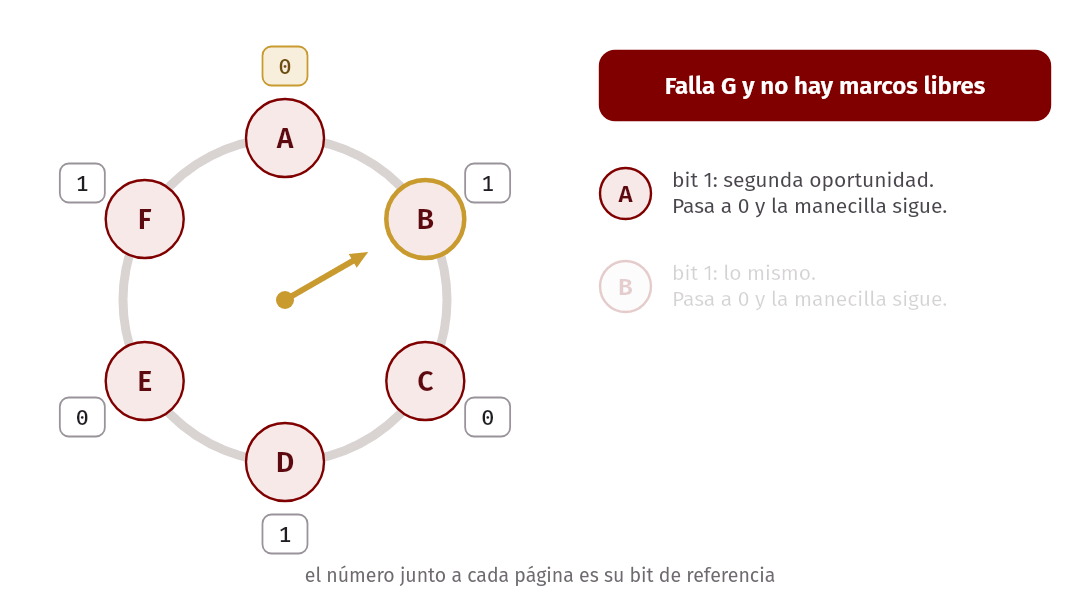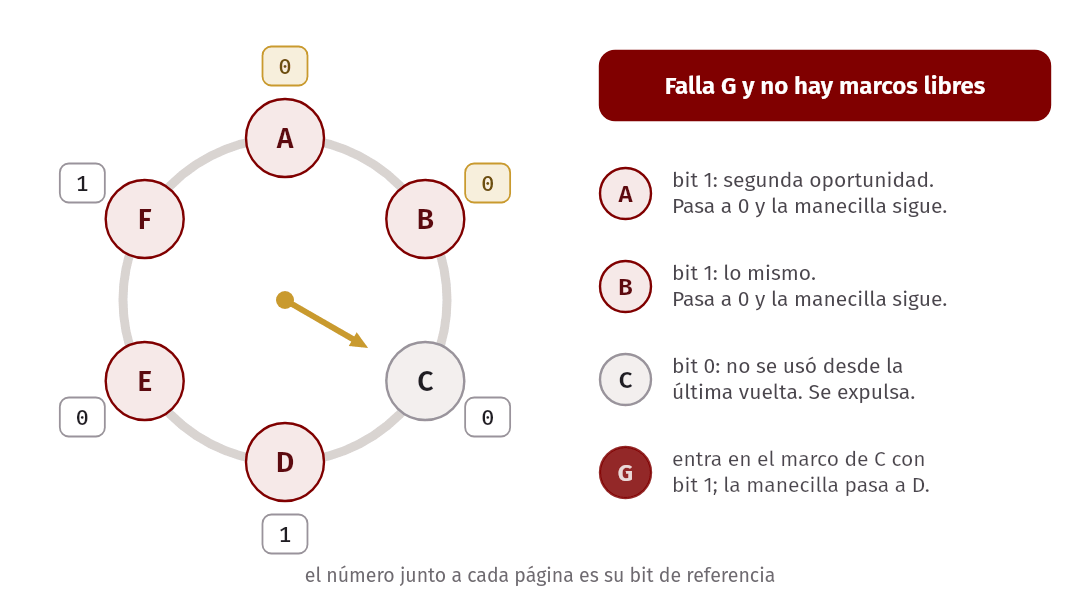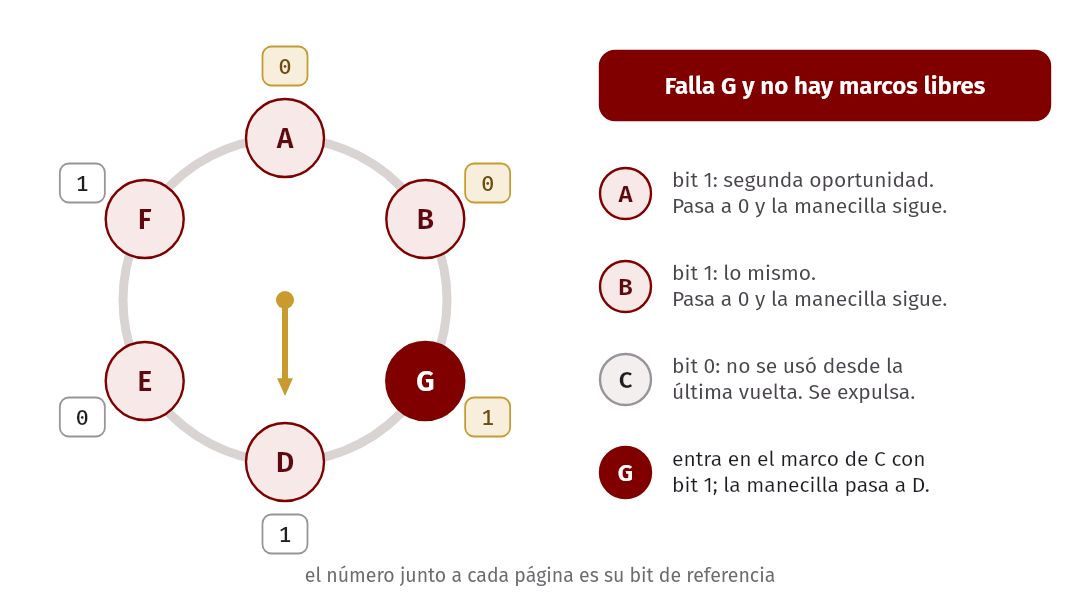
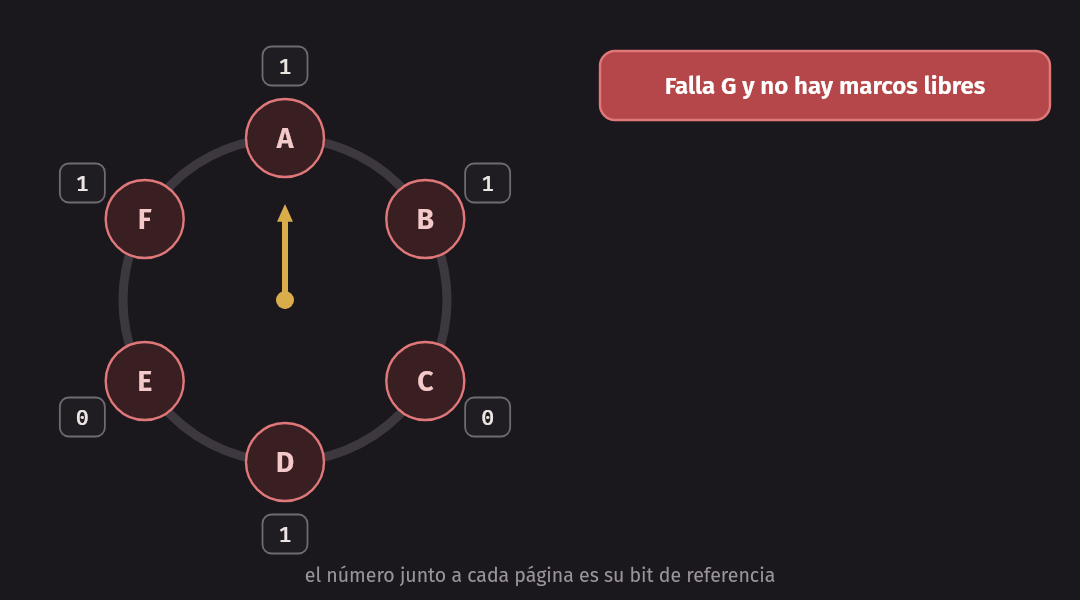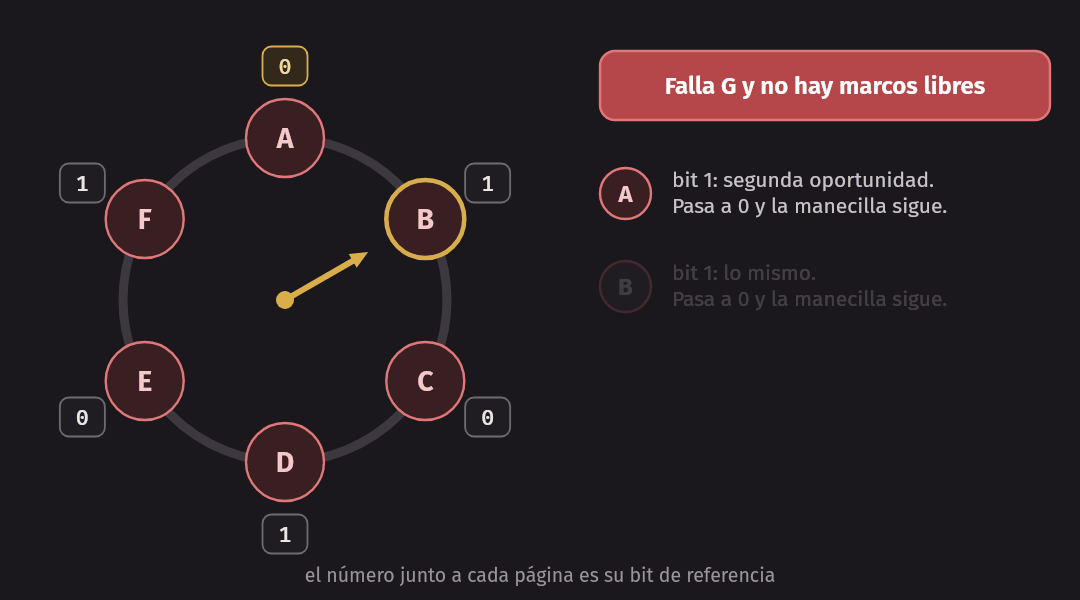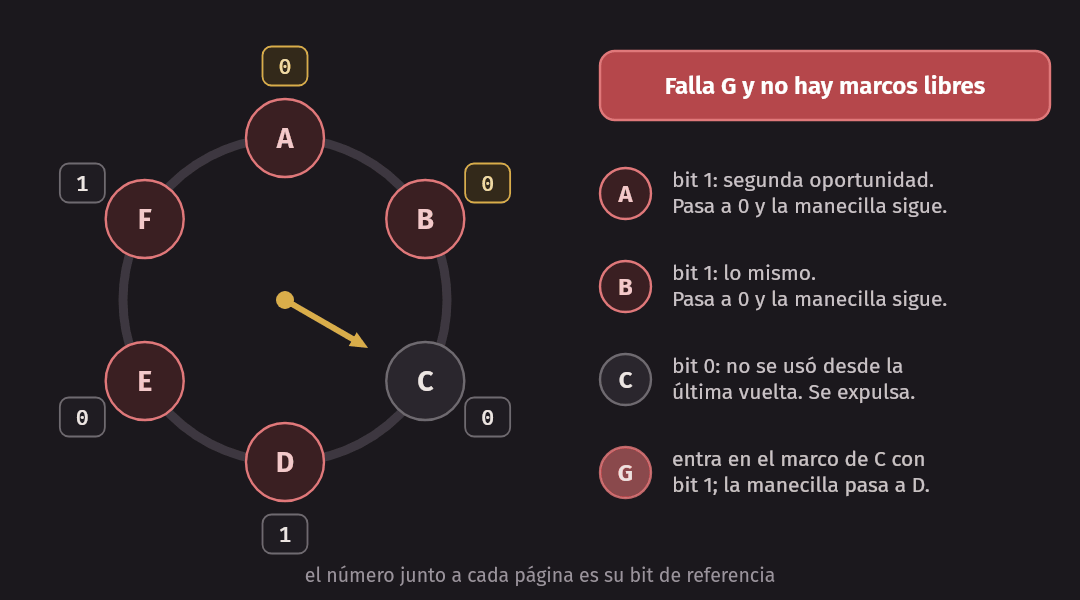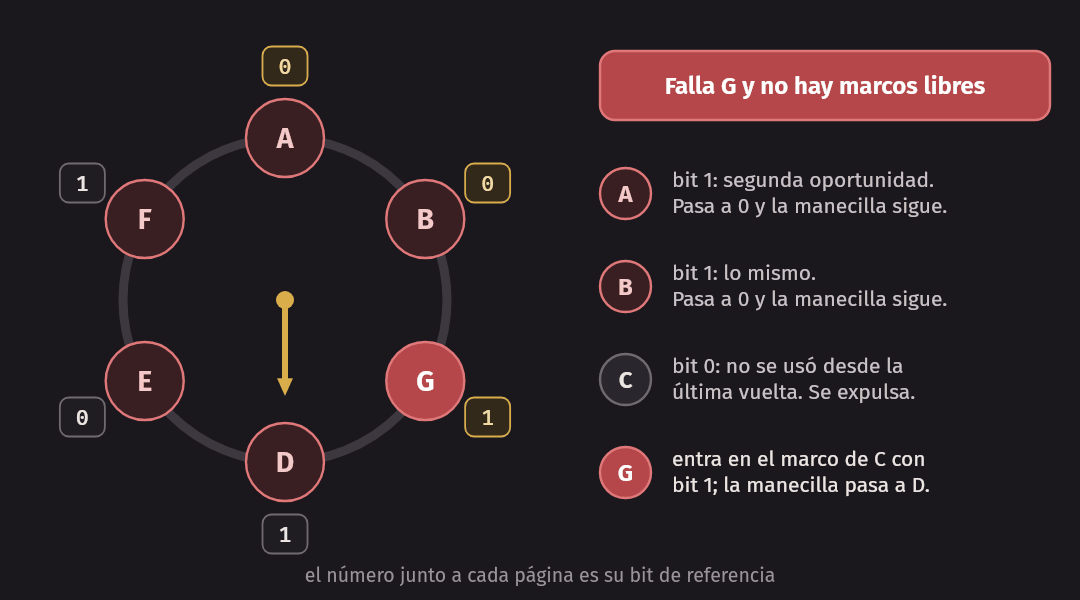
Con nuestra secuencia, cuando llega 3 los tres marcos tienen el bit en 1: la manecilla da una vuelta completa poniéndolos en 0 y expulsa a 0, igual que FIFO. Pero más adelante, cuando 0 ya tiene su bit en 1 por un acierto reciente, la manecilla lo salta y expulsa a 1. El resultado es 8 fallos: entre FIFO (9) y LRU (7), con solo un bit por página.
Páginas sucias
Expulsar una página modificada obliga a escribirla al disco; una página
limpia simplemente se olvida. El hardware marca las páginas modificadas con el
bit sucio (dirty bit; en RISC-V, el bit D). El reloj modificado busca
primero páginas no usadas y limpias, después no usadas y sucias:
| Usada | Sucia | Al expulsar |
|---|---|---|
| 0 | 0 | primera opción: gratis |
| 0 | 1 | hay que escribirla al disco |
| 1 | 0 | se usó hace poco |
| 1 | 1 | la peor opción |
Las páginas se traen casi siempre por demanda (demand paging), a veces con precarga (prefetching) de la siguiente.
Thrashing y conjunto de trabajo
Si la memoria que los procesos usan activamente no cabe en la RAM, cada acceso expulsa una página que se va a necesitar enseguida. Los procesos pasan la vida esperando al disco, la CPU queda casi ociosa aunque hay mucho trabajo pendiente, y el sistema parece congelado. Es el thrashing.
Denning (1968) propuso medirlo con el conjunto de trabajo (working set):
W(t, Δ) son las páginas distintas usadas en las últimas Δ referencias. Con
Δ = 4 y nuestra secuencia:
| t | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Ref. | 0 | 1 | 0 | 2 | 3 | 0 | 1 | 4 | 0 | 3 | 4 | 0 |
| |W| | 1 | 2 | 2 | 3 | 4 | 3 | 4 | 4 | 3 | 4 | 3 | 3 |
El conjunto de trabajo llega a 4 páginas con solo 3 marcos: de ahí salen los fallos de capacidad de FIFO, LRU y el reloj. Según Denning, un proceso solo debería correr si su conjunto de trabajo cabe entero; si no caben todos, hay que sacar procesos completos (control de admisión). Linux, más drástico, tiene el OOM killer: mata a un proceso que usa mucha memoria.
Idea clave. Una política de reemplazo no puede arreglar una memoria demasiado pequeña. Si el conjunto de trabajo no cabe, cualquier política hace thrashing; la única salida es correr menos cosas a la vez o comprar más RAM.
Experimento: presión de memoria en el contenedor
memtouch.c reserva N MB con mmap y los
recorre varias veces, escribiendo un byte en cada página. Por cada pasada mide
el tiempo y, con getrusage, cuántos fallos menores (se resuelven sin
disco: una página nueva en ceros, o una que todavía está en RAM) y fallos
mayores (hubo que leer del disco) hubo:
for (int p = 1; p <= passes; p++) {
    getrusage(RUSAGE_SELF, &before);
    double t0 = now_s();
    for (size_t i = 0; i < size; i += page)
        buf[i] = (char)p; // queda sucia
    double dt = now_s() - t0;
    getrusage(RUSAGE_SELF, &after);
    // imprime dt, MB/s, ru_minflt, ru_majflt
}
En un contenedor limitado a 256 MB (Docker agrega por defecto otros 256 MB de
swap: --memory-swap, memoria más swap, vale el doble de --memory):
docker run --rm -it --memory=256m -v "$PWD":/work -w /work sistemas-operativos bash
make
./memtouch 200 2
./memtouch 400
PID 13: 200 MB, páginas de 4096 bytes, 51200 páginas
pasada segundos MB/s f.menores f.mayores
1 0.029 6856 51204 1
2 0.001 209662 0 0
PID 18: 400 MB, páginas de 4096 bytes, 102400 páginas
pasada segundos MB/s f.menores f.mayores
1 0.117 3424 102406 3
2 1.068 375 76768 25646
3 1.074 373 76667 25744
4 1.086 368 76377 26038Con 200 MB, la primera pasada tiene un fallo menor por página (es el demand
zeroing, más abajo) y después ninguno. Con 400 MB, desde la segunda pasada todo
es unas 500 veces más lento y mayores más menores suman el número de
páginas: cada página falla. Hay más menores que mayores porque Linux, al
leer del swap, trae también páginas vecinas (readahead). Es el ciclo que vimos
arriba, el peor caso de LRU, ejecutándose de verdad: unos 41 µs de pasada por
cada fallo mayor (incluye escribir las víctimas). Mientras tanto, vmstat 1 en otra terminal muestra unos 380 000
KB/s en las columnas si y so (lo que entra desde el swap y sale hacia él).
Si se quita el swap con --memory-swap=256m, el kernel no tiene dónde poner
las páginas y el OOM killer mata al proceso: memtouch 400 termina con
Killed y código 137 (128 + 9, SIGKILL), y /sys/fs/cgroup/memory.events
cuenta oom_kill 1. Con el swap por defecto pasa lo mismo con memtouch 600,
que supera los 512 MB de memoria más swap.
Ojo al medir en Docker Desktop: el contenedor corre en una máquina virtual
Linux (en nuestras pruebas, 16 GB de RAM y 3 GB de swap) y vmstat y free
muestran toda esa máquina, no el límite del contenedor, que está en
/sys/fs/cgroup/memory.current. Si free muestra Swap: 0, no habrá swap y
verán directamente el OOM killer.
Sistemas reales
VAX/VMS
El VAX-11 (1978) tenía direcciones de 32 bits y páginas de 512 bytes (VPN
de 23 bits, offset de 9). Los 2 bits altos eligen el segmento: un híbrido de
segmentación y paginación. La mitad baja es del proceso, P0 (código y
heap) y P1 (pila); la alta es el sistema S, compartido. Para que las
tablas no fueran enormes, hay una por segmento con base y límite (el hueco
entre heap y pila no ocupa PTEs), y las de P0 y P1 viven en la memoria
virtual del kernel, así que también pueden ir al swap. La página 0 es
inválida, para atrapar los punteros NULL.
La PTE del VAX no tiene bit de referencia. VMS usó un FIFO segmentado: cada proceso tiene un tope de páginas, su RSS (resident set size), y al pasarlo su página más antigua va a una lista global de segunda oportunidad, de limpias o de sucias. Otros procesos toman marcos de la de limpias, pero si el owner vuelve a pedir la página antes, la recupera sin disco. Con listas grandes se acerca a LRU. Las sucias se escriben agrupadas.
VMS popularizó además dos trucos que hoy usa todo sistema operativo:
- Demand zeroing: una página nueva no se llena de ceros al pedirla; queda no
presente. En el primer acceso hay un fallo y recién ahí se busca un marco y
se pone en cero. Si nunca se usa, no costó nada (la primera pasada de
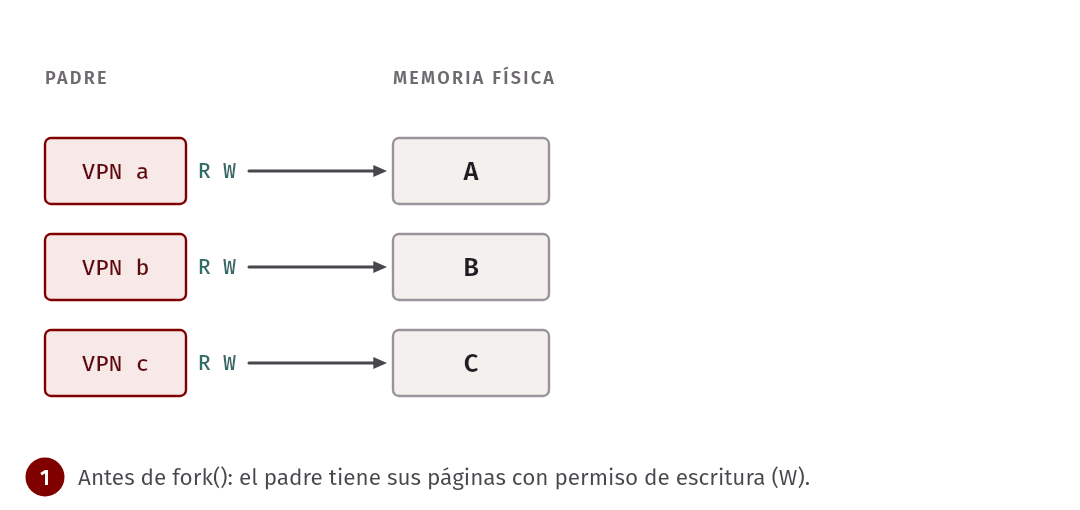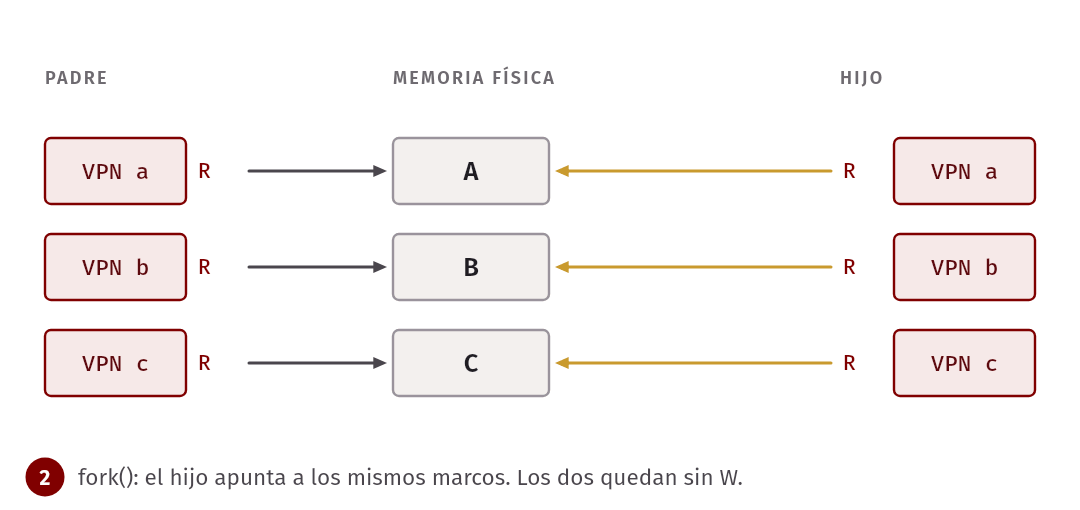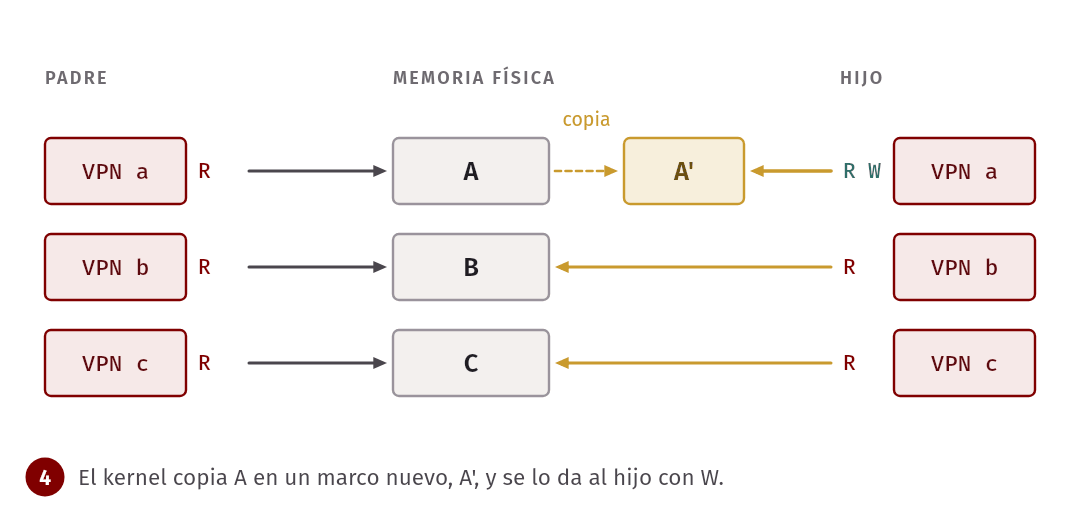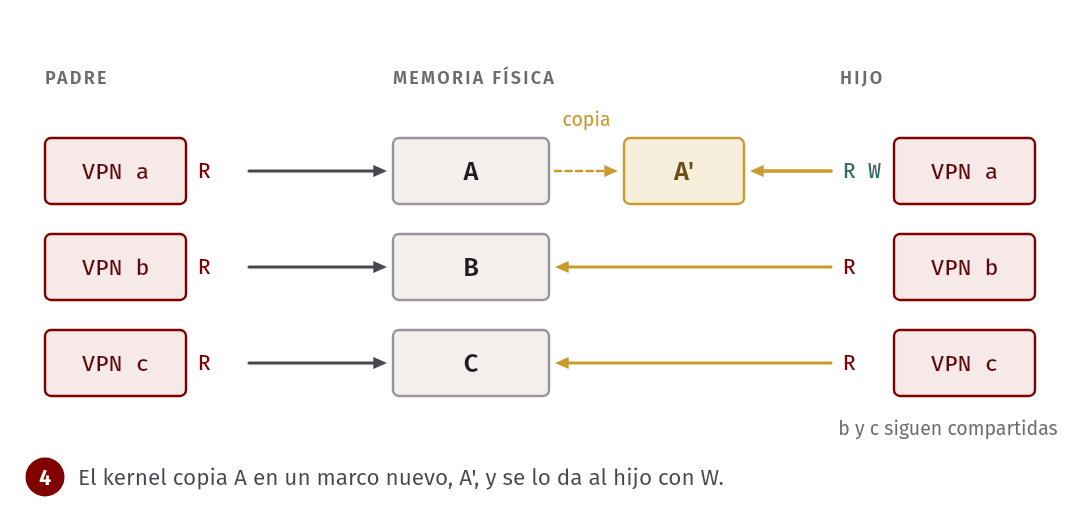
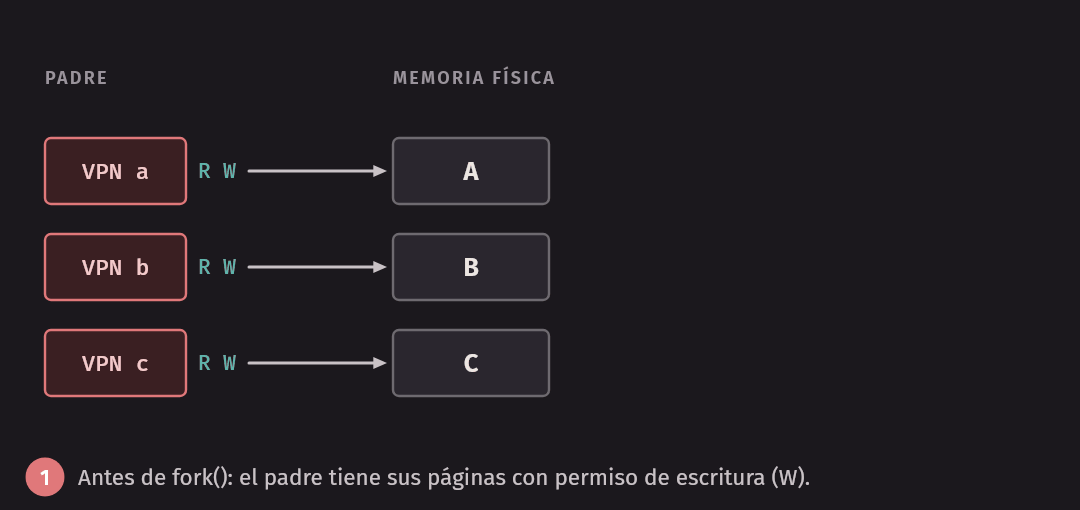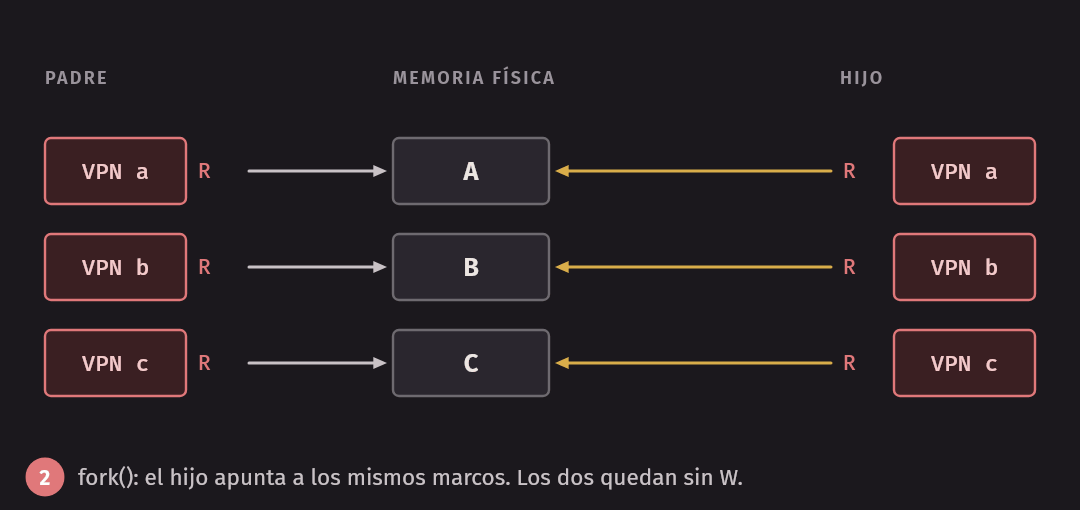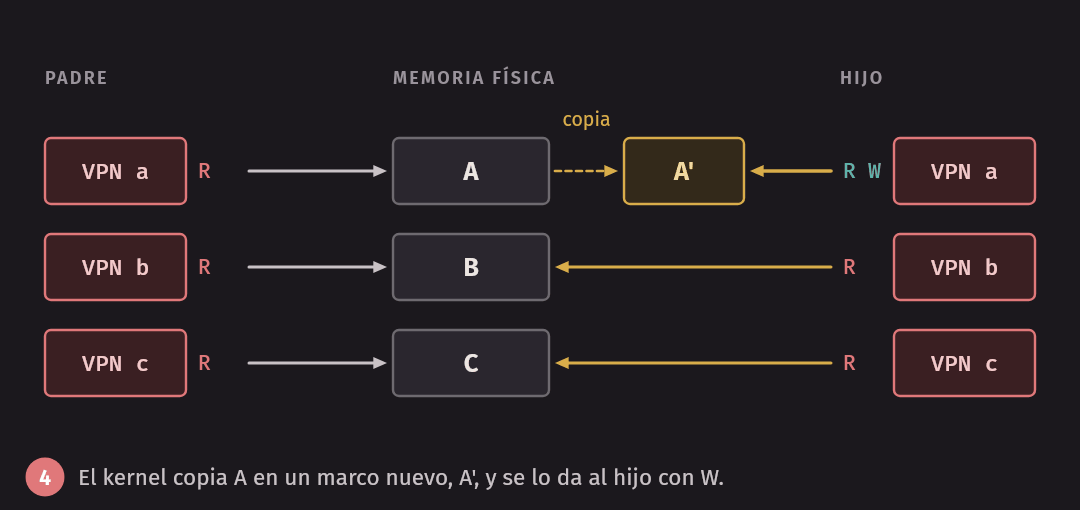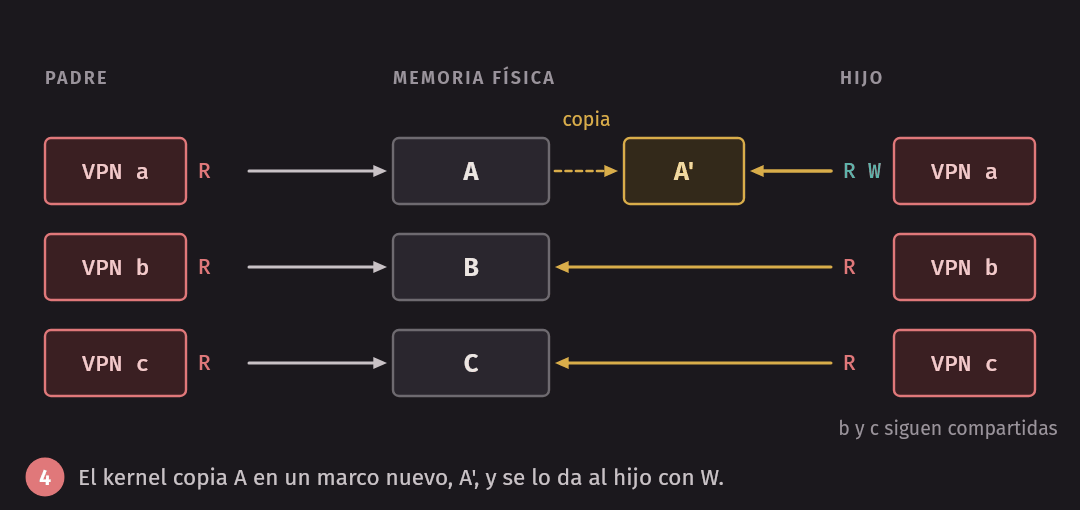
memtouch). - Copy-on-write (COW): “copiar” una página es mapearla en ambos espacios
como solo lectura. Cuando alguien escribe, hay un fallo; el kernel copia
la página, le da al que escribió su copia escribible y reintenta. Con
fork()seguido deexec()casi nada se copia.
Linux
En Linux el kernel está mapeado en la parte alta de todos los procesos (en
x86 de 32 bits, el último GB; en x86-64, la mitad alta de 48 bits). Tiene
direcciones lógicas (kmalloc), que son la memoria física con un
desplazamiento fijo, contiguas y fuera del swap (sirven para DMA), y
direcciones virtuales (vmalloc), páginas sueltas que solo parecen
contiguas.
Páginas enormes (huge pages). Una TLB de 64 entradas cubre 256 KB con
páginas de 4 KB y 128 MB con páginas de 2 MB. Linux las usa solo, con las
transparent huge pages (THP), activadas en el contenedor: con el argumento
huge, la primera pasada de memtouch 200 da 102 fallos en vez de 51 202 y
es 9 veces más rápida. El costo: fragmentación interna y swap más caro.
Page cache. La RAM que sobra guarda páginas de archivos. Con LRU puro, un
cat de un archivo gigante expulsaría todo lo útil; Linux usa una variante de
2Q: la página entra a la lista inactiva y solo sube a la activa si
se vuelve a usar. Las víctimas salen de la inactiva, con un algoritmo tipo
reloj:
$ grep '(file)' /proc/meminfo
Active(file):     620384 kB
Inactive(file):  4426808 kB
Seguridad. Además de ASLR (semana 5) y KASLR para el kernel, en 2018 se publicó Meltdown: en algunas CPU, la ejecución especulativa permitía leer memoria del kernel desde modo usuario, porque estaba mapeada en cada proceso. La defensa es KPTI (kernel page-table isolation): dos tablas por proceso, y en modo usuario casi nada del kernel está mapeado, a costa de cambiar de tabla en cada trap. La CPU ARM del contenedor no es vulnerable.
En xv6. xv6-riscv siempre funcionó como Linux con KPTI: el kernel tiene su propia tabla de páginas y cada proceso la suya, sin el kernel. La única página mapeada en ambas es
trampoline: el código dekernel/trampoline.Scambia el registrosatp(la tabla activa) al entrar y al salir de cada trap.
Fallos de página en xv6-riscv
xv6 no tiene swap: si se acaba la memoria, kalloc() retorna 0. Pero atiende
fallos de página para reservar memoria de forma perezosa (lazy
allocation). En usertrap() (kernel/trap.c), scause da la causa del trap
(8 llamada al sistema, 13 fallo al leer, 15 fallo al escribir) y
stval la dirección que falló:
  } else if ((r_scause() == 15 || r_scause() == 13) &&
             vmfault(p->pagetable, p->sz, r_stval(),
                     (r_scause() == 13) ? 1 : 0) != 0) {
    // page fault on lazily-allocated page
  } else {
    // ... imprime scause, sepc y stval
    setkilled(p);
  }
Si vmfault() no resuelve el fallo, el proceso muere; un fallo al
ejecutar (scause 12) muere directo. La reserva perezosa empieza en
sys_sbrk() (kernel/sysproc.c): sbrklazy(n) pasa SBRK_LAZY y solo suma
n a p->sz. (sbrk(n) usa SBRK_EAGER y reserva de inmediato, así que el
malloc de xv6 no es perezoso.) Al tocar esa memoria, vmfault() en
kernel/vm.c hace el resto:
  if (va >= psz)
    return 0;
  va = PGROUNDDOWN(va);
  if (ismapped(pagetable, va)) {
    return 0;
  }
  mem = (uint64)kalloc();
  if (mem == 0)
    return 0;
  memset((void *)mem, 0, PGSIZE);
  if (mappages(pagetable, va, PGSIZE, mem, PTE_W | PTE_U | PTE_R) != 0) {
    kfree((void *)mem);
    return 0;
  }
  return mem;
Bajo sz y sin mapear: reserva un marco, lo llena de ceros (demand
zeroing), lo mapea y la instrucción se reintenta. El argumento read no se usa
en este commit, y copyin()/copyout() también llaman a vmfault(), porque
el kernel puede tocar memoria perezosa (por ejemplo, en un read()) sin pasar
por usertrap.
En xv6. El bono del curso es el lab
cowdel MIT: fork con copy-on-write. Hoykfork()(kernel/proc.c) llama auvmcopy(), que hacekallocymemmovede cada página del padre. Y una escritura en una página mapeada sinPTE_Wllega avmfault(), que retorna 0 porque la página ya está mapeada: el proceso muere. El lab cambia exactamente esos dos puntos:uvmcopy()comparte los marcos, quitaPTE_Wy marca las PTE con un bitRSW; y el manejo descause15 copia la página al primer intento de escritura. Además hay que contar referencias por marco enkernel/kalloc.cpara liberar un marco solo cuando nadie lo usa.
Repaso para el examen parcial
El parcial cubre las semanas 1 a 8: procesos, ejecución directa limitada, planificación, espacio de direcciones, segmentación, paginación, TLB, tablas multinivel y swapping. Abundan los problemas de cálculo, como en los simuladores de OSTEP. Un ejemplo de cada tipo:
- Planificación. A, B y C llegan en
t = 0y duran 6, 2 y 4. Con FIFO (A, B, C) terminan en 6, 8 y 12: tiempo de retorno promedio 26/3 ≈ 8.67. Con SJF (B, C, A) terminan en 2, 6 y 12: 20/3 ≈ 6.67. - Base y límite. Base 32 KB, límite 4 KB. La dirección virtual 1000 es menor que 4096: va a 32 768 + 1000 = 33 768. La 5000 supera el límite: excepción.
- Paginación. Espacio de 16 KB, páginas de 1 KB: 14 bits, 4 de VPN y 10 de
offset.
0x0A4C=0010 1001001100: VPN 2, offset0x24C. Si la VPN 2 está en el marco 7, la física es 7 · 1024 +0x24C=0x1E4C. - TLB. 98 % de aciertos, tabla de 2 niveles, 100 ns por acceso a memoria: 0.98 · 100 + 0.02 · 300 = 104 ns.
- Reemplazo. Simular a mano OPT, FIFO, LRU y reloj, como en este capítulo.
Estudien con las preguntas de repaso de cada guía y con los simuladores usando
semillas nuevas (primero a mano, después -c). Escriban siempre el
procedimiento y las unidades.
Resumen
- El swap usa el disco para dar más memoria de la que hay. Si el bit
presente (en RISC-V,
V) está en 0, el acceso causa un fallo de página que atiende el kernel. Los fallos cuestan miles de accesos a RAM. - El demonio de swap mantiene páginas libres entre las marcas LW y HW y agrupa las escrituras.
- Con
0 1 0 2 3 0 1 4 0 3 4 0y 3 marcos: OPT 5 fallos, LRU 7, reloj 8, FIFO 9, RAND 7.45 en promedio. FIFO sufre la anomalía de Belady; LRU y OPT no. - El reloj aproxima LRU con un bit por página. Si los conjuntos de trabajo no caben, hay thrashing.
- VMS: FIFO segmentado, demand zeroing y copy-on-write. Linux: huge pages, page cache con 2Q y KPTI.
- xv6 no tiene swap, pero atiende fallos (
scause13 y 15) para la reserva perezosa convmfault().
Ejercicios
- Simulen a mano OPT, FIFO y LRU para la secuencia
0 1 2 0 1 3 0 3 1 2 1con 3 marcos. Clasifiquen cada fallo como compulsivo o de capacidad y verifiquen con./paging -p opt 0 1 2 0 1 3 0 3 1 2 1(y lo mismo confifoylru). - Simulen el reloj con la misma secuencia del ejercicio 1. ¿En qué referencia se
separa de FIFO? Verifiquen con
-p clock. - Con
T_RAM = 100 nsyT_fallo = 100 µs(un SSD), ¿qué tasa de fallos de página haría que la memoria efectiva fuera el doble de lenta? - Encuentren otra secuencia, distinta de la del capítulo, que muestre la
anomalía de Belady con FIFO. Pista: usen
./paging -p fifo -c 5para probar candidatas. Verifiquen que LRU no la sufre. - Ejecuten
memtouchen un contenedor con--memory=128my tamaños de 64, 120, 140 y 200 MB. ¿Desde qué tamaño aparecen fallos mayores? ¿Por qué no es exactamente 128 MB? - Calculen el conjunto de trabajo
W(t, 3)de la secuencia del capítulo. ¿Cuál es su tamaño máximo? ¿Cuántos marcos necesitaría LRU para no tener fallos de capacidad? - En xv6, escriban un programa de usuario que llame a
sbrklazy(4096 * 10)y toque solo la primera y la última página. ¿Cuántas veces se llama avmfault()? Verifíquenlo con unprintftemporal en el kernel.