
Apuntes · Capítulo 9Concurrencia
Máquinas virtuales e hilos
Máquinas virtuales e hilos
Durante ocho semanas vimos cómo el sistema operativo crea ilusiones: cada proceso cree tener una CPU y una memoria privadas. Esta semana cierra la parte de virtualización y abre la de concurrencia, con dos preguntas que van en sentidos opuestos.
La primera: ¿se puede hacer el mismo truco un nivel más abajo y darle a un sistema operativo entero la ilusión de tener la máquina para él? Eso hace un monitor de máquinas virtuales, la base de la nube y del entorno del curso. La segunda: ¿qué pasa si, dentro de un proceso, queremos varios flujos de ejecución que compartan la memoria? Esos son los hilos (threads), y con ellos aparece el problema central de la segunda parte del curso: las condiciones de carrera (race conditions).
Ruta de lectura.
- Antes de clase (15–20 min): «Un sistema operativo debajo del sistema operativo» e «Hilos».
- En clase: sesión A, de «Virtualizar la CPU: trap-and-emulate» a «Contenedores: aislar sin un segundo kernel» (si esta sesión pasa a lectura autónoma, se lee completa); sesión B, «La API de hilos», «Condiciones de carrera», «Exclusión mutua con un mutex» y «Esperar: variables de condición».
- Después de clase: repasar el «Resumen», leer «Concurrencia en xv6» y resolver los «Ejercicios». Para ampliar: el apéndice Virtual Machine Monitors y los cap. 25 a 27 de OSTEP, y «Popek y Goldberg, y el problema de x86».
Lectura. Este capítulo acompaña al diálogo y al apéndice Virtual Machine Monitors de OSTEP (sesión A) y a los cap. 25–27 (Dialogue on Concurrency, Concurrency: An Introduction e Interlude: Thread API, sesión B). El código está en
code/week-09y se compila conmakedentro del contenedor del curso.
Un sistema operativo debajo del sistema operativo
Un monitor de máquinas virtuales (virtual machine monitor, VMM), también llamado hipervisor (hypervisor), controla el hardware y lo reparte entre varios sistemas operativos invitados (guests). Cada invitado cree tener sus propias CPU, su memoria física y sus discos, y corre sin modificaciones: la meta es la transparencia. El VMM es un sistema operativo para sistemas operativos.
La idea es de IBM (VM/370, años 70) y volvió a fines de los 90 con Disco y VMware. Sirve para consolidar servidores, aislar sistemas, probar software y, sobre todo, para la nube: alquilar “una computadora” casi siempre es alquilar una VM. Los hipervisores de tipo 1 corren sobre el hardware (Xen, VMware ESXi, Hyper-V, Linux con KVM); los de tipo 2 son un programa sobre un OS anfitrión (host), como VirtualBox o QEMU.
Virtualizar la CPU: trap-and-emulate
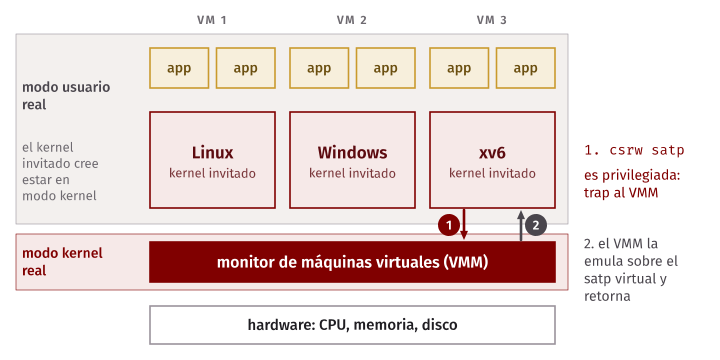
El invitado corre con la técnica de la semana 2, la ejecución directa limitada: el VMM salta a su primera instrucción y lo deja correr en la CPU. Pero el kernel invitado no puede correr en modo kernel (kernel mode): podría cambiar la tabla de páginas (page table) real o leer el disco de otra VM. Corre desprivilegiado, en modo usuario (user mode) de verdad, aunque crea estar en modo kernel; el VMM recuerda, por cada CPU virtual (vCPU), en qué modo cree estar.
Cuando el kernel invitado ejecuta una instrucción privilegiada, el hardware
hace un trap, como con cualquier programa de usuario. El trap llega al VMM,
que instaló el vector de traps real. El VMM hace en software lo que esa
instrucción habría hecho en la máquina virtual, avanza el PC del invitado y
retorna: trap-and-emulate. Cambiar de VM (machine switch) es como un
cambio de contexto (context switch), pero guardando también el estado privilegiado de la vCPU:
satp, stvec, sstatus…
Sigamos un read() de un proceso invitado:
| Paso | Quién | Qué pasa |
|---|---|---|
| 1 | Proceso invitado | Ejecuta ecall, como siempre |
| 2 | Hardware → VMM | Trap real: el VMM recibe el control |
| 3 | VMM | Salta al manejador de traps del invitado, con la vCPU en “modo S virtual” |
| 4 | Kernel invitado | Atiende read() y ejecuta sret |
| 5 | Hardware → VMM | sret es privilegiada y el invitado está en modo usuario: otro trap |
| 6 | VMM | Hace el retorno real al proceso |
El VMM conoce ese manejador porque anotó la dirección cuando el invitado,
al arrancar, intentó escribir stvec. Cada llamada al sistema (system call) cuesta dos
traps extra.
En xv6. Cada hart ejecuta al arrancar
kvminithart()enkernel/vm.c, que llama aw_satp(MAKE_SATP(kernel_pagetable))entre dossfence_vma(). Enkernel/riscv.h,w_satpes una sola instrucción:csrw satp, %0. Si xv6 fuera un invitado en un VMM clásico, esa instrucción provocaría una excepción de instrucción ilegal; el VMM guardaría el valor en elsatpvirtual, prepararía la traducción real y retornaría a la instrucción siguiente.
Popek y Goldberg, y el problema de x86
Una instrucción es privilegiada si hace trap en modo usuario, y sensible si lee o cambia el estado de la máquina: el modo, la tabla de páginas, las interrupciones (interrupts). Popek y Goldberg (1974) mostraron que trap-and-emulate funciona si toda instrucción sensible es privilegiada; si no, el VMM no se entera de algunas.
RISC-V, MIPS e IBM 370 cumplen la condición; el x86 de 32 bits no. El ejemplo
clásico es POPF: en modo usuario ignora en silencio el bit que habilita
las interrupciones, sin trap. Hubo tres salidas: traducción binaria
(VMware, 1999), que reescribe el código del kernel invitado antes de
ejecutarlo; paravirtualización (Xen, 2003); y soporte de hardware
(VT-x y AMD-V, 2005–2006), un modo de la CPU para el invitado.
Virtualizar la memoria
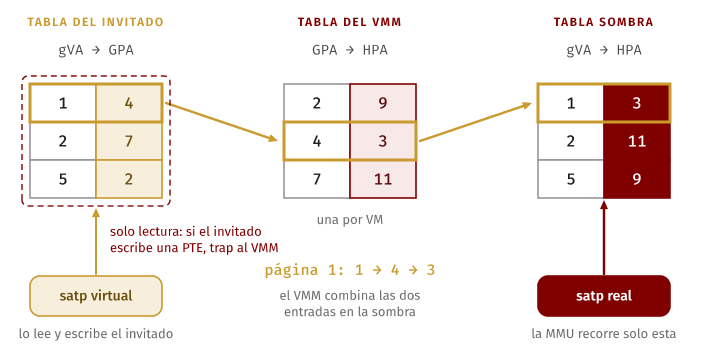
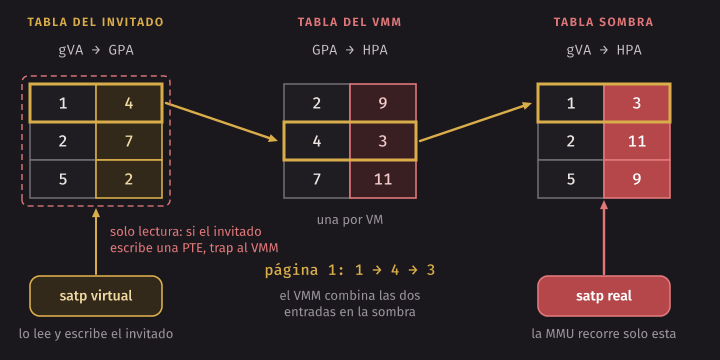
Con una VM hay tres tipos de dirección: la virtual del invitado (gVA), que traduce la tabla de páginas del kernel invitado; la física del invitado (GPA), la “memoria física” que él cree ver; y la física de la máquina (HPA), la RAM real. El VMM reparte la RAM entre las VMs y lleva, por VM, una tabla GPA → HPA.
Un proceso invitado usa las páginas virtuales 1, 2 y 5:
| gVA | 1 | 2 | 5 |
|---|---|---|---|
| GPA (tabla del invitado) | 4 | 7 | 2 |
| HPA (tabla del VMM, aplicada a esa GPA) | 3 | 11 | 9 |
La página 1 está, para el invitado, en la página física 4; y la página física 4 del invitado es, en realidad, el marco de página (page frame) 3 de la máquina. Pero la MMU sabe hacer una traducción. ¿Cómo llega de gVA a HPA?
Tablas de páginas sombra
La solución por software: el VMM combina las dos tablas en una tercera, la
tabla de páginas sombra (shadow page table), que va directo de gVA a HPA:
1 → 3, 2 → 11, 5 → 9. El satp real apunta a la sombra; el que lee y escribe
el invitado es virtual. Para que la sombra no quede vieja, el VMM marca como
solo lectura las páginas con la tabla del invitado: cuando este modifica
una PTE, hay un fallo que atiende el VMM, que actualiza ambas tablas.
Es caro. Cada escritura de una PTE del invitado es un trap (un fork escribe
cientos); aparecen fallos de página (page faults) “ocultos” que el invitado nunca ve; hace
falta una sombra por proceso invitado, y los bits A y D se sincronizan a mano.
Paginación anidada
La solución definitiva vino del hardware: la paginación anidada (nested
paging). La MMU conoce las dos tablas y las recorre ella misma, así que el
invitado cambia sus PTE y su satp sin traps. Intel la llama EPT y AMD, NPT
(2007–2008). En RISC-V es la etapa G (G-stage): vsatp apunta a la tabla del
invitado y hgatp, a la del VMM.
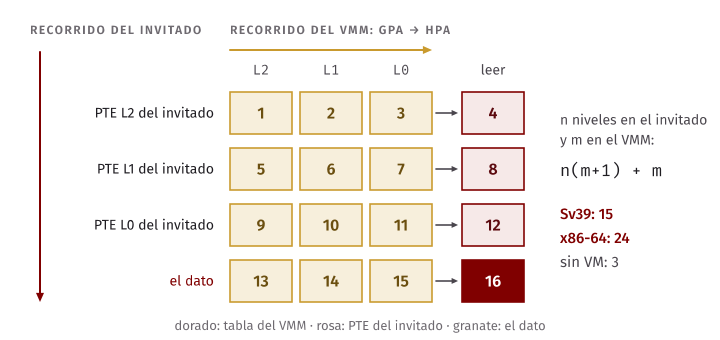
El precio se paga en los fallos de TLB. Con Sv39 en el invitado y en el VMM, el recorrido es “en dos dimensiones”:
vsatpda la raíz del invitado como GPA: 3 accesos a la tabla del VMM para traducirla y 1 para leer la PTE de nivel 2.- Esa PTE apunta a la tabla de nivel 1, otra GPA: 3 + 1.
- Lo mismo para el nivel 0: 3 + 1.
- La PTE de nivel 0 da la GPA del dato: 3 accesos más.
En total, 4 + 4 + 4 + 3 = 15 accesos para una traducción, contra 3 sin virtualización. Con n niveles en el invitado y m en el VMM son n(m+1)+m; con x86-64 (4 y 4), 4·5+4 = 24.
Idea clave. La TLB guarda la traducción final gVA → HPA. Con una tasa de aciertos alta, como vimos en la semana 7, el recorrido largo se paga muy pocas veces. Por eso ganó la paginación anidada: los fallos de TLB son raros; los traps de las tablas sombra no lo eran.
Paravirtualización
La paravirtualización abandona la transparencia a propósito: el kernel invitado sabe que es invitado y, en vez de ejecutar instrucciones que hay que atrapar, le pide al VMM lo que necesita con hiperllamadas (hypercalls). Así corría Xen antes de VT-x. También cierra la brecha de información: el VMM no sabe si el invitado está en su bucle ocioso (y le sigue dando CPU) o si va a poner en cero una página que el VMM ya limpió.
Hoy se paravirtualiza sobre todo la E/S: imitar un disco real registro por registro es lento, porque cada acceso es una salida al VMM. Con virtio, el invitado deja sus pedidos en colas en memoria compartida y avisa una vez.
En xv6. xv6 ya es un invitado paravirtual. El
Makefilearranca QEMU con-device virtio-blk-device,drive=x0,bus=virtio-mmio-bus.0, ykernel/virtio_disk.ces el driver de ese disco (“driver for qemu’s virtio disk device”). El driver arma descriptores en memoria y QEMU los atiende. Lo estudiaremos en la parte de persistencia.
Las máquinas virtuales hoy: KVM, QEMU y RISC-V
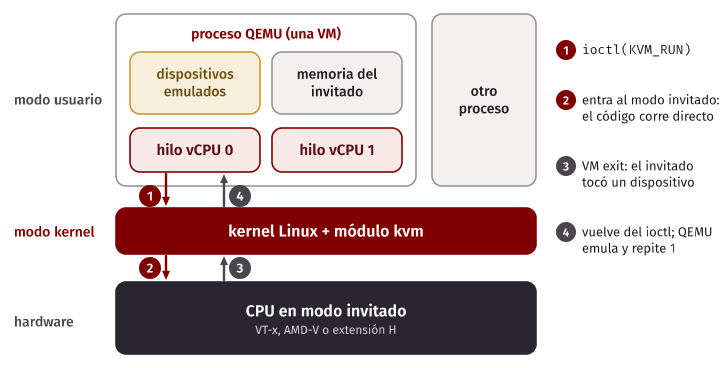
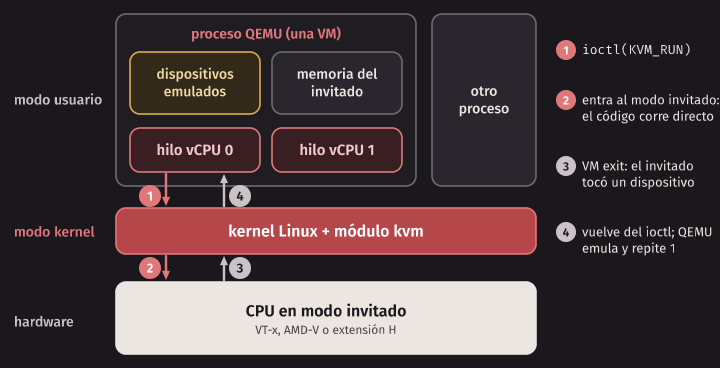
En Linux, KVM es un módulo del kernel (desde 2007) que usa el modo
invitado del hardware: con KVM, Linux es el hipervisor. QEMU es un proceso
de usuario que pone el resto: la memoria del invitado es memoria de ese
proceso y cada vCPU es un hilo que llama ioctl(KVM_RUN); el código del
invitado corre entonces directamente en la CPU. Cuando el invitado toca un
dispositivo hay una salida de la VM (VM exit), QEMU emula el dispositivo y
vuelve a entrar. Así funcionan casi todas las VMs de la nube.
En el curso usamos QEMU para correr xv6, pero sin KVM:
$ uname -m
aarch64
$ qemu-system-riscv64 -accel help
Accelerators supported in QEMU binary:
tcg
$ ls /dev/kvm
ls: cannot access '/dev/kvm': No such file or directory
KVM ejecuta el código del invitado en la CPU real, así que invitado y
anfitrión deben tener la misma arquitectura. xv6 es RISC-V y las laptops del
curso son x86-64 o arm64 (la salida es de una Mac con Apple Silicon). QEMU usa
entonces TCG, un traductor binario dinámico. No interpreta instrucción por
instrucción: toma un bloque básico de código RISC-V (una secuencia sin
saltos), lo traduce una vez a código de la CPU anfitriona, lo guarda en una
caché y lo ejecuta; la próxima vez reutiliza la traducción. Las cargas y
guardados del invitado pasan por una TLB implementada en software, y csrw,
ecall o sret se traducen a llamadas a funciones que emulan su efecto. Es
mucho más rápido que un intérprete, pero más lento que KVM.
QEMU es un proceso con varios hilos. Con xv6 corriendo con -smp 3 y la opción
-name xv6,debug-threads=on, que pone nombre a los hilos:
$ ps -L -o pid,lwp,pcpu,comm -p 437
  PID   LWP %CPU COMMAND
  437   437  0.1 qemu-system-ris
  437   438  0.0 qemu-system-ris
  437   439  6.5 CPU 0/TCG
  437   440  6.6 CPU 1/TCG
  437   441  6.3 CPU 2/TCG
  437   442  0.0 worker
Un proceso, seis hilos; tres son las harts de xv6.
RISC-V agregó virtualización por hardware con la extensión H, ratificada en
2021. El modo supervisor pasa a ser HS (kernel anfitrión e hipervisor) y
aparecen dos modos virtuales, VS para el kernel invitado y VU para sus
programas. En VS, un acceso a satp usa en su lugar vsatp: el csrw satp
de xv6 funcionaría sin trap. xv6 no la usa, pero KVM sí, en anfitriones
RISC-V.
Contenedores: aislar sin un segundo kernel
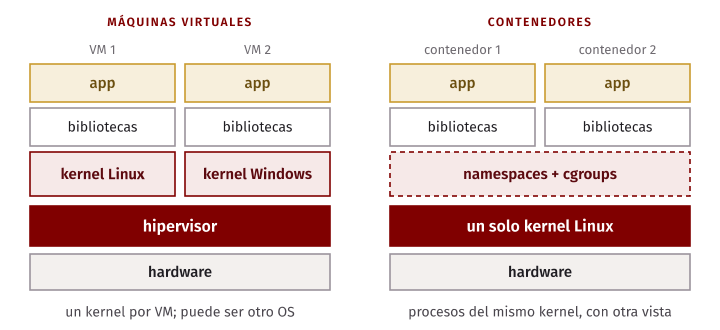
Un contenedor (container) se parece a una VM desde afuera, pero es un proceso normal del kernel anfitrión, al que el kernel le muestra una vista restringida del sistema. No hay hipervisor ni segundo kernel. Dos mecanismos de Linux lo hacen posible:
- Los namespaces deciden qué puede ver: el proceso recibe su propia
copia de un recurso global. Hay namespaces de
pid(el primer proceso es el PID 1),mnt(su árbol de archivos),net,uts(suhostname),ipc,user,cgroupytime. - Los cgroups deciden cuánto puede usar: límites y contabilidad de CPU, memoria y E/S para un grupo de procesos.
Por eso arranca en milisegundos y no gasta memoria en otro kernel, pero no puede correr otro sistema operativo, y su aislamiento depende del kernel.
Todo esto se observa dentro de sistemas-operativos:
$ uname -r
6.12.72-linuxkit
$ ls -l /proc/self/ns        # recortado: solo nombre y destino
mnt -> mnt:[4026533186]
net -> net:[4026533199]
pid -> pid:[4026533193]
user -> user:[4026531837]
uts -> uts:[4026533189]
$ cat /proc/self/cgroup
0::/
$ ps -e
  PID TTY          TIME CMD
    1 ?        00:00:00 bash
   11 ?        00:00:00 ps
En una Mac, uname -r no dice “Darwin”: el kernel es Linux, porque Docker
Desktop corre una VM Linux liviana y los contenedores viven dentro de ella (en
Windows pasa algo parecido con WSL2; en Linux nativo se ve el kernel de su
propia computadora). Cada número de /proc/self/ns identifica un namespace;
bash es el PID 1 porque en su namespace de PID no hay nadie más; y 0::/
dice que el contenedor ve la raíz de su cgroup.
Con dos contenedores vivos a la vez, A y B, y un proceso de la VM:
| Namespace | Contenedor A | Contenedor B | VM Linux |
|---|---|---|---|
| pid | 4026533193 | 4026533470 | 4026531836 |
| net | 4026533199 | 4026533472 | 4026531840 |
| uts | 4026533189 | 4026533468 | 4026531838 |
| user | 4026531837 | 4026531837 | 4026531837 |
Los namespaces de PID, red y nombre de host son distintos. El de user es el
mismo: Docker no crea uno por defecto, así que el root del contenedor es
root para el kernel. Un sleep 60 en otro contenedor es el PID 1 visto desde adentro y el PID
49346 visto desde la VM: un proceso, dos números. Y con
docker run --memory=256m --cpus=1.5, dentro del contenedor
/sys/fs/cgroup/memory.max vale 268435456 y cpu.max vale
150000 100000 (150 ms de CPU por cada 100 ms).
El entorno del curso en macOS o Windows apila, entonces: una VM Linux, el
contenedor sistemas-operativos (sin kernel propio), QEMU con TCG, el kernel
xv6 y sus programas.
Hilos
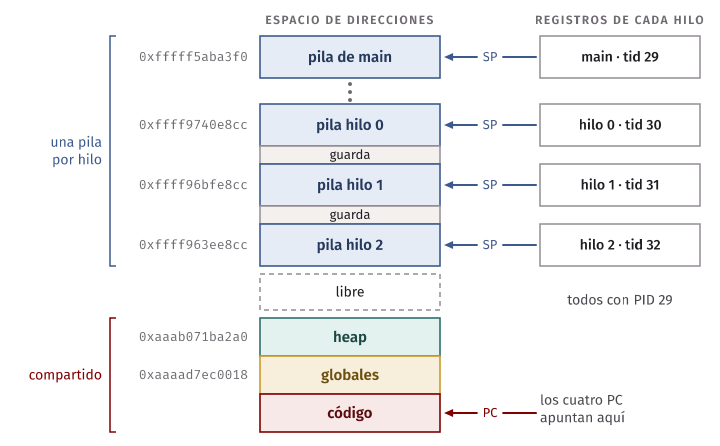
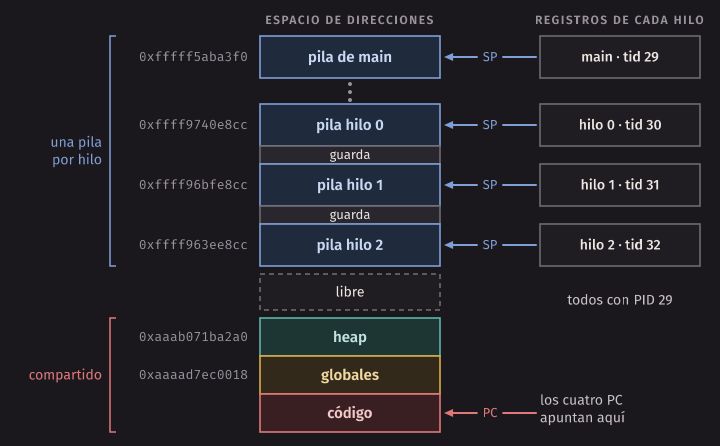
Un hilo (thread) es un flujo de ejecución dentro de un proceso. Tiene su propio contador de programa, sus registros y su pila (stack), pero comparte con los demás hilos el espacio de direcciones (address space): código, variables globales y heap. Un proceso clásico tiene un solo hilo; con varios, el espacio de direcciones tiene varias pilas. El estado de cada hilo se guarda en un TCB (thread control block), como el de un proceso en su PCB, y cambiar entre hilos del mismo proceso no cambia la tabla de páginas.
Los hilos sirven para el paralelismo (como en el proyecto P4, pzip) y
para que un hilo que espera E/S no detenga al programa. Con procesos, compartir
datos exige pipes o memoria compartida explícita; con hilos, lo que uno escribe
en el heap los demás lo ven de inmediato. Esa facilidad es la fuente de los
problemas.
| Compartido entre los hilos | Propio de cada hilo |
|---|---|
| Código, variables globales, heap | PC y registros |
| Archivos abiertos | Pila (variables locales) |
| PID, directorio actual | TID, errno, máscara de señales |
“Propio” no es “protegido”: otro hilo puede leer una pila ajena si tiene un
puntero a ella. stacks.c lo muestra; cada hilo
anota la dirección de una variable local:
$ ./stacks 3
global       0xaaaad7ec0018
heap         0xaaab071ba2a0
main  local  0xfffff5aba3f0   pid 29  tid 29
hilo 0 local  0xffff9740e8cc   pid 29  tid 30
hilo 1 local  0xffff96bfe8cc   pid 29  tid 31   (a 8256 KiB del hilo 0)
hilo 2 local  0xffff963ee8cc   pid 29  tid 32   (a 8256 KiB del hilo 1)
La global y el heap tienen una dirección para todos; las locales están en
pilas separadas por unos 8 MiB (ulimit -s) más una zona de guarda, aunque el
número exacto depende de la máquina. Mismo PID, distinto TID: para Linux cada
hilo es una tarea que se planifica aparte. Los hilos esperan en una
barrera (pthread_barrier_wait) para estar vivos a la vez; sin ella, la
biblioteca podría reutilizar la pila de un hilo ya terminado.
La API de hilos
Los hilos POSIX (pthreads) se compilan con gcc -pthread:
int pthread_create(pthread_t *thread, const pthread_attr_t *attr,
                   void *(*start_routine)(void *), void *arg);
int pthread_join(pthread_t thread, void **value_ptr);
pthread_create crea un hilo que ejecuta start_routine(arg); attr casi
siempre es NULL. La función recibe y devuelve void *, así que se puede
pasar un puntero a cualquier tipo. pthread_join espera a que el hilo termine
y deja en *value_ptr lo que devolvió: es el wait() de los hilos. Ambas
devuelven 0 si todo salió bien. Después de crear un hilo no hay orden
garantizado: lo decide el planificador (scheduler).
En args.c, varios hilos suman partes de
1 + 2 + … + N. Cada uno recibe un struct con su rango y devuelve otro, en el
heap, con su suma:
static void *sum_range(void *arg) {
    task_t *t = arg;                    // void * -> puntero al tipo real
    result_t *r = malloc(sizeof(*r));   // en el heap: sobrevive al hilo
    r->sum = 0;
    for (long i = t->from; i <= t->to; i++)
        r->sum += i;
    return r;
}
Con ./args 100 3, los hilos suman 561, 1650 y 2839 (sus líneas salen en
cualquier orden) y main obtiene 5050.
Dos errores clásicos: devolver un puntero a la pila del hilo (return &r
con r local), que deja a join con una dirección inválida; y pasar &i,
el contador del bucle, a todos los hilos, que leen la misma variable cuando
quizás ya cambió. Por eso args.c usa un arreglo con un task_t por hilo.
Condiciones de carrera
race.c lanza varios hilos que incrementan un
contador compartido:
static volatile long counter = 0;

static void *worker_nolock(void *arg) {
    for (long i = 0; i < loops; i++)
        counter++;
    return NULL;
}
$ ./race nolock 1 1000000
nolock hilos=1 esperado=1000000 obtenido=1000000 OK 0.001 s
$ ./race nolock 4 1000000
nolock hilos=4 esperado=4000000 obtenido=1928101 MAL 0.006 sCon cuatro hilos se pierde más de la mitad, y el número cambia en cada
ejecución. make asm compila counter.c con el compilador
cruzado de RISC-V del contenedor y muestra por qué:
increment:
    lla   a4,.LANCHOR0
    ld    a5,0(a4)
    addi  a5,a5,1
    sd    a5,0(a4)
    ret
counter++ son tres instrucciones: cargar (ld), sumar (addi) y
guardar (sd). Y cada hilo tiene su propio a5, porque los registros son
parte del estado de cada hilo. Con dos hilos en una CPU y el contador en 7:
| Paso | Hilo 1 | a5 de H1 |
Hilo 2 | a5 de H2 |
counter |
|---|---|---|---|---|---|
| 1 | ld a5,0(a4) |
7 | 7 | ||
| 2 | addi a5,a5,1 |
8 | 7 | ||
| interrupción: se guardan los registros de H1 | |||||
| 3 | ld a5,0(a4) |
7 | 7 | ||
| 4 | addi a5,a5,1 |
8 | 7 | ||
| 5 | sd a5,0(a4) |
8 | 8 | ||
interrupción: vuelve H1 con su a5 = 8 |
|||||
| 6 | sd a5,0(a4) |
8 | 8 |
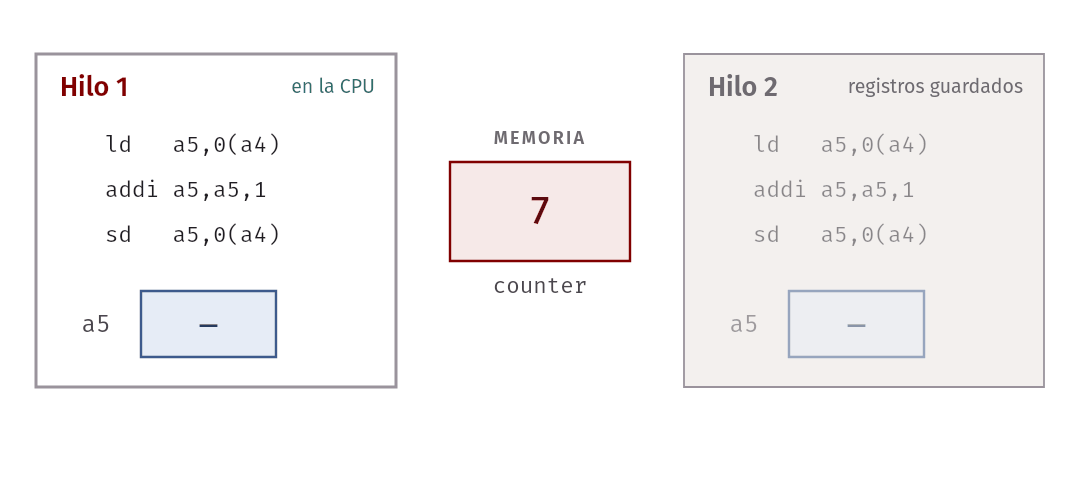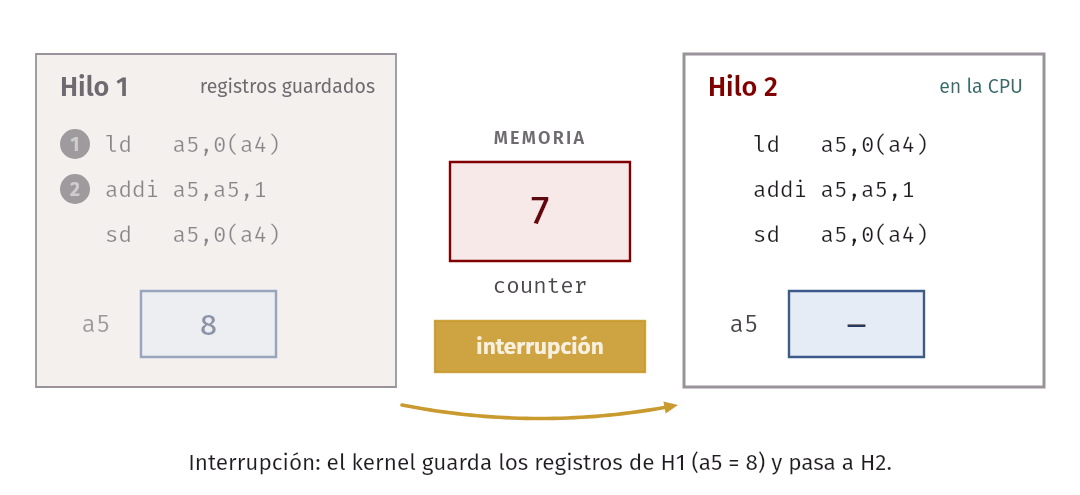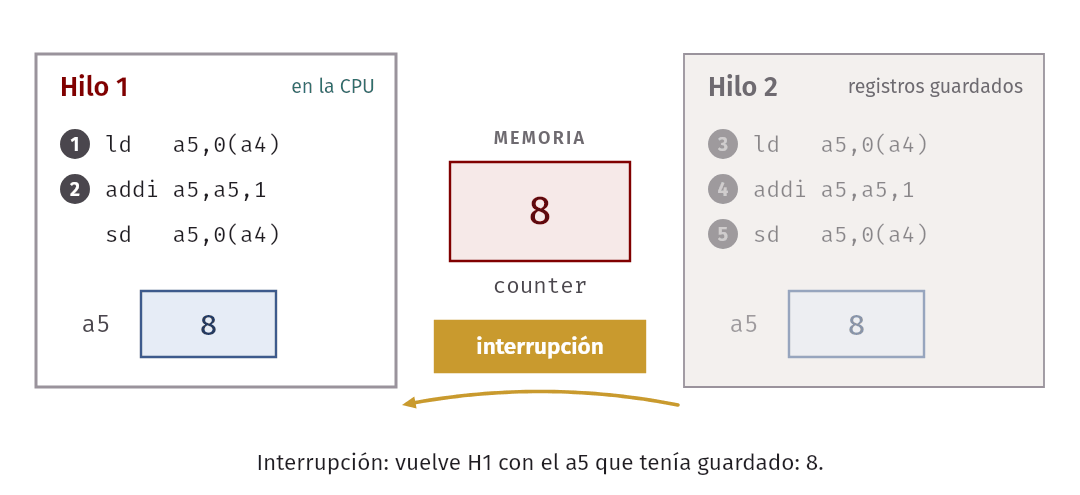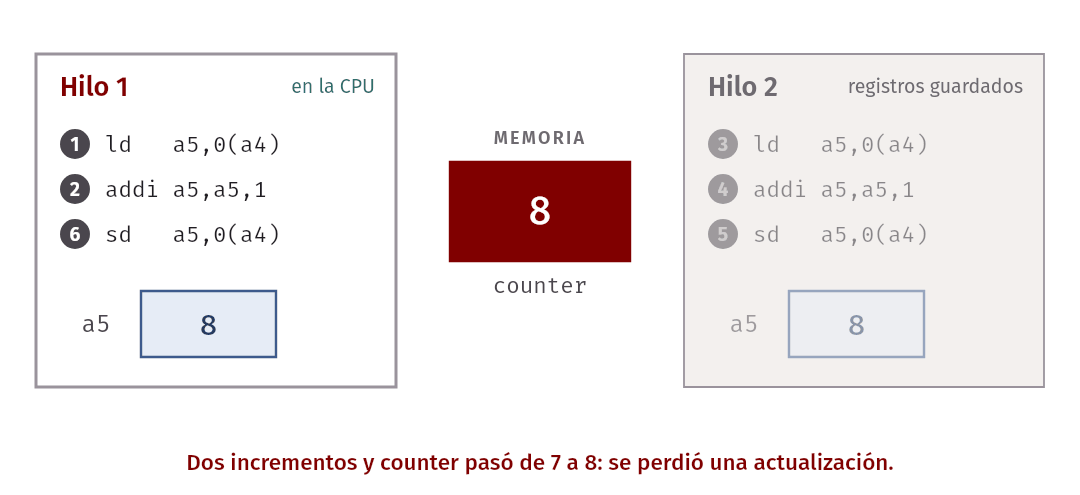
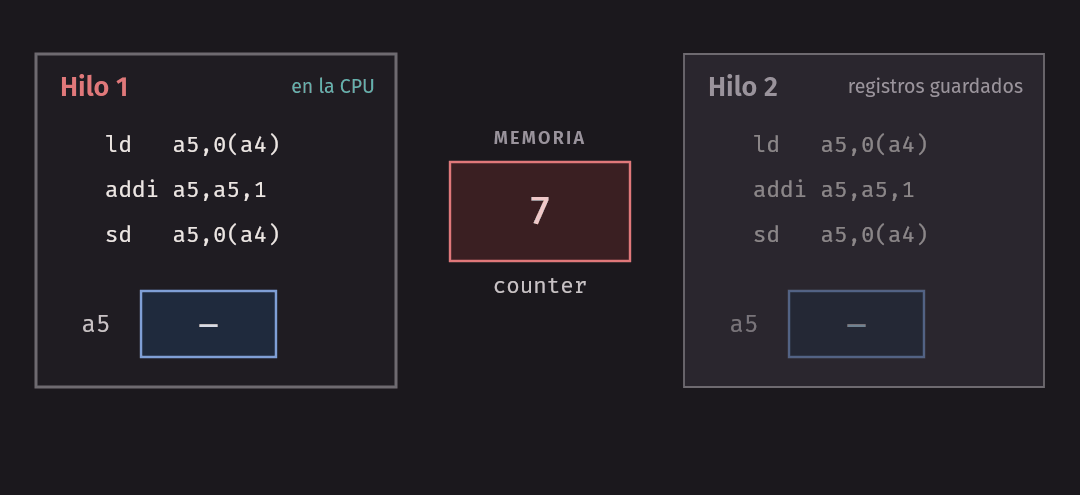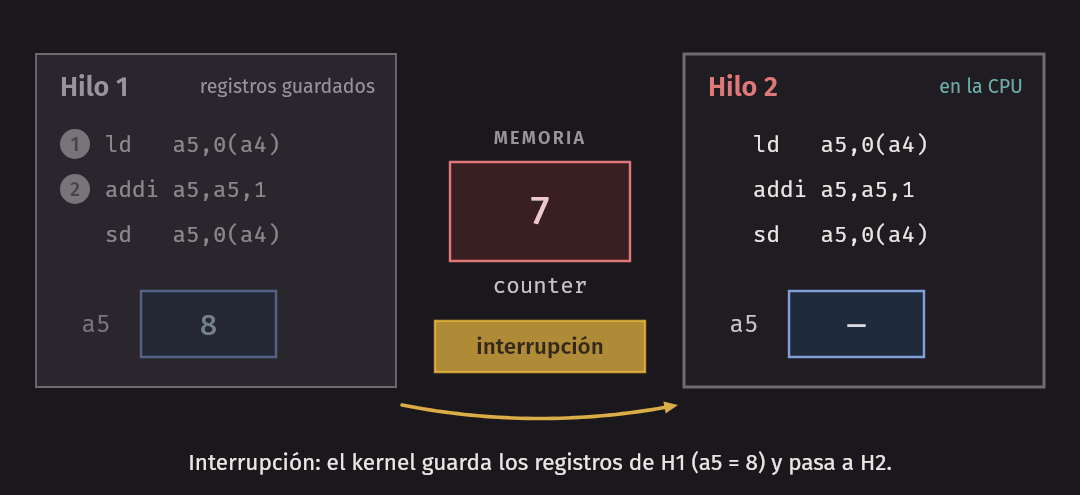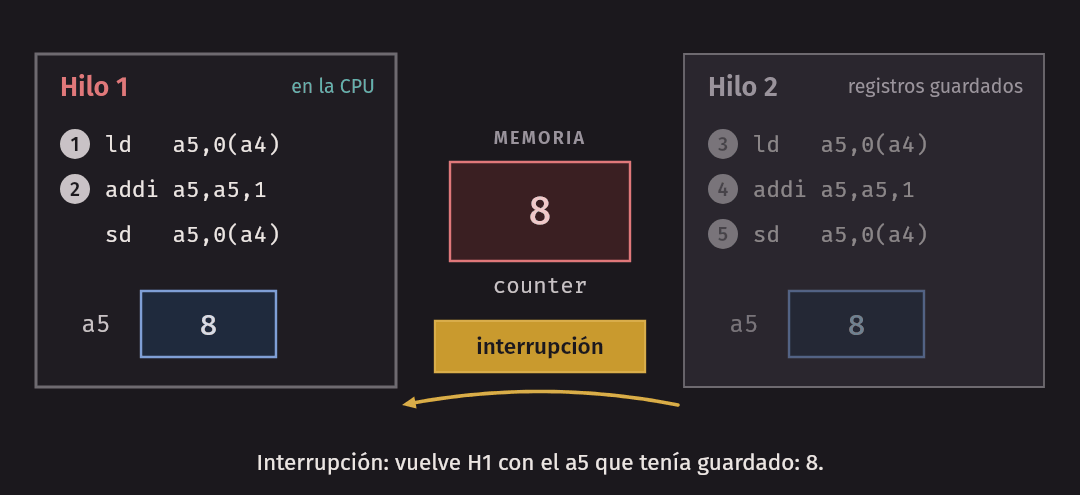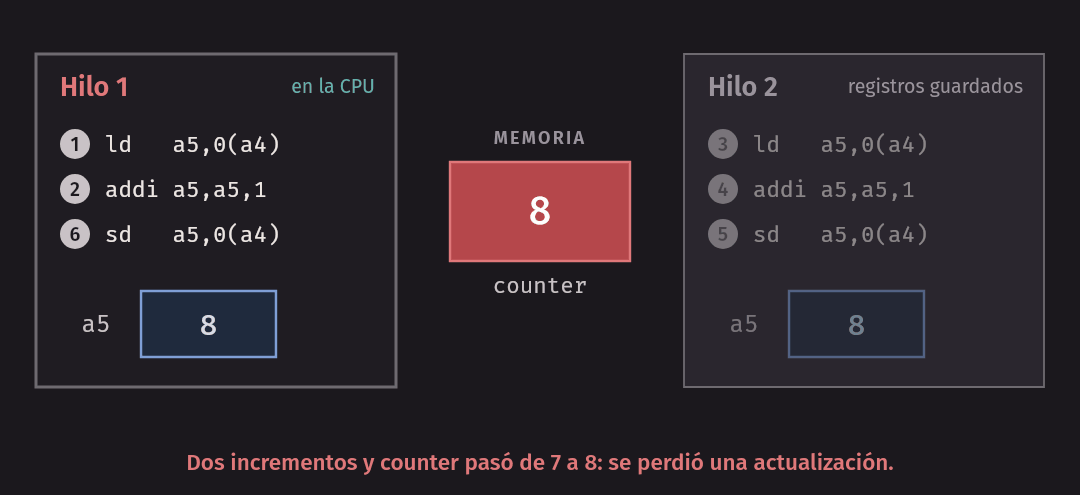
Dos incrementos y el contador subió de 7 a 8: se perdió una actualización. Con
varias CPU ni siquiera hace falta la interrupción: los dos ld pueden ocurrir
en el mismo instante. volatile no lo arregla: solo obliga al compilador a ir
a memoria en cada vuelta, pero siguen siendo tres instrucciones.
El vocabulario de esta parte del curso:
- Condición de carrera (race condition): el resultado depende del orden en que se intercalan los hilos; el programa es no determinista.
- Sección crítica (critical section): código que accede a un recurso
compartido y que no deben ejecutar dos hilos a la vez. Aquí,
counter++. - Exclusión mutua (mutual exclusion): si un hilo está en la sección crítica, ningún otro entra.
- Atomicidad: un grupo de operaciones ocurre “todo o nada”; nadie ve un estado intermedio.
Idea clave. La concurrencia plantea dos problemas distintos: la atomicidad (que nadie se meta en medio), que se resuelve con locks, y la espera (no seguir hasta que otro haga algo), que se resuelve con variables de condición (condition variables).
Exclusión mutua con un mutex
Un mutex es un lock: la sección crítica va entre pthread_mutex_lock y
pthread_mutex_unlock; si otro hilo tiene el lock, se espera.
static pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;
// ...
pthread_mutex_lock(&lock);    // inicio de la sección crítica
counter++;
pthread_mutex_unlock(&lock);  // fin de la sección crítica
Con 4 hilos y diez millones de vueltas cada uno (./race <modo> 4 10000000):
| Modo | Obtenido (esperado 40 000 000) | Tiempo |
|---|---|---|
nolock |
12 621 040 | 0.039 s |
mutex |
40 000 000 | 1.342 s |
local |
40 000 000 | 0.007 s |
El mutex corrige el resultado, pero es unas 35 veces más lento: en cada
vuelta los cuatro hilos se pelean por el lock. Sin competencia es barato
(./race mutex 1 1000000 tarda unos 0.006 s). El modo local muestra la
salida: cada hilo cuenta en una variable de su pila y toma el lock una
vez al final. Primero correcto; después, compartir menos. Lo retomaremos en
la semana 10. Los números cambiarán en su máquina.
Esperar: variables de condición
Para que un hilo espere a que otro haga algo están las variables de
condición. En cond.c,
main espera a que otro hilo prepare un dato:
// hilo que espera (main)
pthread_mutex_lock(&lock);
while (!ready)
    pthread_cond_wait(&ready_cv, &lock);  // suelta el lock y duerme
pthread_mutex_unlock(&lock);

// hilo que avisa (producer)
pthread_mutex_lock(&lock);
data = 42;
ready = 1;
pthread_cond_signal(&ready_cv);
pthread_mutex_unlock(&lock);
pthread_cond_wait se llama con el lock tomado: lo suelta y duerme en un solo
paso, y al despertar lo vuelve a tomar. Lo que importa es el estado
(ready); la variable de condición solo sirve para dormir y despertar. Se
espera con while, no con if: al despertar, el estado puede haber
cambiado de nuevo, y existen despertares espurios. Quien avisa cambia el
estado y luego hace signal, con el lock tomado; un signal sin nadie
esperando se pierde, pero el estado queda escrito.
Errores comunes: girar sobre una bandera sin lock
(while (ready == 0) ;), olvidar inicializar el mutex, salir con un return
sin unlock o proteger un dato con dos locks distintos. Para encontrar
carreras está helgrind:
$ valgrind --tool=helgrind ./race nolock 2 1000
==13== Possible data race during read of size 8 at 0x128018 by thread #3
==13==    at 0x108BB0: worker_nolock (race.c:23)
...
==13== ERROR SUMMARY: 2 errors from 2 contexts (suppressed: 1 from 1)
Señala race.c:23, el counter++. Con mutex, reporta 0 errors.
Concurrencia en xv6
En xv6. xv6 no tiene hilos de usuario. Cada
struct proc(kernel/proc.h) tiene un solotrapframe, uncontexty una pila de kernel (kstack): un proceso es un hilo. Pero el kernel sí es concurrente: elMakefiledefineCPUS := 3y arranca QEMU con-smp 3, y enkernel/main.clas harts 1 y 2 esperan a que la 0 termine de inicializar, imprimenhart 1 startingyhart 2 starting, y desde ahí tres CPU ejecutan el kernel sobre las mismas estructuras.
El caso más parecido a nuestro contador es allocpid() en kernel/proc.c:
  acquire(&pid_lock);
  pid = nextpid;
  nextpid = nextpid + 1;
  release(&pid_lock);
nextpid = nextpid + 1 es counter++: sin pid_lock, dos fork() en dos
harts podrían recibir el mismo PID. pid_lock es un struct spinlock, y
el corazón de acquire() en kernel/spinlock.c es:
  while (__atomic_exchange_n(&lk->locked, 1, __ATOMIC_ACQUIRE) != 0)
    ;
__atomic_exchange_n se compila a amoswap.w.aq, una instrucción atómica de
RISC-V que escribe 1 y devuelve el valor anterior en un solo paso. Si devolvió
1, otro tenía el lock y hay que reintentar, girando (spinning). Antes,
push_off() apaga las interrupciones de esa CPU; release() hace lo inverso
con __atomic_store_n(&lk->locked, 0, __ATOMIC_RELEASE). Por qué hace falta
cada pieza es el tema de la semana 10.
Resumen
- Un VMM virtualiza la máquina con ejecución directa limitada: el kernel invitado corre desprivilegiado y sus instrucciones privilegiadas se atrapan y emulan. Requiere que toda instrucción sensible sea privilegiada; x86 no lo cumplía y se resolvió con traducción binaria, paravirtualización y VT-x/AMD-V.
- La memoria tiene tres niveles, gVA → GPA → HPA. Las tablas sombra los combinan por software con muchos traps; la paginación anidada lo hace en hardware, con fallos de TLB de hasta 15 accesos (Sv39) o 24 (x86-64).
- La paravirtualización hace cooperar al invitado; hoy se usa sobre todo para E/S con virtio, como el disco de xv6.
- KVM ejecuta al invitado en el hardware; nuestro QEMU emula RISC-V con TCG. Un contenedor es un proceso con namespaces y cgroups, sobre el mismo kernel.
- Un hilo tiene PC, registros y pila propios, y comparte el resto del
proceso.
counter++son tres instrucciones: sin exclusión mutua se pierden actualizaciones. Mutex para la atomicidad; variables de condición, conwhile, para esperar. - xv6 no tiene hilos de usuario, pero su kernel corre en varias harts y usa spinlocks.
Ejercicios
- Dos hilos ejecutan
counter++tres veces cada uno, desde 0. Conld/addi/sd, construyan un intercalado que termine en 2. ¿Puede terminar en 1? - Un VMM usa paginación anidada con Sv39; el invitado usa Sv48 (cuatro niveles). ¿Cuántos accesos cuesta un fallo de TLB en el peor caso? Dibujen la grilla.
- La tabla de un invitado traduce gVA 0 → GPA 6 y gVA 3 → GPA 1; la del VMM, GPA 1 → HPA 20 y GPA 6 → HPA 8. Escriban la tabla sombra. Si el invitado cambia gVA 3 → GPA 6, ¿qué hace el VMM?
- Agreguen a
race.cun modoatomiccon__atomic_fetch_add(&counter, 1, __ATOMIC_RELAXED). Midan con 1, 2 y 4 hilos y compárenlo conmutexylocal. - Quiten la barrera de
stacks.cy haganpthread_joinde cada hilo justo después de crearlo. ¿Qué direcciones aparecen? ¿Por qué? - Cambien el
whiledecond.cpor unif. Describan un escenario con dos hilos que esperan y uno que avisa en el que eliffalla. - Comparen
docker run --rm --pid=host sistemas-operativos ps -e | headconps -een un contenedor normal. ¿Quién es el PID 1 en cada caso? - ¿Qué hardware y qué anfitrión harían falta para correr xv6 con KVM?