
Apuntes · Capítulo 10Concurrencia
Locks y estructuras de datos concurrentes
Locks y estructuras de datos concurrentes
La semana pasada vimos que dos hilos que hacen counter++ sobre la misma
variable pierden sumas, y que la solución es rodear la sección crítica
(critical section) con pthread_mutex_lock y pthread_mutex_unlock. Este
capítulo abre esa caja: ¿cómo se construye un lock? Con loads y stores
normales es muy difícil, así que el hardware ofrece instrucciones atómicas y el
sistema operativo aporta lo que falta para no desperdiciar la CPU esperando. En
la segunda mitad usamos locks para construir contadores, listas, colas y tablas
hash, y preguntamos si escalan: si con más hilos y CPUs se hace más trabajo
por segundo.
Ruta de lectura.
- Antes de clase (15–20 min): «Qué le pedimos a un lock», «Deshabilitar las interrupciones» y «Una bandera», de «Primeros intentos», y «Test-and-set».
- En clase: sesión A, «Primeros intentos», «Ayuda del hardware» y «Sin girar tanto»; sesión B, «Estructuras de datos con locks» y «Locks en xv6-riscv».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 28 y 29, «El algoritmo de Peterson» y «Linux: futex».
Lectura. OSTEP cap. 28 Locks y cap. 29 Lock-based Concurrent Data Structures. El código está en
code/week-10. Los números se midieron en el contenedor del curso con 14 CPUs (Apple M4 Max,aarch64); en otra máquina cambian, pero las tendencias no.
Qué le pedimos a un lock
Un lock es una variable con dos estados, libre o tomado. lock() lo
toma si está libre y, si no, espera; unlock() lo deja libre. La garantía es la
exclusión mutua (mutual exclusion): nunca hay dos hilos dentro de la sección
crítica a la vez. Para comparar diseños usaremos tres criterios:
corrección (¿garantiza la exclusión mutua en cualquier intercalado?),
equidad (fairness: ¿todo hilo que espera termina entrando, o alguno sufre
inanición, starvation?) y rendimiento (¿cuánto cuesta sin competencia, con
varios hilos en una CPU y en varias CPUs?). Ningún diseño gana en los tres.
Primeros intentos
Deshabilitar las interrupciones
En una máquina con una sola CPU, otro hilo solo puede meterse en medio de una
sección crítica si hay un cambio de contexto, y los involuntarios llegan con la
interrupción del reloj. La solución más antigua es apagar las interrupciones al
entrar y encenderlas al salir (DisableInterrupts() en lock,
EnableInterrupts() en unlock). Tiene problemas serios: es una operación
privilegiada (un programa con un lazo infinito dentro colgaría la máquina),
no sirve con varias CPUs (apagar las de la CPU 0 no detiene a la CPU 1) y
se pueden perder interrupciones, como el aviso de que terminó una lectura
del disco. Aun así, el kernel lo usa, pero además de un lock y no en lugar de
él; lo veremos en xv6 al final del capítulo.
Una bandera
La idea natural es una variable busy: mirar si está en 0 y, si lo está,
ponerla en 1.
int busy = 0;

void lock(void) {
    while (busy == 1)
        ;          // esperar girando
    busy = 1;
}
void unlock(void) { busy = 0; }
Esperar en un lazo que solo vuelve a mirar se llama girar (spin-waiting).
El problema es que mirar y tomar son dos pasos separados. El hilo 1 ve
busy == 0 y sale del while; antes de escribir 1, hay un cambio de contexto.
El hilo 2 también ve 0, escribe 1 y entra. Cuando el hilo 1 vuelve, escribe 1
(ya era 1) y entra también: dos hilos dentro.
No es teórico: en el modo flag de peterson.c,
dos hilos que suman un millón de veces cada uno pierden entre 800 000 y 980 000
sumas (flag: perdidas 812735 de 2000000). Con dos CPUs ni siquiera hace falta
un cambio de contexto.
El algoritmo de Peterson
En 1981 Gary Peterson publicó una solución para dos hilos que usa solo loads y
stores. Cada hilo tiene una bandera “quiero entrar” y hay una variable turn
para desempatar:
int flag[2];
int turn;

void lock(int me) {
    int other = 1 - me;
    flag[me] = 1;      // quiero entrar
    turn = other;      // pero te cedo el paso
    while (flag[other] == 1 && turn == other)
        ;              // esperar
}
void unlock(int me) { flag[me] = 0; }
Si solo un hilo quiere entrar, flag[other] vale 0 y pasa. Si los dos
quieren, los dos escriben turn, pero queda el valor del último que
escribió, que le cedió el paso al otro: entra el primero. Hay exclusión mutua y
no hay inanición.
Pero hay una suposición escondida: que cuando un hilo escribe flag[me] = 1 y
luego lee flag[other], su escritura ya es visible para el otro. Eso se llama
consistencia secuencial, y las CPUs modernas no la ofrecen. Cada núcleo
tiene un store buffer donde las escrituras esperan antes de llegar a la
caché compartida, mientras la CPU sigue ejecutando; una lectura posterior a
otra dirección puede adelantarse. Los dos hilos escriben su bandera (en su
buffer), leen la del otro (todavía 0 en memoria) y entran. x86 permite este
reordenamiento; ARM y RISC-V, varios más.
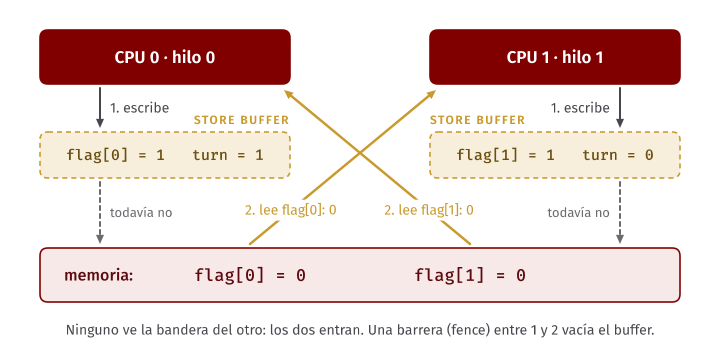
La solución es una barrera de memoria (memory fence) entre las escrituras y
las lecturas, que obliga a vaciar el store buffer. En C11 es
atomic_thread_fence(memory_order_seq_cst); en ARM se compila a dmb ish y en
RISC-V a fence rw,rw:
$ ./peterson peterson
peterson: perdidas 24 de 2000000
$ ./peterson peterson
peterson: perdidas 4 de 2000000
$ ./peterson fence
fence: perdidas 0 de 2000000
Sin barrera, el error aparece pocas veces: pasa las pruebas y falla después.
Idea clave. No construyan locks con loads y stores comunes: el compilador y la CPU reordenan accesos a memoria. Usen las instrucciones atómicas, que vienen con las barreras correctas.
Ayuda del hardware
Test-and-set
El problema de la bandera es que mirar y tomar son dos pasos. La solución del hardware es una instrucción que haga los dos atómicamente. Test-and-set (o atomic exchange) escribe un valor nuevo y devuelve el viejo, sin que ninguna otra CPU pueda meterse en medio:
int TestAndSet(int *p, int new) {   // todo esto, atómico
    int old = *p;
    *p = new;
    return old;
}
Con ella, el spinlock es directo: escribir 1 y mirar qué había. Si había 0, el
lock estaba libre y ahora es nuestro; si había 1, otro lo tiene y seguimos
girando. Así está en locks.h, con atómicos de C11:
typedef struct { atomic_int locked; } tas_lock;

static inline void tas_acquire(tas_lock *l) {
    while (atomic_exchange_explicit(&l->locked, 1, memory_order_acquire) == 1)
        cpu_relax();
}
static inline void tas_release(tas_lock *l) {
    atomic_store_explicit(&l->locked, 0, memory_order_release);
}
memory_order_acquire impide que los accesos de la sección crítica se adelanten
a la toma del lock y memory_order_release, que se atrasen después de
soltarlo: las barreras vienen incluidas. cpu_relax() es solo una pista para
el procesador (yield en ARM, pause en x86).
Evaluemos este spinlock. Es correcto: el intercambio atómico deja pasar a uno solo. No es justo: nada decide quién gana cuando se libera, y un hilo puede perder siempre. En una CPU rinde mal: si el owner es desalojado dentro de la sección crítica, cada uno de los otros gira su quantum completo; además, solo funciona con un planificador apropiativo (preemptive), porque sin interrupciones del reloj el que gira no soltaría nunca la CPU. En varias CPUs es razonable si la sección crítica es corta y hay como mucho un hilo por CPU.
Compare-and-swap y LL/SC
Compare-and-swap (CAS) escribe el valor nuevo solo si la variable todavía tiene el valor esperado, y devuelve lo que había:
int CompareAndSwap(int *p, int expected, int new) {  // atómico
    int actual = *p;
    if (actual == expected)
        *p = new;
    return actual;
}
Para un spinlock da lo mismo que test-and-set, pero es más poderosa: permite actualizar estructuras sin locks (lock-free): leer, calcular el valor nuevo e intentar escribirlo con CAS, reintentando si otro hilo lo cambió.
RISC-V no tiene CAS. Tiene un par más primitivo: load-reserved (lr.w) lee
y reserva una dirección; store-conditional (sc.w) escribe solo si nadie
escribió ahí desde el lr.w. Un CAS de C se compila a un lazo con este par
(make rv compila rvatomics.c con
riscv64-linux-gnu-gcc -O2 -S):
compare_and_swap:
1:  lr.w.aq  a5,0(a0)     # a5 = *p, y reservar p
    bne      a5,a1,1f     # si *p != expected, salir
    sc.w.rl  a4,a2,0(a0)  # intentar *p = new
    bnez     a4,1b        # sc.w deja 0 si tuvo éxito: si no, reintentar
1:  ...
Ojo: sc.w deja 0 si tuvo éxito y otro valor si falló; por eso se
reintenta con bnez. .aq y .rl agregan acquire y release. ARM tiene el
mismo par (ldxr/stxr). RISC-V además tiene operaciones atómicas de
memoria (amo*) de una sola instrucción: test-and-set se compila a
amoswap.w.aq y fetch-and-add a amoadd.w.
Fetch-and-add y el ticket lock
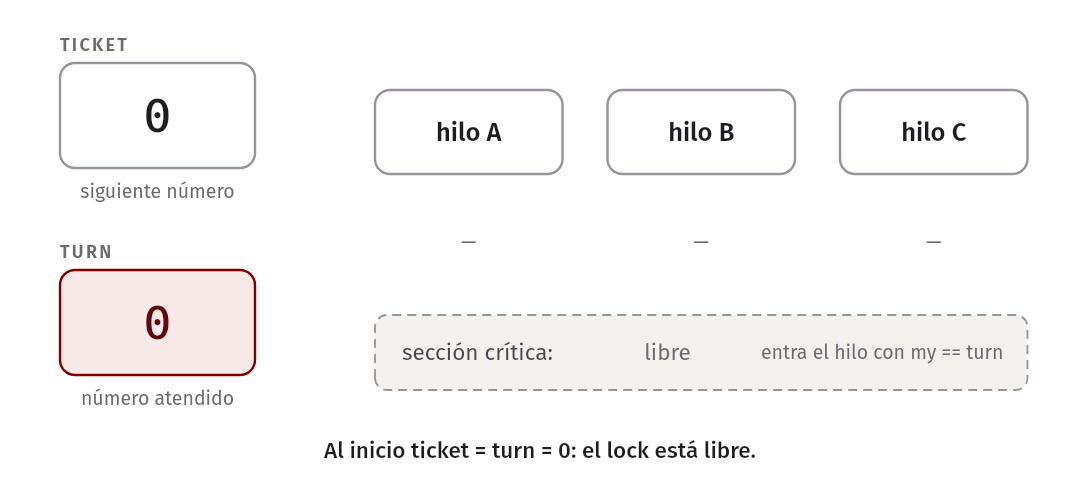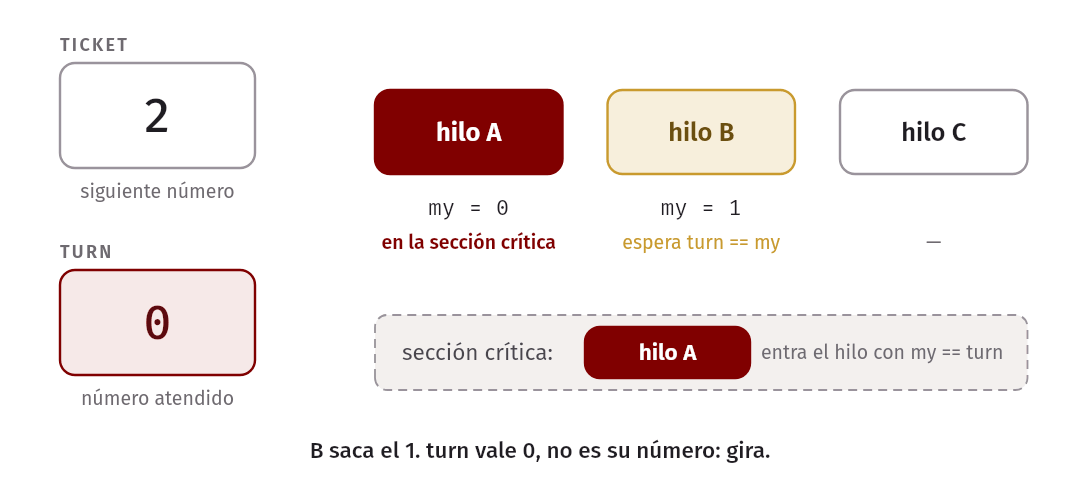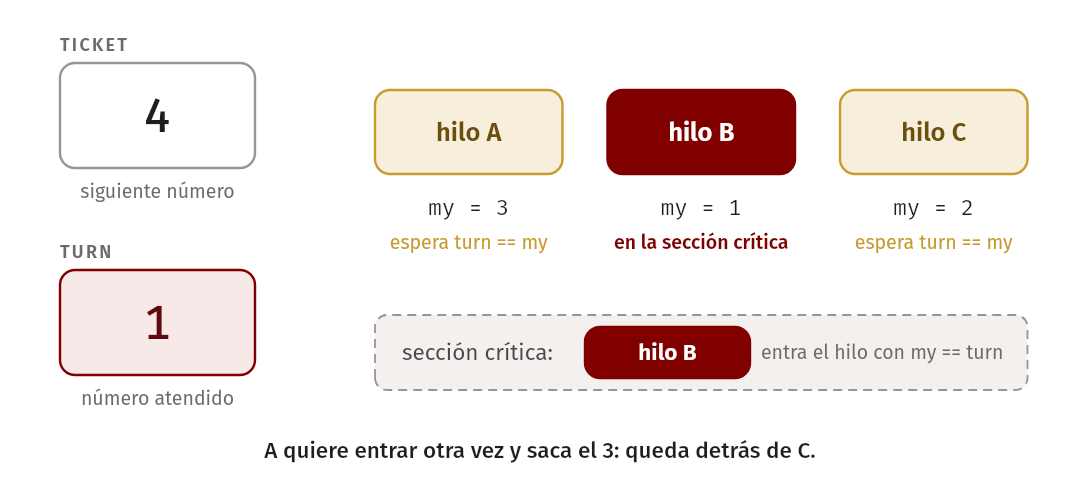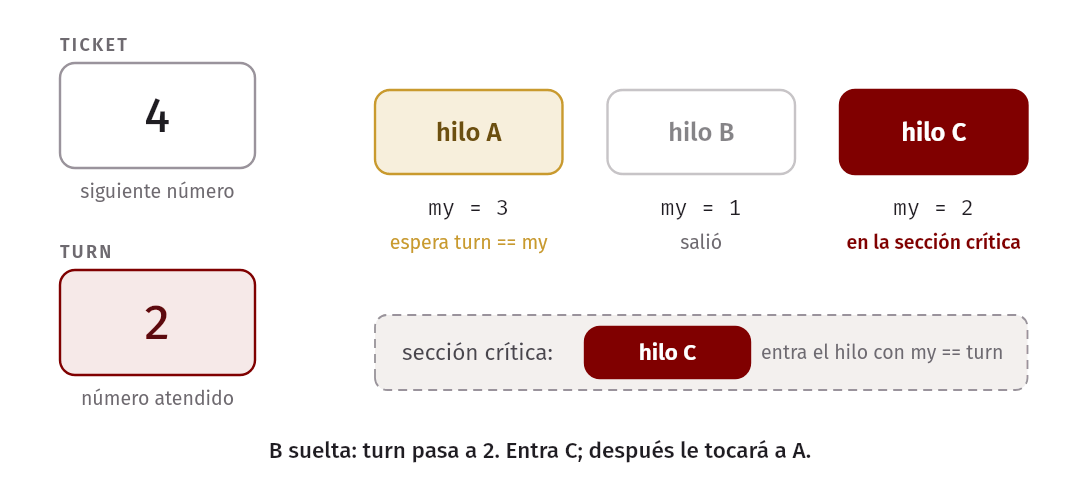
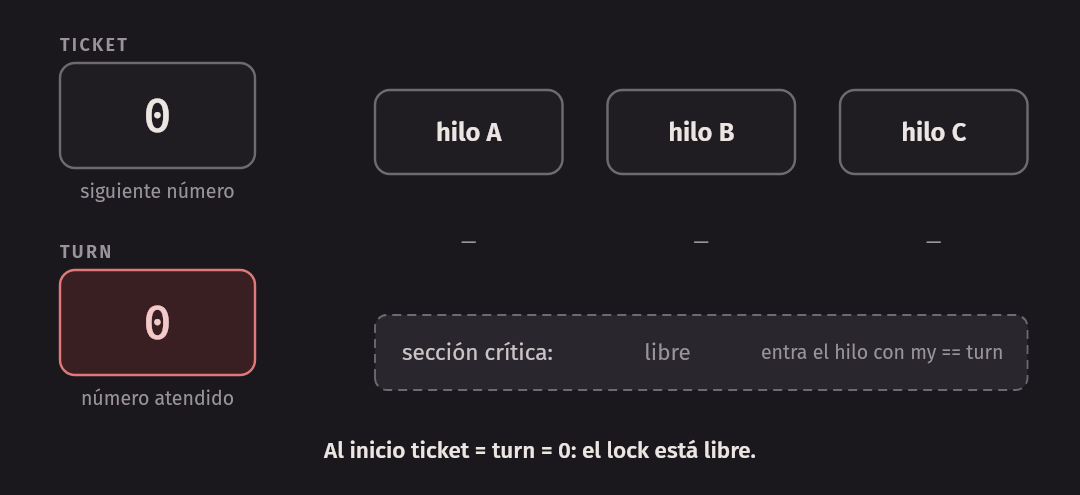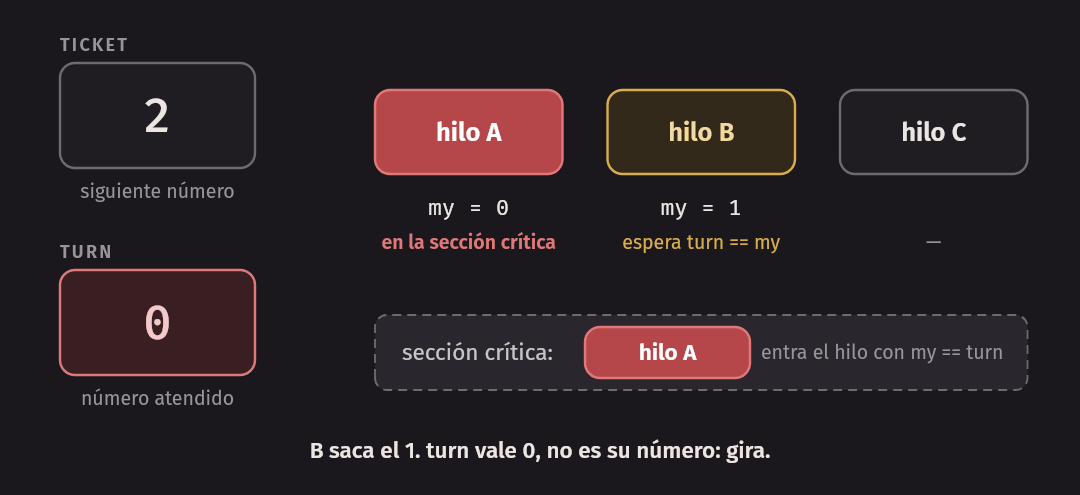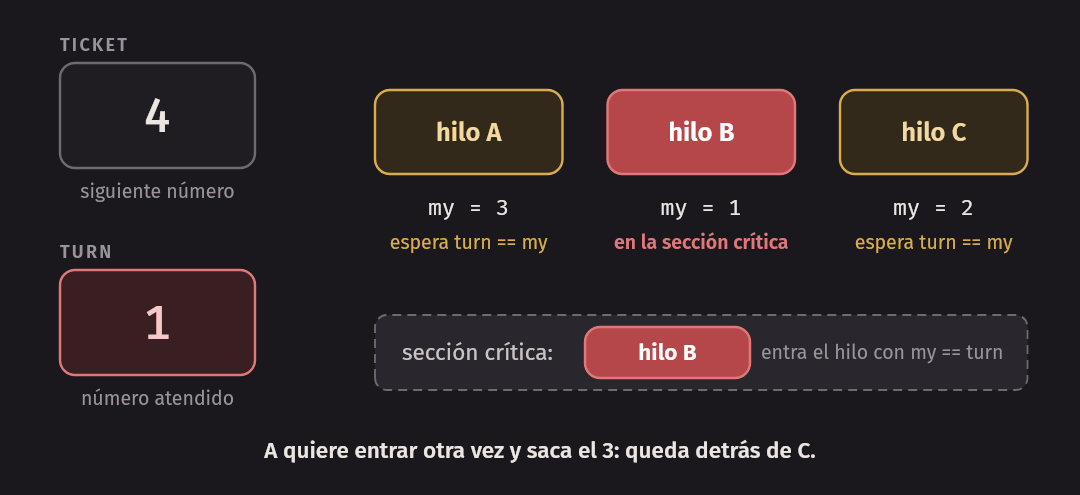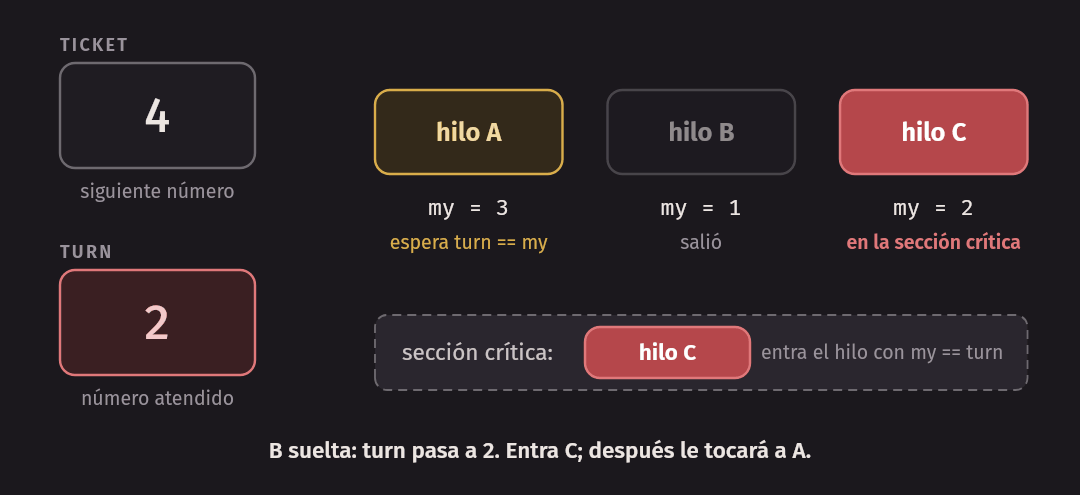
Fetch-and-add suma atómicamente y devuelve el valor anterior. Con ella se
construye el ticket lock, que funciona como la fila de un banco: al llegar,
cada hilo saca un número (ticket) y espera a que la pantalla (turn) muestre
su número. Al salir, el owner avanza la pantalla.
static inline void ticket_acquire(ticket_lock *l) {
    unsigned my = atomic_fetch_add_explicit(&l->ticket, 1, memory_order_relaxed);
    while (atomic_load_explicit(&l->turn, memory_order_acquire) != my)
        cpu_relax();
}
static inline void ticket_release(ticket_lock *l) {
    atomic_fetch_add_explicit(&l->turn, 1, memory_order_release);
}
Si A, B y C llegan en ese orden, sacan el 0, el 1 y el 2. Cuando A suelta,
turn pasa a 1 y entra B. Si A vuelve enseguida, saca el 3 y queda detrás de
C. Esa es la ventaja del ticket lock: equidad, porque se atiende en orden
de llegada. Con test-and-set, A podría ganar cada vez.
Sin girar tanto
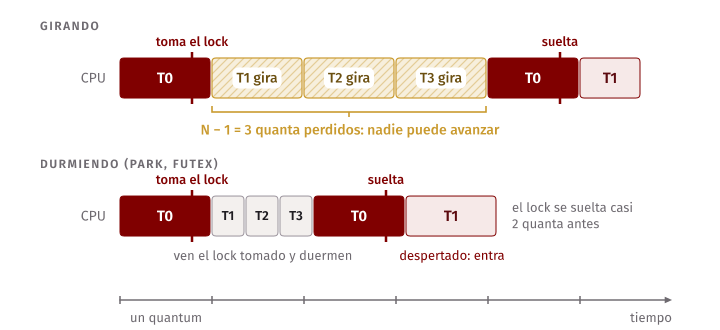
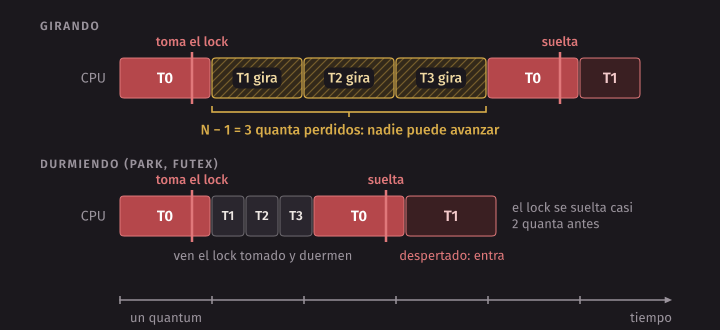
Todos los locks anteriores giran: el que espera ocupa la CPU sin avanzar.
Si hay más hilos que CPUs, cada vez que el owner es desalojado con el lock
tomado, los demás gastan quanta completos: con N hilos en una CPU, hasta
N − 1 por desalojo. El ticket lock lo empeora, porque solo puede entrar el hilo
del número siguiente. Lo medimos con taskset -c 0, que pone a los dos hilos
en una sola CPU:
| Lock (2 hilos, 1 CPU) | 3 millones de sumas por hilo |
|---|---|
| test-and-set | 0.013 s |
| futex de dos fases | 0.014 s |
| ticket | no terminó en 280 s |
Con un millón de sumas por hilo, el ticket lock tarda 6 ms: cada hilo termina dentro de su quantum. Con más trabajo los hilos se intercalan y cada entrega del lock espera un quantum. Un spinlock en una sola CPU con planificación apropiativa funciona, pero desperdicia quanta enteros, y el ticket lock, por ser justo, es el que peor lo pasa.
Ceder la CPU con yield
La primera mejora es no girar: si el lock está tomado, llamar a sched_yield()
para pasar de ejecutando a listo (tas_acquire_yield en locks.h). Con dos
hilos funciona bien; con cien, cada vuelta cuesta hasta 99 cambios de contexto.
Y sigue sin equidad.
Colas: park y unpark
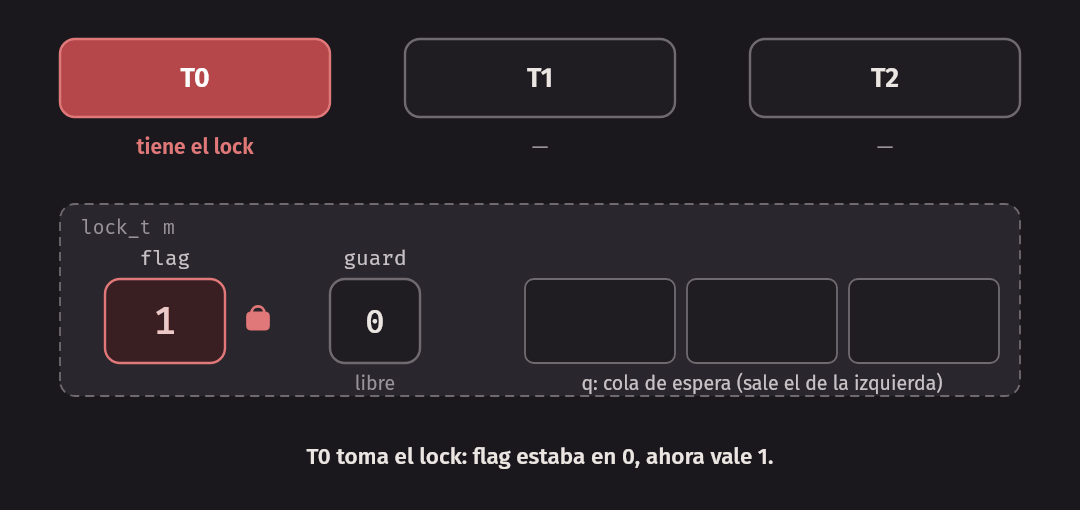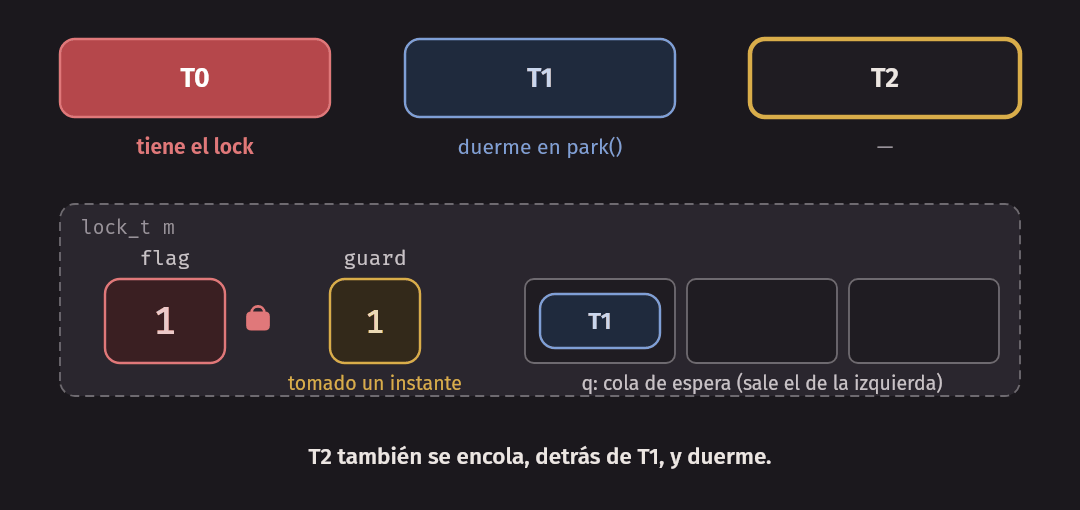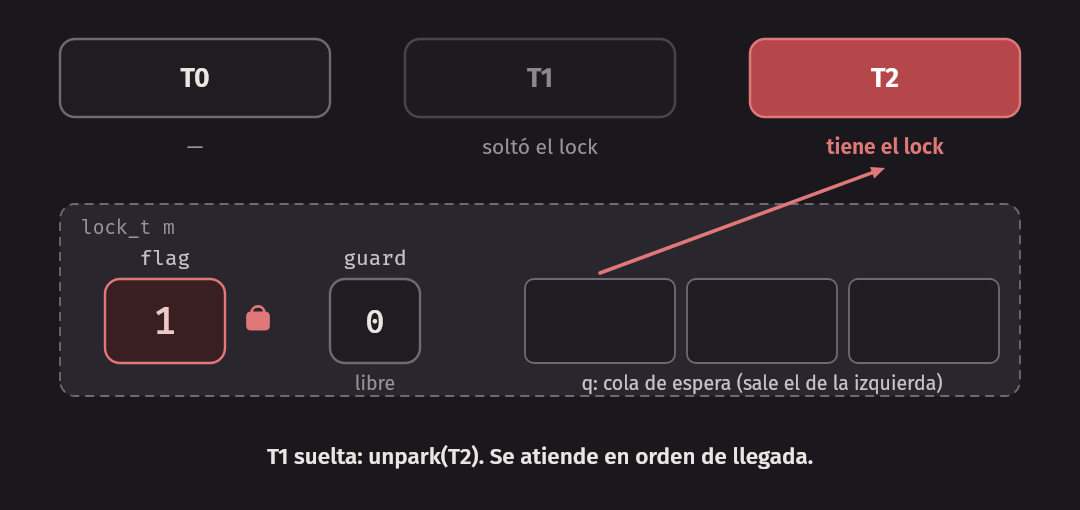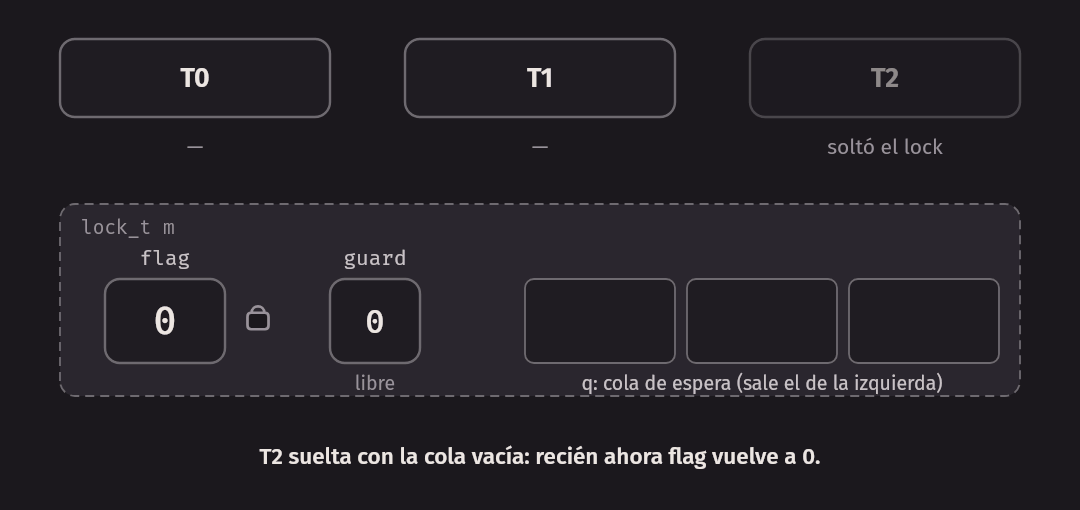
Para tener equidad y no gastar CPU hace falta decidir quién entra después y
dormir hasta entonces. Solaris ofrece dos llamadas: park() duerme al hilo
actual y unpark(tid) despierta a uno en particular. Con ellas y una cola:
void lock(lock_t *m) {
    while (TestAndSet(&m->guard, 1) == 1)
        ;                         // giro corto
    if (m->flag == 0) {
        m->flag = 1;              // libre: es mío
        m->guard = 0;
    } else {
        queue_add(m->q, gettid());
        setpark();                // voy a dormir
        m->guard = 0;
        park();
    }
}
void unlock(lock_t *m) {
    while (TestAndSet(&m->guard, 1) == 1)
        ;
    if (queue_empty(m->q))
        m->flag = 0;              // nadie espera
    else
        unpark(queue_remove(m->q)); // pasarlo directo
    m->guard = 0;
}
El giro no desaparece: guard es un spinlock, pero protege solo las pocas
instrucciones que tocan flag y la cola. La cola da equidad. Y cuando hay
alguien esperando, unlock no pone flag en 0: el lock pasa directo al
hilo despertado.
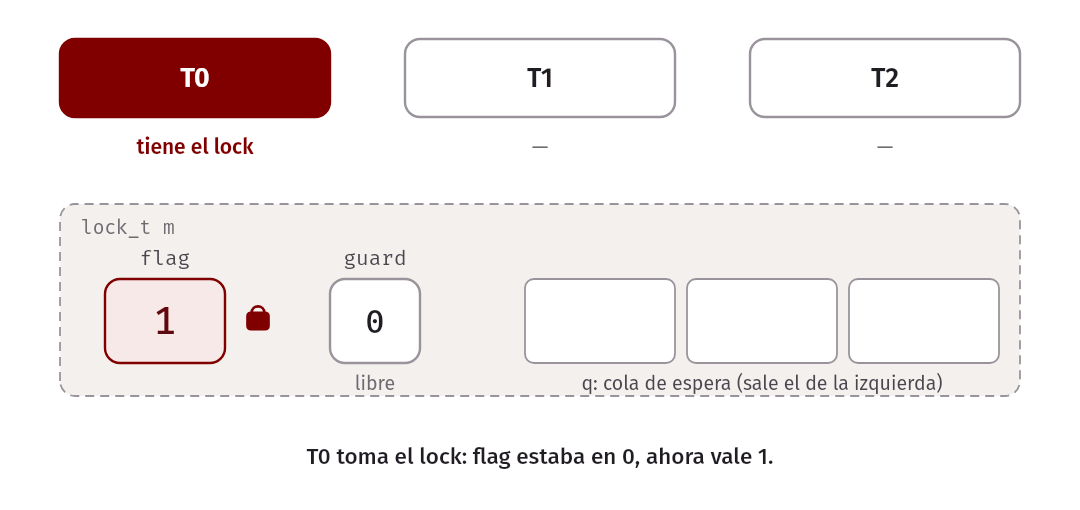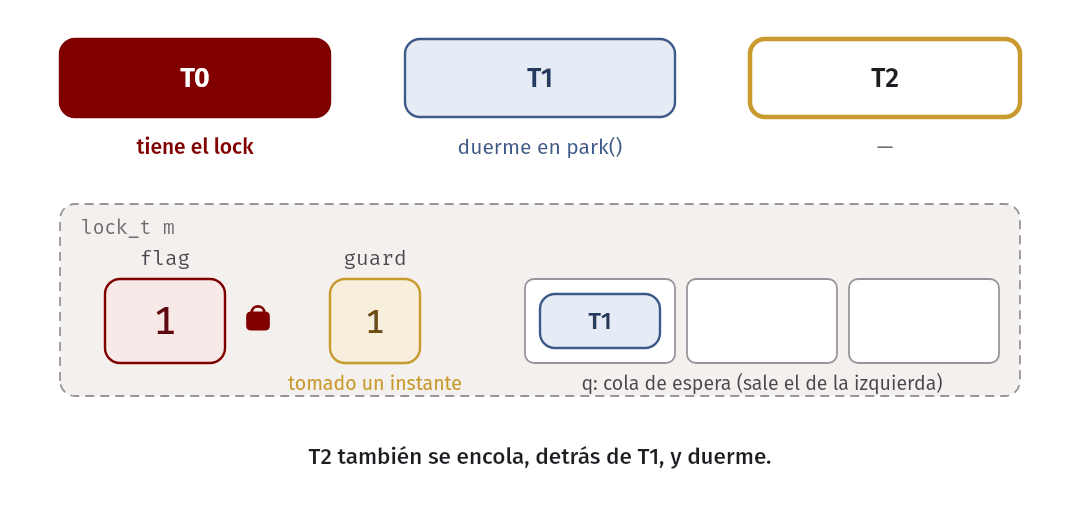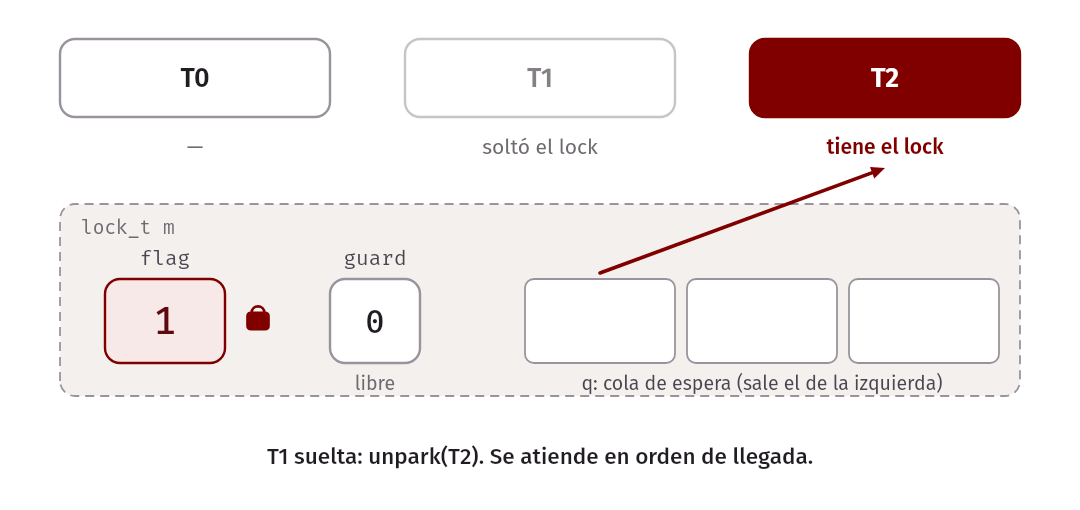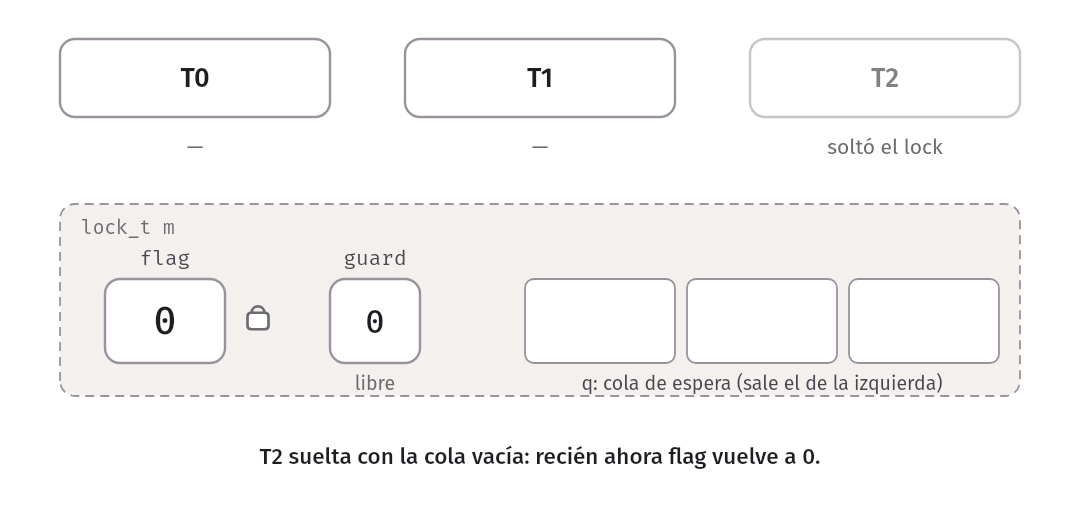
setpark() evita la carrera entre despertar y dormir (wakeup/waiting race). El
hilo 1 se encola y suelta guard, pero es desalojado antes de park(). El
owner suelta el lock y hace unpark(T1), que se pierde porque T1 aún no
duerme. Luego T1 ejecuta park() y duerme para siempre. Con setpark(), un
unpark que llega antes del park hace que este retorne de inmediato.
En xv6.
sleep_prepare(chan)(enkernel/proc.c) anota el canal enp->chanantes de soltar el lock que protege la condición. Si unwakeup(chan)llega en medio, borrap->chan, ysleep()retorna sin dormir. Es la misma idea quesetpark().
Linux: futex
Linux ofrece el futex (fast userspace mutex): una dirección de memoria del
usuario con una cola de espera en el kernel. futex_wait(addr, v) duerme solo
si *addr todavía vale v (el kernel lo compara atómicamente, así que no hay
carrera entre mirar y dormir) y futex_wake(addr, n) despierta hasta n hilos.
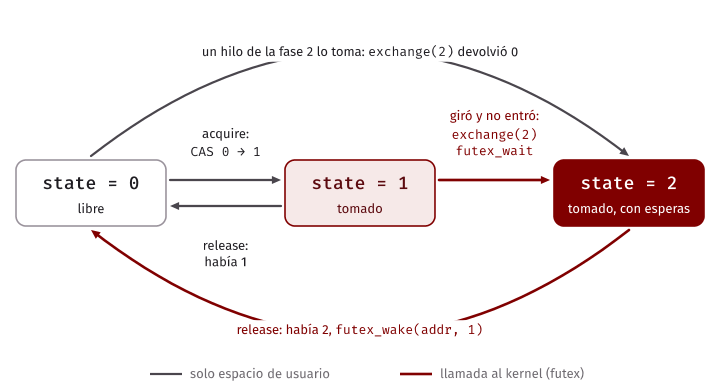
Sin competencia, nunca se entra al kernel. El lock de
locks.h usa tres estados (0 libre, 1 tomado, 2
tomado y quizá con hilos dormidos), como el pthread_mutex de glibc, que gira
una sola vez antes de dormir:
static inline void futex_acquire(futex_lock *l) {
    int c = 0;
    if (atomic_compare_exchange_strong(&l->state, &c, 1))
        return;                                   // camino rápido
    for (int i = 0; i < FUTEX_SPINS; i++) {       // fase 1: girar
        c = 0;
        if (atomic_compare_exchange_strong(&l->state, &c, 1))
            return;
        cpu_relax();
    }
    while (atomic_exchange(&l->state, 2) != 0)   // fase 2: dormir
        sys_futex(&l->state, FUTEX_WAIT_PRIVATE, 2);
}
Para soltarlo se pone 0 con un intercambio; solo si había un 2 se llama a
futex_wake para despertar a uno.
Locks de dos fases
El lock anterior es un lock de dos fases (two-phase lock), una idea de los años 60 que sigue vigente.
Idea clave. Girar conviene si la espera es más corta que dos cambios de contexto (dormir y despertar); dormir, si es más larga. Un lock de dos fases no necesita saberlo: gira un tiempo fijo y después duerme.
¿Cuál es más rápido?
El programa bench.c pone a T hilos a hacer un
millón de incrementos cada uno sobre un contador compartido, con distintos
locks. Si un lock escalara perfecto, el tiempo no crecería con los hilos.
Mediana de 3 corridas, en milisegundos:
| Lock | 1 hilo | 2 hilos | 4 hilos | 8 hilos |
|---|---|---|---|---|
| suma atómica (sin lock) | 2.5 | 9.9 | 34.4 | 211.9 |
pthread_mutex |
6.8 | 148.0 | 89.8 | 355.7 |
| test-and-set | 1.9 | 19.2 | 428.0 | 5512.6 |
test-and-set + yield |
1.5 | 5.2 | 158.3 | 4202.8 |
| ticket | 2.6 | 211.3 | 509.2 | 1998.9 |
| futex de dos fases | 2.4 | 50.8 | 428.0 | 1492.4 |
Si su máquina tiene menos CPUs que hilos, ./bench tabla muestra -- para
los locks que giran (tas, yield, ticket), porque podrían tardar minutos.
Con un hilo, todos cuestan unos pocos nanosegundos: sin competencia, un lock es
barato. Con 8 hilos, test-and-set es 15 veces más lento que pthread_mutex:
ocho CPUs escriben la misma palabra y su línea de caché salta de núcleo en
núcleo. Incluso la suma atómica, sin lock, se vuelve unas 85 veces más lenta.
El problema de fondo es compartir el contador.
Estructuras de datos con locks
El contador: exacto y aproximado
La forma obvia es una estructura con un valor y un lock que se toma en cada
incremento. Es correcta y simple, y así hay que empezar. Pero no escala: con 8
hilos, pthread_mutex tarda 356 ms para hacer 8 veces el trabajo que un hilo
hace en 6.8 ms. Escalar perfecto sería seguir en 6.8 ms.
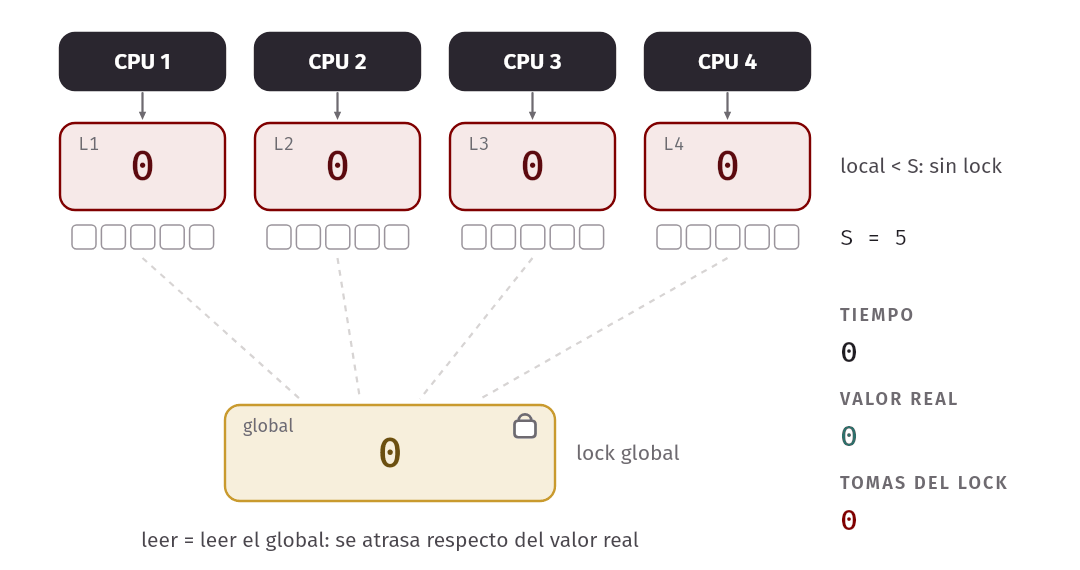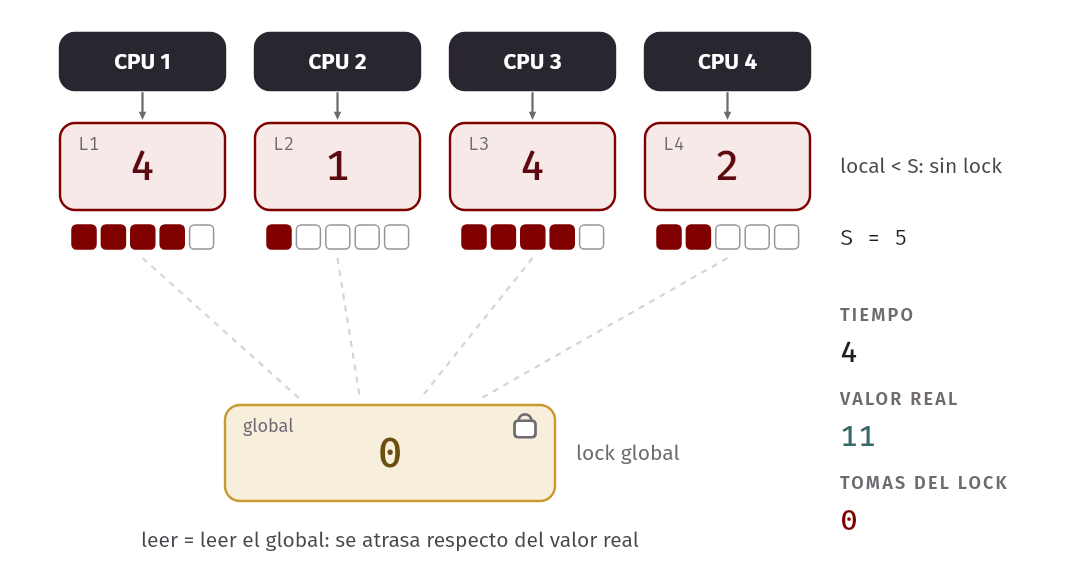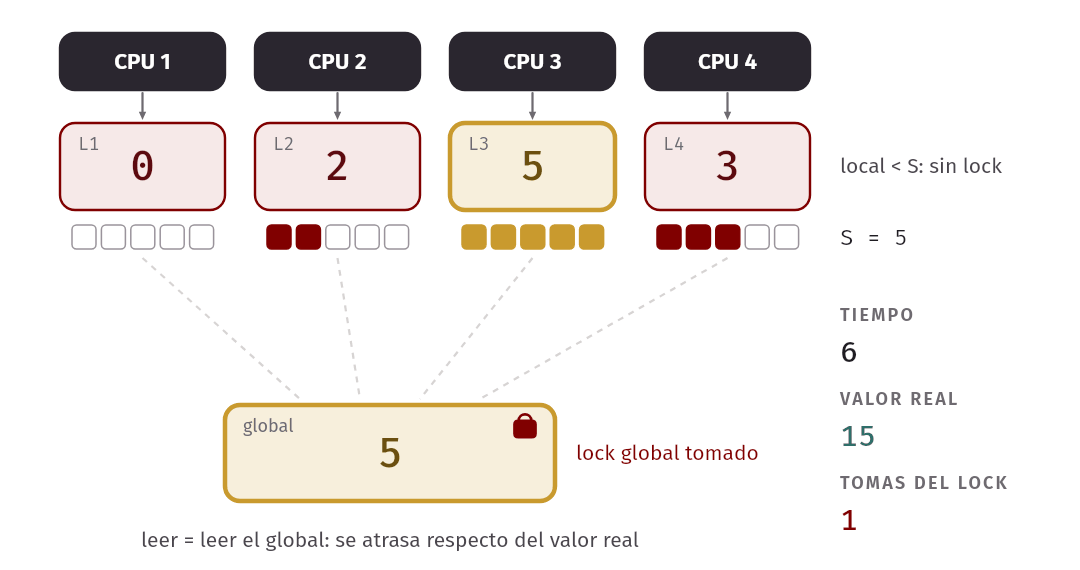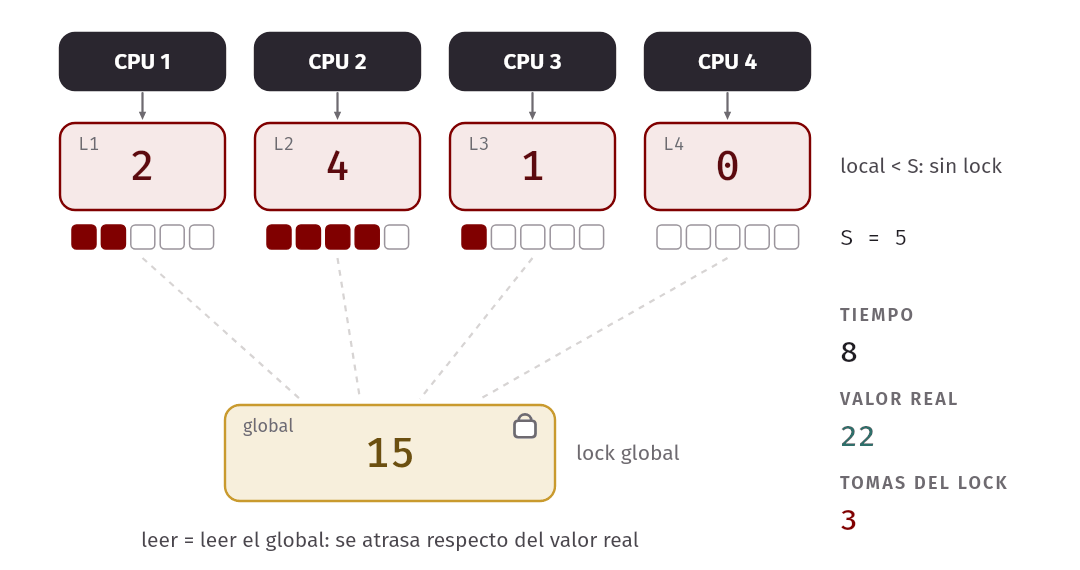
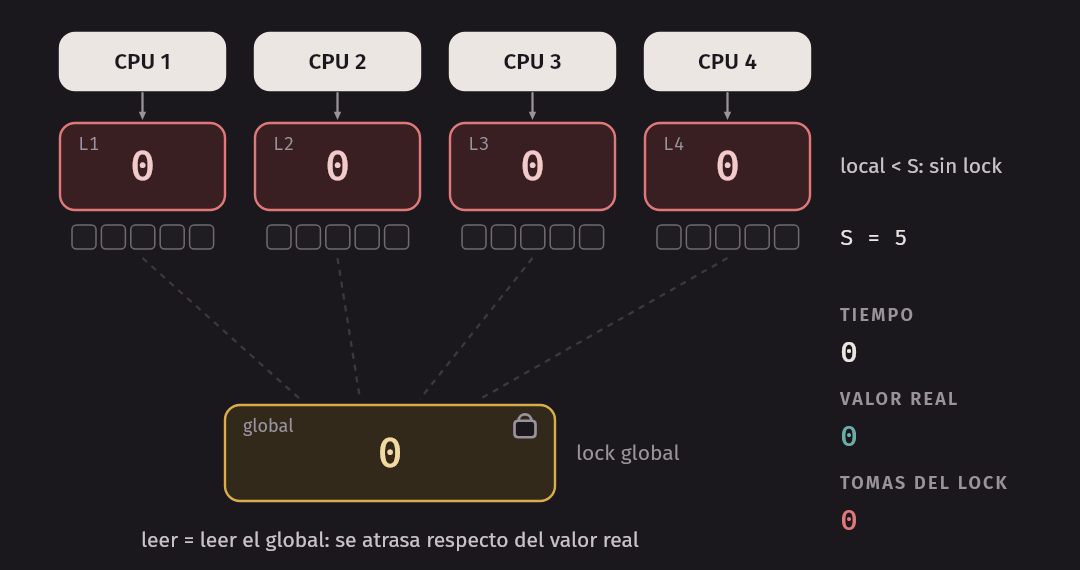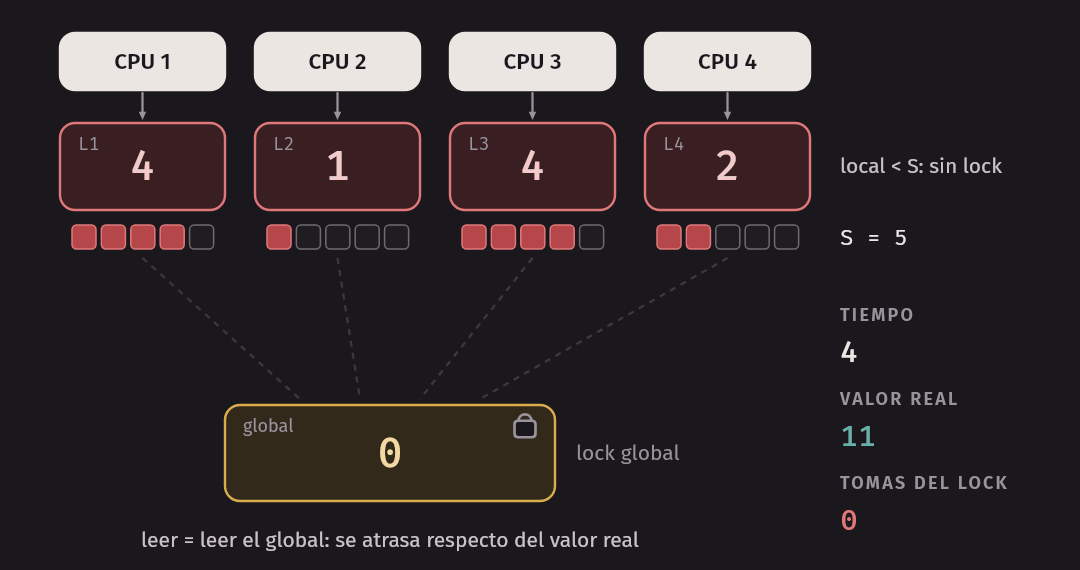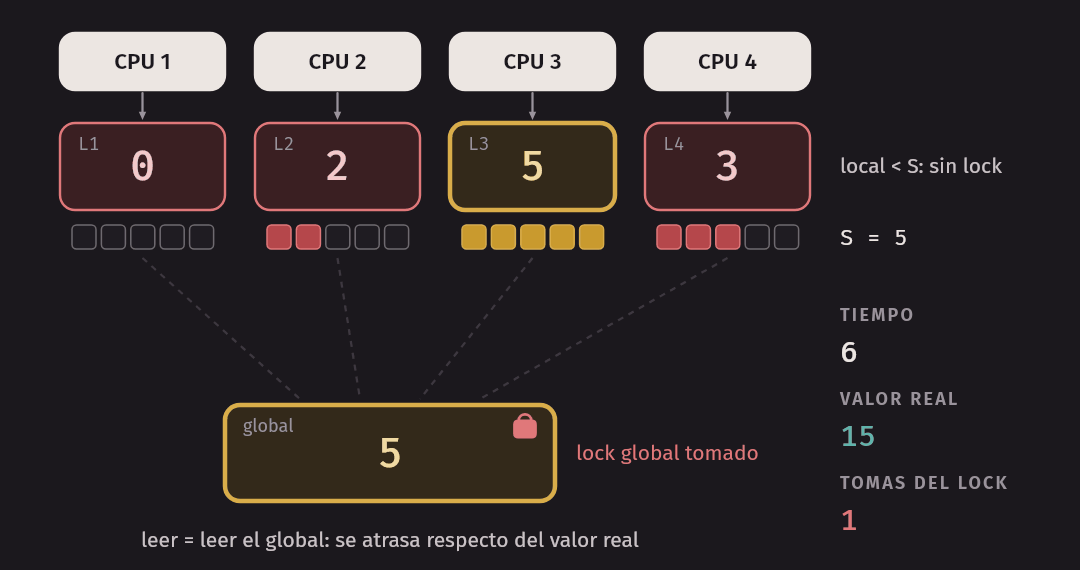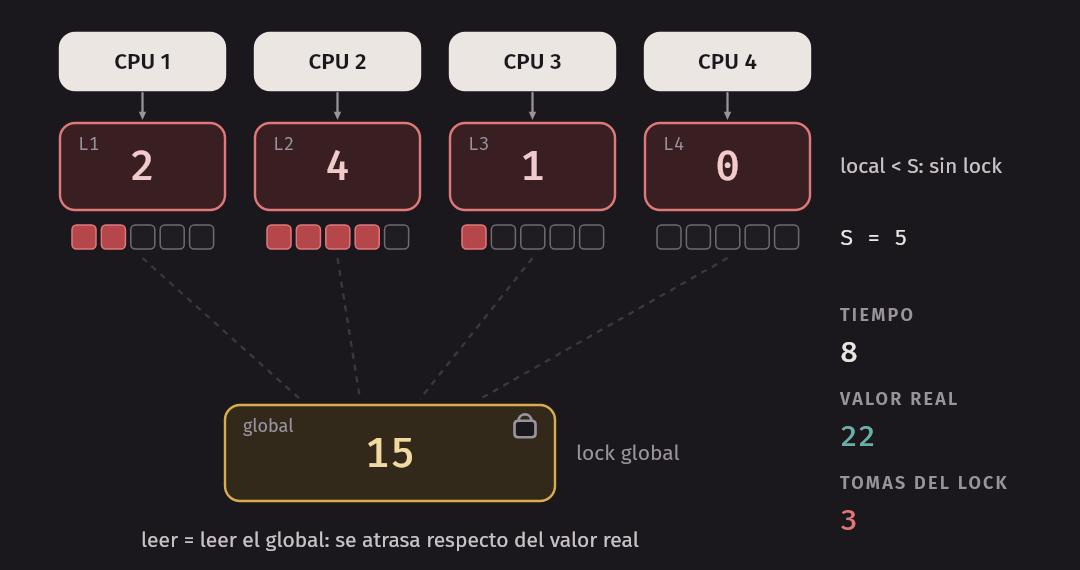
El contador aproximado (sloppy counter) reparte el trabajo. Cada CPU (o cada hilo) suma en su contador local, que nadie más toca. Cuando el local llega a un umbral S, se toma el lock global, se pasa el valor al contador global y el local vuelve a 0. Leer es leer el global, que puede estar atrasado hasta (número de CPUs) × (S − 1) unidades.
Un ejemplo con S = 5 y 4 CPUs:
| Tiempo | L1 | L2 | L3 | L4 | global | valor real |
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | 2 | 0 | 2 | 1 | 0 | 5 |
| 4 | 4 | 1 | 4 | 2 | 0 | 11 |
| 5 | 5 → 0 | 1 | 4 | 3 | 5 | 13 |
| 6 | 0 | 2 | 5 → 0 | 3 | 10 | 15 |
| 8 | 2 | 4 | 1 | 5 → 0 | 15 | 22 |
En el tiempo 8 el global dice 15 y el valor real es 22. Pero en 22 incrementos el lock global se tomó solo 3 veces.
En bench.c cada hilo tiene su local, así que no
necesita lock para él (OSTEP usa uno por CPU, con un lock por local, porque
varios hilos pueden correr en la misma CPU):
struct local {
    alignas(128) long value;   // cada local en su propia línea de caché
};
static struct local local[MAXT];

// en el lazo de cada hilo:
if (++local[id].value >= threshold) {
    pthread_mutex_lock(&glock);
    counter += local[id].value;
    pthread_mutex_unlock(&glock);
    local[id].value = 0;
}
El alignas(128) importa. Las CPUs mueven la memoria en líneas de caché (128
bytes en los Apple M; 64 en la mayoría de los x86). Si los locales estuvieran
juntos en un arreglo de long, compartirían una línea y cada escritura
invalidaría la copia de los demás aunque nunca toquen el mismo dato: false
sharing.
Con S = 1024 y un millón de incrementos por hilo, el contador aproximado tarda 0.8, 0.9, 1.2 y 3.7 ms con 1, 2, 4 y 8 hilos: casi plano. Eso es escalar. El precio es la exactitud, y lo controla S. Con 4 hilos y 4 millones de incrementos cada uno:
| S | 1 | 4 | 16 | 64 | 256 | 1024 | 4096 |
|---|---|---|---|---|---|---|---|
| millones de sumas/s | 31 | 117 | 276 | 508 | 1410 | 3229 | 4564 |
Con S = 1 es un contador con lock. De S = 1 a S = 4096 el rendimiento se multiplica por 145, y cada vez que S se multiplica por 4 sube entre 1.4 y 3.7 veces. El umbral S es el parámetro que controla el compromiso entre exactitud y rendimiento.
Listas enlazadas
Una lista con un solo lock es fácil de hacer correcta. En
hash.c, la inserción hace el malloc fuera del
lock: la sección crítica es más corta y, si malloc falla, salimos sin tener
el lock tomado. La búsqueda tiene un único camino de salida (un break y luego
el unlock): olvidar soltar el lock en un return temprano es un error
clásico.
¿Y si queremos que varios hilos recorran la lista a la vez? El hand-over-hand locking (o lock coupling) pone un lock en cada nodo. Al avanzar, se toma el lock del nodo siguiente antes de soltar el del actual, como quien cruza un pasamanos. Así varios hilos pueden recorrer la lista uno detrás de otro.
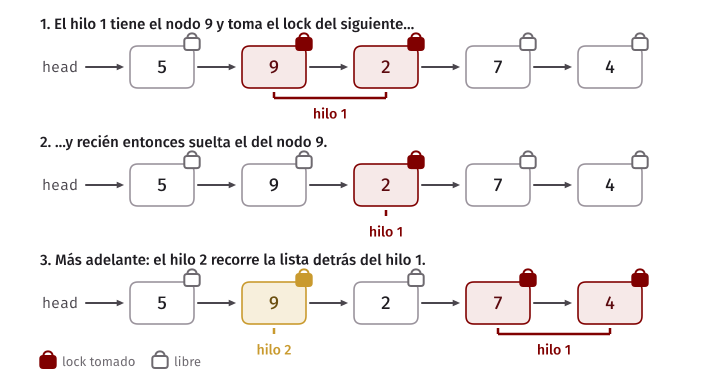
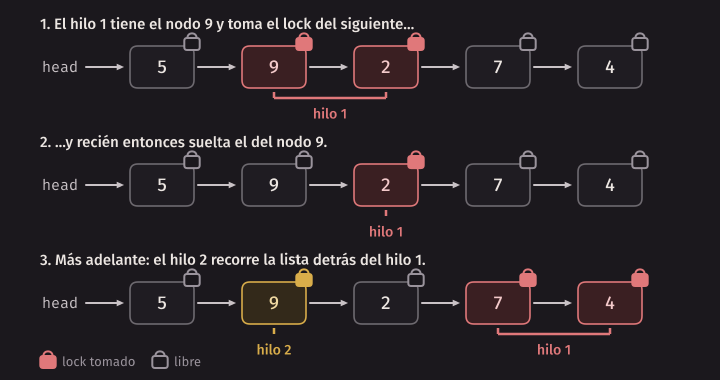
Suena mejor, pero cuesta más. list.c arma una lista
de 1000 nodos y cada hilo hace 20 000 búsquedas:
| Hilos | 1 | 2 | 4 | 8 |
|---|---|---|---|---|
| un lock (s) | 0.012 | 0.037 | 0.108 | 0.274 |
| hand-over-hand (s) | 0.060 | 0.094 | 0.714 | 1.234 |
Tomar y soltar un lock por cada nodo visitado es caro. La lección de siempre: medir antes de complicar.
Una cola con dos locks
Michael y Scott (1996) propusieron una cola con dos locks: uno para la
cabeza, que usan los que sacan, y otro para la cola, que usan los que meten. Un
nodo ficticio (dummy) al inicio separa los dos extremos, así que meter y
sacar pueden ocurrir a la vez. Al sacar, el primer dato real pasa a ser el nuevo
ficticio. El código está en queue.c.
Un caso delicado: con la cola vacía, el que mete escribe next del ficticio
(bajo tail_lock) y el que saca lo lee (bajo head_lock). Como son locks
distintos, en una CPU con memoria débil el que saca podría ver el puntero nuevo
y todavía no el value. Por eso queue.c publica ese puntero con
__ATOMIC_RELEASE y lo lee con __ATOMIC_ACQUIRE. Esperar a que llegue algo
cuando la cola está vacía es tarea de las variables de condición, la próxima
semana.
Tablas hash
La tabla hash es la estructura que mejor se reparte: cada bucket es una lista
con su propio lock, y dos hilos solo compiten si caen en el mismo bucket.
hash.c compara un lock global con un lock por bucket
(1024 buckets; cada hilo inserta y luego busca 20 000 claves):
| Hilos | 1 | 2 | 4 | 8 |
|---|---|---|---|---|
| lock global (ms) | 1 | 8 | 52 | 391 |
| lock por bucket (ms) | 1 | 3 | 6 | 19 |
Con 8 hilos, la versión por bucket es 20 veces más rápida. Aún crece un poco
porque las listas se alargan y malloc tiene sus propios locks.
Idea clave. Primero correcto, después rápido. Un lock grande alrededor de toda la estructura es un buen comienzo (Linux empezó con un big kernel lock). Solo si la medición muestra que es el cuello de botella vale la pena partirlo.
Locks en xv6-riscv
xv6 tiene dos tipos de lock: el spinlock, para secciones críticas cortas, y el sleeplock, para esperas largas.
acquire y release
El spinlock está en kernel/spinlock.c. Este es el código, con los comentarios
recortados:
void
acquire(struct spinlock *lk)
{
  push_off(); // disable interrupts to avoid deadlock.
  if (holding(lk))
    panic("acquire");

  while (__atomic_exchange_n(&lk->locked, 1, __ATOMIC_ACQUIRE) != 0)
    ;

  lk->cpu = mycpu();
}

void
release(struct spinlock *lk)
{
  if (!holding(lk))
    panic("release");

  lk->cpu = 0;
  __atomic_store_n(&lk->locked, 0, __ATOMIC_RELEASE);

  pop_off();
}
El lazo de acquire es el spinlock de test-and-set: __atomic_exchange_n
escribe 1 y devuelve el valor anterior, y __ATOMIC_ACQUIRE/__ATOMIC_RELEASE
hacen de barreras. holding detecta un error de programación (tomar dos veces
el mismo lock en la misma CPU, que sería un deadlock) y hace panic. Versiones
anteriores de xv6 usaban __sync_lock_test_and_set y __sync_synchronize; el
cambio a __atomic_* es de 2026 y la idea es la misma.
Si compilan una copia de xv6 en el contenedor y desensamblan el kernel con
riscv64-linux-gnu-objdump -d kernel/kernel, el giro aparece como cuatro
instrucciones:
80000bea:  mv      a5,a4               # a5 = 1
80000bec:  amoswap.w.aq a5,a5,(s1)     # intercambiar con lk->locked
80000bf0:  sext.w  a5,a5
80000bf2:  bnez    a5,80000bea         # si había 1, otra vez
En release, la escritura sw zero,0(s1) (el lk->locked = 0) va precedida
de fence rw,w: todas las lecturas y escrituras de la sección crítica se
completan antes de que otra CPU vea el lock libre.
Por qué se apagan las interrupciones
acquire empieza con push_off(), que apaga las interrupciones de la CPU.
¿Para qué, si ya tenemos el lock? sys_sleep (kernel/sysproc.c) toma
tickslock para leer ticks, y el manejador del reloj clockintr
(kernel/trap.c) toma el mismo lock para hacer ticks++. Si la
interrupción llega mientras la CPU tiene tickslock, el manejador gira
esperando a un owner que está debajo de él, en la misma CPU, y que no volverá a
correr hasta que el manejador termine: deadlock. Por eso, mientras una CPU
tiene cualquier spinlock, sus interrupciones están apagadas.
En xv6.
push_offypop_offse anidan.push_offusarc_sstatus, que es una sola instruccióncsrrc: leesstatusy borra el bitSIE. Cada CPU lleva enstruct cpu(enkernel/proc.h) un contadornoffdepush_offpendientes y enintenasi las interrupciones estaban encendidas antes del primero.pop_offlas vuelve a encender solo cuandonoffllega a 0 y solo siintenalo indica. Así, con dos locks tomados, soltar el primero no enciende las interrupciones por error.
Una consecuencia: un spinlock de xv6 no se puede tener mientras se duerme.
sched() en kernel/proc.c hace panic("sched locks") si noff != 1, es
decir, si el proceso tiene algún lock además de p->lock.
sleeplock: un lock que duerme
Para esperas largas, como leer un bloque del disco, xv6 usa
kernel/sleeplock.c:
void
acquiresleep(struct sleeplock *lk)
{
  acquire(&lk->lk);
  while (lk->locked) {
    sleep_prepare(lk);
    release(&lk->lk);
    sleep();
    acquire(&lk->lk);
  }
  lk->locked = 1;
  lk->pid = myproc()->pid;
  release(&lk->lk);
}
Es el lock con cola de la sección anterior: lk->lk hace de guard, sleep
de park y wakeup(lk) (en releasesleep) de unpark, y sleep_prepare va
antes de soltar lk->lk por la carrera entre despertar y dormir. Mientras el
proceso duerme, la CPU corre otro. A diferencia de Solaris, wakeup despierta a
todos y no hay cola explícita, así que no es justo. Se usa para los buffers
del disco (kernel/bio.c) y los inodos (kernel/fs.c).
Resumen
- Un lock se evalúa por corrección, equidad y rendimiento.
- Apagar las interrupciones no sirve con varias CPUs. Una bandera no es atómica. Peterson solo funciona con una barrera de memoria.
- El hardware ofrece test-and-set (
amoswap), compare-and-swap (un lazolr.w/sc.wen RISC-V) y fetch-and-add (amoadd). El spinlock de test-and-set es injusto; el ticket lock es justo. - Girar desperdicia CPU:
yield, colas conpark/unparkysetpark, el futex de Linux y los locks de dos fases. - El contador aproximado escala gracias a contadores locales; el umbral S controla el compromiso entre exactitud y rendimiento.
- Listas con un lock, colas con dos locks, tablas hash con un lock por bucket. Hand-over-hand resultó más lento: primero correcto, después medir.
- En xv6,
acquirees unamoswap.w.aqen un lazo con las interrupciones apagadas;sleeplockduerme consleep_prepare,sleepywakeup.
Ejercicios
- Con un intercalado concreto, expliquen por qué el spinlock de test-and-set no
es justo y cómo lo evita el ticket lock. ¿Sigue funcionando el ticket lock
cuando
ticketpasa de 2³² − 1 a 0? - Con
x86.pyypeterson.s(homework del cap. 28), prueben varias semillas (-s) e intervalos de interrupción (-i) y verifiquen que nunca hay dos hilos dentro. ¿Por qué el simulador nunca muestra el error de./peterson peterson? - Ejecuten
./bench tablaynprocen su máquina. Luego comparentaskset -c 0,1 ./bench tas 4contaskset -c 0,1 ./bench mutex 4. ¿Por qué no conviene probarticketasí? - En
bench.c, cambienalignas(128)por nada (unlongsimple) y midan./bench sloppy 8 4000000. ¿Cuánto cambia? Expliquen el resultado con la idea de false sharing. - Agreguen a
bench.cun hilo que lea el contador aproximado mientras los demás trabajan. ¿Cuánto se atrasa como máximo? ¿Respeta la cota T × (S − 1), con T hilos? - En el lock con cola de
park/unpark, ¿qué pasaría sim->guard = 0se hiciera después depark()en lugar de antes? Describan el intercalado. - En xv6, ¿qué pasaría si
acquireno llamara apush_off? Describan un intercalado contickslockque lleve a un deadlock en una sola CPU. ¿Por qué no es un problema si el manejador corre en otra CPU?