
Apuntes · Capítulo 11Concurrencia
Variables de condición y semáforos
Variables de condición y semáforos
La semana pasada construimos locks: con ellos, un solo hilo a la vez entra a la sección crítica (critical section). Pero la exclusión mutua (mutual exclusion) no es lo único que necesitan los programas concurrentes. Muchas veces un hilo tiene que esperar a que algo pase: que otro hilo termine, que llegue un dato a una cola, que se libere espacio en un buffer. Un lock no sirve para eso: dice “nadie más está aquí dentro”, pero no “ya puedes seguir”.
Este capítulo presenta las dos herramientas clásicas para esperar: las variables de condición (condition variables) y los semáforos (semaphores). Con ellas resolvemos productor/consumidor, lectores/escritores y los filósofos comensales (dining philosophers). Después vemos qué pasa cuando un lock se cruza con las prioridades de la semana 3: la inversión de prioridad. Al final vemos cómo espera el kernel de xv6.
Ruta de lectura.
- Antes de clase (15–20 min): «Esperar sin girar», «Variables de condición» y «Por qué
waitrecibe el lock».- En clase: sesión A, «El padre espera al hijo» y «Productor/consumidor»; sesión B, «Semáforos» e «Inversión de prioridad».
- Después de clase: repasar el «Resumen», leer «En xv6:
sleepywakeup» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 30 y 31, el apéndice Monitors, «En Linux:PTHREAD_PRIO_INHERIT» y las lecturas del recuadro sobre el Mars Pathfinder.
Lectura. Este capítulo acompaña a OSTEP cap. 30 Condition Variables y cap. 31 Semaphores; el apéndice Monitors es opcional. Todo el código está en
code/week-11;make testcorre todas las demostraciones dentro del contenedor del curso.
Esperar sin girar
El caso más simple: el hilo principal crea un hijo y quiere esperar a que termine. Sin ninguna herramienta nueva, lo natural es una bandera:
volatile int done = 0;

void *child(void *arg) {
    printf("hijo\n");
    done = 1;
    return NULL;
}

int main(void) {
    pthread_t c;
    pthread_create(&c, NULL, child, NULL);
    while (done == 0)
        ;                // girar
    printf("padre: fin\n");
}
Funciona, pero desperdicia. Con una CPU, el padre gasta su quantum
preguntando por done, y el hijo, el único que puede cambiar done, ni
siquiera corre. Con varias CPUs, una queda al 100 %
sin hacer nada útil, y no por unas pocas instrucciones como en un spinlock, sino
por lo que tarde el hijo. (Sin volatile, además, el compilador con -O2 puede
leer done una sola vez y girar para siempre.)
Lo que queremos es otra cosa: dormir hasta que la condición cambie, y que el hilo que la cambia nos despierte.
Variables de condición
Una variable de condición (condition variable, CV) es una cola de hilos
dormidos que esperan a que cierto estado del programa cambie. Es importante lo
que no es: la CV no guarda el estado. Solo sirve para dormir y para
despertar. El estado vive en variables normales (done, count…), protegidas
por un lock.
En pthreads:
| Operación | Qué hace |
|---|---|
pthread_cond_wait(&c, &m) |
Con m tomado: suelta m y duerme en c, en un solo paso atómico. Antes de retornar, vuelve a tomar m. |
pthread_cond_signal(&c) |
Despierta a un hilo dormido en c. Si no hay nadie, no hace nada. |
pthread_cond_broadcast(&c) |
Despierta a todos los hilos dormidos en c. |
Por qué wait recibe el lock
¿Por qué wait recibe un mutex? Por dos razones.
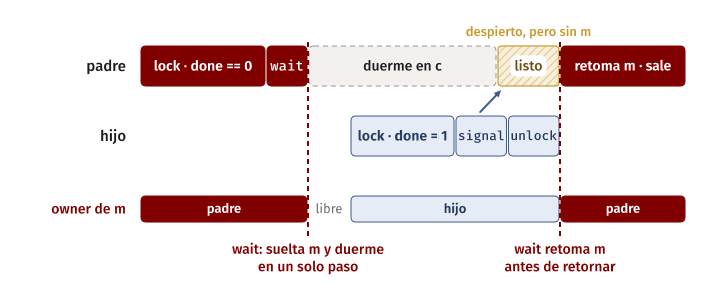
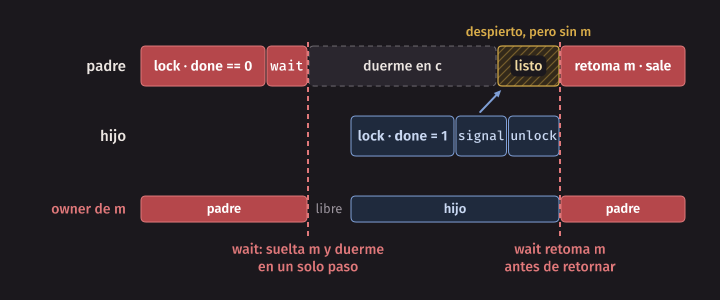
Primero, el hilo que espera no puede dormir con el lock tomado. Si el padre
revisa done con el lock y luego duerme sin soltarlo, el hijo nunca podrá tomar
el lock para cambiar done: deadlock. Así que wait tiene que soltarlo.
Segundo, soltar y dormir tienen que ser un solo paso. Si wait soltara el
lock y después durmiera, en ese hueco el hijo podría cambiar done y hacer
signal cuando todavía nadie duerme; el aviso se perdería. Es la carrera entre
despertar y dormir que vimos la semana pasada con park() y setpark().
Al despertar, wait vuelve a tomar el lock antes de retornar: el código que
sigue al wait corre siempre con el lock tomado.
El padre espera al hijo
Esta es la versión correcta de “esperar a que el hijo termine”, sacada de
join.c sin las trazas:
int done = 0;
pthread_mutex_t m = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t c = PTHREAD_COND_INITIALIZER;

void thr_exit(void) {          // la llama el hijo al terminar
    pthread_mutex_lock(&m);
    done = 1;
    pthread_cond_signal(&c);
    pthread_mutex_unlock(&m);
}

void thr_join(void) {          // la llama el padre
    pthread_mutex_lock(&m);
    while (done == 0)
        pthread_cond_wait(&c, &m);
    pthread_mutex_unlock(&m);
}
Hay tres piezas: el estado (done), el lock que lo protege (m) y la
CV para dormir (c). Veamos los dos órdenes posibles:
- El padre llega primero. Ve
done == 0y duerme (soltandom). El hijo ponedone = 1y hacesignal. El padre despierta, recuperam, revisa otra vez y sale. - El hijo llega primero. Pone
done = 1y hacesignal, que no despierta a nadie. Cuando el padre llega, vedone == 1y ni siquiera duerme.
¿Hace falta cada pieza? Quitemos una a la vez.
Roto 1: sin variable de estado
Si eliminamos done, el hijo solo hace signal y el padre solo hace wait.
Con el padre primero funciona. Pero si el hijo corre primero, su signal no
encuentra a nadie y se pierde; cuando el padre hace wait, duerme para siempre.
signal no recuerda nada. El estado es lo que permite al padre saber que el
evento ya ocurrió.
Roto 2: el estado sin lock
Ahora mantenemos done pero quitamos el lock al revisarlo:
void thr_exit(void) { done = 1; pthread_cond_signal(&c); }

void thr_join(void) {
    if (done == 0) {
        // <- aquí desalojan al padre
        pthread_mutex_lock(&m);
        pthread_cond_wait(&c, &m);
        pthread_mutex_unlock(&m);
    }
}
El padre ve done == 0 y, antes de llegar al wait, el planificador
(scheduler) lo desaloja. Corre el hijo: done = 1, signal (nadie duerme todavía). Vuelve el
padre y hace wait: duerme para siempre, aunque done ya vale 1. El problema
es que revisar la condición y dormir no fueron atómicos respecto del que la
cambia. Con el lock tomado desde la revisión hasta el wait, el hijo no podría
haber cambiado done en medio.
join.c reproduce los tres casos (ok, nostate, nolock). Unos msleep()
fuerzan la intercalación mala y un hilo watchdog detecta que nadie avanza en
un segundo y termina el programa:
$ ./join nolock
[   0 ms] padre: done == 0 (revisado sin lock)
[  54 ms] hijo:  trabajo terminado
[  54 ms] hijo:  done = 1, signal (sin lock)
[ 112 ms] padre: wait
[1055 ms] WATCHDOG: 1 s sin avance.
          El padre duerme: el aviso se perdió.
Sin los retrasos el error aparece solo de vez en cuando, y eso es lo peligroso: las pruebas pasan casi siempre.
Idea clave. Para esperar una condición se necesitan las tres piezas: un estado explícito, un lock que lo proteja y una CV para dormir. El estado se lee y se modifica siempre con el lock tomado.
Productor/consumidor
El problema del bounded buffer (buffer acotado) aparece en todas partes:
en grep main *.c | wc -l el pipe es un buffer de tamaño fijo entre un
productor y un consumidor; en un servidor web, un hilo pone conexiones en una
cola y varios trabajadores las sacan. El productor espera si el buffer está
lleno y el consumidor si está vacío.
Empecemos con un buffer de un solo elemento: count vale 0 o 1, put() exige
count == 0 y get() exige count == 1.
Intento 1: if y una sola CV
void *producer(void *arg) {
  for (int i = 0; i < loops; i++) {
    mutex_lock(&mutex);          // p1
    if (count == 1)              // p2
      cond_wait(&cond, &mutex);  // p3
    put(i);                      // p4
    cond_signal(&cond);          // p5
    mutex_unlock(&mutex);        // p6
  }
}
void *consumer(void *arg) {
  for (;;) {
    mutex_lock(&mutex);          // c1
    if (count == 0)              // c2
      cond_wait(&cond, &mutex);  // c3
    int tmp = get();             // c4
    cond_signal(&cond);          // c5
    mutex_unlock(&mutex);        // c6
  }
}
Con un productor y un consumidor funciona. Con dos consumidores, Tc1 y Tc2, y un productor Tp, hay una intercalación que lo rompe:
| Paso | Tc1 | Tc2 | Tp | count |
Qué pasa |
|---|---|---|---|---|---|
| 1 | c1 c2 c3 (duerme) | 0 | Vacío: Tc1 duerme. | ||
| 2 | duerme | p1 p2 p4 p5 | 1 | Tp pone un dato y despierta a Tc1. | |
| 3 | listo | p6 p1 p2 p3 (duerme) | 1 | Tc1 está listo pero no corre; Tp ve lleno y duerme. | |
| 4 | listo | c1 c2 c4 | duerme | 0 | Tc2 llega antes que Tc1 y se lleva el dato. |
| 5 | listo | c5 c6 | listo | 0 | Tc2 despierta a Tp. |
| 6 | c4 | 0 | Tc1 sigue después de c3: get() con el buffer vacío. |
Cuando Tc1 por fin corre, el estado ya cambió. Despertar es solo una
pista; hay que volver a revisar: while en lugar de if.
Semántica Mesa y semántica Hoare
¿Por qué puede pasar esto? Depende de qué significa signal. Brinch Hansen y
Hoare propusieron los monitores: objetos cuyos métodos corren con un lock implícito y
tienen variables de condición (Java los trae en el lenguaje: synchronized,
wait(), notifyAll()). En su propuesta, signal entrega el lock y la CPU
inmediatamente al hilo despertado; el que avisó espera. Con esa semántica
Hoare, el despertado corre justo cuando la condición es cierta. Es fácil de
razonar, pero difícil de implementar bien.
Casi todos los sistemas reales usan la semántica Mesa, por el lenguaje Mesa
de Xerox (Lampson y Redell, 1980): signal solo mueve al despertado a la cola
de listos. El que avisó sigue corriendo, y cualquier otro hilo puede tomar el
lock antes que el despertado. pthreads, Java, Linux y xv6 son Mesa. POSIX además
permite despertares espurios (spurious wakeups): pthread_cond_wait puede
retornar sin que nadie haya hecho signal.
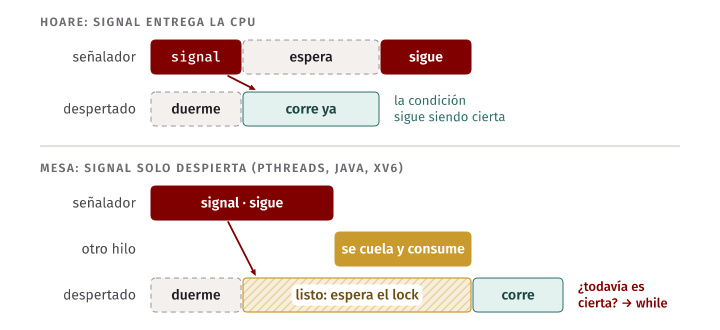
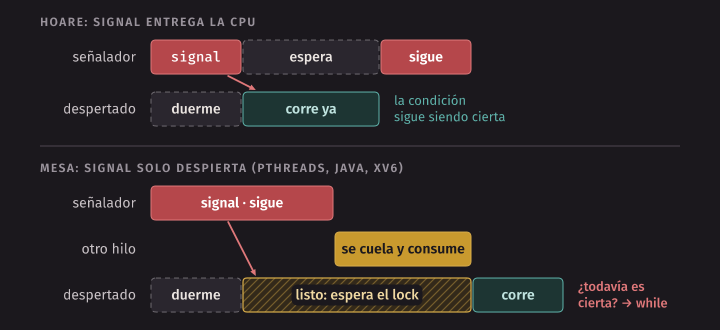
La regla práctica es sencilla: siempre while. Con while el código es
correcto bajo Mesa, bajo Hoare y con despertares espurios.
Intento 2: while con una sola CV
Con while, un consumidor que despierta vuelve a revisar count. Pero queda
otro error, más sutil:
| Paso | Tc1 | Tc2 | Tp | count |
Qué pasa |
|---|---|---|---|---|---|
| 1 | c1 c2 c3 (duerme) | 0 | Tc1 duerme. | ||
| 2 | duerme | c1 c2 c3 (duerme) | 0 | Tc2 también. | |
| 3 | listo | duerme | p1 p2 p4 p5 | 1 | Tp pone un dato y despierta a Tc1. |
| 4 | listo | duerme | p6 p1 p2 p3 (duerme) | 1 | Lleno: Tp duerme. |
| 5 | c2 c4 c5 | listo | duerme | 0 | Tc1 consume y hace signal… que despierta a Tc2. |
| 6 | c6 c1 c2 c3 (duerme) | listo | duerme | 0 | Vacío: Tc1 vuelve a dormir. |
| 7 | duerme | c2 c3 (duerme) | duerme | 0 | Tc2 revisa: vacío. Los tres duermen. |
En el paso 5, Tc1 debía despertar al productor, pero con una sola CV despertó a otro consumidor. Ahora nadie despertará a nadie.
La solución: while y dos CVs
Los consumidores deben despertar solo a productores, y los productores solo a
consumidores. Con dos CVs, empty (“hay espacio”) y fill (“hay datos”), y un
buffer circular de max celdas, queda la versión de
pc.c:
void produce(int value) {
    pthread_mutex_lock(&mutex);
    while (count == max)
        pthread_cond_wait(&empty, &mutex);
    put(value);                         // buffer[fill_ptr], fill_ptr++
    pthread_cond_signal(&fill);
    pthread_mutex_unlock(&mutex);
}

int consume(void) {
    pthread_mutex_lock(&mutex);
    while (count == 0)
        pthread_cond_wait(&fill, &mutex);
    int tmp = get();                    // buffer[use_ptr], use_ptr++
    pthread_cond_signal(&empty);
    pthread_mutex_unlock(&mutex);
    return tmp;
}
Con más de una celda hay más concurrencia: el productor llena varias sin
esperar a que alguien consuma. ./pc 4 2 3 100000 (buffer de 4, dos
productores, tres consumidores) verifica al final que la suma de lo consumido
sea la de lo producido.
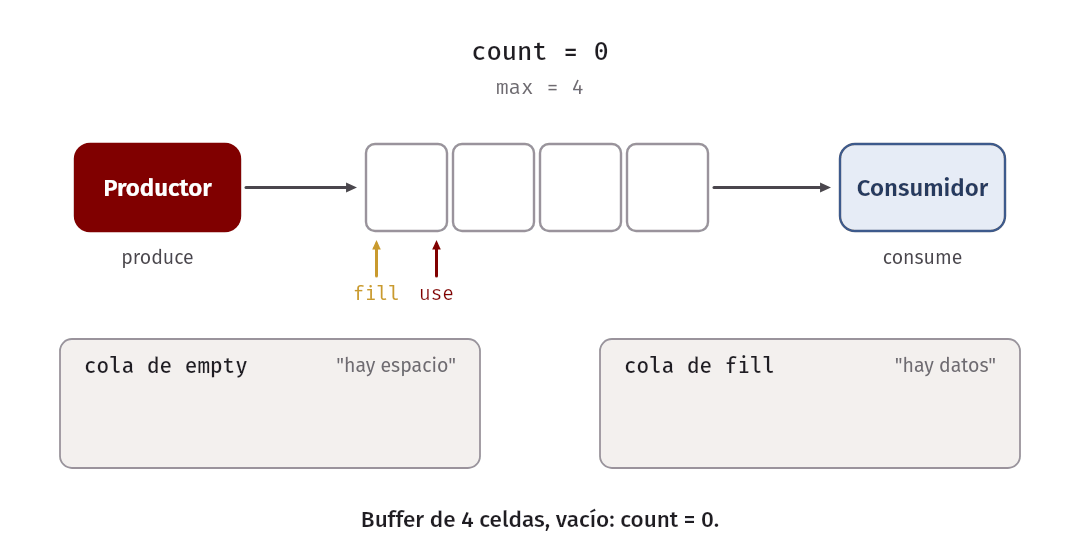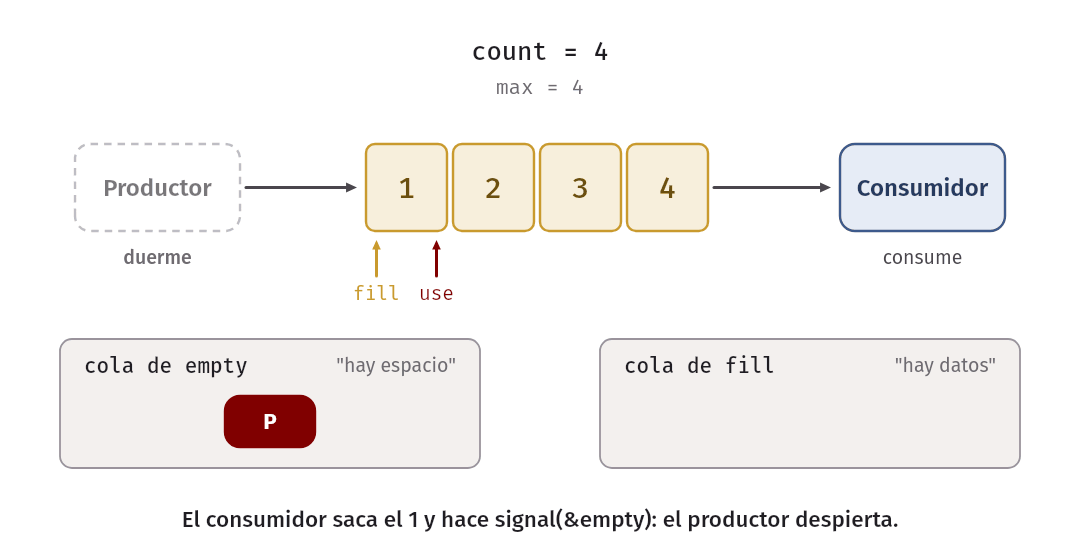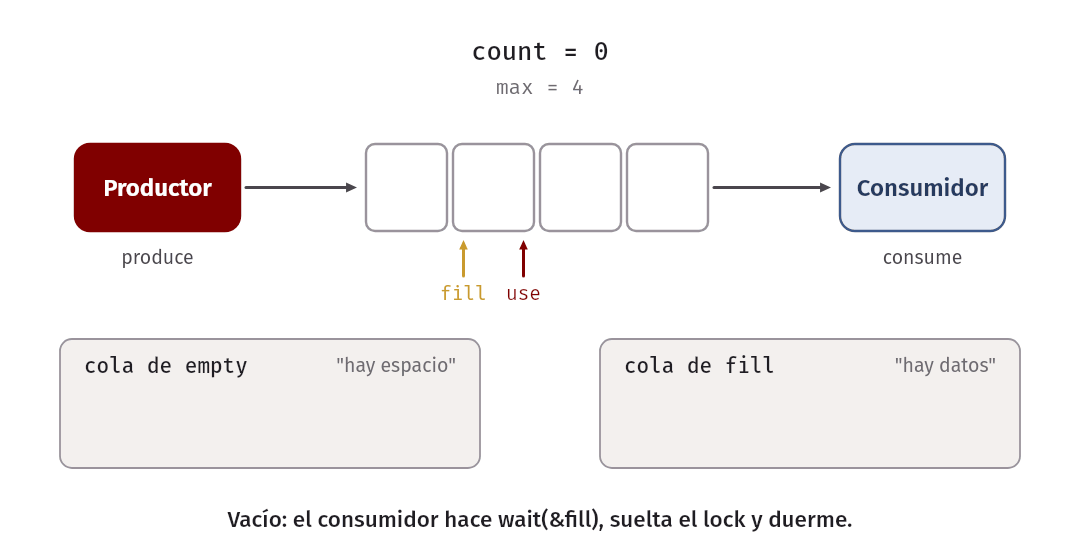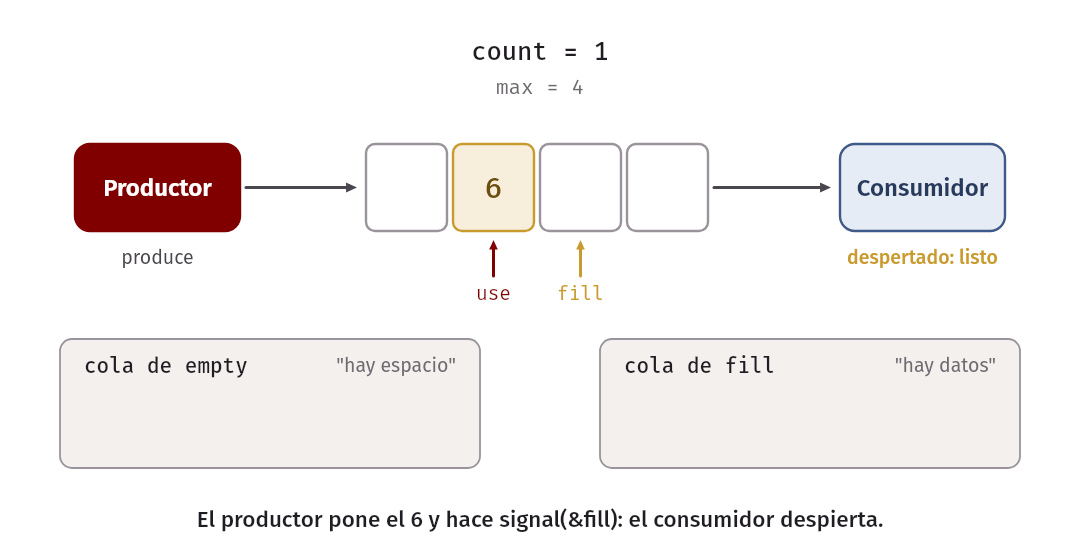
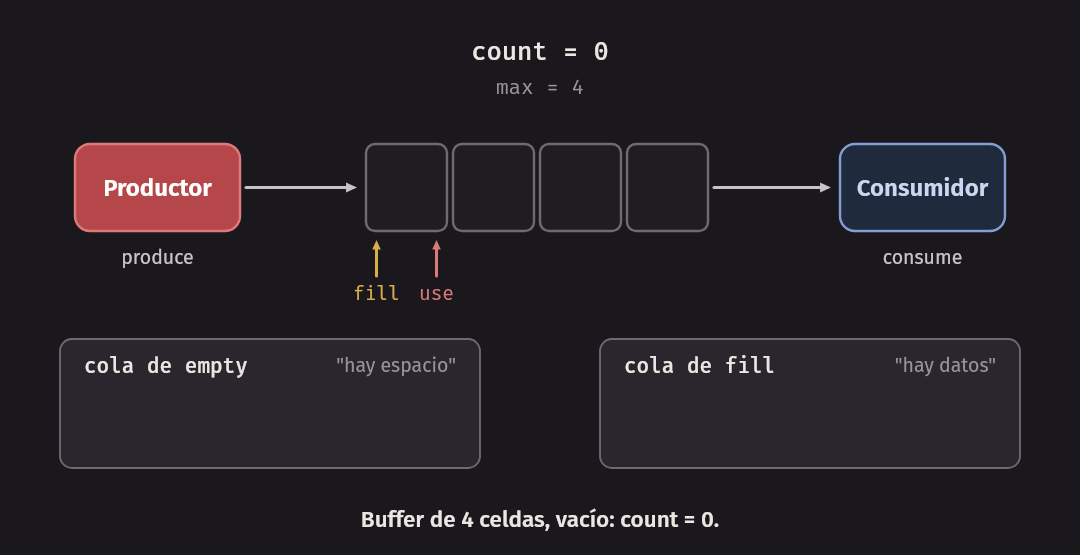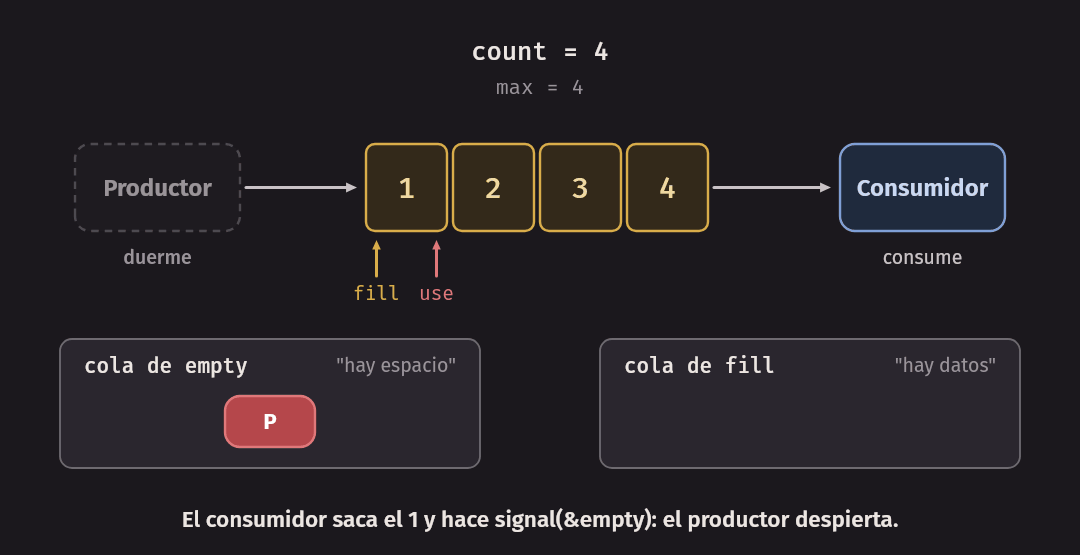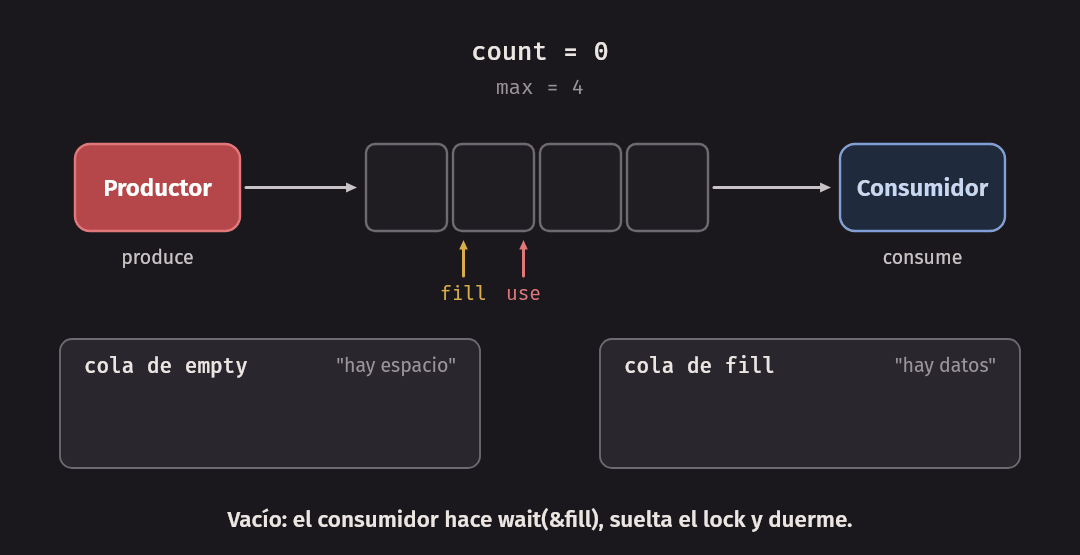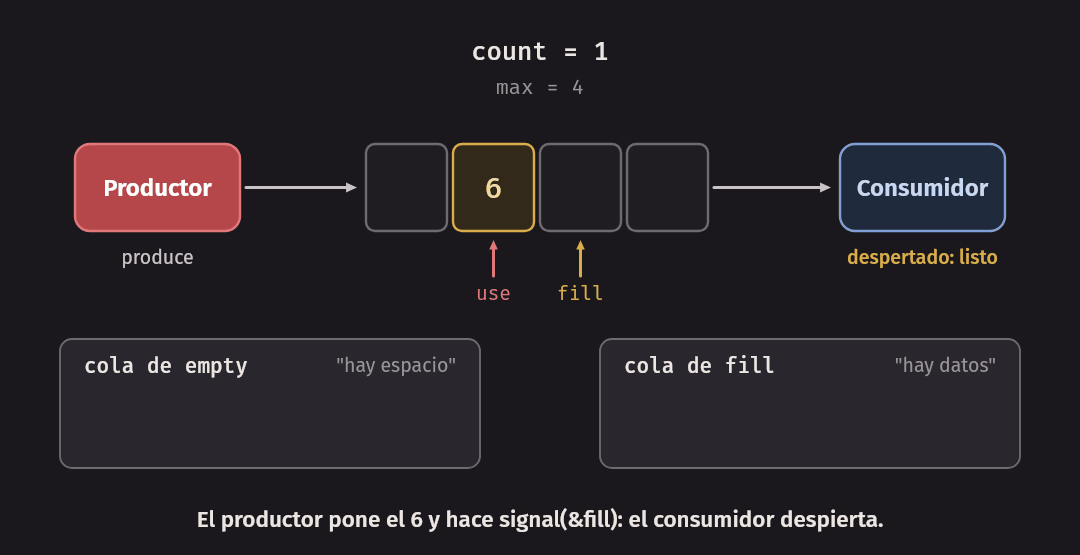
pcbug.c fuerza las dos intercalaciones de las
tablas. Con ./pcbug if, Tc2 se cuela y Tc1 lee el buffer vacío; con
./pcbug while, la misma intercalación termina bien porque Tc1 revisa otra vez.
Con ./pcbug onecv los tres hilos terminan dormidos y el watchdog lo detecta;
con ./pcbug twocv, el signal de Tc1 va a empty y despierta a Tp:
$ ./pcbug if
[   0 ms] Tc1: buffer vacío, wait
[  26 ms] Tc2: pide el lock
[  40 ms] Tp : put(1), signal
[  60 ms] Tc2: consume 1 (se coló)
[  60 ms] Tc1: despierta con el lock
[  60 ms] Tc1: get() con el buffer VACÍO: ¡error!
resultado: ERROR, un consumidor leyó un buffer vacío
Para que el error salga siempre, Tp retiene el lock un momento después del
signal, así Tc2 ya está formado en el mutex cuando Tc1 despierta. En el
contenedor, 10 de 10 corridas reproducen cada error.
Covering conditions
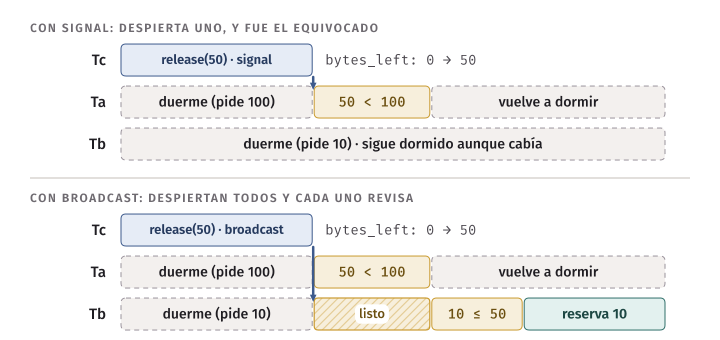
A veces no se sabe a quién despertar. Piensen en un asignador de memoria:
allocate(size) espera mientras bytes_left < size, y release(ptr, size)
suma bytes y hace signal. Supongan bytes_left = 0, un hilo Ta esperando 100
bytes y otro Tb esperando 10. Un tercero libera 50 y hace signal. Si despierta
a Ta, Ta revisa, ve que 50 no le alcanza y vuelve a dormir; Tb, que sí cabía,
sigue dormido.
La solución es pthread_cond_broadcast: despiertan todos, cada uno revisa su
condición (gracias al while) y el que no puede avanzar vuelve a dormir.
Lampson y Redell lo llamaron una covering condition. El costo es despertar
hilos de más, así que conviene solo cuando una misma CV representa condiciones
distintas.
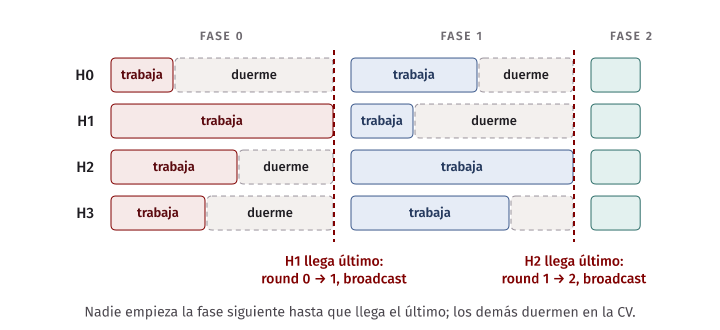
Una barrera (barrier) es otro caso natural de broadcast: nadie empieza la
fase siguiente hasta que todos terminaron la actual, y el último en llegar
despierta a todos (barrier.c).
Idea clave. Cuatro reglas para usar variables de condición: (1) toda espera tiene un estado explícito; (2) ese estado se lee y se cambia con el lock tomado; (3)
waitsiempre dentro de unwhile; (4) una CV por condición, obroadcastsi no se puede. Hacer elsignalcon el lock tomado no siempre es obligatorio, pero siempre es correcto.
Semáforos
Dijkstra propuso en los años 60 una sola primitiva que sirve tanto de lock como de mecanismo de espera: el semáforo. Es un entero con dos operaciones atómicas. En POSIX:
#include <semaphore.h>
sem_t s;
sem_init(&s, 0, 1);   // 0: compartido entre hilos; 1: valor inicial
sem_wait(&s);         // resta 1; si el valor queda negativo, duerme
sem_post(&s);         // suma 1; si alguien espera, despierta a uno
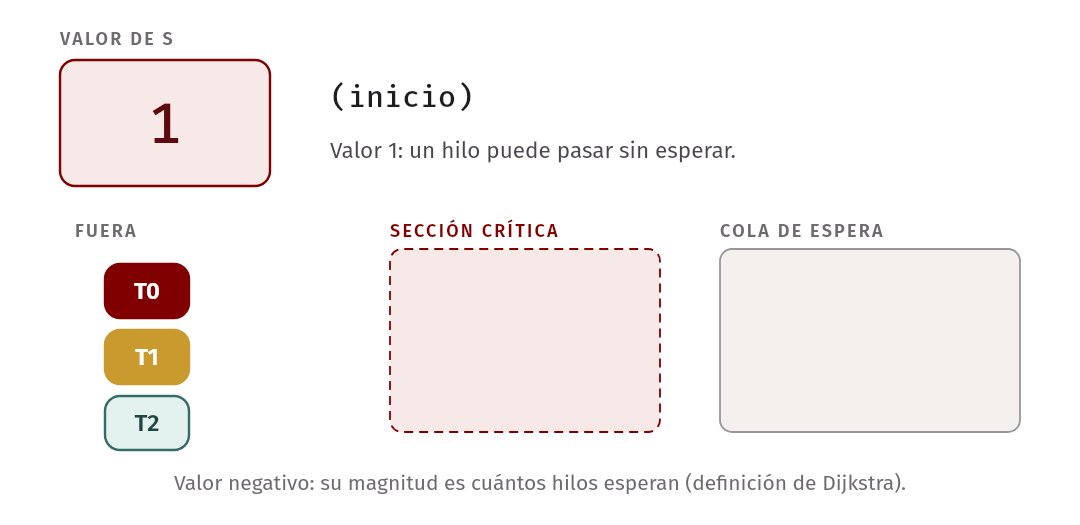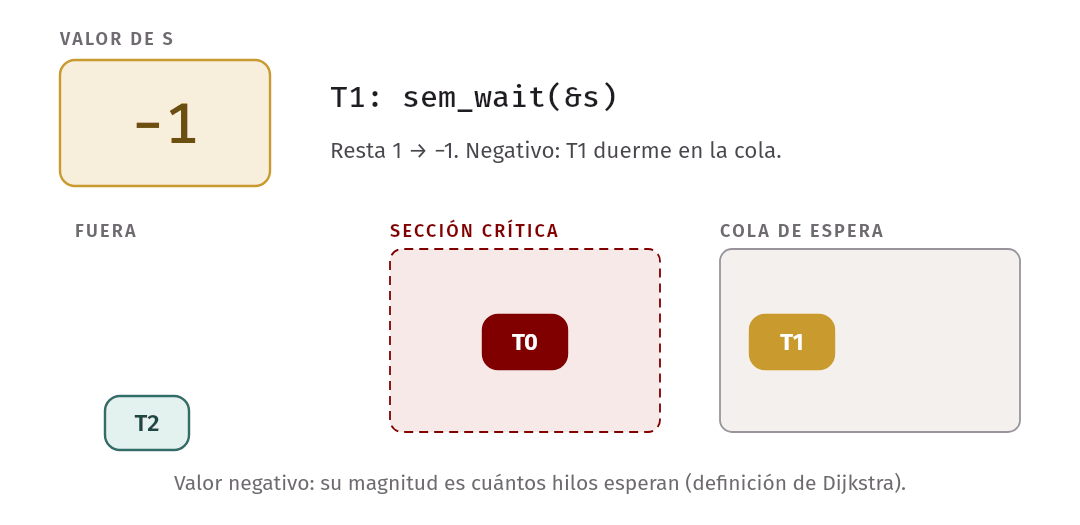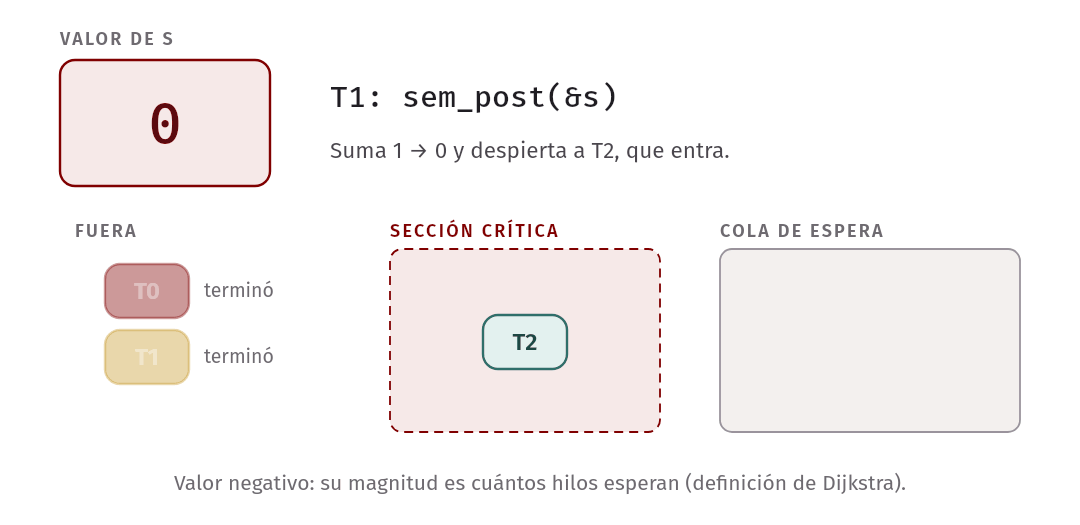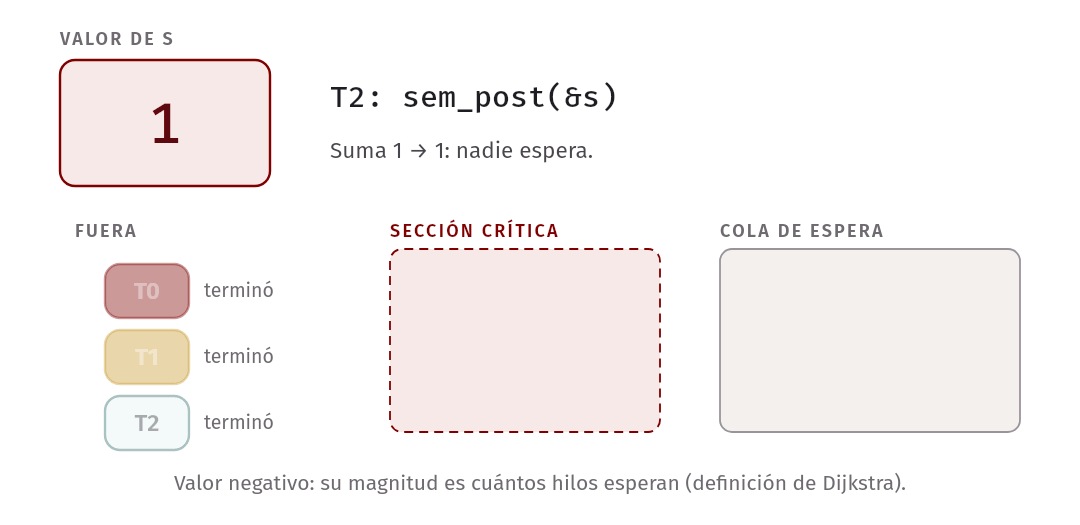
En la definición de Dijkstra, cuando el valor es negativo su magnitud es el número de hilos esperando. Un ejemplo con valor inicial 1 y tres hilos:
| Operación | Valor | Efecto |
|---|---|---|
| (inicio) | 1 | libre |
T0: sem_wait |
0 | T0 entra |
T1: sem_wait |
−1 | T1 duerme |
T2: sem_wait |
−2 | T2 duerme: dos esperan |
T0: sem_post |
−1 | despierta a T1, que entra |
T1: sem_post |
0 | despierta a T2, que entra |
T2: sem_post |
1 | nadie espera |
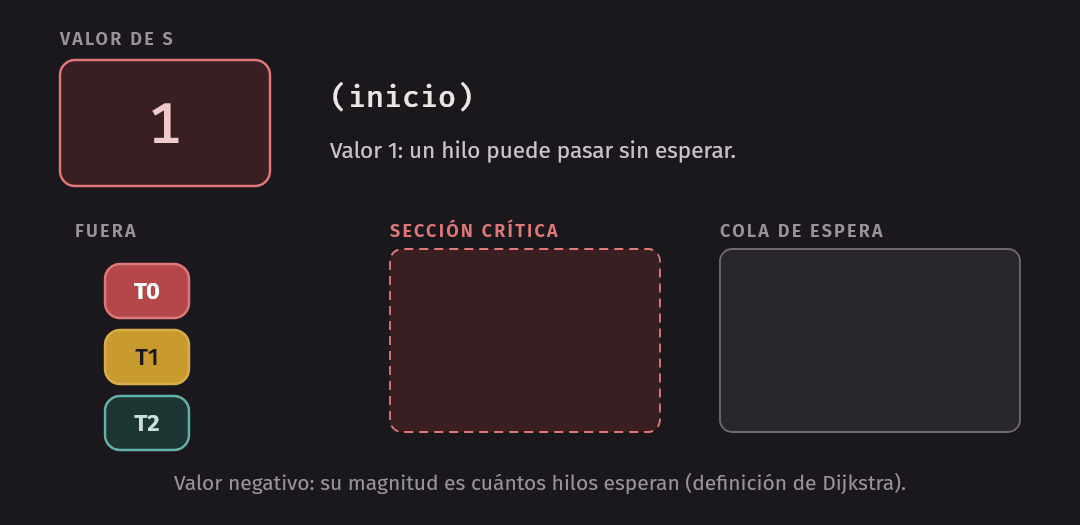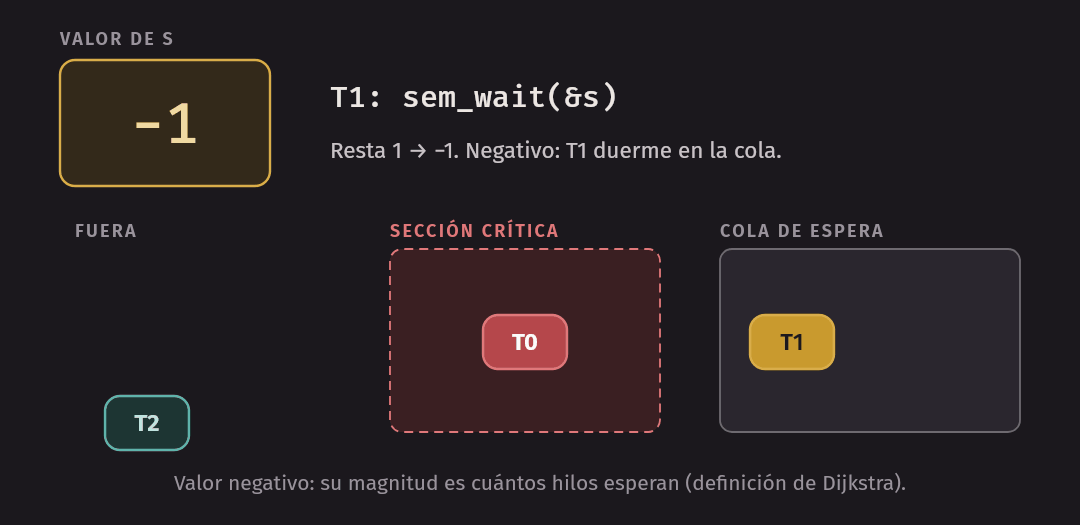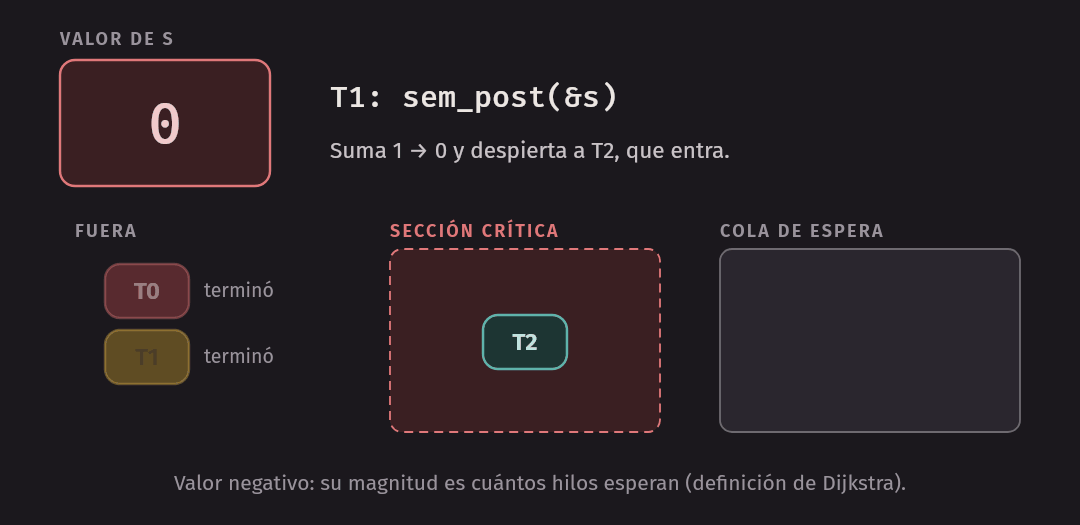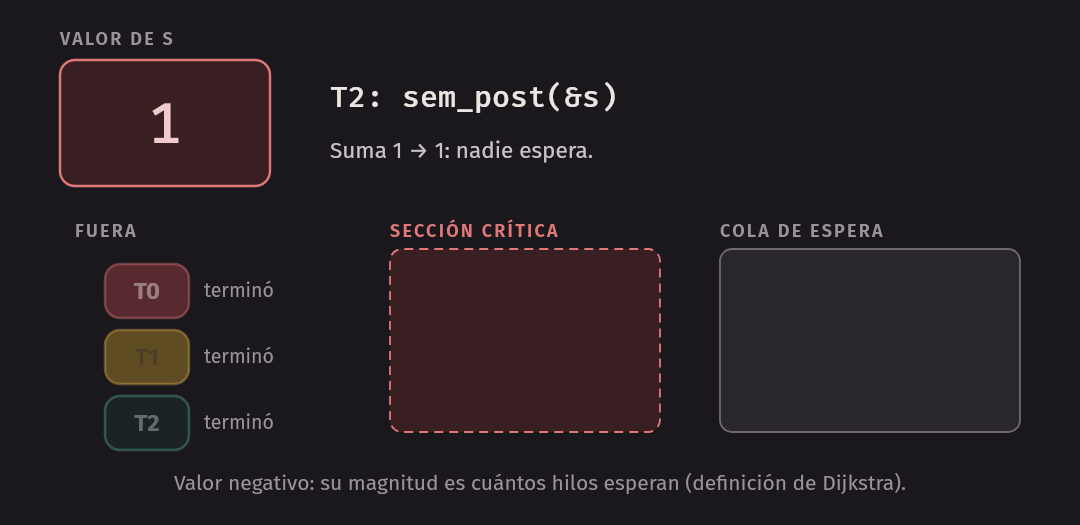
En Linux el valor nunca se ve negativo (sem_getvalue devuelve 0 si hay hilos
esperando), pero el modelo sirve igual para razonar.
Semáforo como lock y para ordenar
La tabla anterior ya muestra el primer uso: con valor inicial 1, un semáforo
es un lock (un semáforo binario). sem_wait es lock y sem_post es
unlock.
El segundo uso es ordenar eventos. Para que el padre espere al hijo, se
inicializa en 0: el padre hace sem_wait y el hijo, al terminar,
sem_post. Si el padre llega primero, el valor baja a −1 y duerme hasta que el
hijo lo sube a 0. Si el hijo llega primero, el valor sube a 1 y queda
anotado: el sem_wait del padre lo baja a 0 sin dormir. A diferencia de
signal, el semáforo recuerda el aviso, porque el valor es el estado. Es el
“roto 1” de la sección anterior, arreglado.
Una forma práctica de elegir el valor inicial: es cuántos pueden pasar sin esperar. Para un lock, 1; para esperar un evento, 0; para K recursos, K.
Productor/consumidor con semáforos
Dos semáforos bastan para las dos esperas: empty, inicializado en MAX, cuenta
los espacios libres, y full, inicializado en 0, cuenta los datos. El productor
hace sem_wait(&empty), put y sem_post(&full); el consumidor, lo simétrico.
No hace falta count: los semáforos son el estado.
Con un productor y un consumidor esto funciona con cualquier MAX. Con dos
productores y MAX > 1, los dos pueden pasar sem_wait(&empty) a la vez y
ejecutar put al mismo tiempo, escribiendo en la misma celda: se pierde un dato.
Falta exclusión mutua alrededor de put y get. La tentación es envolver todo
con un tercer semáforo mutex:
int consume(void) {
    sem_wait(&mutex);   // ¡mal! el mutex primero...
    sem_wait(&full);    // ...y luego dormir esperando un dato
    int v = get();
    sem_post(&mutex);
    sem_post(&empty);
    return v;
}
// produce() hace lo mismo con sem_wait(&mutex) y sem_wait(&empty)
Si el consumidor llega primero con el buffer vacío, toma mutex y duerme en
full con el mutex tomado. El productor llega, intenta tomar mutex y
duerme también. El consumidor espera un dato que solo el productor puede poner,
y el productor espera un mutex que tiene el consumidor: deadlock. La
corrección es poner el mutex adentro: primero se espera la condición
(empty o full) y recién después se toma el mutex, solo para la sección
crítica. sempc.c tiene las dos versiones:
./sempc ok consume los 100000 datos y ./sempc outside termina en deadlock
(el watchdog lo detecta).
Lectores y escritores
Muchas estructuras se leen mucho más de lo que se escriben. Varias lecturas
pueden ir a la vez; una escritura debe ir sola. El lock de lectores/escritores de
rwlock.c usa dos semáforos: lock protege el
contador readers, y writelock lo tienen o un escritor o el grupo de lectores.
void acquire_readlock(rwlock_t *rw) {
    sem_wait(&rw->lock);
    rw->readers++;
    if (rw->readers == 1)           // el primer lector bloquea
        sem_wait(&rw->writelock);   // a los escritores
    sem_post(&rw->lock);
}

void release_readlock(rwlock_t *rw) {
    sem_wait(&rw->lock);
    rw->readers--;
    if (rw->readers == 0)           // el último lector
        sem_post(&rw->writelock);   // deja pasar a un escritor
    sem_post(&rw->lock);
}
El escritor solo hace sem_wait(&rw->writelock) y sem_post. El problema es
la inanición (starvation) del escritor: si llegan lectores nuevos mientras
otros siguen leyendo, readers nunca vuelve a 0 y el escritor espera
indefinidamente. rwlock lo mide con lectores que leen durante un segundo
(10 ms dentro del lock, 1 ms fuera):
$ ./rwlock 8
[  54 ms] escritor: pide el lock
[1001 ms] los lectores se detienen
[1013 ms] escritor: entra tras esperar 959 ms (532 lecturas mientras tanto)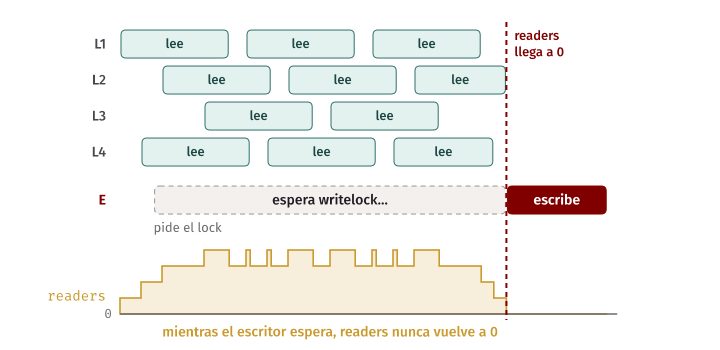
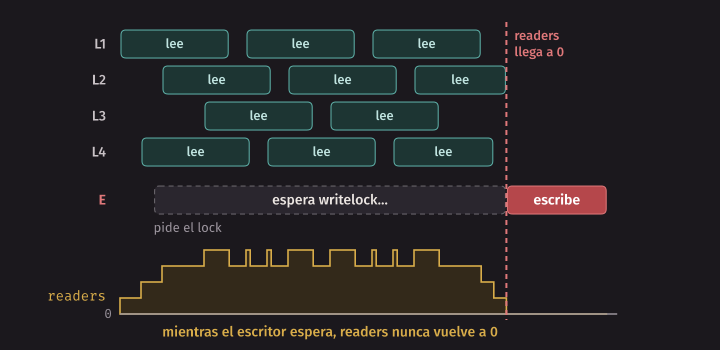
Con ./rwlock 1 hay huecos y el escritor entra en pocos milisegundos. Con ocho lectores que
se solapan, solo entra cuando los lectores se detienen. El arreglo
consiste en que, cuando un escritor espera, los lectores nuevos se formen
detrás de él; es parte del laboratorio.
Los filósofos comensales
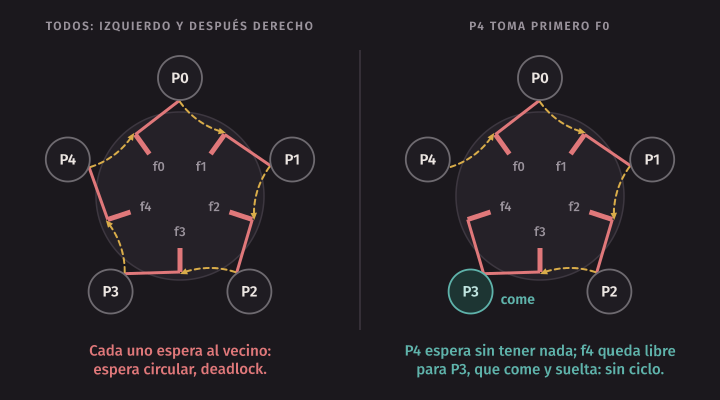
Cinco filósofos se sientan alrededor de una mesa redonda, con un tenedor entre cada par. Cada uno alterna entre pensar y comer, y para comer necesita los dos tenedores vecinos. Con cada tenedor como un semáforo de valor 1, la solución ingenua es tomar primero el izquierdo y después el derecho:
int left(int p)  { return p; }
int right(int p) { return (p + 1) % 5; }

void get_forks(int p) {
    sem_wait(&forks[left(p)]);
    sem_wait(&forks[right(p)]);
}
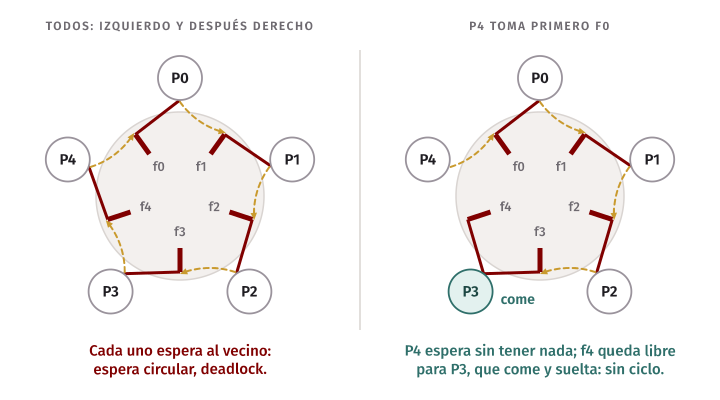
Si los cinco tienen hambre a la vez, cada uno toma su tenedor izquierdo y queda esperando el derecho, que tiene su vecino. Nadie suelta nada: es una espera circular y, por lo tanto, deadlock.
La solución es romper el ciclo: el último filósofo toma los tenedores al revés, primero f0 y después f4. Si P0 a P3 toman sus izquierdos, P4 espera f0 sin tener nada; f4 queda libre, P3 come y suelta, y la cadena se desarma. La idea general es tomar los locks en un orden global (el tenedor menor primero); la retomamos la semana 12.
philo.c tiene las dos versiones. Para que el
deadlock aparezca siempre, la primera vez cada filósofo espera 20 ms entre los
dos tenedores; el watchdog muestra el ciclo:
$ ./philo naive
[1059 ms] WATCHDOG: 1 s sin avance.
          Deadlock: espera circular.
  filósofo 0: tiene el tenedor 0, espera el 1
  filósofo 1: tiene el tenedor 1, espera el 2
  filósofo 2: tiene el tenedor 2, espera el 3
  filósofo 3: tiene el tenedor 3, espera el 4
  filósofo 4: tiene el tenedor 4, espera el 0
$ ./philo ordered
[  51 ms] todos comieron 1000 veces: sin deadlock
Throttling
Un semáforo con valor inicial K deja pasar a K hilos y hace esperar al
siguiente. Eso sirve para limitar (throttling) cuántos hilos están a la vez
en una parte costosa del programa: si cada hilo necesita mucha memoria en cierta
fase y entran todos a la vez, el sistema empieza a hacer thrashing.
./throttle 8 2 corre 8 hilos con límite 2 y mide el máximo que estuvo dentro a
la vez: 2.
Zemaphores: semáforos con un lock y una CV
¿Se puede construir un semáforo con las herramientas de la primera mitad? Sí, y
es corto. OSTEP lo llama Zemaphore; está en
throttle.c:
void zem_wait(zem_t *s) {
    pthread_mutex_lock(&s->lock);
    while (s->value <= 0)
        pthread_cond_wait(&s->cond, &s->lock);
    s->value--;
    pthread_mutex_unlock(&s->lock);
}

void zem_post(zem_t *s) {
    pthread_mutex_lock(&s->lock);
    s->value++;
    pthread_cond_signal(&s->cond);
    pthread_mutex_unlock(&s->lock);
}
Son las cuatro reglas: estado, lock, CV y while. A diferencia de Dijkstra,
value nunca baja de 0: no dice cuántos esperan (igual que en Linux).
Construir CVs con semáforos es mucho más delicado; las dos herramientas son
igual de expresivas, pero las CVs con while son más fáciles de usar bien.
Inversión de prioridad
Hasta aquí, los hilos que esperan un lock solo pierden el tiempo que el owner tarda en soltarlo. Con prioridades aparece una trampa. En la semana 3 vimos la regla 1 de MLFQ: si Prioridad(A) > Prioridad(B), corre A. Los sistemas de tiempo real (real time) llevan esa regla al extremo, con prioridades fijas y desalojo inmediato: siempre corre el hilo listo de mayor prioridad. Si se juntan esa regla y un lock, un hilo de prioridad alta puede quedar esperando a uno de prioridad media con el que no comparte nada.
Tres hilos y un lock
Una CPU y tres hilos: L (prioridad baja, 10), M (media, 20) y H (alta, 30). L y H comparten un lock; M no lo usa nunca. Contamos el tiempo en ticks:
- En t = 1, L toma el lock. Su sección crítica dura 4 ticks.
- En t = 2 llega H y desaloja a L, que se queda con el lock tomado.
- En t = 3, H pide el lock. Lo tiene L, así que H se bloquea. En ese mismo instante llega M.
- ¿Quién corre? H está bloqueado; entre M (20) y L (10), gana M. M corre sus 6 ticks completos, y mientras tanto L, el único que puede soltar el lock, no avanza.
- Recién en t = 9, cuando M termina, L sigue su sección crítica. La termina en t = 12 y por fin H obtiene el lock.
H esperó 9 ticks: los 6 de M más los 3 que le faltaban a L. Que H espere a L es normal: es el precio de la exclusión mutua, y está acotado por lo que dure la sección crítica. Lo grave es que H esperó a M, un hilo de menor prioridad que no toca el lock. Las prioridades quedaron invertidas: en la práctica, M le ganó a H. Y la espera no tiene cota: con más hilos de prioridad media, o con un M que no termina, H puede esperar indefinidamente.
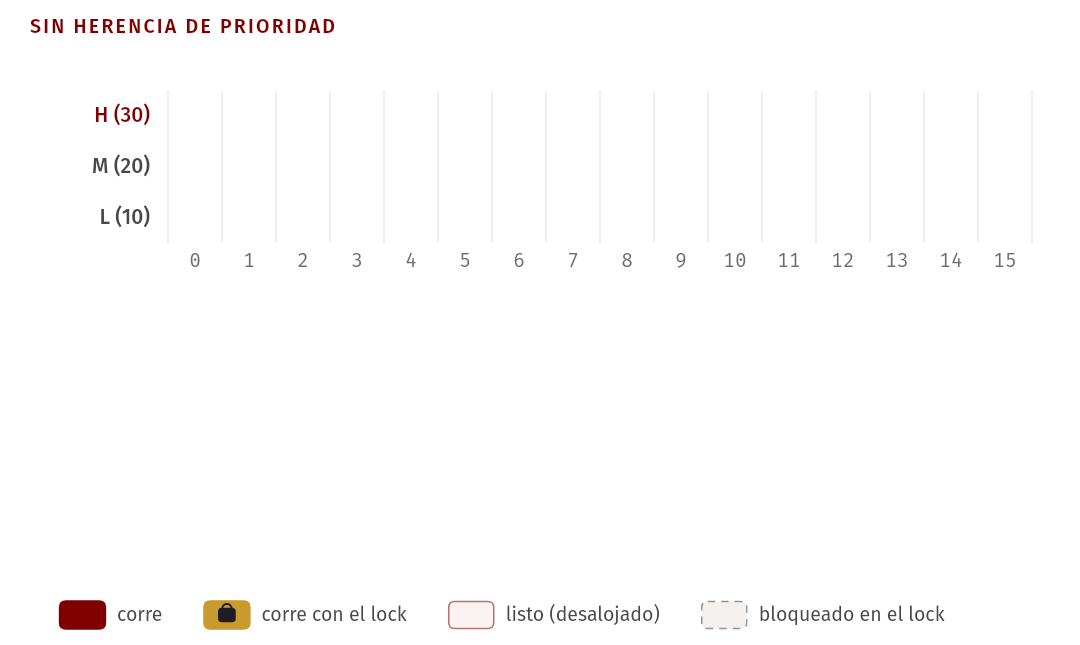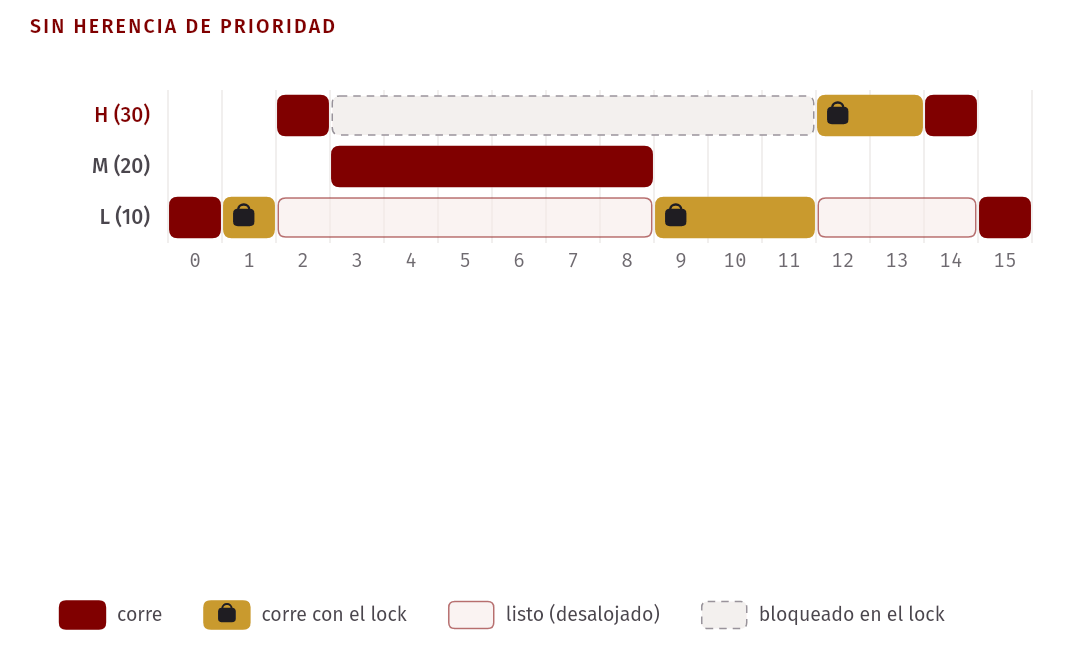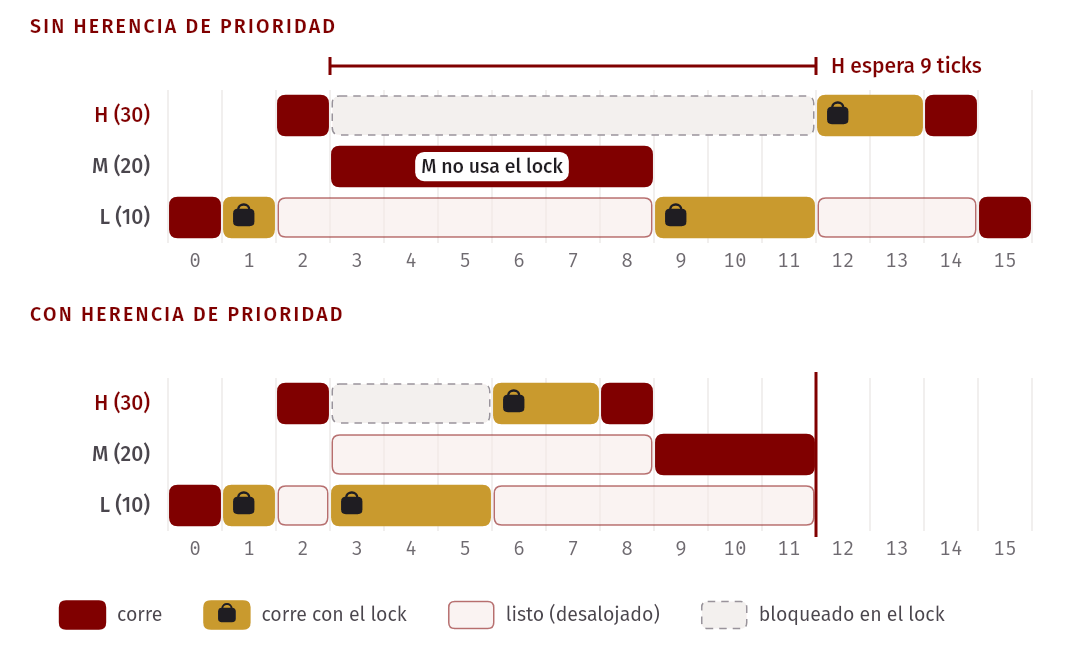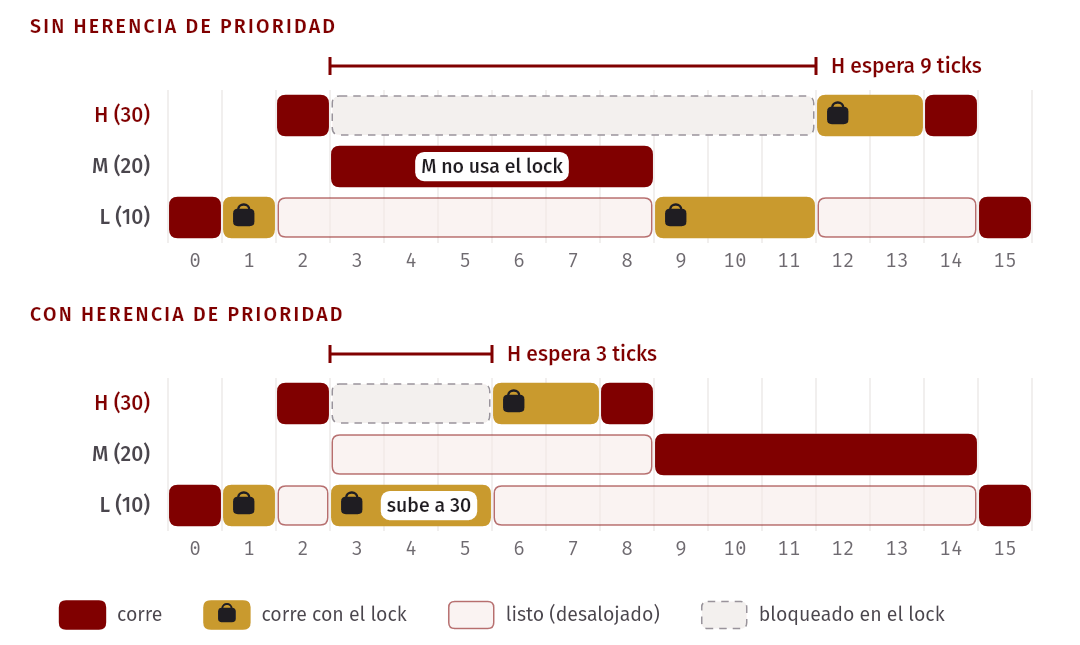
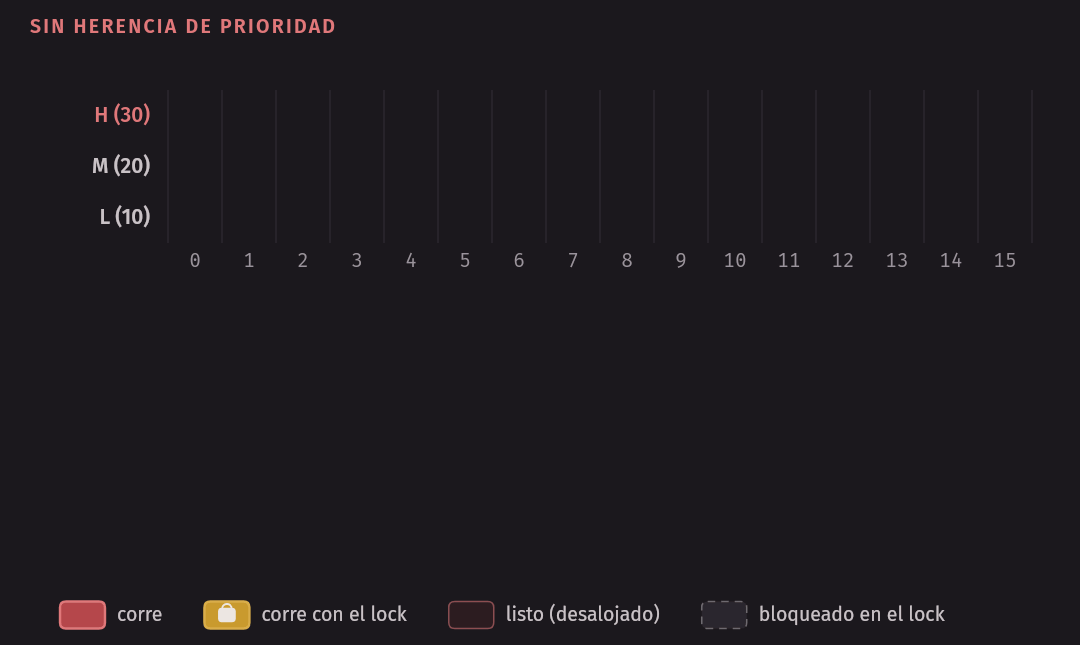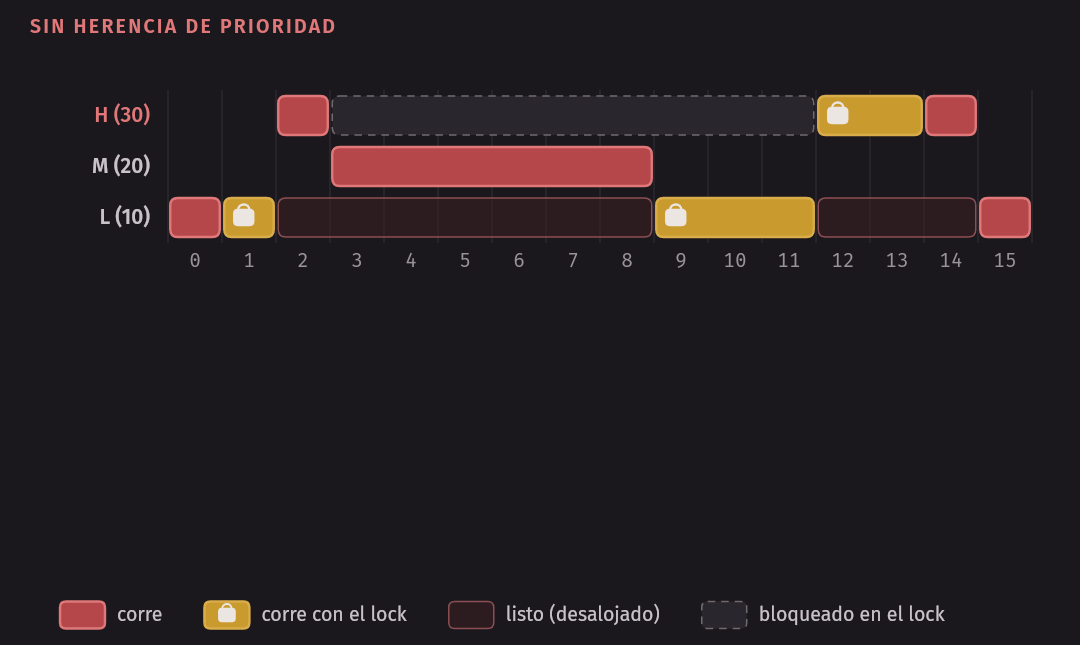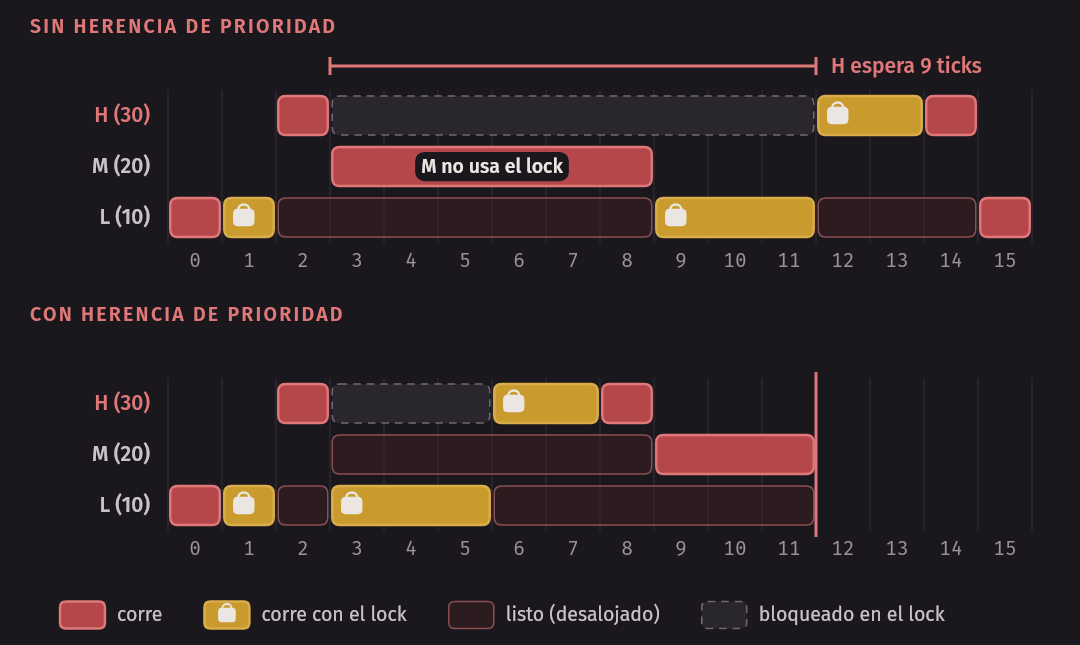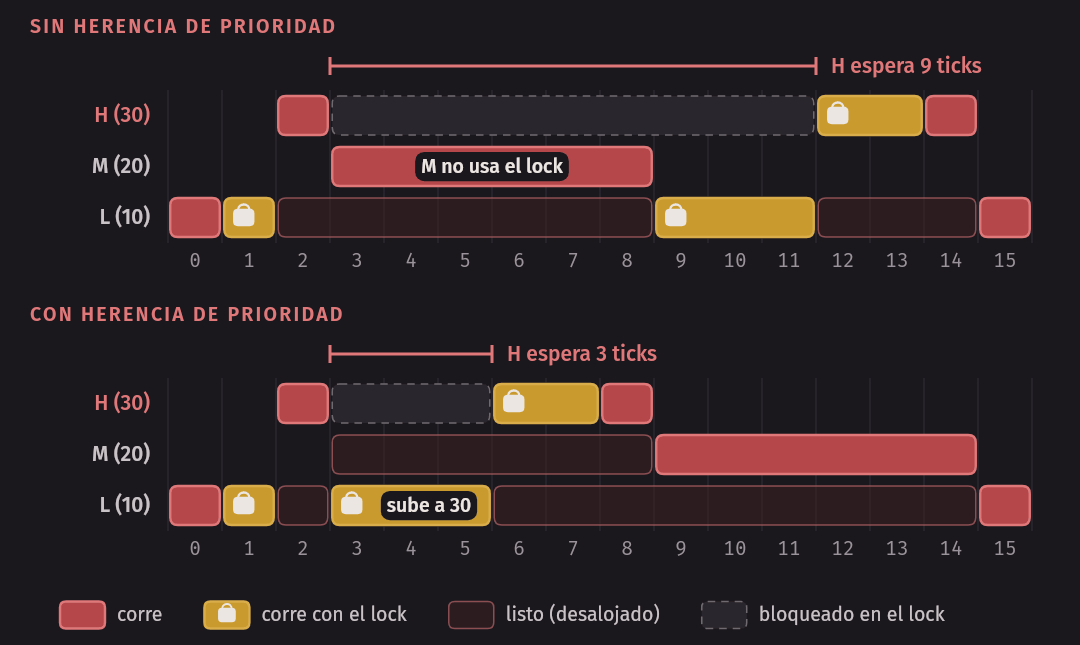
Idea clave. Hay inversión de prioridad (priority inversion) cuando un hilo de prioridad alta espera un recurso que tiene uno de prioridad baja, y un tercero de prioridad intermedia, que no usa ese recurso, desaloja al de prioridad baja. La espera del hilo alto deja de depender de la sección crítica y pasa a depender de cuánto trabajo intermedio haya.
El caso del Mars Pathfinder
En julio de 1997 el Mars Pathfinder aterrizó en Marte y bajó a la superficie al rover Sojourner. A los pocos días, la computadora de la sonda (con el sistema operativo de tiempo real VxWorks) empezó a reiniciarse sola, y cada reinicio cancelaba las actividades que se habían mandado desde la Tierra para ese día.
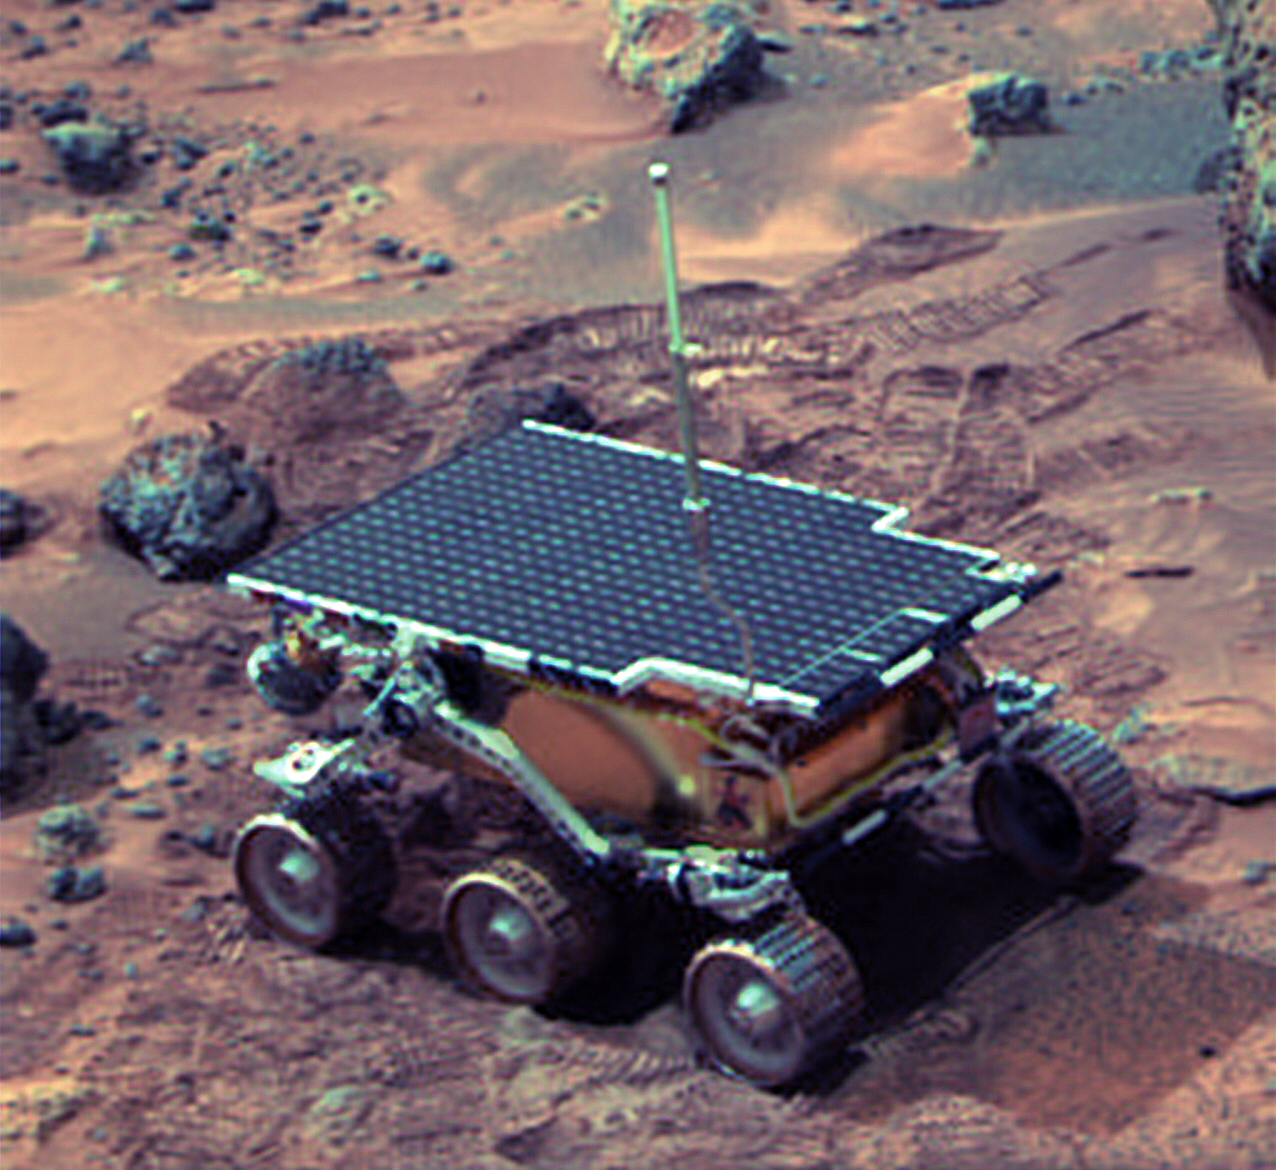
Mike Jones resumió el caso a fines de 1997, y Glenn Reeves, responsable del
software de vuelo, le respondió con los detalles. Los
datos de la sonda circulaban por un bus de información, administrado por
una tarea de prioridad alta (bc_dist) que debía terminar su trabajo en cada
ciclo del bus. Una tarea de prioridad baja, la que publicaba los datos
meteorológicos, usaba el mismo mecanismo de comunicación, protegido por un
semáforo de exclusión mutua dentro de select(). A veces esa tarea quedaba
desalojada con el semáforo tomado, mientras corrían tareas de prioridad
media; bc_dist se bloqueaba esperando ese semáforo y no terminaba a tiempo.
La tarea que programaba el ciclo siguiente detectaba que bc_dist no había
terminado, lo trataba como una falla grave y reiniciaba todo el sistema.
Es el esquema de la figura, con bc_dist como H y la tarea meteorológica como
L.
El equipo reprodujo el problema en una réplica de la sonda en la Tierra, con
la traza de VxWorks activada. El arreglo fue de una línea, en principio: VxWorks
ya implementaba herencia de prioridad, pero el semáforo se había creado sin
ella. Cambiaron una variable global que decidía si los semáforos de select()
se creaban con herencia y enviaron ese cambio a Marte como un parche. Después
de eso no hubo más reinicios. El problema ya había aparecido una o dos veces
en las pruebas antes del lanzamiento, pero como no se podía reproducir, se lo
atribuyó a una falla del hardware.
Soluciones
Herencia de prioridad (priority inheritance). Mientras un hilo tiene un lock que otro espera, corre con la prioridad del que espera (la mayor, si son varios). Al soltar el lock, vuelve a su prioridad base. En el ejemplo: en t = 3 H se bloquea y L sube a 30, así que M (20) ya no puede desalojarlo. L termina su sección crítica en t = 6, baja a 10, y H obtiene el lock tras 3 ticks; M corre después. H sigue esperando a L, pero solo lo que dura la sección crítica: la espera vuelve a estar acotada. La herencia se propaga en cadena: si L a su vez espera un lock de otro hilo, ese otro hereda también.
Techo de prioridad (priority ceiling). Cada lock tiene un techo: la mayor prioridad de los hilos que lo usan (aquí 30, la de H). Quien toma el lock sube al techo de inmediato, sin esperar a que alguien se bloquee. En el ejemplo, L corre con prioridad 30 desde t = 1; cuando llega H, tiene la misma prioridad y no puede desalojarlo: espera listo, no bloqueado en el lock. Hay que conocer de antemano qué hilos usan cada lock, algo razonable en un sistema de tiempo real diseñado con cuidado. (Esta es la variante “inmediata”, la de POSIX. El protocolo original de Sha, Rajkumar y Lehoczky es más fino y además evita los deadlocks entre esos locks.)
Deshabilitar las interrupciones. En un sistema pequeño con una sola CPU, la solución de la semana 10 también sirve: si nadie puede desalojar al owner del lock mientras está en la sección crítica, no hay nadie de prioridad media que se cuele. Solo vale para secciones críticas muy cortas (mientras tanto el sistema no atiende a nadie, ni siquiera a H) y no sirve con varias CPUs.
priosim.c simula las tres variantes con el ejemplo de esta sección, sin
privilegios y siempre con la misma salida. X es correr con el lock, #
correr, . estar listo y - estar bloqueado en el lock:
$ ./priosim none
...
t= 3  H pide el lock: lo tiene L, se bloquea
t= 3  la CPU pasa a M
t= 9  M termina
t= 9  la CPU pasa a L
t=12  L suelta el lock
t=12  H obtiene el lock (esperó 9 ticks)
...
        0123456789012345
H (30)    #---------XX#
M (20)     ######
L (10)  #X.......XXX...#
$ ./priosim inherit
...
t= 3  H pide el lock: lo tiene L, se bloquea
t= 3  L sube a prioridad 30
t= 3  la CPU pasa a L
t= 6  L suelta el lock
t= 6  L vuelve a prioridad 10
t= 6  H obtiene el lock (esperó 3 ticks)
...
        0123456789012345
H (30)    #---XX#
M (20)     ......######
L (10)  #X.XXX.........#
$ ./priosim ceiling
...
        0123456789012345
H (30)    ...#XX#
M (20)     ......######
L (10)  #XXXX..........#
Con techo, H no tiene ni un -: nunca se bloquea en el lock, porque cuando le
toca correr el lock ya está libre.
En Linux: PTHREAD_PRIO_INHERIT
POSIX permite elegir el protocolo de cada mutex con
pthread_mutexattr_setprotocol: PTHREAD_PRIO_NONE (el de siempre),
PTHREAD_PRIO_INHERIT (herencia) o PTHREAD_PRIO_PROTECT (techo, que se fija
con pthread_mutexattr_setprioceiling):
pthread_mutexattr_t ma;
pthread_mutexattr_init(&ma);
pthread_mutexattr_setprotocol(&ma, PTHREAD_PRIO_INHERIT);
pthread_mutex_init(&m, &ma);
prioinv.c arma el ejemplo con hilos de verdad.
Los tres usan la política SCHED_FIFO de Linux (prioridades fijas de tiempo
real, la regla 1 sin nada más) y sched_setaffinity los fija a la CPU 0, para
que compitan por una sola CPU. L toma el lock y lo usa 50 ms de CPU; a los
10 ms llega H, y justo después M, que usa 200 ms de CPU:
$ ./prioinv none
protocolo: none
[   0 ms] L (10): toma el lock
[  10 ms] H (30): pide el lock
[  12 ms] M (20): empieza (no usa el lock)
[ 212 ms] M (20): termina
[ 250 ms] L (10): suelta el lock
[ 250 ms] H (30): obtiene el lock, esperó 240 ms
$ ./prioinv inherit
protocolo: inherit
[   0 ms] L (10): toma el lock
[  10 ms] H (30): pide el lock
[  51 ms] L (10): suelta el lock
[  51 ms] H (30): obtiene el lock, esperó 41 ms
[  56 ms] M (20): empieza (no usa el lock)
[ 256 ms] M (20): termina
Es la misma historia que la simulación: sin herencia, H espera 240 ms = 200 (todo M) + 40 (el resto de L), como los 9 ticks = 6 + 3; con herencia, solo unos 40 ms: lo que le faltaba a L, como los 3 ticks. (Los milisegundos cambian un poco de una corrida a otra.)
Cambiar a SCHED_FIFO requiere privilegios (la capability CAP_SYS_NICE):
un hilo de tiempo real que gira sin parar puede acaparar una CPU. env/run.sh
lanza el contenedor del curso con esa capability, así que ahí la versión real
funciona:
$ env/run.sh sh -c 'cd code/week-11 && make prioinv && ./prioinv none && ./prioinv inherit'Sin ella (un docker run sin --cap-add=SYS_NICE), prioinv solo avisa y
priosim muestra lo mismo simulado.
En una instalación de Linux propia basta con sudo ./prioinv none.
¿Cómo hace el kernel para saber a quién subirle la prioridad? El futex de la
semana 10 guarda en su palabra solo 0, 1 o 2: dice si el lock está tomado, pero
no quién lo tiene. Los mutex con PTHREAD_PRIO_INHERIT usan otra variante,
el PI futex (FUTEX_LOCK_PI): la palabra guarda el identificador (TID) del
owner del lock. Cuando un hilo se bloquea, el kernel lee ese TID, encuentra al
owner y le presta la prioridad, a través de su rt-mutex, el lock del kernel
que implementa la herencia (también en cadena). Sin competencia, tomar y soltar
el lock sigue sin entrar al kernel, igual que el futex de dos fases.
Con la política normal de Linux (SCHED_OTHER, la de CFS) el problema es mucho
menos grave: ningún hilo se queda sin CPU por completo, así que L termina
avanzando aunque más lento. La inversión de prioridad es, sobre todo, un
problema de los sistemas de tiempo real, donde las prioridades son estrictas y
los plazos importan.
Lectura. El resumen de Mike Jones, What really happened on Mars? (1997), y la respuesta de Glenn Reeves; las páginas man de
pthread_mutexattr_setprotocolysched(7); en la documentación del kernel de Linux, RT-mutex subsystem with PI support y Lightweight PI-futexes. Opcional: Tanenbaum y Bos, Modern Operating Systems, 5.ª ed., sec. 2.4.10.
En xv6. El planificador de xv6 es Round Robin, sin prioridades, así que esta inversión no puede ocurrir. Además,
acquiredeshabilita las interrupciones en su CPU mientras se tiene un spinlock: nadie desaloja al owner dentro de la sección crítica. Es la tercera solución, aplicada a todos los spinlocks del kernel. Lossleeplocksí pueden quedar tomados por un proceso desalojado, pero como todos tienen la misma prioridad, el owner vuelve a correr en su turno.
En xv6: sleep y wakeup
El kernel de xv6 no tiene pthreads, pero necesita esperar todo el tiempo: a que
un hijo termine, a que llegue un byte a un pipe, a que el disco termine una
lectura. Su mecanismo son tres funciones de kernel/proc.c.
En xv6.
sleep_prepare(chan)anota enp->chanque el proceso espera en el canalchan, conp->locktomado.sleep()vuelve a tomarp->locky, solo sip->chansigue distinto de 0, ponep->state = SLEEPINGy llama asched().wakeup(chan)recorre la tabla de procesos y, a cada uno conp->chan == chan, le borra el canal (p->chan = 0) y, si ya estaba dormido, lo pasa aRUNNABLE. Hasta el commit68337b6(mayo de 2026) xv6 tenía en su lugarsleep(chan, lk), que soltaba el lock de la condición por dentro, comopthread_cond_wait.
Un canal es solo una dirección que acuerdan el que duerme y el que despierta;
no hay un objeto CV. wakeup despierta a todos los procesos del canal, así
que es un broadcast, y la semántica es Mesa: quien despierta debe volver a
revisar su condición.
¿Cómo se evita aquí la carrera entre despertar y dormir? Con el orden de las
llamadas. Así espera piperead en kernel/pipe.c (recortado):
acquire(&pi->lock);
while (pi->nread == pi->nwrite && pi->writeopen) {
    sleep_prepare(&pi->nread);
    release(&pi->lock);
    sleep();
    acquire(&pi->lock);
}
// copiar bytes, pi->nread++ ...
wakeup(&pi->nwrite);
release(&pi->lock);
El proceso se anota en el canal antes de soltar pi->lock. Si el escritor
llega entre el release y el sleep(), su wakeup borra el canal y sleep()
retorna sin dormir. Si el lector se anotara después de soltar el lock, el
wakeup no encontraría a nadie. Y pi->lock sigue siendo necesario: hace
atómicos “revisar y anotarse” frente a “cambiar y despertar”, como el mutex de
pthread_cond_wait.
En xv6. El pipe es un bounded buffer con dos canales.
nread == nwritees “vacío” ynwrite == nread + PIPESIZEes “lleno”. Los lectores duermen en&pi->nread(elfilldepc.c) y los escritores en&pi->nwrite(elempty). Enpipewritela espera está escrita conif, pero dentro dewhile (i < n): al despertar, el lazo vuelve a revisar si el buffer está lleno. Es unwhiledisfrazado.
El padre que espera al hijo también aparece en el kernel. kwait() toma
wait_lock, busca un hijo ZOMBIE y, si no hay, hace sleep_prepare(p) sobre
su propia struct proc, suelta wait_lock, duerme y vuelve a tomar el lock,
dentro de un for (;;). kexit() toma wait_lock, hace wakeup(p->parent) y
recién después se marca ZOMBIE y suelta el lock: el padre no puede revisar
hasta tener wait_lock, y para entonces el hijo ya es zombi. Es join.c:
done es pp->state == ZOMBIE, m es wait_lock, c es el canal p.
Resumen
- Una variable de condición es una cola para dormir hasta que un estado
cambie.
pthread_cond_waitsuelta el lock y duerme en un solo paso, y vuelve a tomar el lock antes de retornar. - Se necesitan tres piezas: estado, lock y CV. Sin estado, un aviso temprano se pierde; sin lock, revisar y dormir no son atómicos.
- Con semántica Mesa despertar es solo una pista: siempre
while. El productor/consumidor correcto usawhiley dos CVs;broadcastsirve cuando no se sabe a quién despertar. - Un semáforo es un entero:
sem_waitresta y quizá duerme,sem_postsuma y quizá despierta. El valor inicial es cuántos pueden pasar sin esperar: 1 para un lock, 0 para ordenar, K para limitar. - Con semáforos, el mutex va adentro de
empty/full; el lock de lectores/escritores simple causa inanición; los filósofos evitan el deadlock si uno toma los tenedores al revés. - Inversión de prioridad: un hilo de prioridad media desaloja al owner de
un lock que espera uno de prioridad alta, y la espera deja de tener cota (el
Mars Pathfinder, 1997). Se evita con herencia de prioridad
(
PTHREAD_PRIO_INHERIT, PI futex en Linux), con techo de prioridad o, en sistemas pequeños, deshabilitando las interrupciones. - En xv6,
sleep_prepare,sleepywakeupsobre un canal cumplen el papel de las variables de condición; así esperankwaity los pipes.
Ejercicios
- Muestren una intercalación (como las tablas de este capítulo) en la que usar
ifen lugar dewhilealrededor dewaitrompe el productor/consumidor. Comprueben con./pcbug ify./pcbug whileque su razonamiento coincide. - ¿A qué valor se inicializa un semáforo usado como lock? ¿Y uno usado para
que el padre espere a que un hilo termine? Expliquen qué pasa en el segundo
caso si el hijo termina antes de que el padre llegue a
sem_wait. - En
pc.c, reemplacen las dos CVs por una sola y usenbroadcasten lugar designal. ¿El programa vuelve a ser correcto? Midan el tiempo contime ./pc 1 1 4 1000000en las dos versiones y expliquen la diferencia. - ¿Por qué la solución ingenua de los filósofos produce deadlock? Propongan otra forma de evitarlo distinta de invertir el orden de un filósofo (por ejemplo, con un semáforo que limite cuántos se sientan a la mesa) y argumenten por qué no hay espera circular.
- Modifiquen
rwlock.cpara que el escritor no sufra inanición: cuando un escritor espera, los lectores nuevos no deben entrar. Verifiquen con./rwlock 8que el tiempo de espera del escritor baja. - Implementen una barrera con semáforos (sin mutex ni CVs de pthreads) y
pruébenla con el esqueleto de
barrier.c. ¿Cuántos semáforos necesitan para que sea reutilizable? - En
kernel/pipe.c, ¿qué pasaría sipipereadllamara arelease(&pi->lock)antes desleep_prepare(&pi->nread)? Describan la intercalación con un escritor que lleva a un lector dormido con datos en el pipe. - En el ejemplo de
priosim.c, agreguen un segundo hilo de prioridad media, M2 (prioridad 20, llega en t = 4, 5 ticks de CPU, sin lock). Dibujen a mano las líneas de tiempo sin herencia y con herencia, y calculen cuánto espera H el lock en cada caso. Comprueben agregando M2 ath[]enpriosim.c(con su propio guion, y subiendoNTa 4). - En
priosim.c, cambien la prioridad de M a 40 (mayor que la de H; cambien.basey.prio). ¿H sigue esperando a M? ¿Es inversión de prioridad? ¿Cambia algo la herencia? Justifiquen. - La regla 5 de MLFQ (priority boost, semana 3) sube periódicamente a todos los trabajos a la cola más alta. ¿Acotaría la espera de H en un MLFQ con un lock como el de esta sección? ¿Lo resolvería tan bien como la herencia?
- Deshabilitar las interrupciones evita la inversión en una CPU. Expliquen por qué no sirve con dos CPUs (piensen dónde corre M) y por qué obliga a que la sección crítica sea corta.