
Apuntes · Capítulo 12Persistencia
Bugs de concurrencia, eventos y dispositivos de E/S
Bugs de concurrencia, eventos y dispositivos de E/S
Llevamos cuatro semanas construyendo herramientas de concurrencia: hilos, locks, variables de condición y semáforos. Esta semana cerramos esa parte con dos preguntas: ¿qué errores se cometen en la práctica con esas herramientas?, y ¿se pueden atender muchas cosas a la vez sin hilos?
En la segunda mitad empieza la persistencia: cómo el sistema operativo habla con un dispositivo, y cómo funciona un disco duro, con ejemplos del código de xv6-riscv.
Ruta de lectura.
- Antes de clase (15–20 min): «Qué bugs aparecen en la práctica», «Las cuatro condiciones», de «Deadlock», y «El dispositivo canónico», de «Dispositivos de E/S».
- En clase: sesión A, «Deadlock» y «Concurrencia basada en eventos»; sesión B, «Dispositivos de E/S» y «Discos duros».
- Después de clase: repasar el «Resumen», rehacer «El banquero, paso a paso» y el «Ejemplo resuelto» de los discos, y resolver los «Ejercicios». Para ampliar: OSTEP cap. 32 a 37, las lecturas del recuadro sobre el banquero y «Lo que bloquea sin avisar».
Lectura. OSTEP cap. 32 Common Concurrency Problems, cap. 33 Event-based Concurrency (Advanced), cap. 34 (resumen de concurrencia), cap. 35 (diálogo sobre persistencia), cap. 36 I/O Devices y cap. 37 Hard Disk Drives. El código está en
code/week-12;make testcorre todas las demostraciones en el contenedor del curso.
Qué bugs aparecen en la práctica
En 2008, Shan Lu y sus colegas estudiaron 105 bugs de concurrencia ya corregidos en MySQL, Apache, Mozilla y OpenOffice: 74 no eran deadlock y 31 sí. De los 74, el 97 % caía en dos patrones: violación de atomicidad y violación de orden.
Violación de atomicidad
El programador supone que un grupo de accesos es atómico, pero nada lo garantiza. Por ejemplo, en la caché de un servidor web:
// Hilo 1: responder desde la caché
if (c->page != NULL)
    send(sock, c->page->data, c->page->len, 0);

// Hilo 2: invalidar la caché
free(c->page);
c->page = NULL;
Si al hilo 1 lo desalojan entre la verificación y el uso, y el hilo 2 libera
la página y pone el puntero en NULL, el hilo 1 leerá NULL->data: un
segfault. Peor aún, si ya había cargado el puntero, usará memoria liberada
sin que nadie lo note. La solución es la de la semana 10: un lock que proteja
todo el grupo de accesos (la verificación y el uso juntos) en los dos
hilos.
Violación de orden
Se espera que A ocurra antes que B, pero el orden no se impone:
struct queue *jobs;   // global

void start(void) {
    pthread_create(&t, NULL, worker, NULL);
    jobs = queue_create();
}

void *worker(void *arg) {
    run(queue_pop(jobs));
    return NULL;
}
Casi siempre queue_create corre antes que worker, porque el hilo creador
suele seguir en la CPU. Pero si el planificador elige primero al hilo nuevo,
worker usa jobs cuando todavía es NULL: un bug que aparece una vez cada
mil ejecuciones.
La solución general es una variable de condición con una bandera (semana 11):
start pone ready = 1 y hace signal después de crear la cola; worker
espera con while (ready == 0) wait(...) antes de usarla. En este caso
concreto hay una solución más simple: crear la cola antes de crear el hilo.
Idea clave. Las herramientas para arreglar estos bugs ya las conocen: un lock para la atomicidad, una variable de condición para el orden. Lo difícil es darse cuenta de que el código las necesitaba.
Deadlock
El caso mínimo son dos hilos y dos locks tomados en orden opuesto:
// Hilo 1           // Hilo 2
lock(&A);           lock(&B);
lock(&B);           lock(&A);
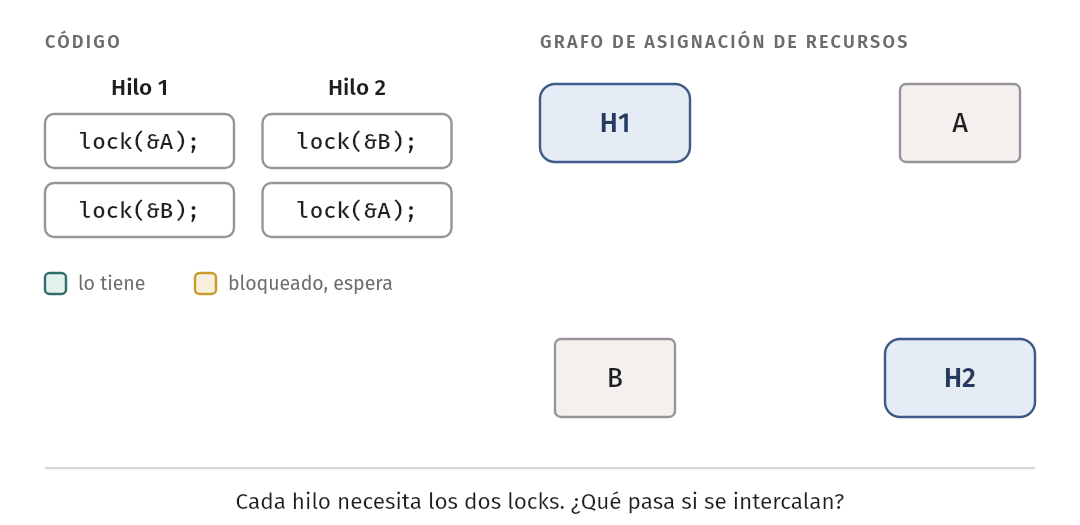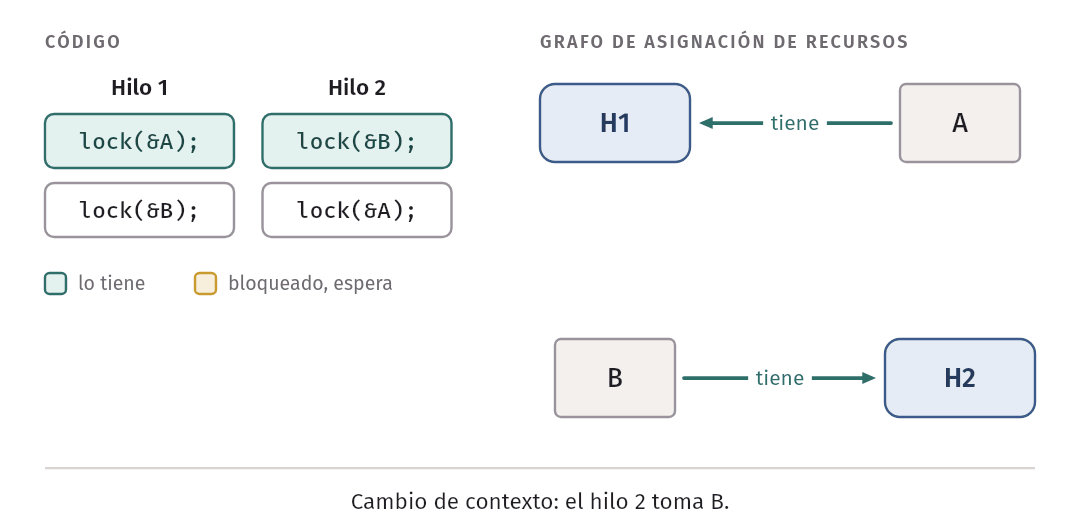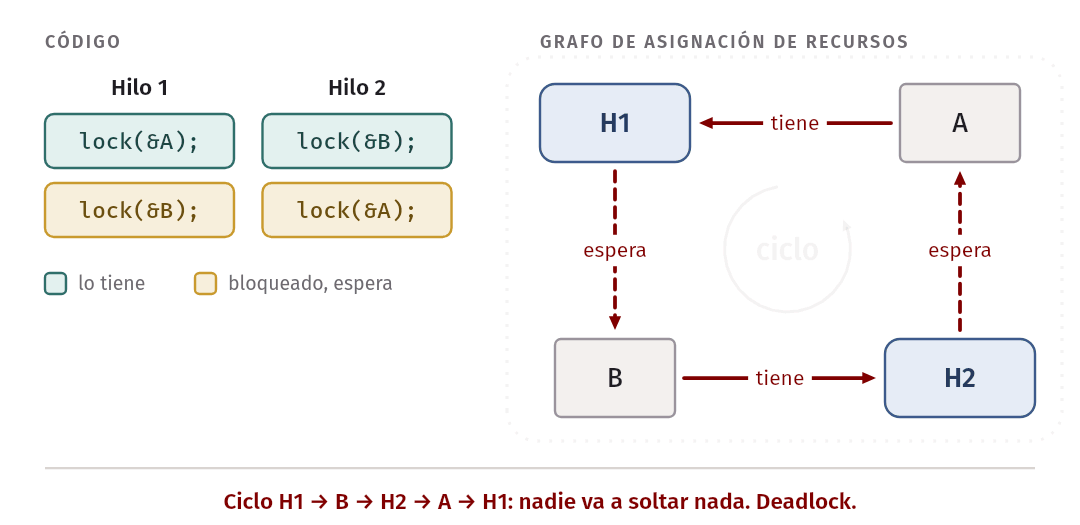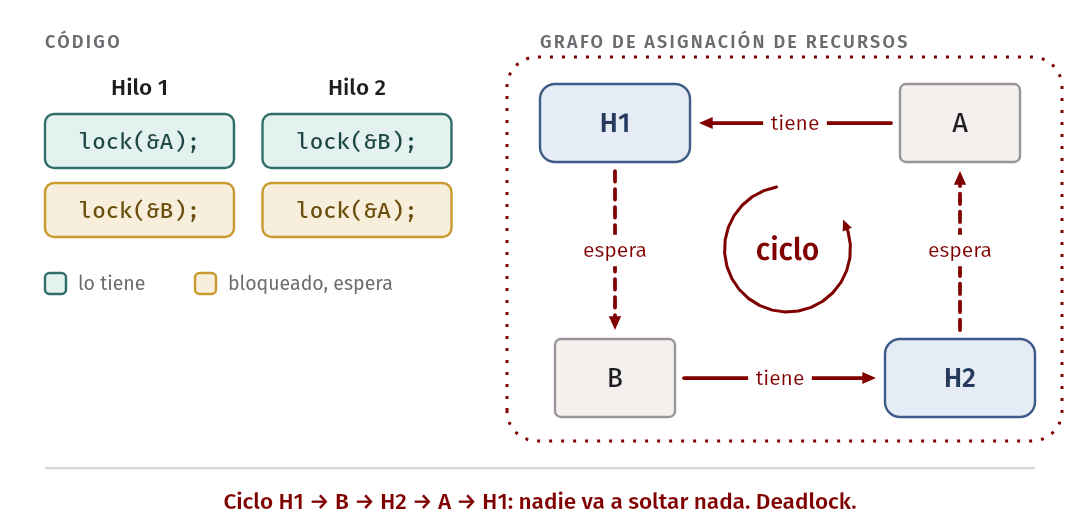
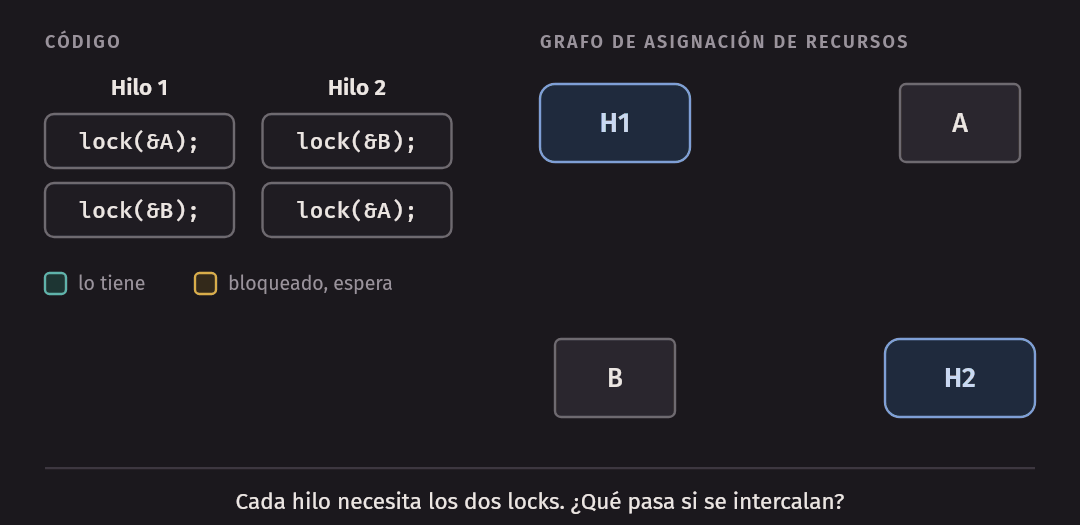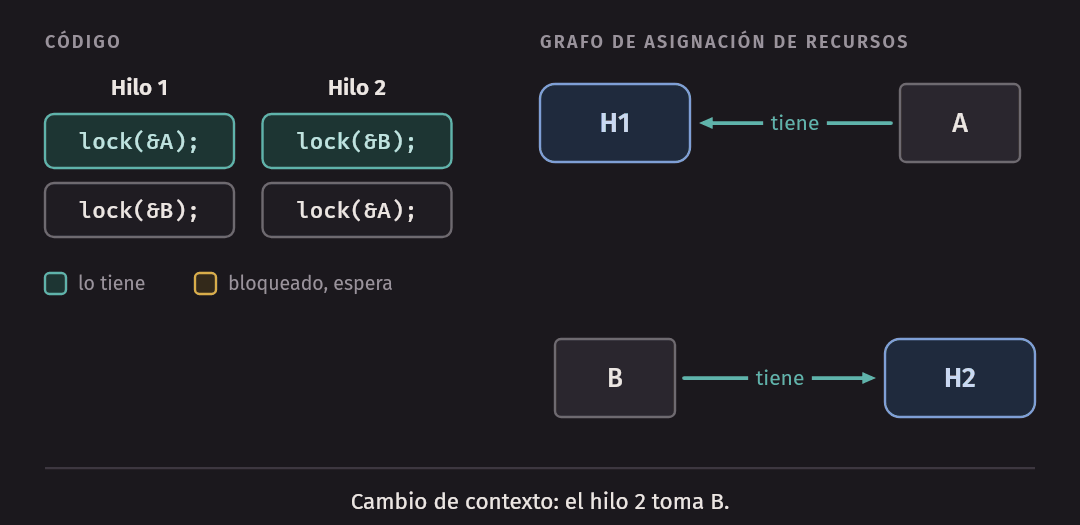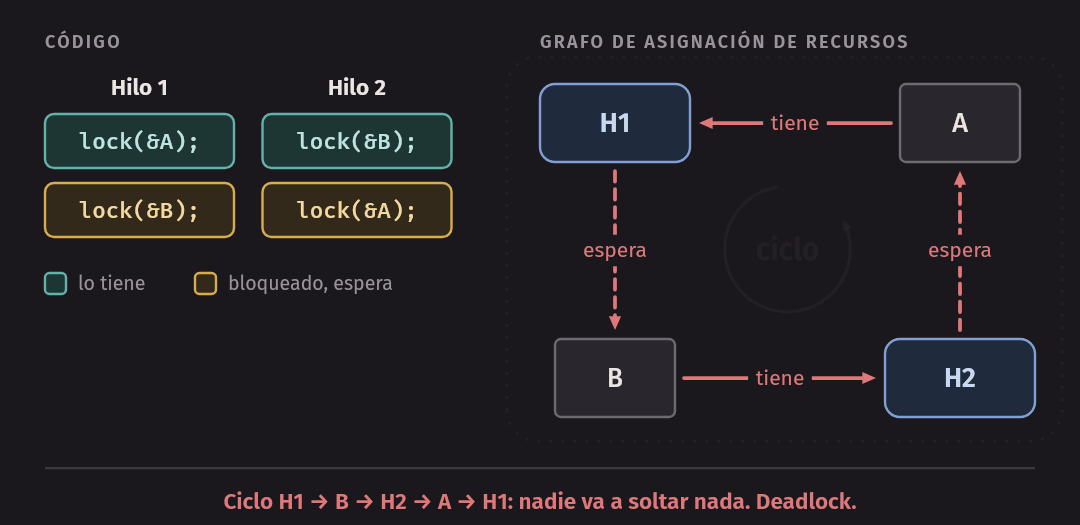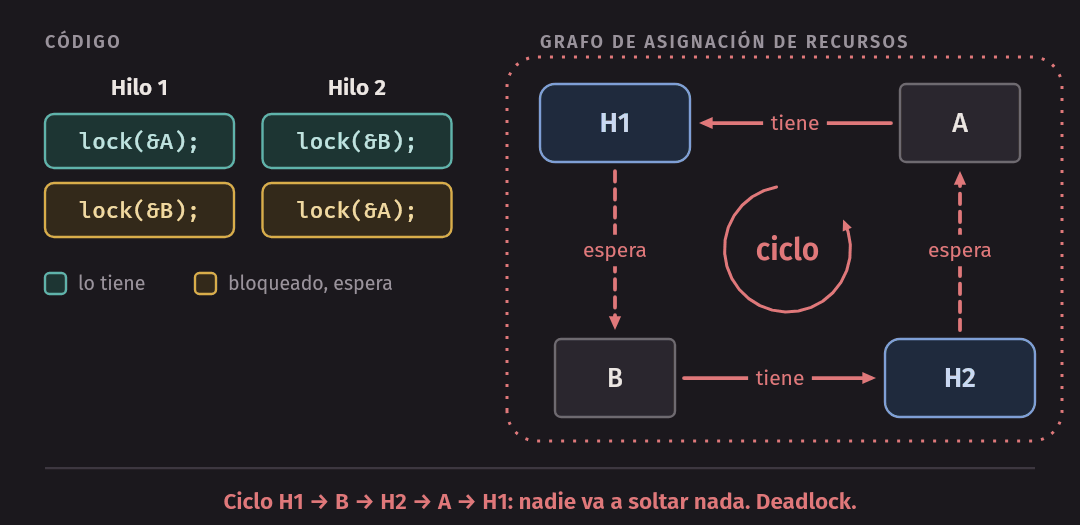
Si el hilo 1 toma A y justo después el hilo 2 toma B, cada uno queda
esperando un lock que tiene el otro, y ninguno lo va a soltar. Es un
deadlock. Se ve bien en un grafo de asignación de recursos
(resource-allocation graph): los hilos y los locks son nodos; una flecha del
lock al hilo dice “lo tiene” y una del hilo al lock dice “lo espera”. Como
cada lock es un recurso único, hay deadlock exactamente cuando el grafo tiene
un ciclo: H1 → B → H2 → A → H1. (Con recursos que tienen varias
instancias, la regla cambia; lo vemos más abajo.)
En código real el ciclo se esconde entre módulos o detrás de una interfaz:
si vector_add_all(v1, v2) toma el lock de v1 y luego el de v2, basta que
otro hilo llame a vector_add_all(v2, v1). Ya lo vimos con los filósofos de
la semana 11 (code/week-11/philo.c).
Las cuatro condiciones
Coffman y colegas (1971) mostraron que un deadlock necesita que se cumplan cuatro condiciones a la vez:
| Condición | Significado |
|---|---|
| Exclusión mutua | Cada recurso lo usa un solo hilo a la vez |
| Retener y esperar (hold-and-wait) | Un hilo retiene recursos mientras espera otros |
| Sin expropiación (no preemption) | Nadie puede quitarle a un hilo lo que tiene |
| Espera circular (circular wait) | Hay un ciclo de hilos, cada uno esperando al siguiente |
Si falta una sola, no hay deadlock. Toda técnica de prevención rompe una de ellas a propósito. Las otras dos estrategias son evitar el deadlock con un planificador que tiene información del futuro, y detectarlo y recuperarse. Y hay una cuarta, la más usada: ignorarlo.
Recursos con varias instancias
Un lock es un recurso de una sola instancia: está libre o lo tiene alguien. Pero muchos recursos vienen en varias copias intercambiables: los marcos de memoria, las entradas de una tabla, los buffers de un pool, las GPU de un servidor, las licencias de un programa. A un proceso que pide “una GPU” le da igual cuál.
Desde aquí hablamos de procesos y recursos, como la literatura clásica; todo vale igual para hilos y locks. En el grafo, cada tipo de recurso es un rectángulo con un punto por instancia. La flecha “lo tiene” sale de un punto concreto; la flecha “lo espera” llega al rectángulo, porque sirve cualquier instancia.
Con varias instancias, un ciclo ya no basta:
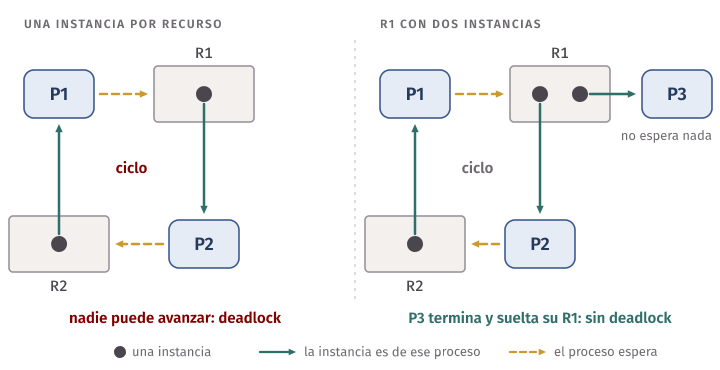
A la derecha, el ciclo existe, pero P3 está fuera de él y no espera nada: cuando termine, su instancia de R1 pasa a P1, P1 termina y suelta R2, y P2 también avanza. La regla queda así:
- Sin ciclo, nunca hay deadlock (con cualquier número de instancias).
- Con ciclo y una instancia por recurso, hay deadlock.
- Con ciclo y varias instancias, puede haberlo o no. Para saberlo hay que simular quién puede terminar: es el algoritmo de detección que veremos después.
Prevenir
Espera circular: orden de locks. Si todos los hilos toman los locks en el
mismo orden global, no puede formarse un ciclo. Con pocos locks se numeran
(orden total); en sistemas grandes se usan reglas entre grupos (orden
parcial): Linux documenta el suyo en comentarios (por ejemplo en
mm/filemap.c) y lo vigila con lockdep. Cuando una función recibe dos locks
sin saber cuál es cuál, se ordenan por dirección: primero el de dirección
menor (modo ordered de deadlock.c).
Retener y esperar: pedir todo de una vez. Un lock global prevention
rodea toda la adquisición: mientras un hilo toma sus locks, nadie más toma
ninguno. Funciona, pero hay que saber de antemano qué locks se van a usar, y
se pierde concurrencia.
Sin expropiación: soltar lo que se tiene. Con pthread_mutex_trylock, que
falla en vez de esperar, un hilo que no consigue el segundo lock suelta el
primero y reintenta: se expropia a sí mismo. El riesgo nuevo es el
livelock: dos hilos que sueltan y reintentan al mismo ritmo, para siempre.
El arreglo habitual es esperar un tiempo aleatorio antes de reintentar. Y si
entre los dos locks el hilo reservó memoria, también debe devolverla.
Exclusión mutua: estructuras sin locks. Con instrucciones atómicas como compare-and-swap (semana 10) se pueden escribir estructuras lock-free. Sin locks no hay nada que retener, así que no hay deadlock. Insertar al inicio de una lista es fácil:
void insert(struct node **head, int key) {
    struct node *n = malloc(sizeof *n);
    n->key = key;
    do {
        n->next = *head;
    } while (!CAS(head, n->next, n));
}
Si otro hilo cambió *head entre la lectura y el CAS, el CAS falla y el lazo
reintenta. Borrar nodos y liberar su memoria es mucho más difícil (el problema
ABA, saber cuándo hacer free).
| Técnica | Condición que rompe | Modo de deadlock.c |
Programa del laboratorio |
|---|---|---|---|
| Orden total de locks | Espera circular | ordered |
vector-global-order |
| Lock global de adquisición | Retener y esperar | global |
vector-avoid-hold-and-wait |
trylock y soltar |
Sin expropiación | trylock |
vector-try-wait |
| Lock-free con CAS | Exclusión mutua | — | vector-nolock |
Evitar: estados seguros
Prevenir pone reglas al programador. Evitar deja que cada proceso pida lo que quiera, en el orden que quiera, y pone la inteligencia en quien reparte: el sistema decide en cada pedido si concederlo ahora o hacer esperar al proceso, aunque haya recursos libres. Para eso necesita saber algo del futuro: cuánto puede llegar a pedir cada proceso. En el caso más simple, si sabe que “Respaldo” e “Importar” usan los mismos dos locks, basta con no correrlos a la vez. La versión general es el algoritmo del banquero (banker’s algorithm; Dijkstra, 1965).
La intuición: un banco que presta. Un banco pequeño tiene 12 mil soles para prestar y tres clientes con una línea de crédito cada uno. Cada cliente pide de a poco; cuando llega a su línea completa, termina su negocio y devuelve todo. Las líneas suman 23 mil, más de lo que el banco tiene: confía en que no todos llegarán al máximo a la vez.
| Cliente | Línea (máximo) | Ya prestado | Le puede faltar |
|---|---|---|---|
| Ana | 8 | 4 | 4 |
| Beto | 5 | 2 | 3 |
| Carla | 10 | 3 | 7 |
En caja quedan 12 − 9 = 3. ¿Está el banco en peligro? Supongamos lo peor: que todos pidan ya lo que les falta. Con 3 en caja, el banco puede completar a Beto; Beto termina y devuelve 5, la caja sube a 8; con 8 completa a Ana, que devuelve 8, y la caja llega a 12; con 12 completa a Carla. Existe un orden en que todos terminan, aun en el peor caso: el estado es seguro.
Ahora Ana pide 1 más. Hay plata en caja, pero si el banco presta, quedan 2, y a Ana le faltarían 3, a Beto 3 y a Carla 7: si todos piden su máximo, nadie puede terminar ni devolver nada. Ese estado es inseguro, así que el banco le dice a Ana “espera”. En cambio, si el que pide 1 es Beto, quedan 2 en caja y a Beto le faltan 2: Beto puede terminar, y el resto sigue como antes. Se concede. Mismo monto, distinta respuesta: importa quién pide.
- Un estado es seguro (safe state) si existe al menos un orden de los procesos (una secuencia segura, safe sequence) en que cada uno puede recibir todo lo que le falta con lo disponible más lo que devuelven los que terminaron antes.
- Desde un estado seguro, el sistema puede evitar el deadlock con certeza. El banquero solo concede pedidos que llevan a estados seguros.
- Inseguro no es deadlock. En el estado inseguro de arriba nadie está bloqueado todavía, y si Ana termina sin usar toda su línea, todo sale bien. Inseguro significa que el sistema ya no puede garantizarlo: el resultado depende de lo que pidan los procesos, no de lo que decida el banco.
El algoritmo del banquero
Con varios tipos de recurso, cada cantidad se vuelve un vector, con una componente por tipo. Con n procesos y m tipos:
| Nombre | Forma | Significado |
|---|---|---|
| Disponible (Available) | vector de m | instancias libres de cada tipo |
| Máximo (Max) | matriz n × m | lo más que el proceso i puede pedir de cada tipo (lo declara al empezar) |
| Asignado (Allocation) | matriz n × m | lo que el proceso i tiene ahora |
| Necesidad (Need) | matriz n × m | Máximo − Asignado: lo que todavía le puede faltar |
Comparar vectores es componente a componente: X ≤ Y si cada componente de X es menor o igual que la de Y. El algoritmo de seguridad es la cuenta del banco, con vectores:
- Trabajo (Work) = Disponible. Ningún proceso ha terminado.
- Buscar un proceso i que no haya terminado y cuya Necesidad[i] ≤ Trabajo.
- Si existe, se supone que recibe lo que le falta, termina y devuelve todo: Trabajo = Trabajo + Asignado[i]. Se marca como terminado y se vuelve al paso 2.
- Si ya no hay ninguno, el estado es seguro si y solo si todos terminaron. El orden en que terminaron es una secuencia segura.
Una observación hace que este algoritmo voraz sea correcto: que un proceso termine solo puede hacer crecer a Trabajo. Si en algún momento hay varios candidatos, da igual cuál se elija: los otros seguirán cabiendo después. Por eso no hace falta probar todos los órdenes. El costo es O(m·n²): hasta n vueltas, y en cada una se revisan n filas de m números.
Cuando el proceso i hace una solicitud (un vector), el banquero:
- Si Solicitud > Necesidad[i], es un error: pide más de lo que declaró.
- Si Solicitud > Disponible, el proceso espera: no hay con qué.
- Si no, simula que la concede: Disponible −= Solicitud, Asignado[i] += Solicitud, Necesidad[i] −= Solicitud. Corre el algoritmo de seguridad sobre ese estado. Si es seguro, la concesión queda; si no, deshace la simulación y el proceso espera.
El banquero, paso a paso
Un sistema con tres tipos de recurso, A, B y C, y cuatro procesos:
| Proceso | Máximo (A B C) | Asignado (A B C) | Necesidad (A B C) |
|---|---|---|---|
| P1 | 5 2 2 | 1 1 0 | 4 1 2 |
| P2 | 3 2 2 | 2 0 1 | 1 2 1 |
| P3 | 2 2 3 | 1 1 2 | 1 1 1 |
| P4 | 1 4 2 | 0 2 1 | 1 2 1 |
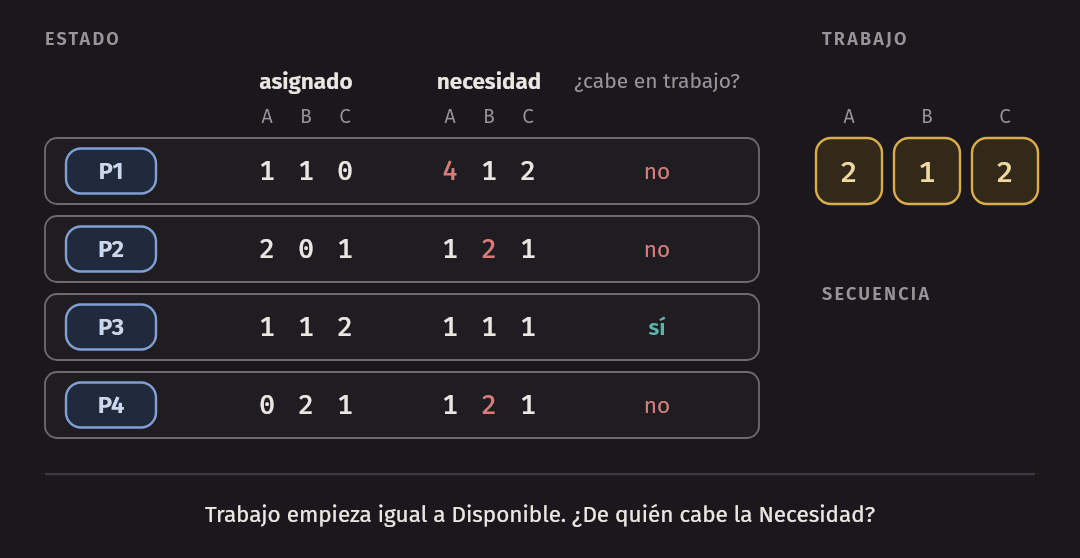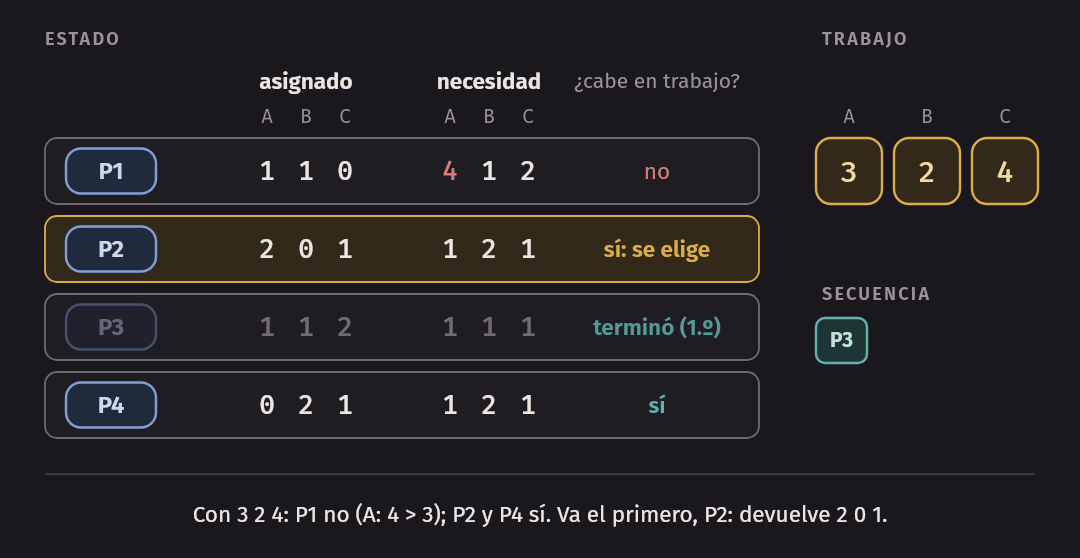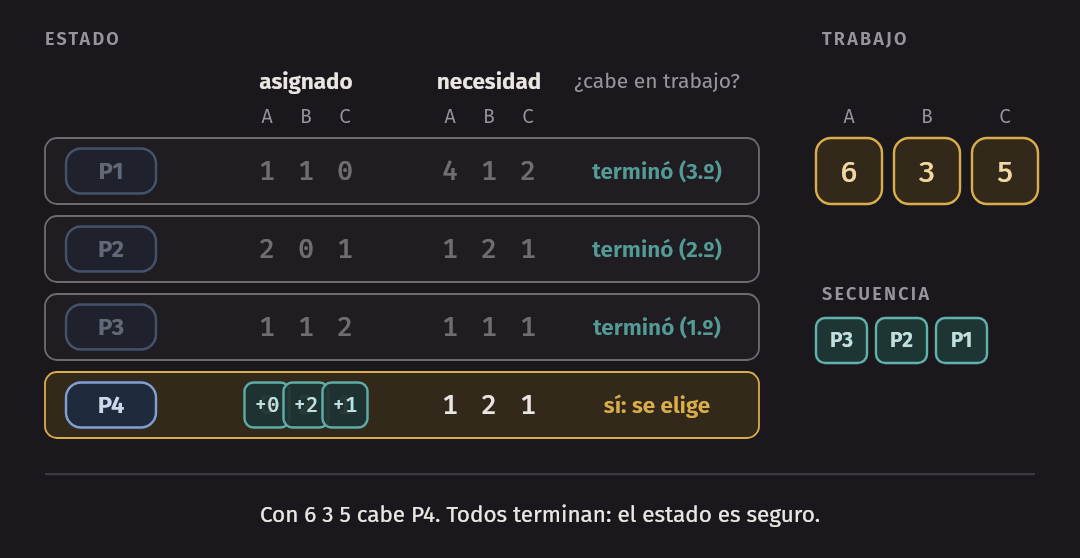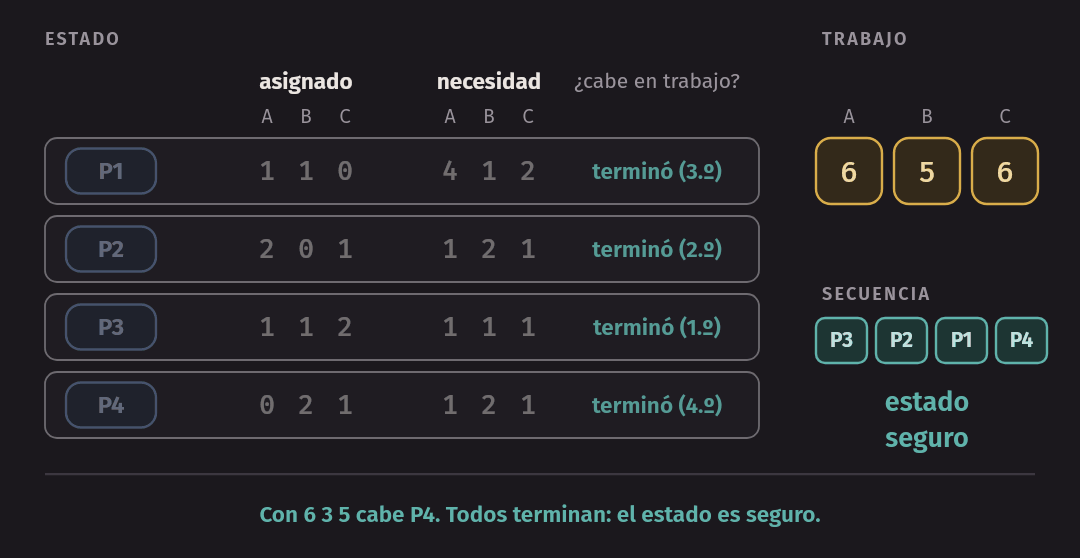
Disponible = (2 1 2). En total hay Disponible + la suma de Asignado = (2 1 2) + (4 4 4) = (6 5 6) instancias. La columna Necesidad es la primera cuenta: Máximo − Asignado, fila por fila.
¿Es seguro? Trabajo empieza en (2 1 2). En cada vuelta tomamos el primer proceso, en orden, cuya Necesidad cabe:
| Vuelta | Trabajo | ¿Quiénes caben? | Se elige | Devuelve |
|---|---|---|---|---|
| 1 | 2 1 2 | P3 (P1: A 4 > 2; P2 y P4: B 2 > 1) | P3 | 1 1 2 |
| 2 | 3 2 4 | P2, P4 (P1: A 4 > 3) | P2 | 2 0 1 |
| 3 | 5 2 5 | P1, P4 | P1 | 1 1 0 |
| 4 | 6 3 5 | P4 | P4 | 0 2 1 |
| fin | 6 5 6 | todos terminaron |
Todos terminan: el estado es seguro, con la secuencia ⟨P3, P2, P1, P4⟩. No es la única (⟨P3, P4, P2, P1⟩ también sirve); basta con encontrar una. Al final Trabajo vale el total (6 5 6), como debe ser: todos devolvieron todo.
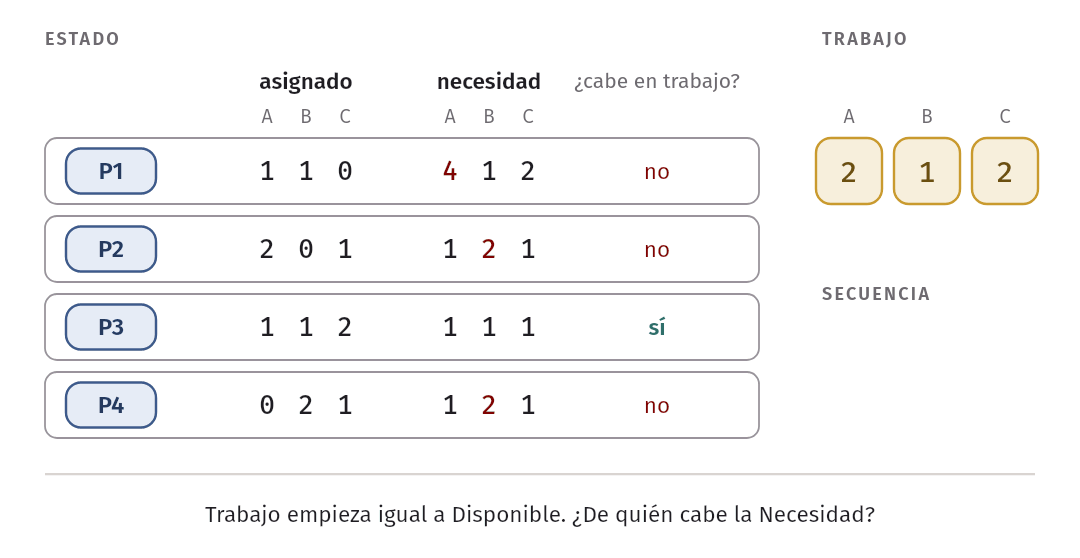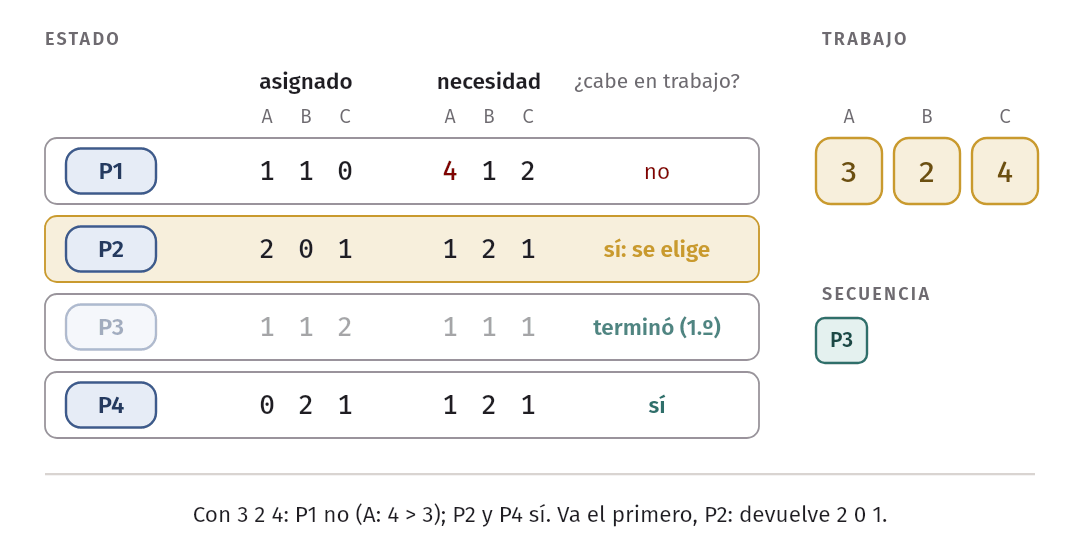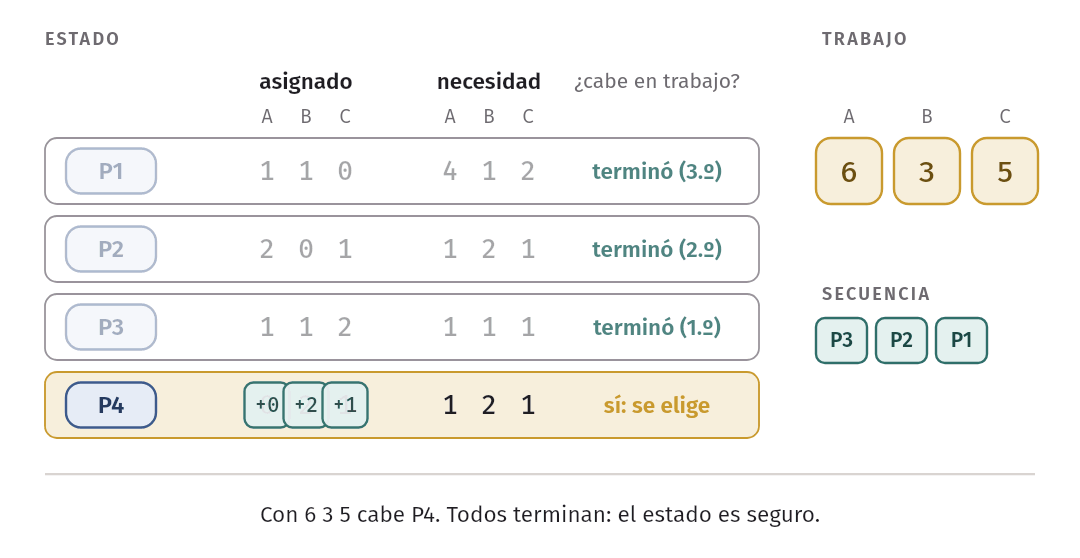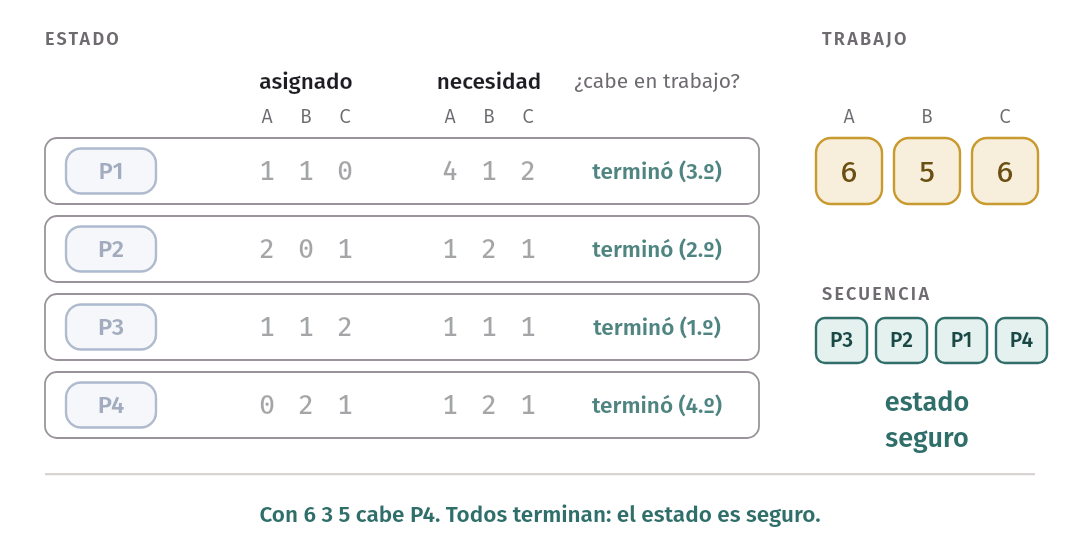
Una solicitud que se concede. P1 pide (1 0 1). Cabe en su Necesidad (4 1 2) y en Disponible (2 1 2). Simulamos: Disponible = (1 1 1), Asignado de P1 = (2 1 1), Necesidad de P1 = (3 1 1). Con Trabajo = (1 1 1), P3 cabe justo (necesita 1 1 1) y devuelve (1 1 2): Trabajo = (2 2 3). Luego P2 → (4 2 4), P1 → (6 3 5), P4 → (6 5 6). Sigue siendo seguro: se concede, aunque Disponible quedó en (1 1 1).
Una solicitud que se niega. Desde ese estado, P2 pide (0 1 0). También cabe en su Necesidad (1 2 1) y en Disponible (1 1 1): hay una B libre. Pero si se la damos, Disponible = (1 0 1) y todos necesitan al menos una B más (P1, P2 y P3 una; P4 dos). Nadie puede asegurar que termina: el estado es inseguro y se niega; P2 espera hasta que alguien devuelva recursos. Fíjense en que el pedido negado era más chico que el concedido: lo que importa es si deja al sistema sin salida.
Todo el ejemplo sale de banker.c, que lee el
estado de bank.txt (Disponible, Máximo, Asignado
y las solicitudes en orden), calcula Necesidad, dice si el estado es seguro con
la secuencia y evalúa cada pide; si concede uno, el siguiente parte de ese
estado:
$ ./banker bank.txt
recursos: A B C   total: 6 5 6   disponible: 2 1 2
proceso  máximo     asignado   necesidad
P1       5 2 2      1 1 0      4 1 2
P2       3 2 2      2 0 1      1 2 1
P3       2 2 3      1 1 2      1 1 1
P4       1 4 2      0 2 1      1 2 1

¿es seguro?
  trabajo 2 1 2: P3 necesita 1 1 1, cabe; termina y devuelve 1 1 2
  trabajo 3 2 4: P2 necesita 1 2 1, cabe; termina y devuelve 2 0 1
  trabajo 5 2 5: P1 necesita 4 1 2, cabe; termina y devuelve 1 1 0
  trabajo 6 3 5: P4 necesita 1 2 1, cabe; termina y devuelve 0 2 1
  trabajo 6 5 6: todos terminaron
estado seguro: P3 P2 P1 P4

pide P1 1 0 1
  cabe en necesidad y disponible; si se concede, disponible = 1 1 1
  trabajo 1 1 1: P3 necesita 1 1 1, cabe; termina y devuelve 1 1 2
  trabajo 2 2 3: P2 necesita 1 2 1, cabe; termina y devuelve 2 0 1
  trabajo 4 2 4: P1 necesita 3 1 1, cabe; termina y devuelve 2 1 1
  trabajo 6 3 5: P4 necesita 1 2 1, cabe; termina y devuelve 0 2 1
  trabajo 6 5 6: todos terminaron
  seguro (P3 P2 P1 P4): se concede

pide P2 0 1 0
  cabe en necesidad y disponible; si se concede, disponible = 1 0 1
  trabajo 1 0 1: nadie cabe (P1 3 1 1, P2 1 1 1, P3 1 1 1, P4 1 2 1)
  inseguro: se niega; P2 espera y el estado vuelve atrás
Para probar otros estados, escriban un archivo con el mismo formato (los
comentarios de banker.c lo describen) y córranlo con ./banker archivo.
Por qué casi no se usa. El banquero necesita que cada proceso declare su máximo antes de empezar, y casi ningún programa lo sabe (¿cuánta memoria o cuántos archivos usará un navegador?). Supone además que el número de procesos y de recursos es fijo, y que un proceso que recibe su máximo termina pronto. Es conservador: niega pedidos que en la práctica no habrían causado nada. Y cuesta O(m·n²) en cada solicitud. Tiene otro riesgo, que ya conocen: un proceso con un pedido grande puede quedar postergado para siempre mientras se conceden los pedidos de otros. Es inanición, y se mitiga atendiendo en orden de llegada a los que esperan cuando se libera algo.
Detectar y recuperarse
La alternativa pragmática es no frenar a nadie y revisar de vez en cuando si ya hay un deadlock.
Una instancia por recurso. Basta el grafo de espera (wait-for graph):
el grafo de asignación sin los nodos de recursos, con una flecha Pi → Pj si Pi
espera algo que tiene Pj. Un ciclo en el grafo de espera es un deadlock, y se
encuentra con una búsqueda en profundidad. Es lo que hace el watchdog de
deadlock.c más abajo.
Varias instancias. El grafo de espera ya no sirve, por lo que vimos en la figura de las dos instancias. Se usa el mismo algoritmo de seguridad con un cambio: en lugar de Necesidad (lo que un proceso podría pedir), se usa Solicitud (Request), lo que cada proceso está pidiendo ahora y por lo que está esperando. La suposición es optimista: si un proceso consigue lo que pide, terminará y devolverá todo; si después pide más, la siguiente revisión lo verá. Los procesos que el algoritmo no logra marcar como terminados están en deadlock. No hace falta conocer el futuro, solo el presente.
Un ejemplo con tres tipos y cuatro procesos, en
detect.txt. banker.c usa el modo de
detección cuando el archivo trae solicitud en lugar de maximo:
$ ./banker detect.txt
recursos: A B C   total: 3 3 2   disponible: 0 1 0
proceso  solicitud  asignado
P1       0 0 1      1 0 1
P2       0 0 1      0 1 0
P3       2 0 0      1 1 1
P4       0 1 0      1 0 0

detección (solicitud en lugar de necesidad)
  trabajo 0 1 0: P4 pide 0 1 0, cabe; termina y devuelve 1 0 0
  trabajo 1 1 0: nadie más cabe (P1 0 0 1, P2 0 0 1, P3 2 0 0)
deadlock: P1 P2 P3

recuperación: abortar a uno solo
  abortar P1 (libera 1 0 1): los demás terminan: P2 P4 P3
  abortar P2 (libera 0 1 0): no basta, siguen bloqueados: P1 P3
  abortar P3 (libera 1 1 1): los demás terminan: P1 P2 P4
P4 pide la B que está libre, así que puede terminar y devolver una A. Con Trabajo = (1 1 0), P1 y P2 esperan una C (las dos están en manos de P1 y P3) y P3 espera dos A (solo hay una). Nadie más avanza: P1, P2 y P3 están en deadlock. P4 no lo está: lo que pide está libre.
¿Cada cuánto revisar? En cada solicitud que debe esperar se detecta lo
antes posible, pero se paga el algoritmo muchas veces. Lo habitual es revisar
cada cierto tiempo, o cuando una espera se alarga. PostgreSQL, por ejemplo,
deja que una transacción espere un lock durante deadlock_timeout (1 s por
omisión) y recién entonces busca un ciclo, porque casi todas las esperas
terminan antes.
Recuperarse. Ninguna opción es elegante:
- Abortar procesos. Todos los del deadlock (seguro, pero se pierde mucho trabajo) o de uno en uno, volviendo a correr el detector tras cada víctima. La salida de arriba muestra por qué hay que volver a revisar: abortar P2 no basta, porque solo libera una B y nadie esperaba una B. Para elegir la víctima se mira cuánto lleva corriendo, cuántos recursos tiene, cuánto le falta y si alguien la está esperando (un proceso interactivo).
- Expropiar recursos. Quitarle un recurso a un proceso y dárselo a otro. Solo sirve con recursos que lo permiten: un marco de memoria se puede llevar a swap y devolver después; una impresora a mitad de página, no.
- Retroceder (rollback). Si el proceso guarda checkpoints de su estado, se lo regresa a uno anterior a tomar el recurso y se reanuda desde ahí. Es lo que hacen las bases de datos: abortan la transacción, deshacen sus cambios con el log y la repiten.
Las dos últimas traen de vuelta problemas conocidos. Si siempre se elige a la
misma víctima, ese proceso no termina nunca: inanición; por eso se cuenta
cuántas veces fue víctima. Y si las víctimas reintentan enseguida y al mismo
ritmo, pueden volver a chocar una y otra vez: el livelock de trylock, con
el mismo arreglo, esperar un tiempo aleatorio antes de reintentar.
De vuelta a los locks: deadlock.c junta la
prevención y la detección. Dos hilos toman A y
B en orden opuesto 100 000 veces cada uno. Un hilo watchdog revisa cada
medio segundo un contador de avance; si en 2 s no cambió, muestra el grafo de
espera y termina:
$ ./deadlock naive
watchdog: 2 s sin avance (862 de 200000 vueltas)
  hilo 0: tiene A, espera B
  hilo 1: tiene B, espera A
  ciclo: H0 -> B -> H1 -> A -> H0: deadlock
$ ./deadlock ordered
ordered: counter = 200000 de 200000 en 0.025 s
$ ./deadlock global
global: counter = 200000 de 200000 en 0.049 s
$ ./deadlock trylock
trylock: counter = 200000 de 200000 en 0.027 s
  27727 reintentos
Sin orden, el deadlock llegó en menos de mil vueltas. trylock funciona, pero
reintentó casi 28 000 veces: trabajo perdido.
La estrategia del avestruz
Linux, Windows y macOS, en general, no hacen nada: ni evitan ni detectan
deadlocks entre procesos de usuario. Si dos procesos toman dos
pthread_mutex en orden opuesto, quedan bloqueados para siempre, y el sistema
no se entera. Se le llama estrategia (o algoritmo) del avestruz
(ostrich algorithm), por el ave que, según el mito, esconde la cabeza en la
arena. Parece una irresponsabilidad, pero es una decisión de ingeniería:
- Frecuencia contra costo. Un deadlock de este tipo es raro comparado con otros fallos (un bug común, un disco que falla, un corte de luz). Detectarlo exigiría registrar quién tiene y quién espera en cada operación de lock, y la gran mayoría de esas operaciones nunca participa en un deadlock.
- El banquero pide lo imposible. Ningún programa declara su máximo de memoria, archivos o locks al empezar.
- La recuperación sería la misma. Si el sistema detectara el deadlock, lo
más que podría hacer es matar un proceso, que es lo que el usuario hace con
killo Ctrl-C cuando el programa se cuelga. - Muchos recursos no se esperan. Si la tabla de procesos o la de
descriptores está llena,
forkfalla conEAGAINyopenconEMFILE: el proceso recibe un error en vez de quedarse esperando, y sin espera no hay ciclo. Es prevención barata, pasando el problema al programa.
Eso no significa que nadie se ocupe. La responsabilidad pasa a quien escribe el código concurrente, con las técnicas de prevención, y el sistema ofrece algunas herramientas puntuales:
- En el kernel,
lockdep(una opción de depuración) registra el orden en que se toman las clases de locks y avisa de un posible deadlock la primera vez que ve dos órdenes opuestos, aunque el deadlock no haya ocurrido. Es la prevención por orden de locks, verificada. - El detector de tareas colgadas (hung task detector) avisa en el log del
kernel cuando una tarea lleva más de
hung_task_timeout_secs(120 s por omisión) en estado D, la espera no interrumpible. Detecta, pero no recupera: es la misma idea que el watchdog dedeadlock.c. - Los locks de registros de
fcntl(F_SETLKW) sí tienen detección: si esperar cerraría un ciclo, la llamada falla conEDEADLK. Es limitada: el kernel solo sigue cadenas de hasta 10 pasos y puede equivocarse en ambos sentidos (lo dice la página man). - Donde el deadlock es frecuente y abortar es barato, sí se detecta: las
bases de datos (PostgreSQL, MySQL/InnoDB) buscan ciclos en el grafo de
espera de sus transacciones, abortan una con un error como
deadlock detectedy la aplicación la repite.
Idea clave. Cuatro estrategias: prevenir (romper una condición, la que se usa en el código), evitar (el banquero: no entrar a estados inseguros; exige conocer el máximo), detectar y recuperarse (el mismo algoritmo con Solicitud, más abortar o retroceder; lo usan las bases de datos) e ignorar (el avestruz: lo que hace un sistema operativo de propósito general con los procesos de usuario).
Lectura. OSTEP no trata el banquero ni la detección con varias instancias. Para profundizar: Tanenbaum y Bos, Modern Operating Systems, 5.ª ed., secs. 6.3 a 6.5; E. W. Dijkstra, The mathematics behind the Banker’s Algorithm (EWD623); la página man de
F_SETLKWy el diseño delockdep.
Concurrencia basada en eventos
Los hilos no son la única forma de hacer muchas cosas a la vez. Un servidor puede tener un solo hilo que repite un ciclo:
while (1) {
    events = wait_for_events();
    for (e in events)
        handle(e);      // no debe bloquear
}
Es el ciclo de eventos (event loop): espera a que pase algo (llega una conexión, un socket tiene datos) y ejecuta el manejador de ese evento. Con un solo hilo no hacen falta locks, y el programa decide qué atender primero. Así funcionan nginx, Node.js y Redis.
select, poll y epoll
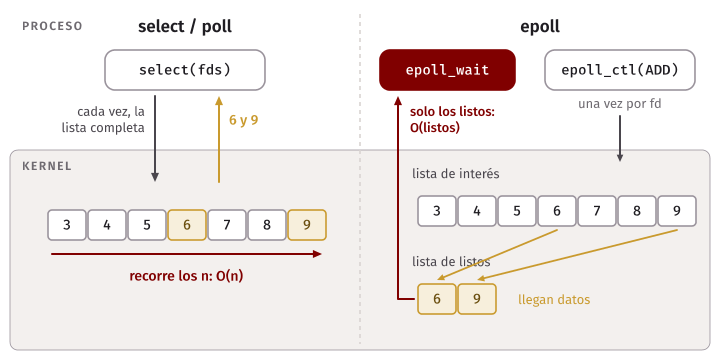
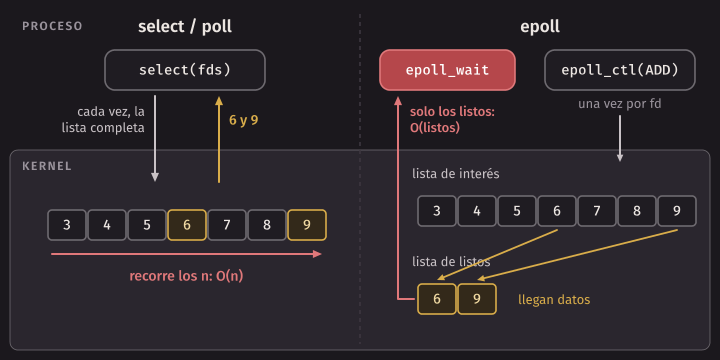
La pieza clave es la espera: “de estos descriptores, ¿cuáles están listos?”.
select (1983) y poll reciben en cada llamada la lista completa, y el
kernel la recorre: O(n) aunque solo uno tenga datos (select, además, admite
hasta FD_SETSIZE = 1024). Linux agregó epoll (2.6), con tres llamadas:
epoll_create1crea una instancia en el kernel.epoll_ctl(ep, EPOLL_CTL_ADD, fd, &ev)agregafda la lista de interés, que el kernel recuerda.epoll_waitdevuelve la lista de listos, que el kernel arma a medida que llegan datos: O(listos), no O(n).
Por omisión avisa por nivel (level-triggered): mientras queden datos, el
descriptor sigue listo. Con EPOLLET avisa por flanco (edge-triggered),
solo cuando el estado cambia, y hay que leer hasta EAGAIN. BSD y macOS
tienen kqueue.
Un servidor de eco
epollecho.c es un servidor de eco con un solo
hilo. En modo test abre el servidor en un puerto libre y crea con fork un
cliente “lento”, que se conecta y no envía nada durante un segundo, y 50
clientes normales que envían 20 líneas cada uno y verifican el eco:
$ ./epollecho test 50 20
servidor: puerto 33853, 1 cliente lento + 50 clientes x 20 mensajes
servidor: 50 conexiones atendidas en 0.012 s; 1 sigue abierta sin enviar nada
servidor: 51 conexiones, 22331 bytes, 41 llamadas a epoll_wait (hasta 50 fd listos a la vez)
clientes: 51 de 51 recibieron su eco completo
Un hilo atendió 51 conexiones y el cliente lento no frenó a nadie; con read
bloqueante, los otros 50 habrían esperado un segundo. Y bastaron 41 llamadas a
epoll_wait para más de mil mensajes.
E/S no bloqueante y el estado a mano
Para que un manejador nunca bloquee, los sockets se ponen en modo
O_NONBLOCK (con fcntl). Así, read y write nunca esperan: si no pueden
avanzar devuelven −1 con errno = EAGAIN, o write envía solo una parte.
Aquí aparece la diferencia más profunda con los hilos. En un servidor con un hilo por cliente, el código es lineal:
char buf[4096];
n = read(sock, buf, sizeof buf);
write(sock, buf, n);    // si no cabe todo, el hilo espera
Si write no puede enviar todo, el hilo se bloquea; el estado (el buffer,
cuánto falta) queda en su pila.
En un ciclo de eventos el manejador tiene que terminar ya, así que ese estado
hay que guardarlo a mano en una estructura:
struct conn {
    int fd;
    char buf[BUFSZ];  // datos leídos que falta devolver
    size_t len;       // cuántos bytes hay en buf
    size_t off;       // cuántos ya se escribieron
};
Si write devuelve EAGAIN, el manejador anota en off dónde quedó y pide a
epoll que avise con EPOLLOUT; otro llamado retoma el envío. OSTEP llama
a esto manejo manual de la pila (manual stack management), y a la
estructura que guarda “cómo continuar”, una continuación (continuation).
Lo que bloquea sin avisar
El punto débil del modelo: una sola llamada que bloquee detiene todo el servidor, porque hay un solo hilo. Leer un archivo del disco o resolver un nombre con DNS tarda milisegundos, y mientras tanto los eventos de los demás clientes se acumulan.
Peor aún son los fallos de página: si el manejador toca una página que
estaba en swap, el hilo se bloquea sin haber llamado a nada, y ni
O_NONBLOCK ni epoll lo evitan. Esa es la respuesta a la pregunta de repaso
2: el fallo bloquea al único hilo, y con él a todos los clientes.
Hay dos salidas. La primera es la E/S asíncrona: pedir la operación y
enterarse después. POSIX AIO (aio_read) existe hace décadas, pero en Linux
glibc la implementa con hilos, y la AIO nativa solo es asíncrona con
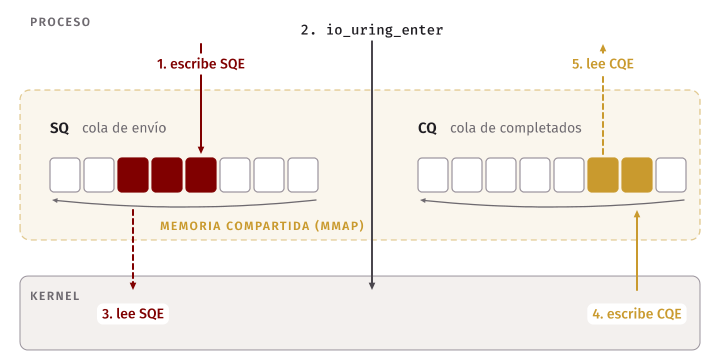
O_DIRECT. La interfaz moderna es io_uring (Linux 5.1, 2019): dos colas
circulares en memoria compartida (vía mmap); el proceso escribe pedidos en la
cola de envío, el kernel deja resultados en la de completados, y una llamada
io_uring_enter envía muchos pedidos a la vez, para archivos y sockets. La
segunda salida es un grupo de hilos auxiliar para lo que bloquea, como
hacen libuv (Node.js) y nginx. Ninguna resuelve los fallos de página del
propio servidor.
| Hilos | Eventos | |
|---|---|---|
| Estado de cada tarea | En la pila, automático | A mano (continuaciones) |
| Datos compartidos | Locks, variables de condición | Sin locks (con un hilo) |
| Bugs típicos | Atomicidad, orden, deadlock | Un manejador que bloquea |
| Varios núcleos | Natural | Un ciclo por núcleo, y vuelven los locks |
| E/S que bloquea | Bloquea solo a ese hilo | Bloquea a todos; requiere E/S asíncrona |
El consejo del cap. 34 de OSTEP: eviten la concurrencia si pueden; si no, usen patrones probados o modelos más simples, como eventos o map-reduce.
Dispositivos de E/S
Los dispositivos se conectan en una jerarquía de buses: lo más rápido (GPU, SSD NVMe) cerca de la CPU por PCIe; lo más lento (SATA, USB, red) colgado de un chip de E/S, en buses baratos que admiten muchos dispositivos.
El dispositivo canónico
Desde el punto de vista del sistema operativo, un dispositivo es una interfaz con unos pocos registros: uno de estado, uno de comando y uno de datos. Por dentro tiene lo que haga falta (un microcontrolador, memoria, firmware de miles de líneas), pero eso queda oculto. El protocolo más simple tiene cuatro pasos:
while (*status & BUSY) ;      // 1. esperar a que esté libre
for (int i = 0; i < n; i++)
    *data = buf[i];           // 2. pasarle los datos
*command = CMD_WRITE;         // 3. darle la orden
while (*status & BUSY) ;      // 4. esperar a que termine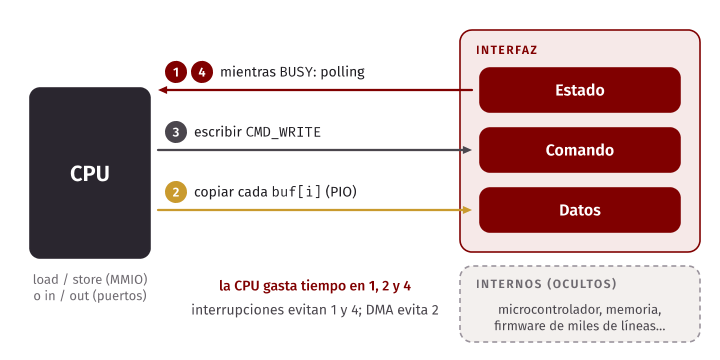
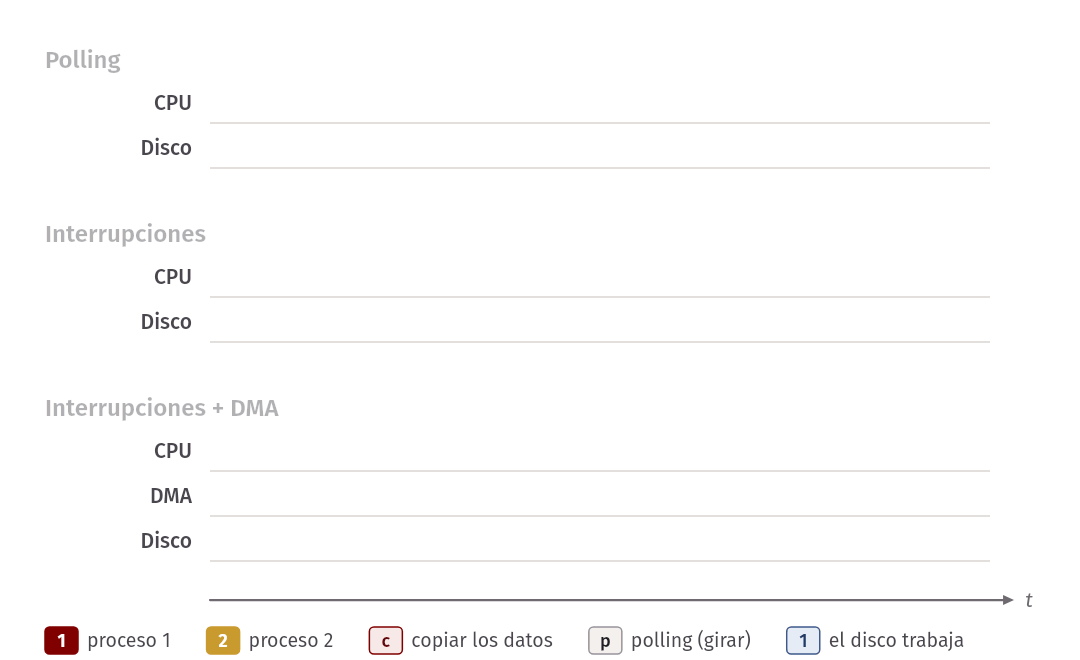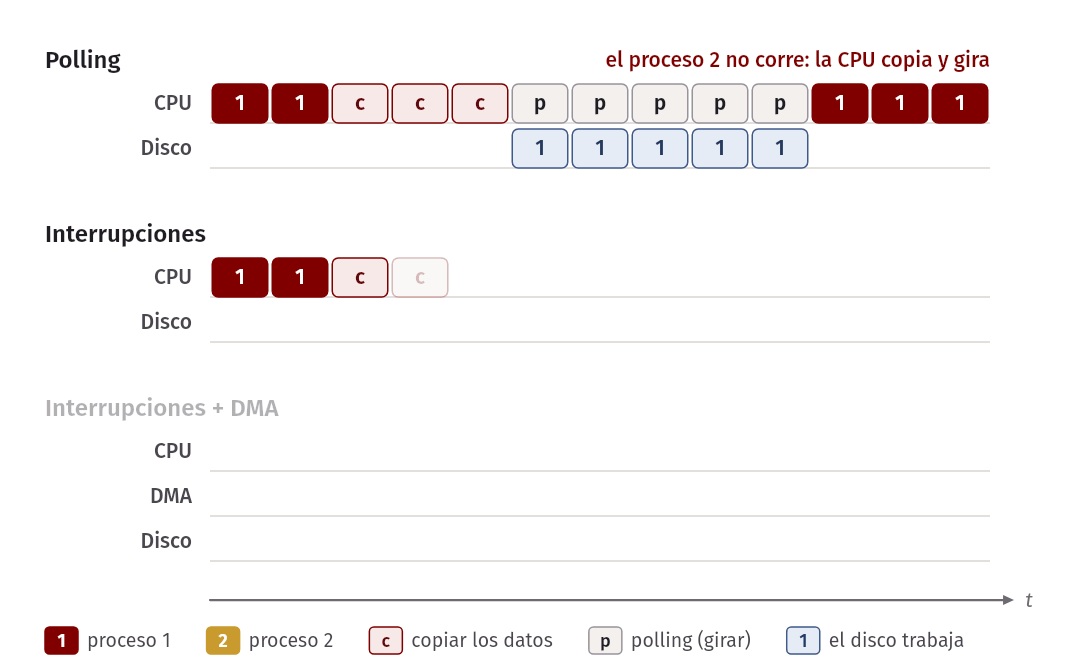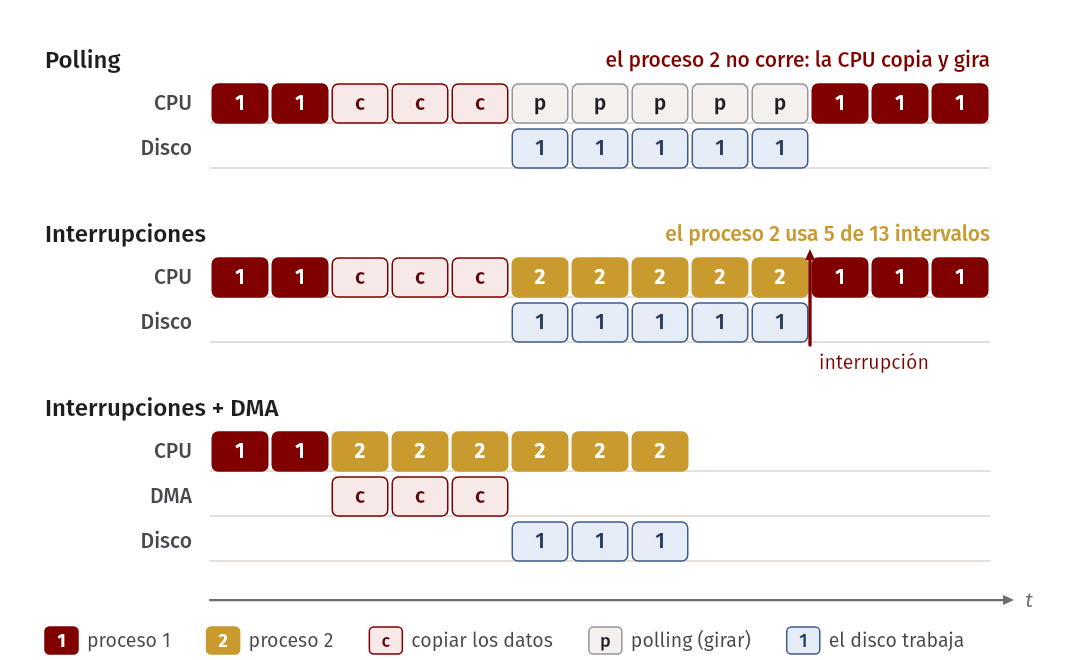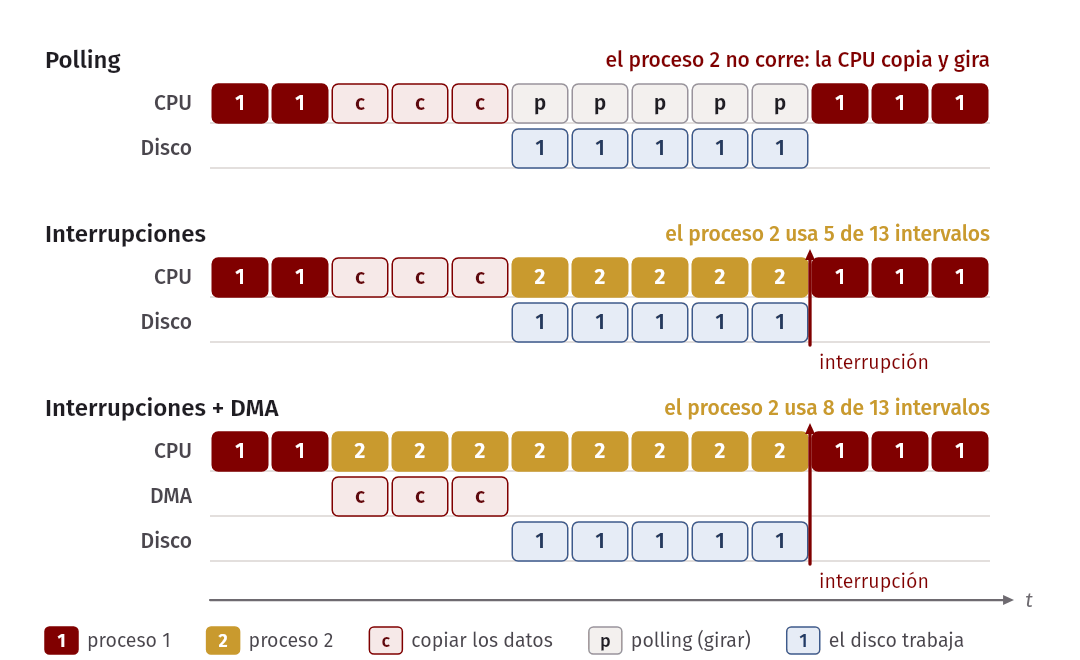
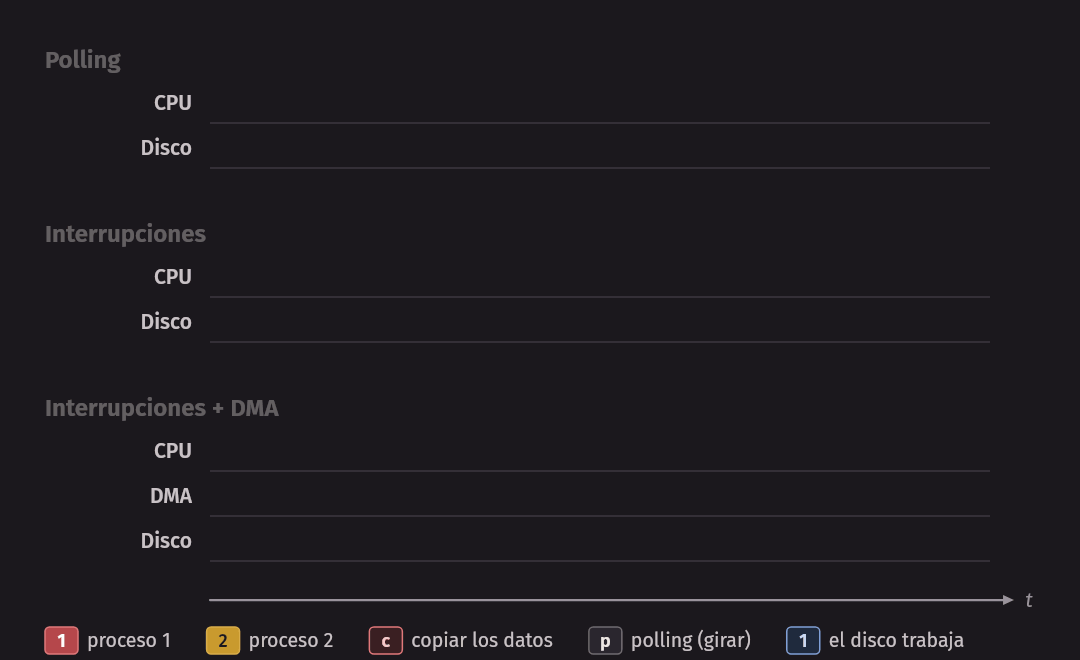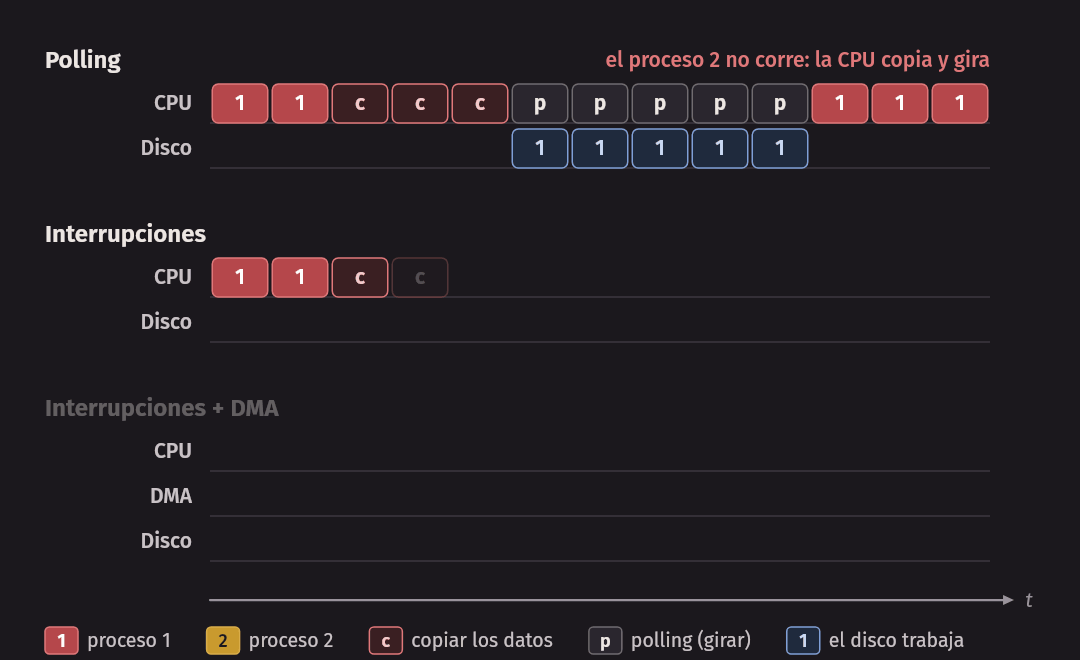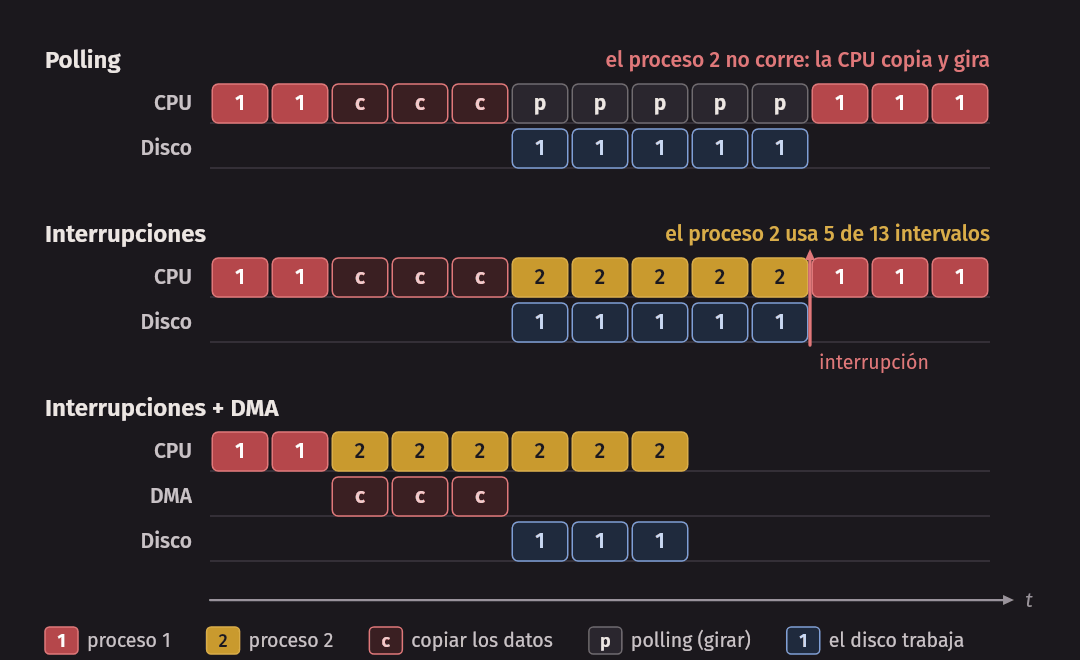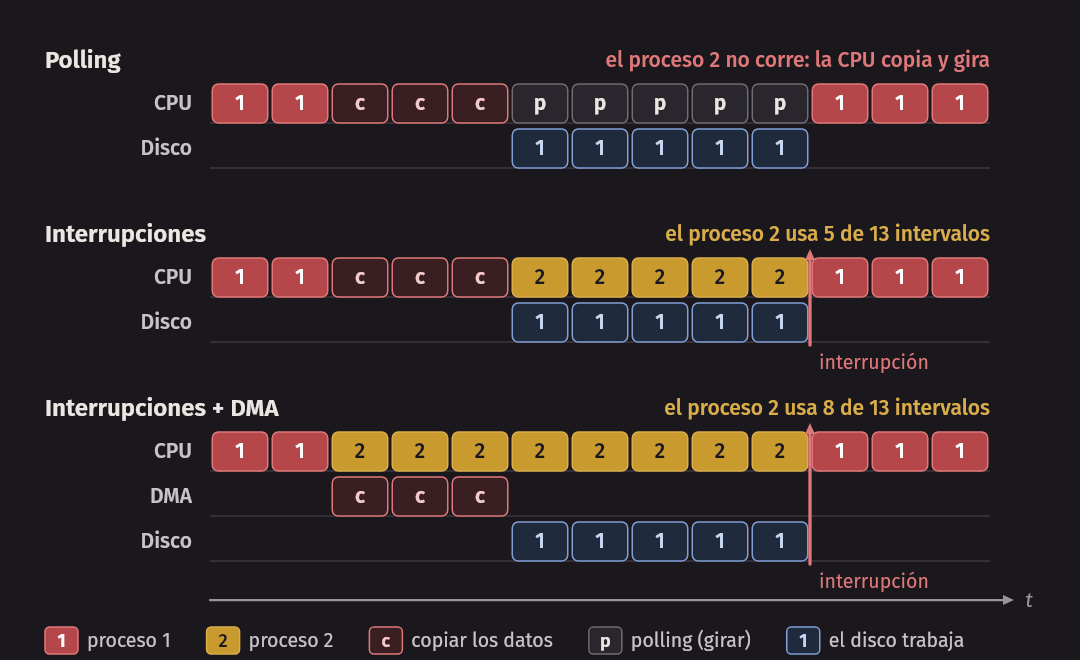
Los pasos 1 y 4 son polling: preguntar una y otra vez. El paso 2 es E/S programada (PIO): la CPU copia cada palabra. Los dos gastan CPU que podría usar otro proceso.
Interrupciones
En vez de preguntar, el sistema operativo da la orden, bloquea al proceso y corre otro. Al terminar, el dispositivo levanta una interrupción: la CPU salta a un manejador del kernel, que despierta al proceso. El tiempo que con polling se perdía girando, ahora lo aprovecha otro proceso.
Las interrupciones no siempre ganan. Si el dispositivo responde en pocos microsegundos, esperar girando sale más barato que atender una interrupción. Y si llegan demasiadas (red con mucho tráfico), el sistema solo atiende interrupciones: un livelock. Las soluciones son híbridas: girar un rato y luego dormir, agrupar interrupciones (coalescing) o pasar a polling bajo carga, como NAPI en Linux.
DMA
Con interrupciones, la CPU todavía copia los datos (paso 2). Con DMA (Direct Memory Access), el sistema operativo le dice al motor de DMA “copia n bytes entre esta dirección y el dispositivo”, y este copia solo e interrumpe al terminar. Hoy cada dispositivo rápido hace su propio DMA, con direcciones físicas: no pasa por la tabla de páginas del proceso.
Puertos o memoria
La CPU llega a esos registros de dos formas. Con E/S por puertos
(port-mapped I/O), mediante instrucciones privilegiadas como in y out de
x86. Con E/S mapeada en memoria (MMIO), los registros tienen direcciones
físicas y se usan con load y store normales. RISC-V solo tiene MMIO: en la
máquina virt de QEMU (kernel/memlayout.h), el PLIC está en 0x0C000000, la
UART en 0x10000000, el disco virtio en 0x10001000 y la RAM desde
0x80000000.
Drivers
La parte del kernel que conoce el protocolo de un dispositivo es su driver (device driver); por encima, una capa genérica de bloques solo dice “lee el bloque n”, y el sistema de archivos no sabe si escribe en SATA, NVMe o USB. Según OSTEP, los drivers son más del 70 % del código de Linux, y es donde más bugs se encuentran.
En xv6. La UART (
kernel/uart.c) usa polling e interrupciones en el mismo driver. Sus registros son MMIO: la macroReg(reg)es un punterovolatile unsigned char *aUART0 + reg.uartputc_synces el protocolo canónico con polling (girar hasta queLSR_TX_IDLEesté encendido enLSR, luego escribir enTHR); la usanprintky el eco del teclado, que deben funcionar con las interrupciones apagadas.uartwrite, llamada desdeconsolewrite, es la mitad superior (top half): escribe un byte, ponetx_busy = 1y duerme (sleep_prepare(&tx_chan),release,sleep()).uartintres la mitad inferior (bottom half): corre en la interrupción, leeISR, ponetx_busy = 0, hacewakeup(&tx_chan)y pasa los bytes recibidos aconsoleintr. Nunca duerme.
En xv6. Al llegar una interrupción,
usertrapokerneltrap(kernel/trap.c) llaman adevintr. Siscausevale0x8000000000000009es una interrupción externa del PLIC (kernel/plic.c), que junta las de todos los dispositivos.plic_claimlee un registro MMIO del PLIC que dice cuál fue (UART0_IRQ= 10,VIRTIO0_IRQ= 1),devintrllama auartintro avirtio_disk_intr, yplic_completeavisa que ya se atendió. Siscausevale0x8000000000000005, es el reloj.
En xv6.
kernel/virtio_disk.cjunta MMIO, DMA e interrupciones.bread(kernel/bio.c) llama avirtio_disk_rw, que arma una cadena de tres descriptores (hayNUM= 8): la cabecera (leer o escribir, sector), los datos (b->data) y un byte de estado. En una lectura, el descriptor de datos llevaVRING_DESC_F_WRITE, “el dispositivo escribe aquí”: DMA hacia el buffer. Marcab->disk = 1, pone la cadena en el anilloavail, ejecutaio_fence()(fence iorw,iorw), escribe en el registro MMIOVIRTIO_MMIO_QUEUE_NOTIFYy duerme conbcomo canal mientrasb->disk == 1. Al terminar, el dispositivo escribe en el anillousede interrumpe;virtio_disk_intracusa recibo, recorreused, poneb->disk = 0y hacewakeup(b).
Discos duros
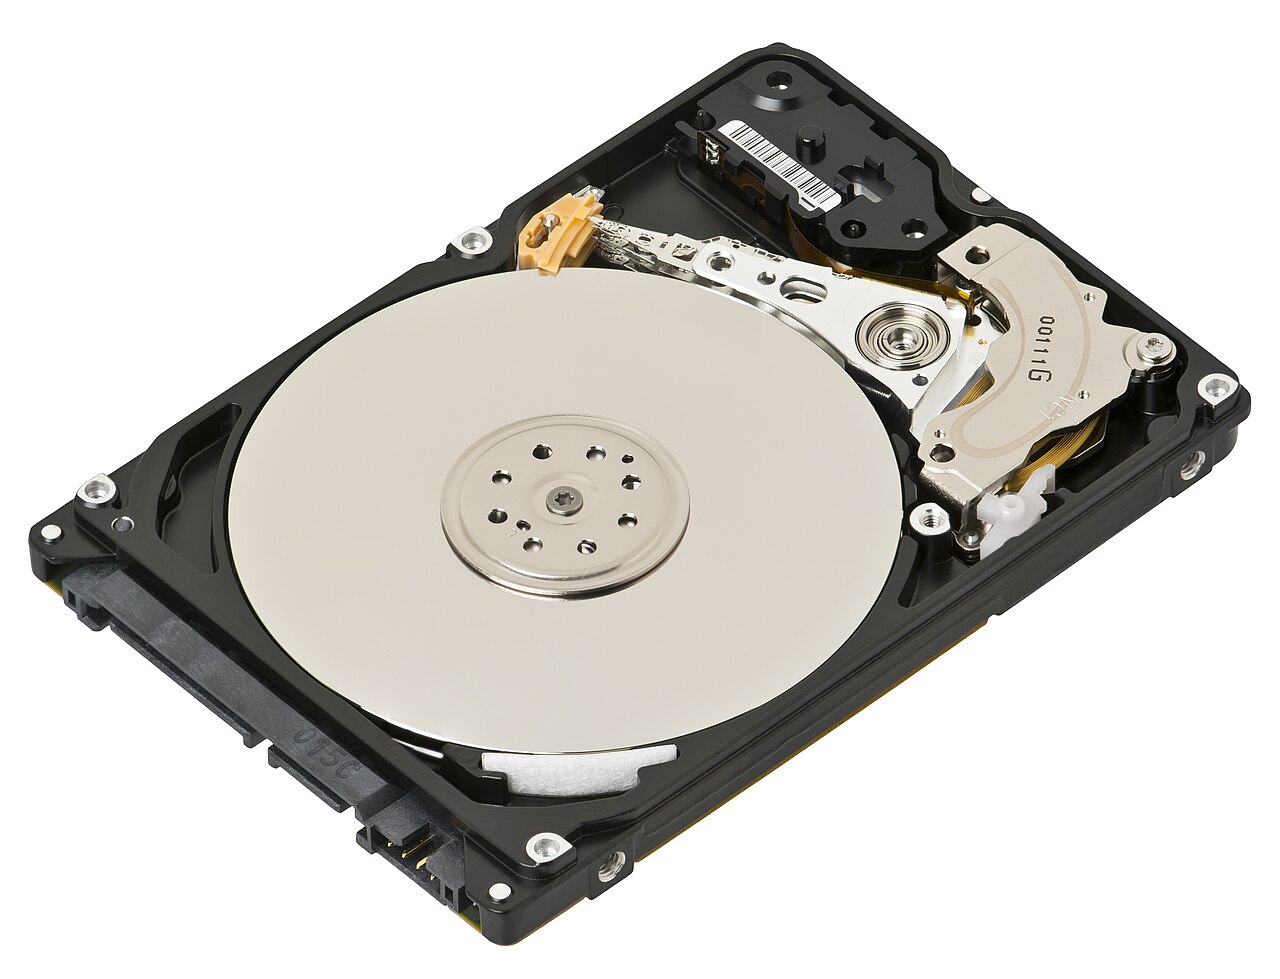
Un disco duro presenta un arreglo de sectores de 512 bytes, numerados de 0 a n − 1. Escribir un sector es atómico; varios no (si se va la luz puede quedar una escritura rota, torn write). Y hay un contrato implícito: lo cercano se lee más rápido que lo lejano, y en orden es lo más rápido de todo.
Geometría
Uno o más platos giran a velocidad constante (5 400 a 15 000 RPM). Cada superficie tiene miles de pistas concéntricas divididas en sectores, y un cabezal montado en un brazo; los brazos se mueven juntos, y las pistas bajo los cabezales forman un cilindro.
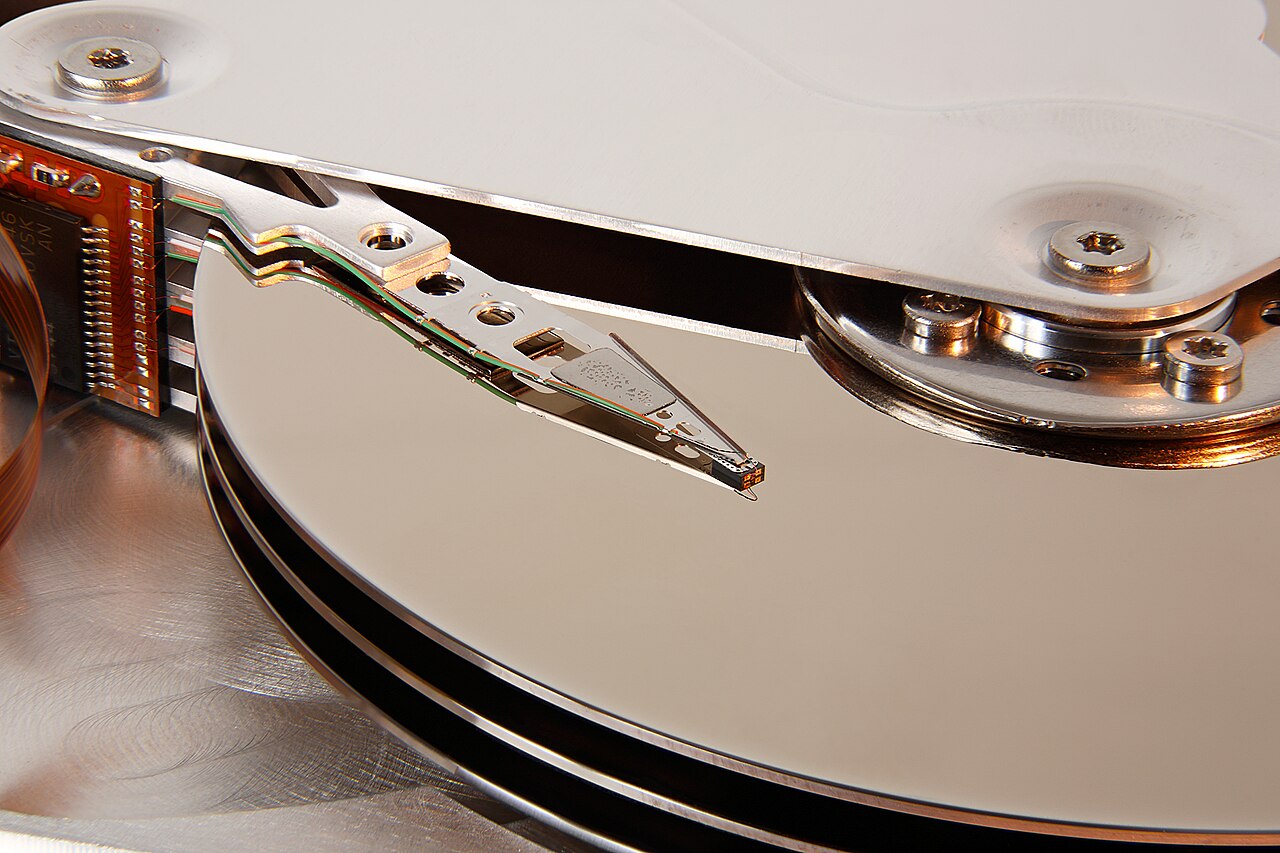
Leer un sector tiene tres partes:
- Búsqueda (seek): mover el brazo a la pista (acelerar, avanzar, frenar, asentarse). En promedio, 4 a 10 ms.
- Rotación (rotational delay): esperar a que el sector pase bajo el cabezal. En promedio, media vuelta.
- Transferencia (transfer): leer los datos mientras pasan. Para 4 KB son microsegundos.
T(E/S) = T(búsqueda) + T(rotación) + T(transferencia), y la tasa de E/S es R(E/S) = tamaño / T(E/S).
Ejemplo resuelto
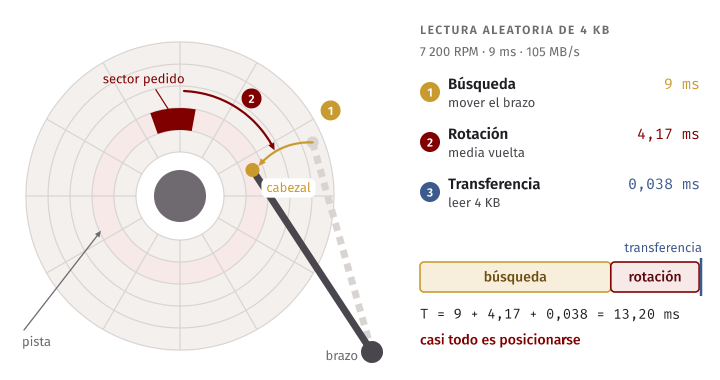
Comparemos dos discos: uno de servidor (10 000 RPM, búsqueda promedio 4,5 ms, 150 MB/s de transferencia máxima) y uno de escritorio (7 200 RPM, 9 ms, 105 MB/s). Usamos 1 MB = 1000 KB, como los fabricantes.
Una vuelta dura 60 000 / RPM milisegundos: 6,00 ms en el de servidor y 8,33 ms en el de escritorio. La rotación promedio es la mitad: 3,00 ms y 4,17 ms.
Lectura aleatoria de 4 KB. La transferencia es 4 KB / 150 MB/s = 0,027 ms en el de servidor, y 4 / 105 000 s = 0,038 ms en el de escritorio. Entonces:
Servidor: T = 4,5 + 3,00 + 0,027 = 7,53 ms, 133 lecturas por segundo, 4 KB / 7,53 ms = 0,53 MB/s. Escritorio: T = 9 + 4,17 + 0,038 = 13,20 ms, 76 lecturas por segundo, 0,30 MB/s (la pregunta de repaso 3).
Lectura secuencial de 100 MB. Se paga una búsqueda y una rotación, y luego se transfiere todo seguido: 4,5 + 3,00 + 666,7 = 674,2 ms (148,3 MB/s) en el de servidor y 9 + 4,17 + 952,4 = 965,5 ms (103,6 MB/s) en el de escritorio.
| Servidor | Escritorio | |
|---|---|---|
| Aleatorio 4 KB | 7,53 ms · 133 E/S por s · 0,53 MB/s | 13,20 ms · 76 E/S por s · 0,30 MB/s |
| Secuencial 100 MB | 674,2 ms · 148,3 MB/s | 965,5 ms · 103,6 MB/s |
| Secuencial / aleatorio | 279 veces | 342 veces |
La diferencia es de cientos de veces: en aleatorio casi todo el tiempo se va
en mover el brazo y esperar al plato. Por eso los sistemas de archivos ponen
juntos los bloques que se usan juntos. Los números salen de
disktime.c; con ./disktime RPM SEEK MB_S
pueden probar otros discos.
Detalles que cambian las cuentas
- Desfase entre pistas (track skew): el sector 0 de cada pista está corrido, para no perder una vuelta al cambiar de pista en una lectura secuencial.
- Zonas (multi-zoned): las pistas exteriores tienen más sectores.
- Caché del disco (track buffer): al leer un sector, guarda el resto de la pista.
- Write-back: el disco confirma la escritura apenas está en su caché. Rápido, pero si se va la luz el dato se pierde o llega en otro orden; será central en la consistencia ante fallos.
Planificación de disco
Cuando hay varios pedidos pendientes, el orden importa. Tomemos una cola de
ocho pedidos sobre pistas 0 a 99, con el cabezal en la pista 50, y un modelo
simple: 10 000 RPM, búsqueda de 0,5 + 0,05·d ms para d pistas y 0,1 ms de
transferencia. Cada pedido tiene además una posición angular, para poder medir
la rotación. Los números salen de
disksched.c:
$ ./disksched
cola (pista/ángulo): 85/300 20/90 58/330 93/150 41/30 10/240 67/120 46/200
cabezal en la pista 50, subiendo
FCFS   : 85 20 58 93 41 10 67 46 | 334 pistas, 39.43 ms
SSTF   : 46 41 58 67 85 93 20 10 | 144 pistas, 28.10 ms
SCAN   : 58 67 85 93 46 41 20 10 | 138 pistas, 34.10 ms
C-SCAN : 58 67 85 93 (99->0) 10 20 41 46 | 194 pistas, 33.43 ms
SPTF   : 67 85 93 58 46 41 10 20 | 136 pistas, 25.60 ms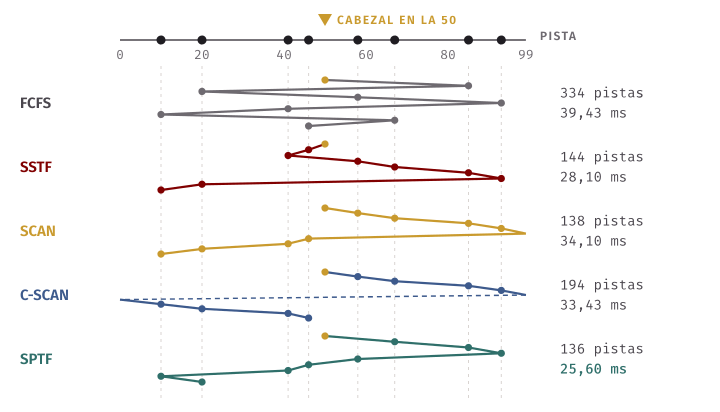
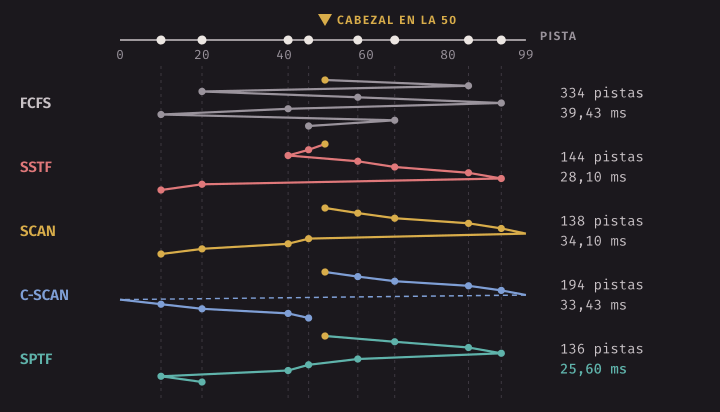
- FCFS atiende en orden de llegada.
- SSTF (shortest seek time first) elige la pista más cercana. Un pedido lejano puede esperar para siempre (inanición), y el sistema operativo no conoce la geometría real, solo números de bloque.
- SCAN (el ascensor) barre hasta el borde atendiendo en orden y vuelve: nadie espera más de dos barridas. Si gira en el último pedido, se llama LOOK.
- C-SCAN solo atiende de subida y regresa a la pista 0 sin atender (ese regreso se cuenta). Es más justo con los extremos.
- SPTF (shortest positioning time first) elige el pedido que se puede atender antes, sumando búsqueda y rotación.
SCAN recorre menos pistas que SSTF (138 contra 144) pero tarda más (34,10 contra 28,10 ms): la cuenta de pistas ignora la rotación. La primera decisión de SPTF lo muestra: desde la pista 50, SSTF elige la 46 (0,70 ms de búsqueda, pero el sector acaba de pasar: 2,63 ms de rotación, 3,43 ms en total); SPTF elige la 67, más lejos (1,35 ms), porque su sector llega 0,65 ms después: 2,10 ms en total.
Solo el disco sabe dónde está el plato, así que en la práctica el sistema
operativo ordena y junta pedidos vecinos (I/O merging) y le pasa varios
al disco, que aplica algo parecido a SPTF. Linux ofrece mq-deadline, bfq,
kyber o none, el habitual en SSD NVMe, que no tienen brazo.
Resumen
- Casi todos los bugs de concurrencia que no son deadlock son violaciones de atomicidad (arreglo: un lock) o de orden (arreglo: una variable de condición).
- Un deadlock requiere exclusión mutua, retener y esperar, sin expropiación
y espera circular. Prevenir es romper una: orden de locks, lock global,
trylock, lock-free. - En el grafo de asignación de recursos, un ciclo implica deadlock solo si cada recurso tiene una instancia; con varias, puede no haberlo.
- Evitar: un estado es seguro si existe una secuencia en que todos pueden terminar. El banquero concede una solicitud solo si el estado que resulta es seguro (Trabajo, Necesidad = Máximo − Asignado). Inseguro no es deadlock, pero ya no hay garantía.
- Detectar: el mismo algoritmo con Solicitud en lugar de Necesidad; los que no terminan están en deadlock. Recuperarse: abortar, expropiar o retroceder. Linux y casi todos los sistemas aplican la estrategia del avestruz y lo dejan al programador.
- Un servidor basado en eventos usa un hilo,
epoll_waity manejadores que no bloquean. Ahorra locks, pero el estado se guarda a mano y cualquier bloqueo o fallo de página lo detiene todo. - El sistema operativo usa registros (MMIO o puertos), polling o
interrupciones, DMA y drivers. En xv6:
uart.c,plic.c,devintryvirtio_disk.c. - En un disco duro, T(E/S) = búsqueda + rotación + transferencia; lo secuencial es cientos de veces más rápido. SSTF, SCAN/C-SCAN y SPTF ordenan los pedidos; SPTF solo lo puede hacer bien el disco.
Ejercicios
- ¿Qué condición del deadlock elimina ordenar los locks? ¿Y
trylock? ¿Por quétrylocknecesita reintentos? - Modifiquen el modo
trylockdedeadlock.cpara quitarsched_yield(). ¿Cambia el número de reintentos? Agreguen una espera aleatoria corta (usleep(rand() % 10)) y comparen. ¿Observan algo parecido a un livelock? - Reproduzcan la violación de orden del capítulo (con un
usleeppara que falle siempre) y arréglenla con una variable de condición. - Un sistema tiene R1 con dos instancias y R2 con una. P1 tiene una instancia de R1 y espera R2; P3 tiene la otra instancia de R1 y también espera R2; P2 tiene R2 y espera R1. Dibujen el grafo de asignación de recursos. ¿Hay un ciclo? ¿Hay deadlock? Comparen con la figura de las dos instancias: ¿qué cambió?
- Un sistema tiene cuatro tipos de recurso, A B C D, y Disponible =
(1 1 1 0). Máximo: P1 (2 2 1 1), P2 (3 1 1 1), P3 (1 3 2 0), P4 (2 1 2 2),
P5 (1 1 3 1). Asignado: P1 (0 1 1 0), P2 (2 0 0 1), P3 (1 1 0 0),
P4 (0 0 2 1), P5 (1 0 1 0).
a) ¿Cuántas instancias hay de cada tipo? Calculen la matriz Necesidad.
b) ¿Es seguro el estado? Si lo es, den una secuencia segura.
c) Evalúen por separado, cada una desde este estado, las solicitudes
P5 (0 0 1 0), P2 (1 0 0 0) y P3 (1 0 0 0): ¿se concede, se niega o es un
error? Justifiquen y comprueben con
banker.cescribiendo el estado en un archivo. - Dos tipos de recurso, X e Y. Disponible = (1 0). Asignado: P1 (1 0), P2 (0 1), P3 (1 1), P4 (0 1), P5 (1 0). Solicitud: P1 (0 1), P2 (1 1), P3 (0 1), P4 (1 0), P5 (0 0). a) ¿Hay deadlock? b) ¿Y si P4 pidiera (1 1)? Si lo hay, ¿qué procesos participan? ¿Basta abortar a cualquiera de ellos? ¿A cuál abortarían y por qué?
- Modifiquen
banker.cpara que, en lugar de una secuencia segura, imprima todas (con backtracking) y cuántas son. ¿Cuántas tiene el estado debank.txt? Expliquen por qué el algoritmo original no necesita probarlas todas para decidir si el estado es seguro. - ¿Por qué un servidor basado en eventos tiene problemas con los fallos de
página? ¿Lo resuelve
io_uring? ¿Y un grupo de hilos auxiliar? - Calculen el tiempo de E/S promedio para lecturas aleatorias de 4 KB en un
disco de 15 000 RPM, búsqueda promedio de 4 ms y 125 MB/s. ¿Cuántas
lecturas por segundo hace? Compruébenlo con
./disktime 15000 4 125. - Con el disco de escritorio, ¿qué tamaño de pedido aleatorio alcanza la mitad de la tasa máxima? Pista: la transferencia debe durar lo mismo que búsqueda más rotación.
- Con la cola de
disksched.c, simulen a mano LOOK (como SCAN, pero girando en el último pedido). ¿Cuántas pistas recorre? ¿Por qué SCAN tarda más que SSTF aunque recorre menos pistas? - En
kernel/virtio_disk.c, ¿por quévirtio_disk_rwduerme en un lazowhile (b->disk == 1)y no con un simpleif? ¿Qué protegedisk.vdisk_lockentrevirtio_disk_rwyvirtio_disk_intr?