
Apuntes · Capítulo 13Persistencia
RAID y la interfaz de archivos
RAID y la interfaz de archivos
La semana pasada vimos que un disco duro es lento en acceso aleatorio (unas 76 lecturas de 4 KB por segundo en nuestro disco de escritorio), tiene una capacidad limitada y, tarde o temprano, falla. Este capítulo empieza con la respuesta clásica a esos tres problemas: juntar varios discos y presentarlos como uno solo. Eso es un RAID.
En la segunda mitad subimos un piso y miramos lo que ve un programa: archivos y directorios. Estudiamos la interfaz de Unix para manejarlos y las estructuras del kernel que hay detrás, en particular la tabla de archivos abiertos (open file table). La semana 14 abrirá la caja y veremos cómo se implementa un sistema de archivos (file system) sobre el disco.
Ruta de lectura.
- Antes de clase (15–20 min): «Muchos discos como uno: RAID», «RAID 0: striping», «RAID 1: espejo», «Archivos y directorios» y «Crear, leer y escribir».
- En clase: sesión A, «RAID 4: paridad», «RAID 5: paridad rotada» y «Comparación con números»; sesión B, de «El offset y
lseek» a «Permisos,mkfsymount».- Después de clase: repasar el «Resumen», leer «Herramientas propias:
mytailymyfind» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 38 y 39, y «RAID hoy».
Lectura. Este capítulo acompaña a OSTEP cap. 38 Redundant Arrays of Inexpensive Disks (RAIDs) y cap. 39 Interlude: Files and Directories. El código está en
code/week-13;make testarma un árbol de prueba en/tmp/w13y corre todos los programas dentro del contenedor del curso.
Muchos discos como uno: RAID
Un RAID (Redundant Array of Inexpensive Disks, Patterson, Gibson y Katz, 1988) es una caja con varios discos, un procesador, memoria y, muchas veces, NVRAM respaldada por batería. Hacia afuera tiene la interfaz de un disco: un arreglo de bloques que se leen y escriben. Por dentro, cada pedido lógico se traduce a uno o varios pedidos físicos. Esa transparencia explica su éxito: el sistema operativo y los programas no cambian.
Para razonar sobre fallas usamos el modelo fail-stop: un disco funciona bien o falló por completo, y cuando falla el RAID lo sabe de inmediato. Deja fuera la corrupción silenciosa y los sectores dañados sueltos (OSTEP cap. 45).
Compararemos cada diseño en capacidad (con N discos de B bloques), confiabilidad (cuántas fallas aguanta) y rendimiento. Para el rendimiento usamos dos cargas de trabajo (workloads): secuencial, donde un disco entrega S MB/s, y aleatoria, donde entrega R MB/s. Con el disco de escritorio de la semana 12 (7 200 RPM, 9 ms de búsqueda, 105 MB/s):
| Carga | Pedido | Tiempo por pedido | Tasa |
|---|---|---|---|
| Secuencial | 100 MB | 9 + 4,17 + 952,4 = 965,5 ms | S = 103,6 MB/s |
| Aleatoria | 4 KB | 9 + 4,17 + 0,038 = 13,20 ms | R = 0,303 MB/s (76 E/S por segundo) |
Llamaremos T a la latencia de un pedido chico a un solo disco.
RAID 0: striping
El diseño más simple reparte los bloques entre los discos en ronda. Cada fila es una franja (stripe):
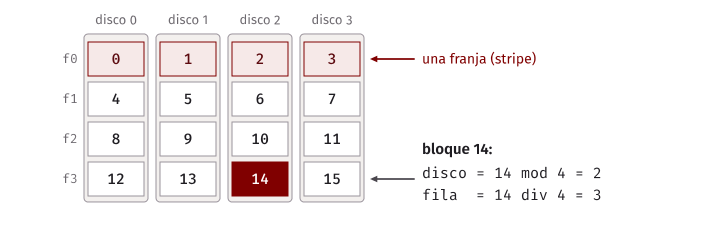
El bloque lógico A está en el disco A mod N, fila A div N: el bloque 14 de un arreglo de 4 discos está en el disco 2, fila 3.
En la práctica se pone un chunk de varios bloques por disco antes de pasar al siguiente. Un chunk chico reparte cada archivo entre muchos discos, pero cada pedido espera al disco más lento en posicionarse; uno grande evita eso, pero el paralelismo tiene que venir de muchos pedidos distintos. Los valores usuales van de 64 KB a 512 KB.
RAID 0 es la cota superior: capacidad N·B, N·S en secuencial y N·R en aleatorio. Y su confiabilidad es cero: si falla un disco, se pierde un pedazo de casi todos los archivos.
RAID 1: espejo
El espejo (mirroring) guarda cada bloque dos veces, en discos distintos. Lo común es combinarlo con striping (RAID 10): pares de espejos y, sobre ellos, franjas. Para leer, el RAID elige cualquier copia; para escribir, actualiza las dos en paralelo y espera a la más lenta.
- Capacidad N·B / 2. Aguanta una falla seguro, y hasta N/2 con suerte.
- Aleatorio: lectura N·R, escritura N/2·R.
- Secuencial: N/2·S en ambos sentidos. La lectura sorprende: si a un disco le tocan los bloques 0, 4, 8…, tiene que dejar pasar bajo el cabezal los que no le tocan, y mientras tanto no entrega datos útiles.
Idea clave. Todo RAID que actualiza varios discos en una operación tiene el problema de la actualización consistente: si se va la luz entre las dos escrituras, las copias quedan distintas. Los RAID por hardware anotan primero lo que van a hacer en una NVRAM (un pequeño log) y lo repiten al volver la luz.
RAID 4: paridad
El espejo gasta la mitad del espacio. La paridad protege contra una falla gastando un solo disco: por cada franja, un bloque extra en un disco aparte con el XOR bit a bit de los bloques de datos. El XOR de varios bits es 1 si hay un número impar de unos; dicho de otra forma, en cada posición de bit, contando la paridad, el número de unos es par. Ese es el invariante.
raid5.c guarda un texto en cinco discos de
juguete. Estos son los primeros bytes de la franja 0, tal como los imprime:
  D0     01010011  (0x53 'S')
  D1     01110011  (0x73 's')
  D2     01100001  (0x61 'a')
  D3     01110010  (0x72 'r')
  P0     00110011  (0x33 '3')
El bit 6 tiene cuatro unos (par): paridad 0. El bit 5 tiene tres (impar): paridad 1. Y así con los ocho bits y los 4 096 bytes de un bloque real.
Ahora falla el disco 2. Para el bit 5, los sobrevivientes tienen 0, 1, 1 y 1; para que el total sea par, el que falta tiene que ser 1. En general:
D2 = D0 ⊕ D1 ⊕ D3 ⊕ P0 = 01100001 = 'a'Reconstruir es lo mismo que calcular la paridad. Pero reconstruir un disco completo obliga a leer todos los demás, y si fallan dos no hay ecuación que alcance.
Escribir con paridad
Si se escribe una franja entera, el RAID calcula la paridad y escribe todo en paralelo (escritura de franja completa). Así RAID 4 logra capacidad (N−1)·B, secuencial (N−1)·S y lectura aleatoria (N−1)·R.
El problema es escribir un solo bloque. Hay dos formas de actualizar la paridad:
- Aditiva: leer los otros N−2 bloques de la franja, recalcular y escribir dato y paridad. El costo crece con N.
- Sustractiva: leer el dato viejo y la paridad vieja y aplicar P_nueva = (D_viejo ⊕ D_nuevo) ⊕ P_vieja: donde el dato cambió, la paridad se invierte. Siempre 2 lecturas y 2 escrituras.
Reemplazar ‘s’ por ‘N’ en el bloque 1:
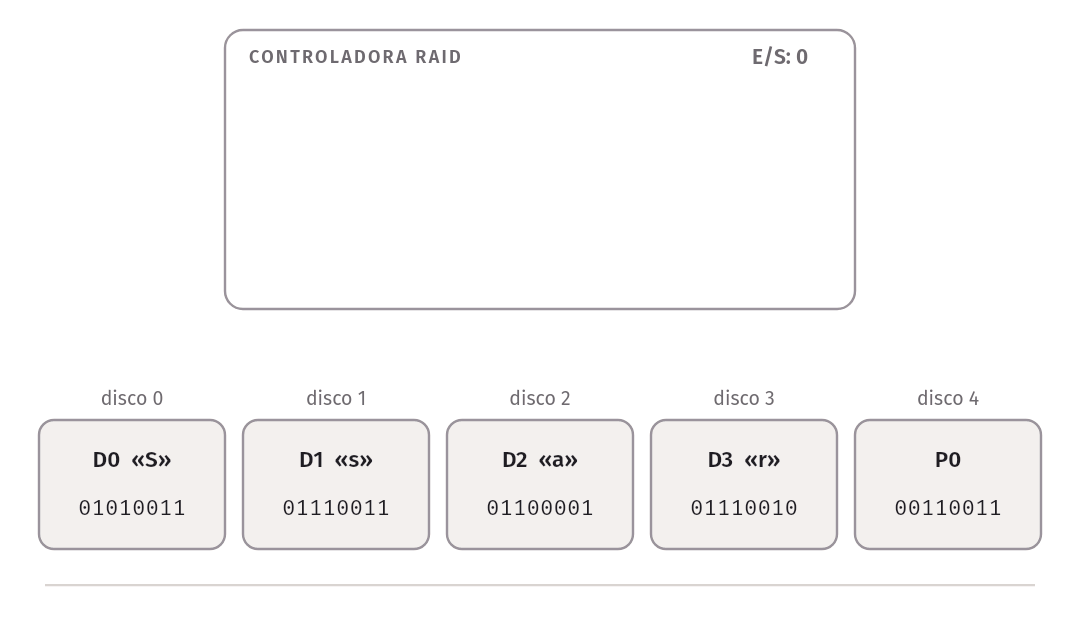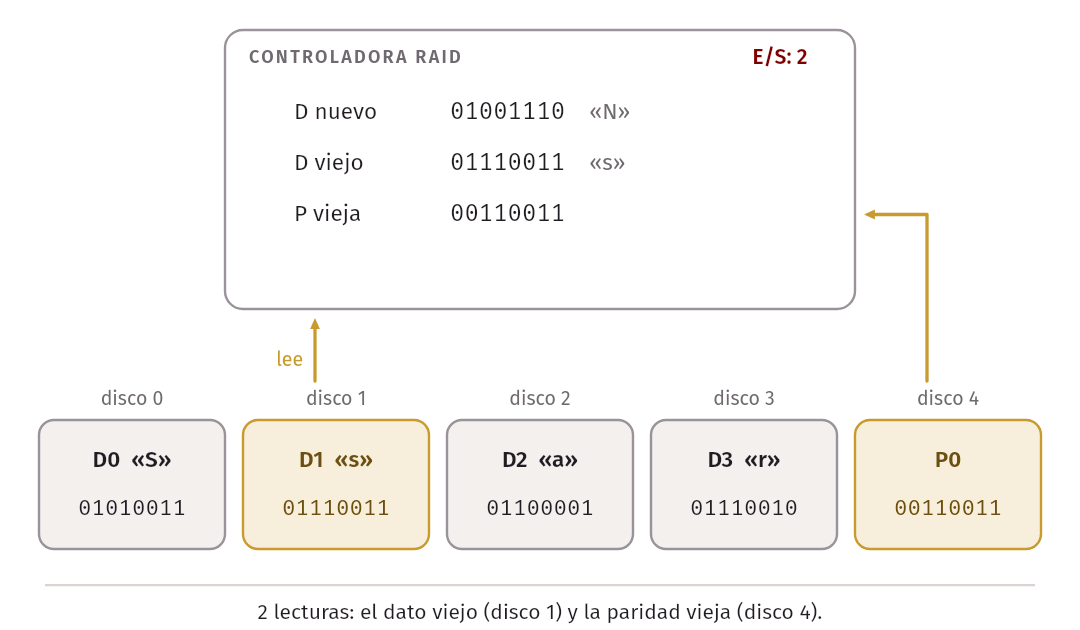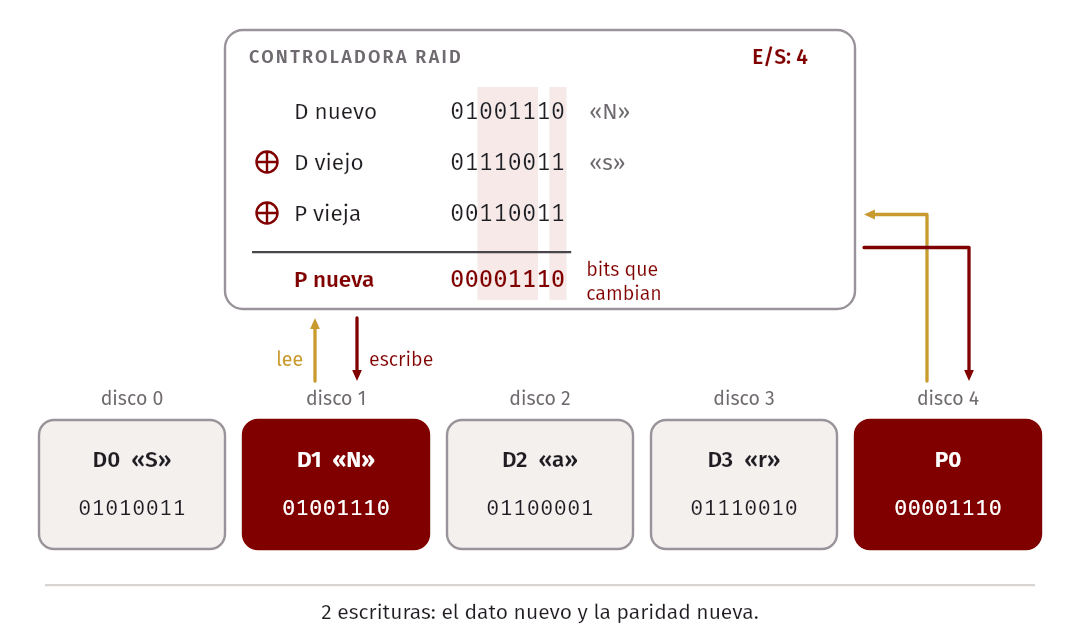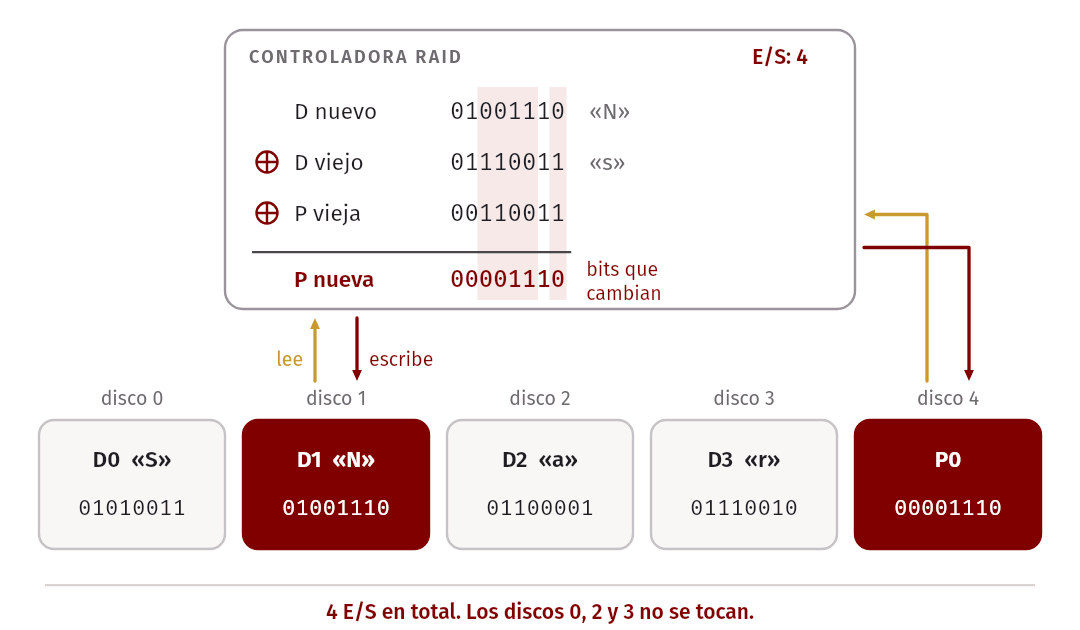
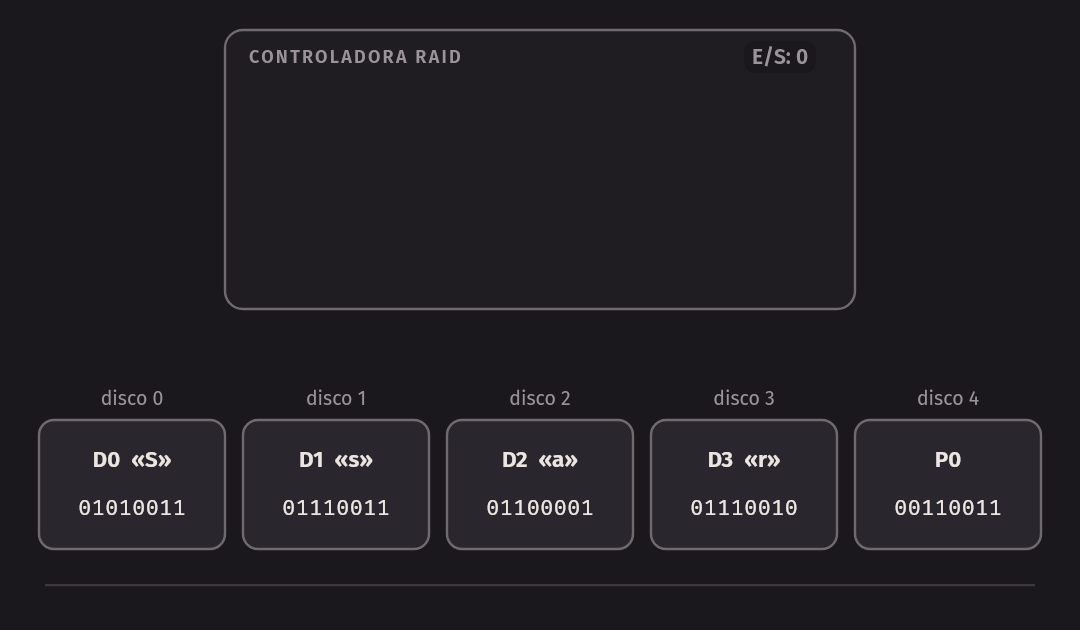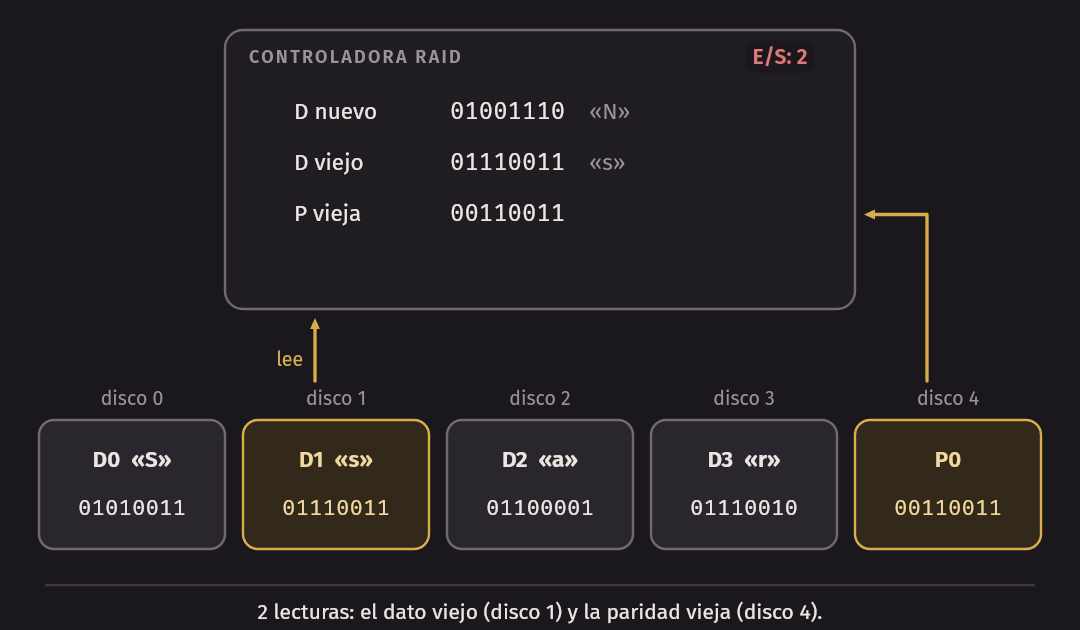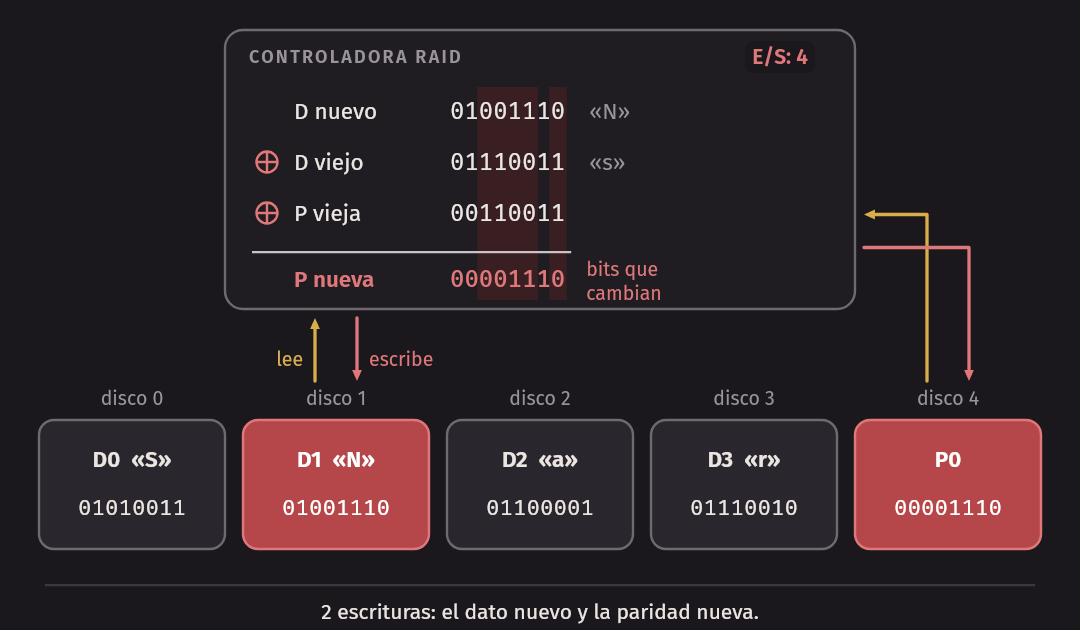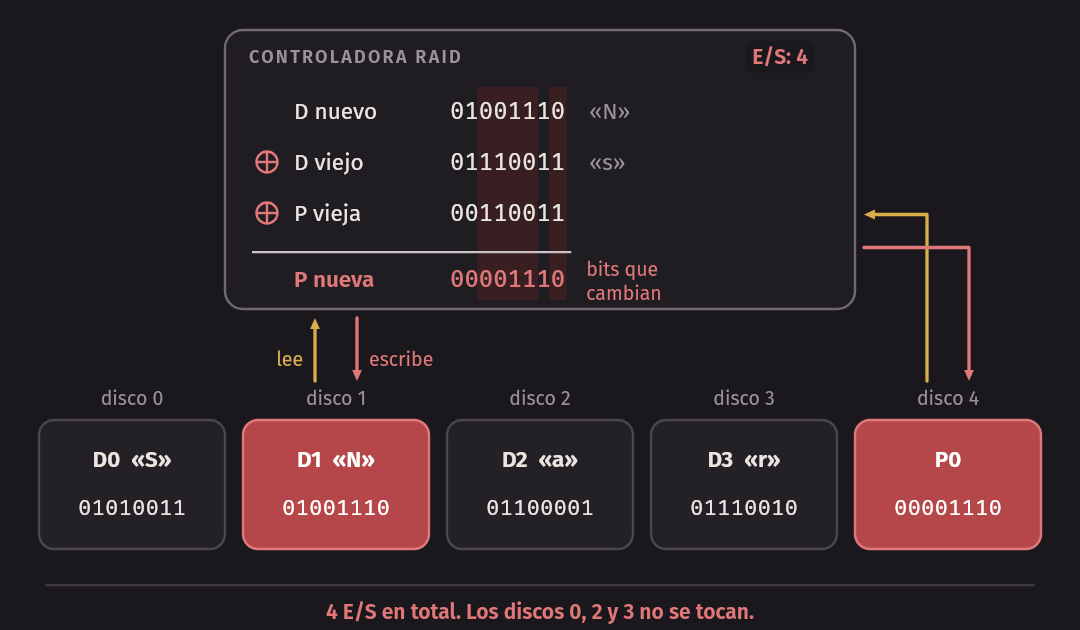
Pueden comprobar que ‘S’ ⊕ ‘N’ ⊕ ‘a’ ⊕ ‘r’ también da 00001110.
El problema de la escritura pequeña
Cada escritura pequeña cuesta 4 E/S y tarda unos 2T. Peor aún: dos escrituras simultáneas a los bloques 4 y 13 tienen sus datos en discos distintos, pero las dos leen y escriben paridad en el mismo disco. El disco de paridad hace 2 E/S por cada escritura lógica, así que todo el arreglo queda en R/2, sin importar cuántos discos se agreguen. Es el problema de la escritura pequeña (small-write problem).
RAID 5: paridad rotada
RAID 5 pone la paridad de cada franja en un disco distinto. Esta es la
distribución de raid5.c (la de OSTEP): la franja s guarda su paridad en el
disco N − 1 − (s mod N).
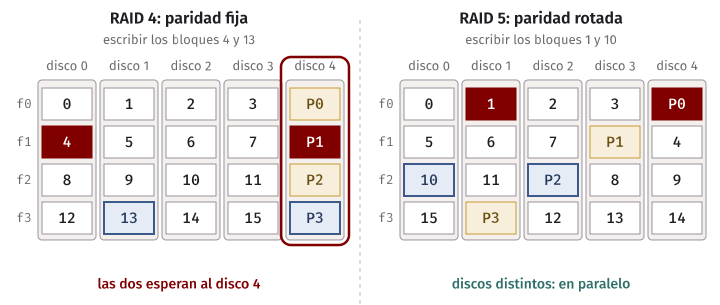
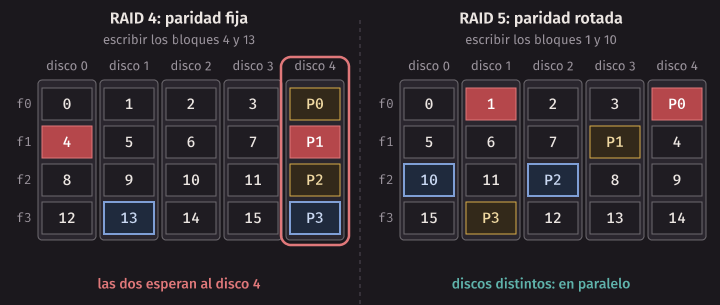
Escribir el bloque 1 usa los discos 1 y 4; escribir el 10, los discos 0 y 2: pueden ir en paralelo. Con muchos pedidos trabajan todos los discos; cada escritura sigue costando 4 E/S, y la escritura aleatoria llega a N/4·R. La lectura aleatoria sube a N·R. Por eso RAID 5 reemplazó casi por completo a RAID 4.
raid5.c hace caer un disco, reconstruye cada bloque con los otros cuatro y
lo compara con el original; luego hace una escritura pequeña sustractiva y la
verifica contra la paridad recalculada desde cero:
$ ./raid5 2
...
Falla el disco 2. Reconstrucción:
  f0: "a, la pa"  == original
  f1: "s: basta"  == original
  f2: P2 = 59 4a 08 0a 01 00 5b 4e  == original
  f3: " la fran"  == original
  4/4 bloques recuperados, 16 lecturas

Escritura pequeña al bloque 6:
  dato en disco 1, paridad en disco 3
  2 lecturas + 2 escrituras = 4 E/S
  paridad sustractiva == recalculada
Comparación con números
| RAID 0 | RAID 1 | RAID 4 | RAID 5 | |
|---|---|---|---|---|
| Capacidad | N·B | N·B/2 | (N−1)·B | (N−1)·B |
| Fallas que aguanta | 0 | 1 (hasta N/2) | 1 | 1 |
| Secuencial (lectura y escritura) | N·S | N/2·S | (N−1)·S | (N−1)·S |
| Lectura aleatoria | N·R | N·R | (N−1)·R | N·R |
| Escritura aleatoria | N·R | N/2·R | 1/2·R | N/4·R |
| Latencia lectura / escritura | T / T | T / T | T / 2T | T / 2T |
Con 8 discos de 4 TB y nuestro disco de escritorio:
| Capacidad | Secuencial | Lectura aleatoria | Escritura aleatoria | |
|---|---|---|---|---|
| RAID 0 | 32 TB | 829 MB/s | 606 E/S/s | 606 E/S/s |
| RAID 1 | 16 TB | 414 MB/s | 606 E/S/s | 303 E/S/s |
| RAID 4 | 28 TB | 725 MB/s | 530 E/S/s | 38 E/S/s |
| RAID 5 | 28 TB | 725 MB/s | 606 E/S/s | 151 E/S/s |
Idea clave. Solo rendimiento: RAID 0. Rendimiento en escrituras aleatorias con confiabilidad: RAID 1, pagando la mitad del espacio. Capacidad con confiabilidad: RAID 5, sabiendo que cada escritura pequeña cuesta 4 E/S.
RAID hoy
Reconstruir un disco exige leer todos los demás y escribir el reemplazo completo; la cota inferior es tamaño / velocidad. Un disco de 20 TB a 250 MB/s necesita unas 22 horas, y más si el arreglo sigue atendiendo pedidos. Durante ese tiempo un RAID 5 no tiene redundancia, y los discos que quedan son del mismo lote y la misma edad que el que falló. Por eso con discos grandes se usa RAID 6: dos bloques de redundancia por franja, P (XOR) y Q (un código de Reed–Solomon). Aguanta dos fallas, su capacidad es (N−2)·B y una escritura pequeña cuesta 6 E/S.
El RAID puede vivir en una tarjeta controladora o en el kernel: en Linux, el
driver md (que se administra con mdadm) hace RAID 0, 1, 4, 5, 6 y 10 por
software. ZFS junta el sistema de archivos con el RAID (RAID-Z1, Z2 y Z3). Los
dos enfrentan el hueco de escritura (write hole): si la luz se va entre la
escritura del dato y la de la paridad, la franja queda inconsistente sin que
nadie lo note. md ofrece un bitmap de intención de escritura y, para RAID 5,
un journal o un log de paridad parcial (PPL). ZFS nunca sobrescribe en su lugar
(copy-on-write) y guarda checksums, con lo que también detecta la corrupción
silenciosa que el modelo fail-stop ignora.
Y una advertencia: RAID no es un backup. Si alguien borra un archivo, el RAID borra todas sus copias.
Archivos y directorios
Un archivo es un arreglo de bytes; al sistema de archivos no le interesa qué hay adentro. Su nombre de bajo nivel es el número de inodo (inode number), y el inodo guarda sus metadatos: tamaño, owner, permisos, fechas y dónde están sus bloques.
Un directorio también tiene inodo, y su contenido es una lista de pares
(nombre, número de inodo). Directorios dentro de directorios forman el
árbol. Para abrir /home/ana/notas.txt se busca home en /, ana en
home y notas.txt en ana. El nombre de un archivo no está en su inodo:
está en el directorio que lo contiene.
Crear, leer y escribir
int fd = open("foo", O_CREAT | O_WRONLY | O_TRUNC, S_IRUSR | S_IWUSR);O_CREAT crea el archivo si no existe, O_TRUNC lo vacía si existe y el
tercer argumento da los permisos. El resultado es un descriptor de archivo
(file descriptor): un entero chico, privado del proceso, que funciona como una
capability. Cada proceso empieza con los descriptores 0, 1 y 2 abiertos, y
open devuelve el número libre más bajo: casi siempre 3.
strace muestra lo que hace cat (sin la carga de bibliotecas):
$ strace -e trace=openat,read,write,close cat foo
...
openat(AT_FDCWD, "foo", O_RDONLY)       = 3
read(3, "hola\n", 131072)               = 5
write(1, "hola\n", 5hola
)                   = 5
read(3, "", 131072)                     = 0
close(3)                                = 0
cat pide hasta 128 KB, recibe 5 bytes y los escribe en el descriptor 1.
Cuando read devuelve 0, llegó al fin del archivo.
El offset y lseek
Cada archivo abierto tiene un offset: dónde empieza la próxima lectura o
escritura. read y write lo avanzan; lseek(fd, off, whence) lo cambia
(SEEK_SET desde el inicio, SEEK_CUR desde donde está, SEEK_END desde el
final). Con un archivo de 300 bytes:
| Llamada | Retorna | offset después |
|---|---|---|
fd = open("f", O_RDONLY) |
3 | 0 |
read(fd, buf, 100) |
100 | 100 |
read(fd, buf, 100) |
100 | 200 |
lseek(fd, 250, SEEK_SET) |
250 | 250 |
read(fd, buf, 100) |
50 | 300 |
read(fd, buf, 100) |
0 | 300 |
A pesar del nombre, lseek no mueve el disco: solo cambia un número en la
memoria del kernel.
La tabla de archivos abiertos
El offset no vive en el descriptor ni en el inodo, sino en un nivel intermedio:
- Cada proceso tiene un arreglo de descriptores; el descriptor es un índice.
- Cada posición ocupada apunta a una entrada de la tabla de archivos abiertos, una sola para todo el sistema, con el offset, el modo, un contador de referencias y un puntero al inodo.
- El inodo en memoria representa al archivo.
Cada open crea una entrada nueva: dos open del mismo archivo (en uno o
en dos procesos) dan offsets independientes. Dos llamadas hacen, en cambio, que
dos descriptores compartan una entrada:
fork()copia el arreglo de descriptores, no las entradas. Si el hijo lee 10 bytes, el offset del padre también pasa a 10. Así un padre y sus hijos escriben en la misma salida sin pisarse.dup(fd)da otro descriptor del mismo proceso que apunta a la misma entrada. La shell hacecmd > out 2>&1abriendoouten el descriptor 1 y luegodup2(1, 2).
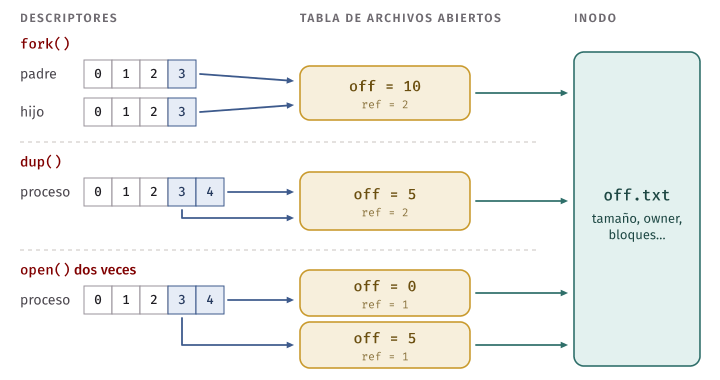
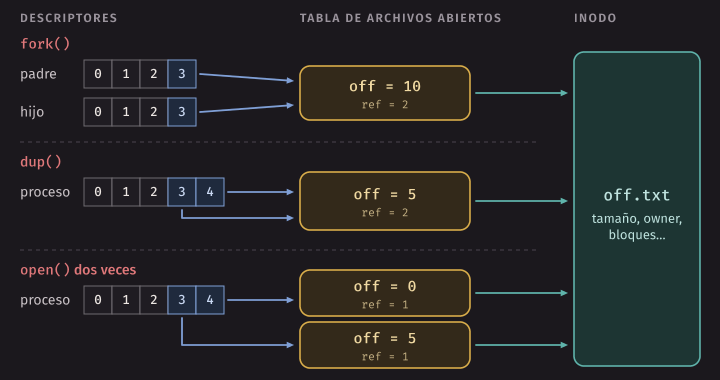
shareoff.c prueba los tres casos sobre un
archivo con el abecedario (el offset se consulta con lseek(fd, 0, SEEK_CUR)):
$ ./shareoff /tmp/w13/off.txt
1) fork():
  hijo  lee 10 bytes: "abcdefghij"
  offset del padre: 10
  padre lee 5 bytes: "klmno"
2) dup():
  fd    lee 5 bytes: "abcde"
  offset de fd=3: 5, de fd2=4: 5
3) open() dos veces:
  a     lee 5 bytes: "abcde"
  offset de a=3: 5, de b=4: 0
  b     lee 5 bytes: "abcde"
Antes de fork el programa hace fflush(stdout): si no, con la salida en un
pipe, el texto pendiente en el buffer de stdio se copiaría al hijo y
aparecería dos veces (el misterio de la semana 2).
En xv6. La entrada de la tabla es
struct file(kernel/file.h), contype,ref,readable,writable, el inodoipy el offsetoff. La tabla del sistema esftable(kernel/file.c):NFILE= 100 entradas bajo un spinlock, libres siref == 0. La tabla de descriptores esstruct file *ofile[NOFILE]enstruct proc(kernel/proc.h), conNOFILE= 16.sys_openpide siempre una entrada nueva confilealloc()y le poneoff = 0.kfork()(kernel/proc.c) llama afiledup()por cada descriptor abierto, ysys_duptambién: ambos copian el puntero y hacenf->ref++.fileclose()resta uno y solo conrefen 0 libera la entrada y suelta el inodo coniput(). xv6 no tienelseek.
Escribir de verdad: fsync
Cuando write retorna, los datos casi nunca están en el disco: están en la
caché de páginas del kernel, marcados como sucios. En Linux, por defecto,
cada 5 segundos se escriben los bloques sucios que llevan más de 30. Si la luz
se va antes, se pierden. Un programa que necesita durabilidad llama a
fsync(fd): el kernel escribe los datos y metadatos sucios del archivo, le
pide al disco que vacíe su propia caché y recién entonces retorna
(fdatasync omite los metadatos que no hacen falta para leerlo).
Un archivo recién creado también vive en su directorio: para que su nombre
sobreviva a una caída, hay que hacer fsync también del directorio.
Reemplazar un archivo de forma atómica: rename
Reescribir un archivo en su lugar es peligroso: una caída a la mitad deja un
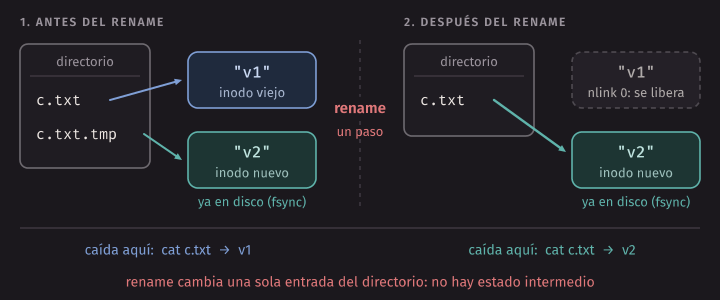
archivo vacío o una mezcla. rename(viejo, nuevo) cambia la entrada del
directorio en un solo paso, también frente a caídas: el nombre apunta al
inodo viejo o al nuevo, nunca a algo intermedio. El patrón, en
atomic.c: escribir la versión nueva en un
temporal, fsync del temporal, rename sobre el nombre final y fsync del
directorio. Con la opción crash, el programa termina justo antes del
rename:
$ cd /tmp/w13
$ /work/atomic c.txt v1
escrito y sincronizado: c.txt.tmp
rename c.txt.tmp -> c.txt listo
$ /work/atomic c.txt v2 crash
escrito y sincronizado: c.txt.tmp
*** caída simulada antes de rename ***
$ cat c.txt
v1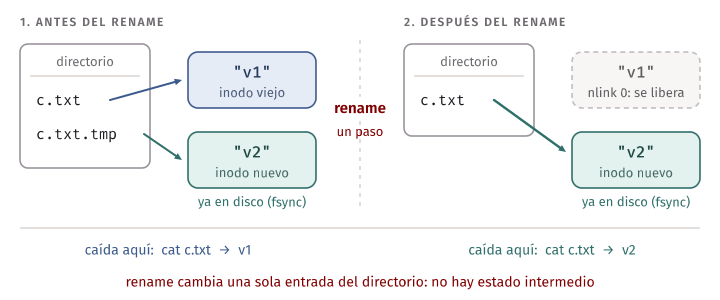
Metadatos: stat
stat devuelve el inodo en un struct stat: dispositivo e inodo, tipo y
permisos (st_mode), enlaces (st_nlink), owner, grupo, tamaño, bloques y
tres fechas: acceso, modificación del contenido y cambio del inodo. lstat
describe el enlace simbólico en vez de su destino; fstat recibe un
descriptor. mystat.c es un stat mínimo:
$ ./mystat /tmp/w13/docs/a.txt
/tmp/w13/docs/a.txt
  tipo      archivo regular
  inodo     35442243  (dispositivo 0:108)
  enlaces   2
  tamaño    5 bytes, 8 bloques de 512
  permisos  0644 rw-r--r--  owner root  grupo root
  ...
5 bytes ocupan 8 bloques de 512: el sistema de archivos reserva bloques de 4 KB. ¿Y por qué 2 enlaces? Lo vemos enseguida.
Directorios
mkdir crea un directorio con dos entradas: . (él mismo) y .. (el padre);
rmdir solo borra uno vacío. Se leen con opendir, readdir y closedir:
cada struct dirent trae nombre e inodo, y el resto sale de un lstat por
entrada. Así funciona ls -l, y así myls.c:
$ ./myls -l /tmp/w13/docs
35442243 -rw-r--r--  2 root  root       5 Nov  4 14:35 a.txt
35442243 -rw-r--r--  2 root  root       5 Nov  4 14:35 b.txt
35442240 drwxr-xr-x  2 root  root    4096 Nov  4 14:35 notas
35442245 lrwxrwxrwx  1 root  root       8 Nov  4 14:35 roto -> nada.txt
35442244 lrwxrwxrwx  1 root  root       5 Nov  4 14:35 sim -> a.txt
Lo que no se puede es escribir un directorio con write: solo el kernel lo
modifica, vía open con O_CREAT, mkdir, link, unlink o rename. Un
directorio tiene 2 + (subdirectorios) enlaces: su entrada en el padre, su
. y el .. de cada hijo. docs tiene un subdirectorio, y
mystat /tmp/w13/docs muestra enlaces 3.
Enlaces duros y unlink
En la salida de myls, a.txt y b.txt tienen el mismo inodo: son dos
nombres del mismo archivo. Eso es un enlace duro (hard link), y se crea con
link() o con ln:
$ echo hola > file
$ ln file file2
$ ls -li file file2
34297533 -rw-r--r-- 2 root root 5 Oct 29 09:22 file
34297533 -rw-r--r-- 2 root root 5 Oct 29 09:22 file2
$ rm file
$ ls -li file2
34297533 -rw-r--r-- 1 root root 5 Oct 29 09:22 file2
ln no copia nada: agrega una entrada con el mismo número de inodo y sube el
contador nlink. Ninguno de los nombres es el “original”. rm file borra una
entrada y baja nlink a 1.
Por eso la llamada que usa rm se llama unlink y no delete: solo quita
un enlace. El archivo desaparece cuando nlink llega a 0 y ningún proceso
lo tiene abierto:
$ exec 3< file2      # la shell lo abre en el descriptor 3
$ rm file2           # nlink = 0
$ cat <&3            # todavía se puede leer
hola
Es un truco útil: crear un temporal, abrirlo y hacerle unlink enseguida.
Nadie más lo ve, y el kernel lo borra cuando el programa lo cierra o termina.
En xv6.
nlinkes un campo destruct dinode(kernel/fs.h): vive en el disco.sys_link(kernel/sysfile.c) haceip->nlink++,iupdate(ip)y agrega la entrada condirlink; no acepta directorios.sys_unlinkllena de ceros la entrada conwriteiy haceip->nlink--. Los bloques se liberan eniput()(kernel/fs.c), que calculalast = (ip->ref == 1 && ip->valid && ip->nlink == 0): solo si nadie más tiene el inodo en memoria y nadie lo nombra en el disco,itrunclibera los bloques eifreeel inodo.nlinkcuenta nombres;ref, referencias.
Enlaces simbólicos
Un enlace duro no puede apuntar a un directorio (habría ciclos) ni a otro
sistema de archivos (los números de inodo solo valen dentro de uno). El
enlace simbólico (symbolic link) sí: ln -s a.txt sim crea un archivo
nuevo, de otro tipo, cuyo contenido es la ruta del destino (por eso sim
mide 5 bytes). No suma al nlink del destino, y si el destino se borra queda
colgando (dangling):
$ rm a.txt
$ cat sim
cat: sim: No such file or directory
$ ls -l sim
lrwxrwxrwx 1 root root 5 Oct 29 09:22 sim -> a.txt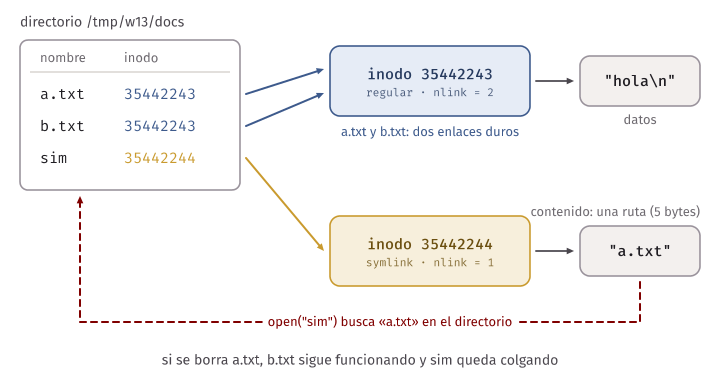
Permisos, mkfs y mount
Los nueve bits bajos de st_mode dan lectura, escritura y ejecución para el
owner, el grupo y los demás: -rw-r--r-- es 0644, y chmod 600 f deja el
archivo solo para su owner. En un directorio, r permite listarlo, w crear y
borrar entradas, y x atravesarlo. root pasa por encima de todo. Una ACL
(access control list) da permisos a usuarios y grupos con nombre:
setfacl -m u:nobody:r f agrega una entrada user:nobody:r--, y ls -l
muestra un + junto a los permisos.
Para armar el árbol, mkfs escribe un sistema de archivos vacío en un
dispositivo o en un archivo imagen (mkfs.ext4 disk.img en el contenedor crea
uno de 16 384 bloques de 4 KB con su journal), y
mount -t ext4 /dev/sdb1 /home/users lo pega en un punto del árbol: desde ese
momento, /home/users/ana es /ana del otro disco. Un solo árbol reúne así
ext4, tmpfs, proc y otros. (Montar pide privilegios que el contenedor no tiene.)
Herramientas propias: mytail y myfind
mytail.c imprime las últimas n líneas sin leer
todo el archivo: fstat da el tamaño, lseek salta cerca del final y lee
bloques de 4 KB hacia atrás contando saltos de línea:
$ ./mytail -3 /tmp/w13/log.txt
línea 1998
línea 1999
línea 2000
[mytail: 4096 de 22893 bytes examinados]
myfind.c recorre el árbol con recursión,
scandir y lstat, con filtros -name y -type. Con lstat no sigue
enlaces simbólicos, así que no cae en ciclos: ./myfind /tmp/w13 -type l
encuentra docs/roto y docs/sim.
En xv6. La interfaz de archivos de xv6 es pequeña (ver
user/usys.pl): no tienelseek,rename,fsyncni enlaces simbólicos, aunque sí unsyncque espera a que se confirme el log (sys_syncenkernel/log.c). El proyecto P5 (labfsdel MIT) agrega archivos grandes, con un bloque doblemente indirecto (semana 14), y enlaces simbólicos: la llamadasymlink(target, path), el tipoT_SYMLINKy la opciónO_NOFOLLOW.opendebe seguir el enlace, también si apunta a otro enlace, con un límite de profundidad contra los ciclos.
Resumen
- Un RAID presenta varios discos como uno. Con el modelo fail-stop, se compara por capacidad, confiabilidad y rendimiento (N, B, S, R, T).
- RAID 0 reparte: rápido y sin protección. RAID 1 copia: aguanta una falla y gasta la mitad. RAID 4/5 guardan la paridad XOR, que reconstruye cualquier disco que falle.
- Una escritura pequeña con paridad cuesta 4 E/S. En RAID 4 el disco de paridad la limita a R/2; RAID 5 rota la paridad y llega a N/4·R. Con discos grandes se usa RAID 6.
- Descriptor → entrada de la tabla de archivos abiertos (offset,
referencias) → inodo.
forkydupcomparten la entrada; dosopen, no. writeno es durable sinfsync. Reemplazo atómico: temporal,fsync,rename.- Un directorio guarda pares (nombre, inodo).
unlinkquita un nombre; el inodo se libera connlink == 0y sin referencias abiertas. Un enlace simbólico guarda una ruta y puede quedar colgando.
Ejercicios
- Un RAID 4 tiene en una franja los bytes 0x0F, 0xA0, 0x33 y 0x5C. Calculen la paridad. Cambien 0xA0 por 0xFF con el método sustractivo y comprueben que coincide con recalcularla desde cero.
- ¿Cuántas E/S cuesta una escritura pequeña en RAID 4? ¿Para qué N conviene el método aditivo? ¿Por qué RAID 5 mejora las escrituras aleatorias y no las secuenciales?
- Repitan la tabla de 8 discos con N = 4. ¿Cómo queda la escritura aleatoria de RAID 5 frente a un solo disco?
- Con
raid.py(homework del cap. 38), comparen-L 5 -5 LSy-L 5 -5 LA. ¿Cuál de las dos distribuciones usaraid5.c? - ¿Por qué se llama
unlink? Escriban un programa que cree un archivo, lo abra, le hagaunlink, escriba 1 MB y lo vuelva a leer. ¿Cuándo se libera el espacio? - Modifiquen
shareoff.cpara que padre e hijo escriban en el mismo descriptor, y luego en dos descriptores abiertos por separado. Comparen el contenido final del archivo. - Agreguen a
myfindla opción-Lpara seguir enlaces simbólicos y creen un enlaceciclo -> ... ¿Qué pasa? Detecten el ciclo const_devyst_ino.