
Apuntes · Capítulo 14Persistencia
Implementación de sistemas de archivos y journaling
Implementación de sistemas de archivos y journaling
La semana 13 miramos el sistema de archivos (file system) desde afuera: las
llamadas open, read, write, link, unlink, fsync y rename, y las
tablas del kernel que conectan un descriptor de archivo con un inodo (inode).
Este capítulo abre la caja. Un sistema de archivos es software puro: el disco
solo ofrece un arreglo de bloques numerados que se leen y escriben enteros. Con
eso hay que construir archivos, directorios y nombres, y hacerlo de forma que
sobreviva a un apagón en el peor momento.
Primero diseñamos un sistema de archivos mínimo, contamos cuántas E/S cuesta
cada llamada y vemos cómo lo hace xv6. Después estudiamos el rendimiento
(FFS) y la consistencia ante fallos (crash consistency): fsck y
journaling.
Ruta de lectura.
- Antes de clase (15–20 min): «Repartir el disco», «Directorios y espacio libre» y «Consistencia ante fallos».
- En clase: sesión A, «Del inodo a los datos: punteros e índices multinivel», «Recorrer una ruta», «Caché y write buffering» y «El sistema de archivos de xv6»; sesión B, «FFS: la localidad importa», «Journaling» y «El log de xv6».
- Después de clase: repasar el «Resumen», leer «Hacia P5» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 40 a 42, «Extents» y «Otras soluciones».
Lectura. Este capítulo acompaña a OSTEP cap. 40 File System Implementation, cap. 41 Locality and The Fast File System y cap. 42 Crash Consistency: FSCK and Journaling. El código está en
code/week-14;make testcorre todos los ejemplos dentro del contenedor del curso.
Repartir el disco
Para entender un sistema de archivos hay que responder dos preguntas: qué
estructuras de datos hay en el disco y qué métodos de acceso las
recorren en cada llamada. Las respondemos para VSFS (Very Simple File
System), el sistema de juguete de OSTEP, que implementamos en
vsfs.c, y después para xv6. Tomemos un disco
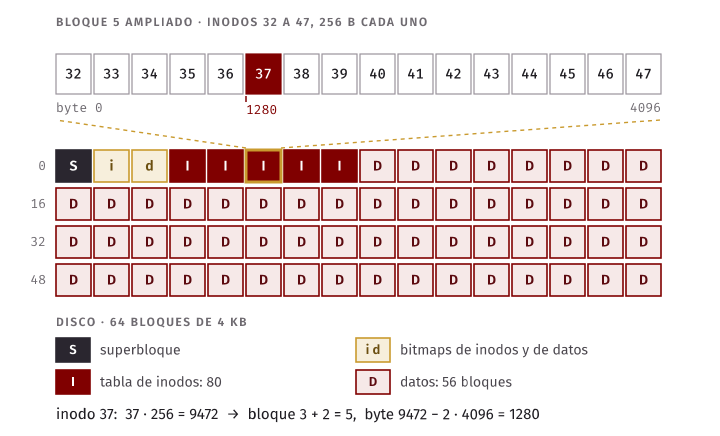
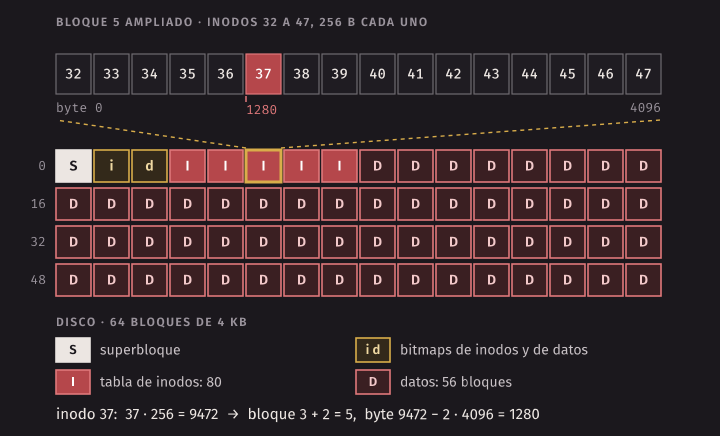
diminuto de 64 bloques de 4 KB. VSFS lo reparte así:
| Bloques | Contenido |
|---|---|
| 0 | superbloque (superblock) |
| 1 | bitmap de inodos |
| 2 | bitmap de bloques de datos |
| 3–7 | tabla de inodos (inode table) |
| 8–63 | bloques de datos |
La tabla de inodos ocupa 5 bloques; con inodos de 256 bytes caben 16 por bloque: 80 inodos, es decir, a lo más 80 archivos. Los bitmaps llevan un bit por objeto (0 libre, 1 ocupado). El superbloque dice cuántos inodos y bloques hay y dónde empieza cada región, y lleva un número mágico que identifica el tipo de sistema; es lo primero que el kernel lee al montar.
El inodo
El inodo guarda todo lo que el sistema sabe de un archivo, salvo su nombre:
tipo (archivo, directorio, enlace simbólico), tamaño en bytes, número de
enlaces (nlink), owner y permisos, tiempos de acceso y modificación, y los
punteros a los bloques de datos. Es lo que devuelve stat. El inodo, los
bitmaps, los directorios y el superbloque son metadatos: datos sobre los
datos. La distinción entre datos y metadatos va a importar en el journaling.
Cada inodo tiene un número (i-number), y la tabla de inodos es un arreglo: la posición de un inodo se calcula, no se busca.
Ejemplo: ¿dónde está el inodo 37?
- Byte dentro de la tabla: 37 · 256 = 9472.
- Bloque de la tabla: ⌊9472 / 4096⌋ = 2, así que es el bloque 3 + 2 = 5.
- Byte dentro del bloque: 9472 mod 4096 = 1280.
- Si el disco tiene sectores de 512 B: ⌊(5 · 4096 + 1280) / 512⌋ = sector 42.
./vsfs img stat 37 imprime inodo 37: bloque 5, byte 1280 del bloque.
Del inodo a los datos: punteros e índices multinivel
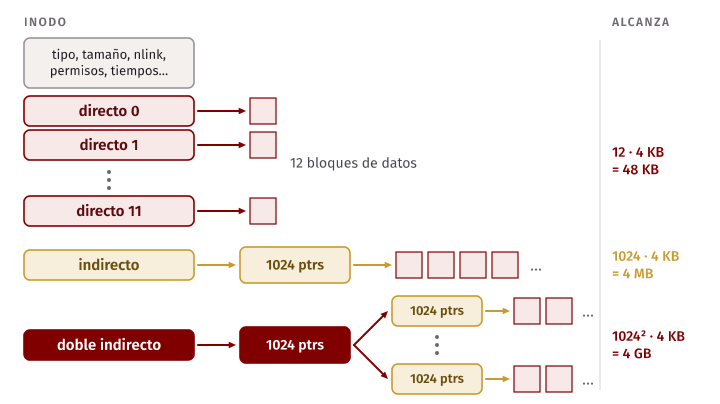
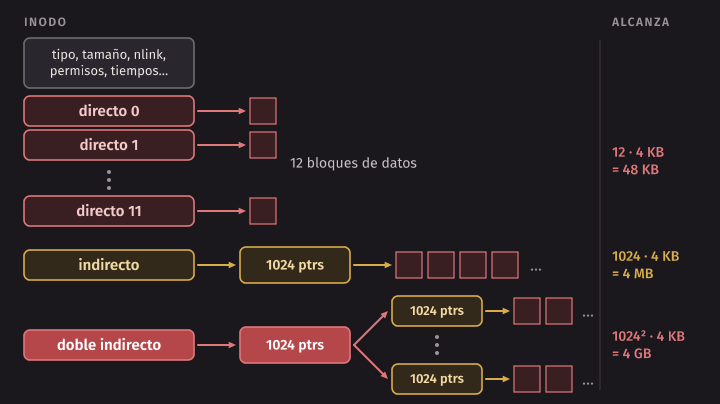
Lo más simple es guardar en el inodo un puntero directo por bloque. VSFS tiene 12: con bloques de 4 KB, apenas 48 KB. La solución clásica es el puntero indirecto: apunta a un bloque que no guarda datos sino 1024 punteros de 4 bytes. Un doble indirecto apunta a un bloque de punteros a bloques indirectos, y un triple agrega otro nivel. Es un árbol desequilibrado a propósito: los archivos chicos se resuelven con punteros directos y los grandes pagan una o dos lecturas más. ext2 y ext3 lo usan.
Ejemplo resuelto: tamaño máximo. Bloques de 4 KB, punteros de 4 B, 12 directos y un indirecto:
- Punteros por bloque: 4096 / 4 = 1024.
- Bloques alcanzables: 12 + 1024 = 1036.
- Tamaño máximo: 1036 · 4 KB = 4144 KB, unos 4 MB.
Un doble indirecto suma 1024² bloques (≈ 4 GB) y un triple, 1024³ (≈ 4 TB).
El programa bmapcalc.c hace la cuenta:
$ ./bmapcalc -max 4096 4 12
1024 punteros por bloque
12 + 1024 = 1036 bloques = 4144 KB
Extents
Otra opción son los extents: pares (bloque inicial, longitud). Un archivo de 10 bloques contiguos desde el 520 necesita 10 punteros, o un solo extent (520, 10). Son compactos si el archivo está contiguo y menos flexibles si el espacio libre está fragmentado; ext4, XFS y btrfs los usan. La lista enlazada de bloques (la FAT de las memorias USB) es simple, pero un acceso aleatorio recorre la cadena.
Idea clave. En sistemas reales, la mayoría de los archivos es pequeña, pero la mayoría de los bytes está en unos pocos archivos grandes. Los índices multinivel atienden bien a los dos casos.
Directorios y espacio libre
Un directorio es un archivo cuyo contenido es una lista de pares (nombre,
número de inodo), incluidas . y ... Borrar una entrada suele ser marcar su
inodo como 0. Para directorios con miles de entradas, XFS y ext4 usan árboles o
tablas hash. Para el espacio libre, VSFS usa bitmaps; muchos sistemas además
reservan varios bloques contiguos de una vez (pre-asignación) para que las
lecturas secuenciales sean rápidas.
Recorrer una ruta
¿Qué pasa en el disco con open("/foo/bar", O_RDONLY) y la lectura de sus 3
bloques? Supongamos que no hay caché: cada acceso a un bloque es una E/S.
El kernel tiene un nombre y necesita un inodo. Empieza por la raíz, cuyo número
se conoce de antemano (2 en Unix y en VSFS; 1 en xv6):
- Leer el inodo de
/para saber dónde están sus datos. - Leer los datos de
/y buscarfoo: su inodo es el 3. - Leer el inodo 3: ¿es un directorio? ¿hay permiso?
- Leer los datos de
fooy buscarbar: su inodo es el 4. - Leer el inodo 4: tamaño, permisos y punteros.
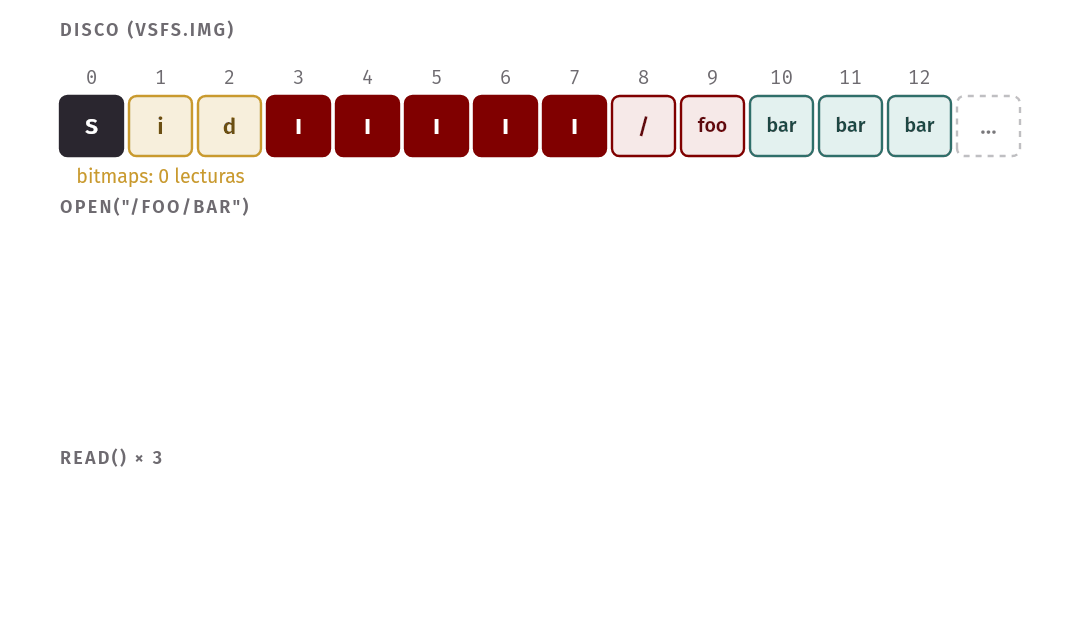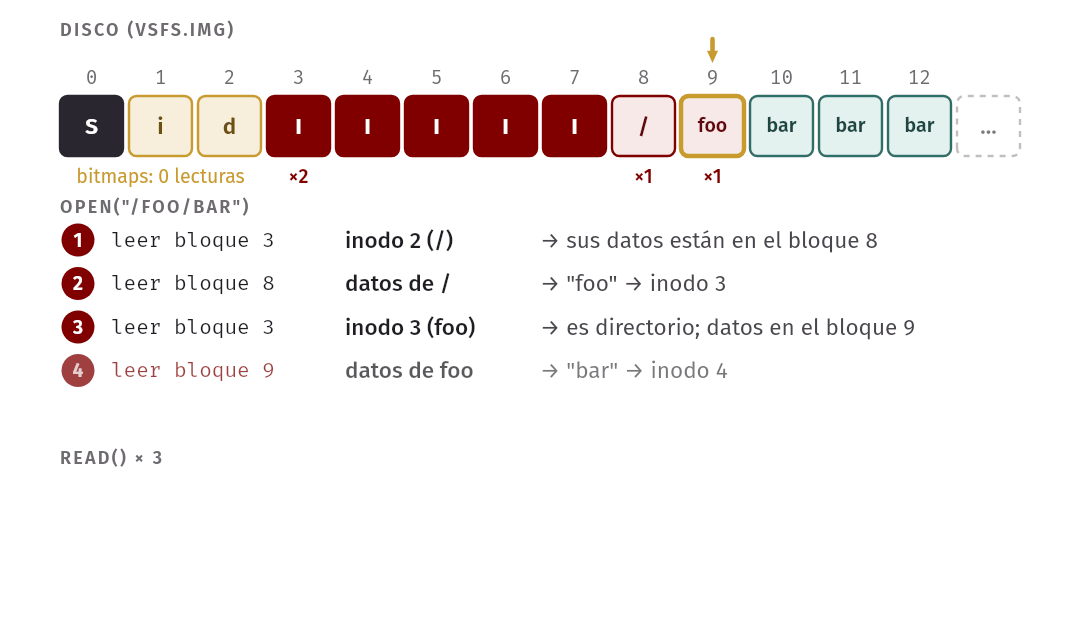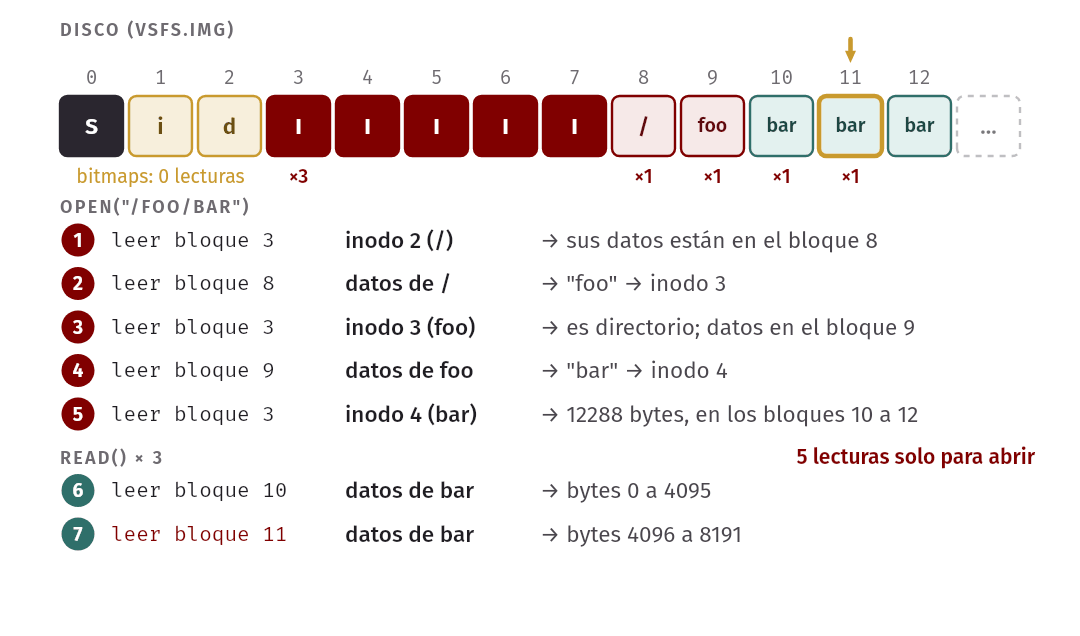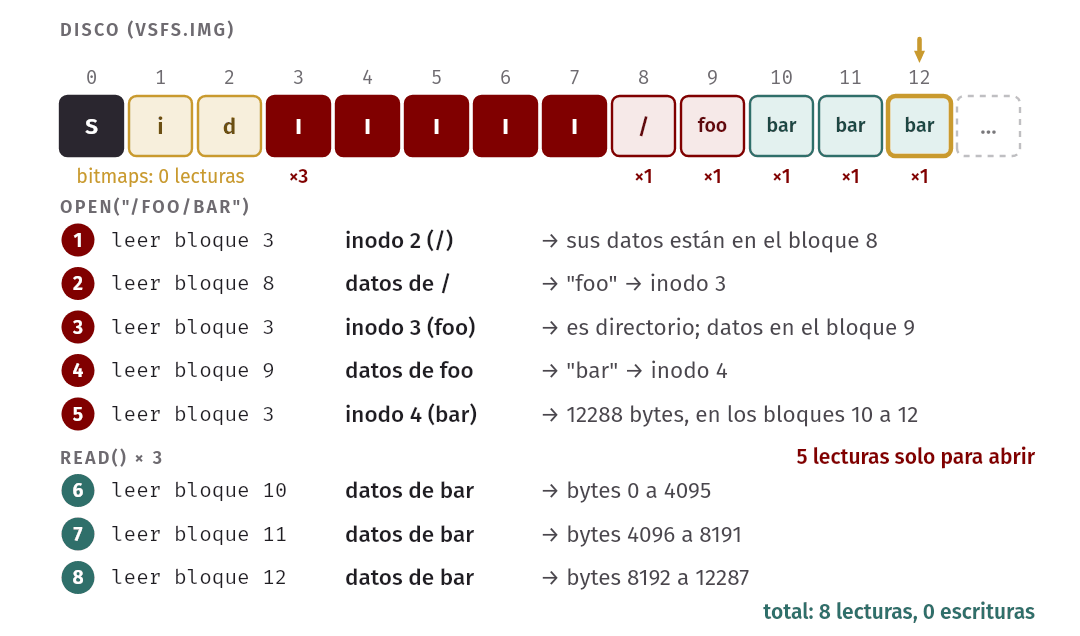
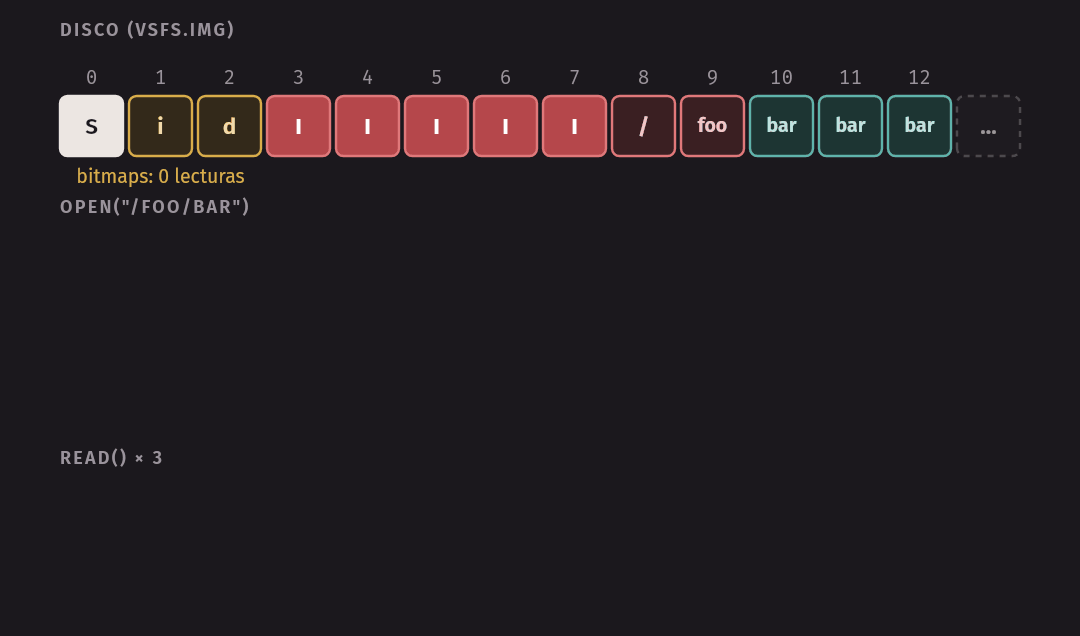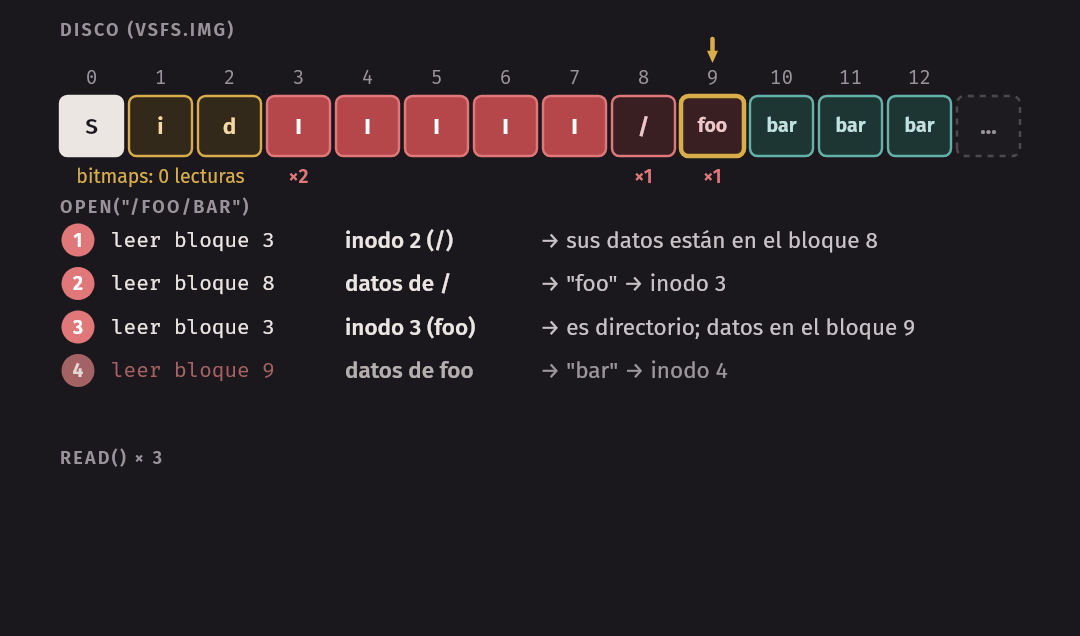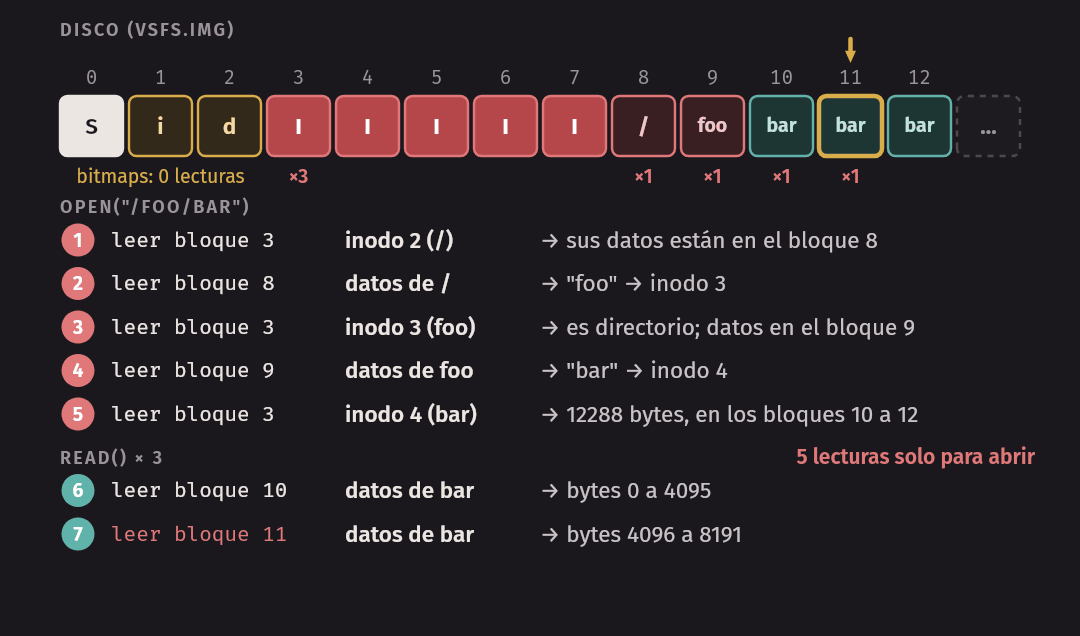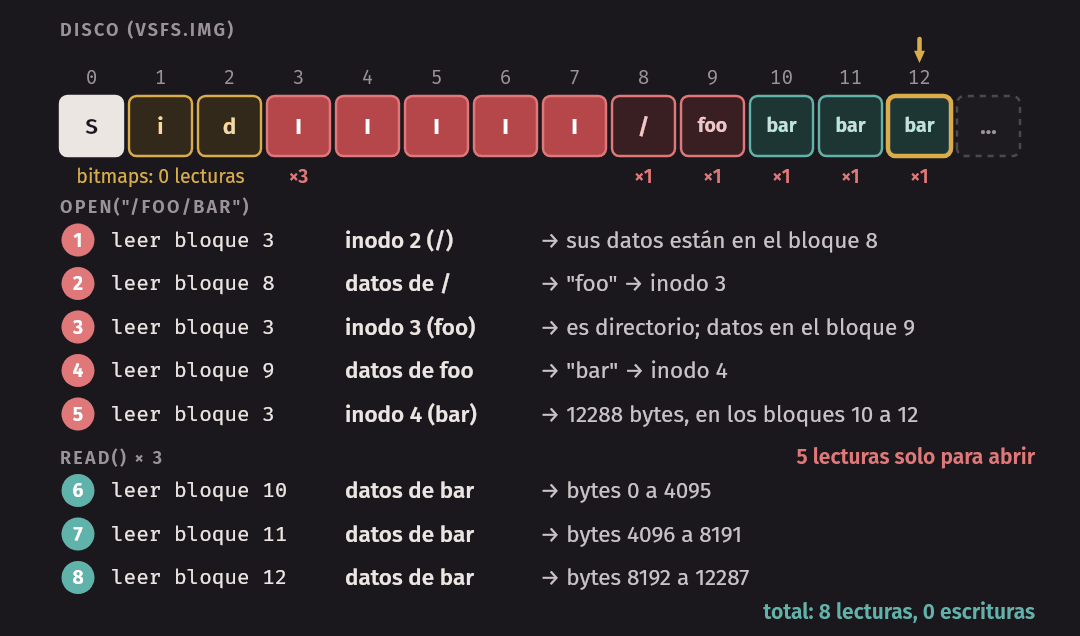
Cinco lecturas solo para abrir; ./vsfs -v img read /foo/bar imprime
cada una. El costo crece con la profundidad de la ruta (dos lecturas por
directorio) y con el tamaño de los directorios. Después, cada read lee un
bloque de datos (y escribe el inodo si se actualiza el tiempo de acceso).
Leer nunca toca los bitmaps: solo se consultan para reservar.
Crear y escribir
Escribir es más caro, porque puede hacer falta reservar. Medimos
./vsfs -v img create /foo/bar 12288, que crea el archivo y escribe tres
bloques:
| Llamada | bitmap de inodos | bitmap de datos | bloque de inodos | datos de / |
datos de foo |
datos de bar |
Total |
|---|---|---|---|---|---|---|---|
create |
L E | L L L E L E | L | L L E | 8 L + 4 E | ||
write 0 |
L E | L E | E | 2 L + 3 E | |||
write 1 |
L E | L E | E | 2 L + 3 E | |||
write 2 |
L E | L E | E | 2 L + 3 E |
Crear cuesta recorrer /foo (4 L), reservar un inodo en el bitmap, iniciar
el inodo nuevo (L+E, porque el bloque tiene otros 15 inodos), agregar la
entrada en foo y actualizar el inodo de foo. Cada write que reserva un
bloque cuesta 5 E/S: bitmap (L+E), dato (E), inodo (L+E). En total, 27 E/S
para 12 KB, y el bloque 3 se lee siete veces.
Caché y write buffering
Ningún sistema real funciona así: todos guardan en memoria los bloques usados. Antes se reservaba una caché fija (cerca del 10 % de la RAM); hoy se usa una caché de páginas unificada (page cache) que comparte la memoria con la memoria virtual. Con la caché caliente, los directorios de una ruta frecuente casi nunca se leen del disco.
Las escrituras también se retrasan: los bloques modificados (dirty) esperan en
memoria entre 5 y 30 segundos. Este write buffering permite agrupar
cambios, ordenar las escrituras y a veces evitarlas (un archivo
temporal borrado antes de llegar al disco). El precio es la durabilidad: si se
va la luz, se pierde lo que estaba en la caché; por eso existen fsync y el
patrón temporal + rename de la semana 13.
fsyncbench.c mide la diferencia: en el
contenedor, un write de 512 B toma menos de un microsegundo y un write
seguido de fsync, cerca de medio milisegundo. Los números dependen del disco
y de la virtualización; la proporción es lo que importa.
El sistema de archivos de xv6
xv6-riscv tiene la misma estructura que VSFS, con algunas diferencias.
mkfs/mkfs.c arma la imagen del disco al compilar xv6:
$ ./mkfs/mkfs fs.img README user/_cat ...
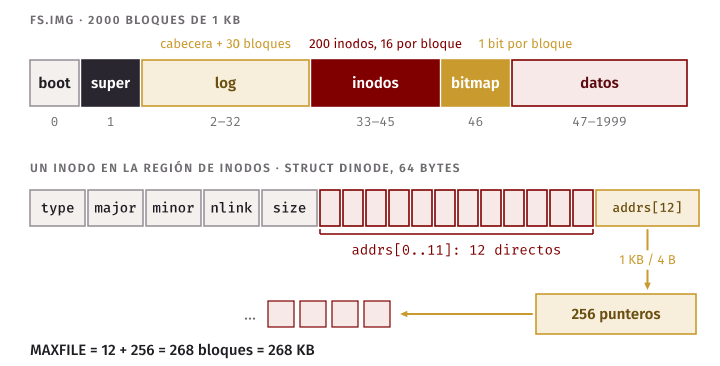
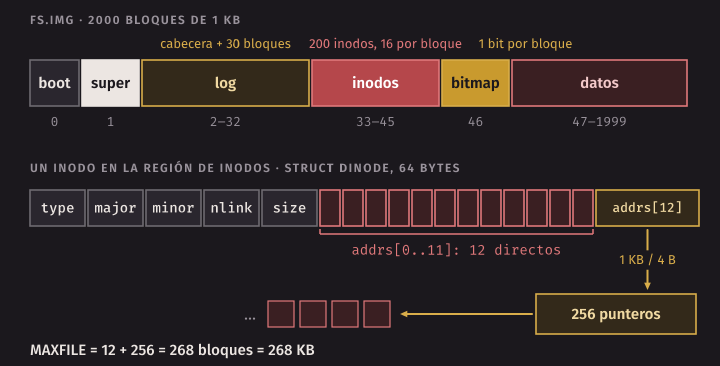
nmeta 47 (boot, super, log blocks 31, inode blocks 13, bitmap blocks 1) blocks 1953 total 2000| Bloques | Contenido |
|---|---|
| 0 | arranque (no se usa) |
| 1 | superbloque |
| 2–32 | log: una cabecera y 30 bloques |
| 33–45 | 200 inodos, 16 por bloque |
| 46 | bitmap de bloques |
| 47–1999 | datos |
Los bloques son de 1 KB (BSIZE); el log está entre el superbloque y los
inodos, y el bitmap va después de los inodos.
En xv6.
kernel/fs.hdefine el formato.struct superblockdice dónde empieza cada región (logstart,inodestart,bmapstart).struct dinodetienetype,major,minor,nlink,sizeyaddrs[NDIRECT + 1]: 12 punteros directos y uno indirecto, en 64 bytes, así queIPBes 16. La macroIBLOCK(i, sb)es la cuenta del inodo 37:i / IPB + sb.inodestart.
xv6 no tiene bitmap de inodos: ialloc() busca en la tabla un inodo con
type == 0. Con NINDIRECT = 1024 / 4 = 256, el máximo es MAXFILE =
12 + 256 = 268 bloques: 268 KB.
bmap(): del bloque lógico al bloque del disco
readi() y writei() calculan el bloque lógico bn = off / BSIZE y
llaman a bmap(ip, bn), que devuelve el bloque del disco y lo reserva si
no existe:
if (bn < NDIRECT) {
  if ((addr = ip->addrs[bn]) == 0) {
    addr = balloc(ip->dev);
    if (addr == 0)
      return 0;
    ip->addrs[bn] = addr;
  }
  return addr;
}
bn -= NDIRECT;
Si bn no es directo, se le restan 12 y se usa como índice en el bloque
indirecto, que también se reserva si hace falta. Al modificarlo se llama a
log_write, no a bwrite.
Ejemplo: el byte 70 000. Bloque lógico ⌊70 000 / 1024⌋ = 68, byte 70 000 − 68 · 1024 = 368. Como 68 ≥ 12, está en el bloque indirecto, entrada 68 − 12 = 56, que ocupa los bytes 224–227 de ese bloque. Sin caché hacen falta tres lecturas: el bloque con el inodo, el bloque indirecto y el bloque de datos.
$ ./bmapcalc 70000 300000
offset 70000: bloque lógico 68, byte 368 dentro del bloque
  indirecto: addrs[12] -> entrada 56 (bytes 224-227 del bloque)
  lecturas = inodo + indirecto + datos = 3
offset 300000: bloque lógico 292, byte 992 dentro del bloque
  fuera de rango: MAXFILE = 268 bloques (esto es P5)
En xv6.
balloc()enkernel/fs.crecorre el bitmap desde el bloque 0 y toma el primer bit libre (first fit), sin idea de localidad. Marca el bit conlog_write()y llena de ceros el bloque nuevo conbzero(), también a través del log.
Hacia P5
El proyecto P5 pide archivos más grandes: reemplazar un puntero directo por un
doble indirecto, sin cambiar el tamaño de struct dinode, para llegar a
11 + 256 + 256 · 256 = 65 803 bloques. El trabajo está en bmap() e
itrunc(), que debe liberar también los bloques nuevos. Antes de escribir
código, dibujen el dinode con sus 13 punteros y piensen qué cuentas tiene que
hacer bmap() cuando bn ya no cabe en el indirecto simple.
FFS: la localidad importa
El primer sistema de archivos de Unix tenía la estructura de VSFS y era lento: cerca del 2 % del ancho de banda del disco. Trataba al disco como memoria de acceso aleatorio: inodos lejos de sus datos, bloques de 512 bytes, y un espacio libre que se fragmentaba. Si se crean A B C D de dos bloques y se borran B y D, un archivo nuevo de cuatro bloques queda partido en dos.
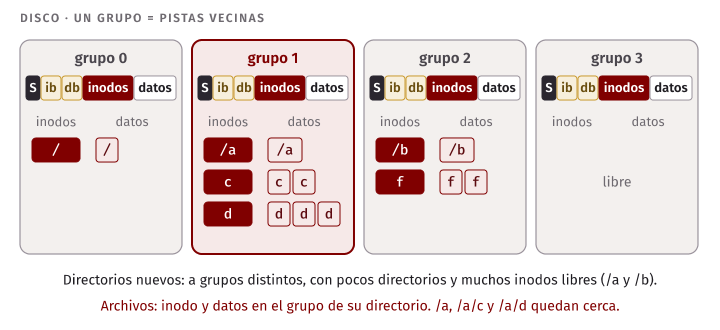
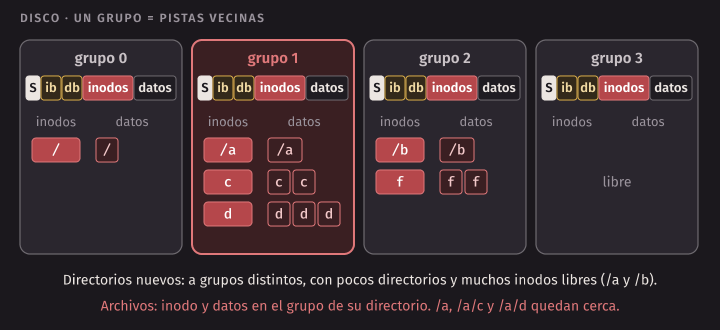
FFS (Fast File System, Berkeley, 1984) parte de que el sistema de archivos debe conocer el disco. Divide el disco en grupos de cilindros (cylinder groups), pistas vecinas entre las que moverse cuesta poco. Cada grupo es un VSFS en miniatura: copia del superbloque, bitmaps, inodos y datos. ext2/3/4 usan grupos de bloques (block groups), rangos consecutivos de bloques, porque los discos modernos no revelan su geometría.
La política de ubicación se resume en “lo relacionado, junto”:
- Un directorio nuevo va a un grupo con pocos directorios y muchos inodos libres, para repartir los directorios por el disco.
- Los bloques de un archivo van al mismo grupo que su inodo, y el inodo va al mismo grupo que su directorio.
La apuesta es que los archivos de un mismo directorio se usan juntos (compilar
un proyecto, ls -l), y las mediciones lo confirman.
La excepción de los archivos grandes
Un archivo enorme llenaría su grupo y alejaría a sus vecinos. Por eso los 12 bloques directos van al grupo del inodo, y cada bloque indirecto, con todo lo que apunta, va a otro grupo: trozos de 4 MB con bloques de 4 KB. Cada salto entre trozos paga un posicionamiento, pero si los trozos son grandes ese costo se amortiza. Supongamos un disco con 8 ms de posicionamiento y 100 MB/s de transferencia. Para usar el 50 % del ancho de banda hay que transferir 8 ms por cada 8 ms de salto: 100 MB/s · 8 ms = 800 KB por trozo. Para el 90 %, hay que transferir 9 · 8 = 72 ms por salto: 7,2 MB. Como la transferencia de los discos mejora más rápido que su mecánica, los trozos necesarios crecen con el tiempo.
FFS introdujo además sub-bloques para archivos pequeños, nombres largos,
enlaces simbólicos y rename atómico.
Consistencia ante fallos
Agregar un bloque a un archivo modifica tres bloques del disco: el bitmap de datos (B), el inodo (I, con el tamaño y el puntero nuevos) y el bloque de datos (Db). El disco escribe un bloque a la vez, y con write buffering los tres esperan juntos en la caché. Si se va la luz o el kernel entra en pánico a mitad de camino, solo algunos llegan. Hay seis casos:
| Llegó al disco | Qué queda | ¿Problema? |
|---|---|---|
| solo Db | nadie apunta al bloque; el bitmap dice libre | no: se perdió la escritura |
| solo I | I apunta a basura y el bitmap dice libre | sí: basura e inconsistencia |
| solo B | bloque marcado usado, sin owner | sí: fuga de espacio |
| I y B | metadatos de acuerdo, el dato es basura | sí, y nadie lo nota |
| I y Db | dato correcto, el bitmap dice libre | sí: se reasignará |
| B y Db | bloque usado sin inodo que lo apunte | sí: fuga de espacio |
Queremos que la actualización sea atómica: o llegan los tres bloques, o ninguno. El hardware solo garantiza que una escritura de un sector (512 B) es atómica.
fsck
La primera respuesta fue arreglar después. fsck recorre todo al arrancar:
verifica el superbloque, reconstruye los bitmaps a partir de los inodos,
descarta inodos inválidos, recalcula nlink recorriendo el árbol (los inodos
sin nombre van a lost+found), busca bloques duplicados y revisa . y ...
Es lento (lee todo el disco aunque el fallo tocó tres bloques: horas en
discos de varios TB) y no ve todo: si llegaron I y B pero no Db, todo
cuadra y el archivo tiene basura.
Journaling
La idea viene de las bases de datos (write-ahead logging): antes de modificar las estructuras en su lugar, escribir en un área aparte una nota con lo que se va a hacer. Esa área es el journal (o log). Si el sistema se cae a mitad de la actualización, al arrancar lee la nota y termina el trabajo. ext3 es ext2 con un journal; ext4, XFS, JFS y NTFS también lo usan, y xv6 también.
Journaling de datos
El protocolo para nuestra actualización (I, B y Db) tiene cuatro pasos:
- Escribir en el journal un bloque de comienzo TxB (con un identificador de transacción y los destinos) y una copia de cada bloque nuevo: I’, B’, Db’. Esperar a que lleguen.
- Confirmar (commit): escribir el bloque de fin TxE. Desde ese momento la transacción es durable.
- Checkpoint: escribir I, B y Db en su lugar definitivo.
- Liberar: marcar la transacción como libre en el superbloque del journal, para reutilizar el espacio. El journal es un buffer circular.
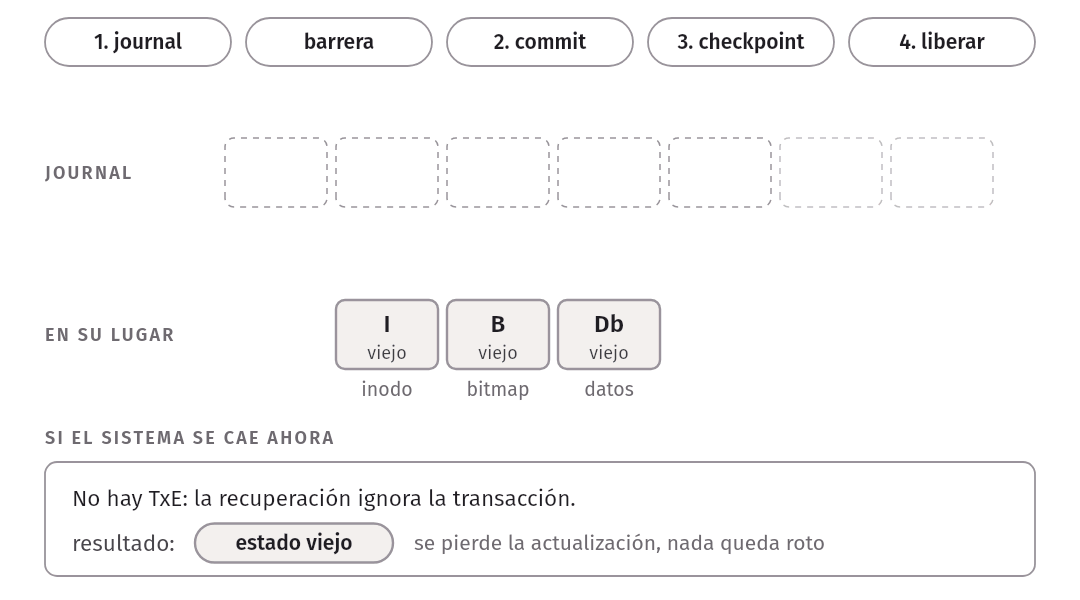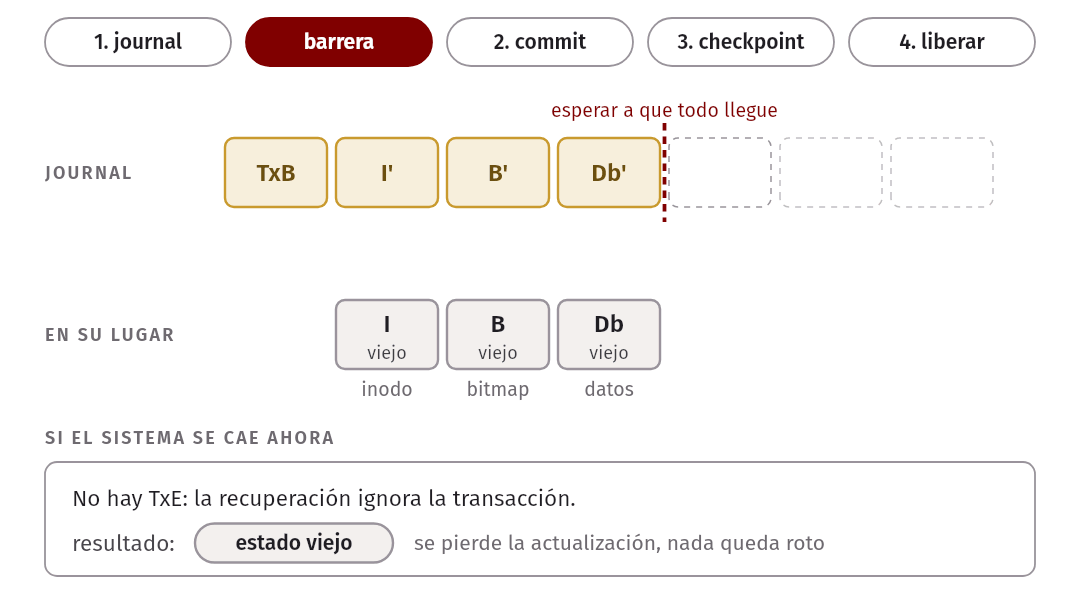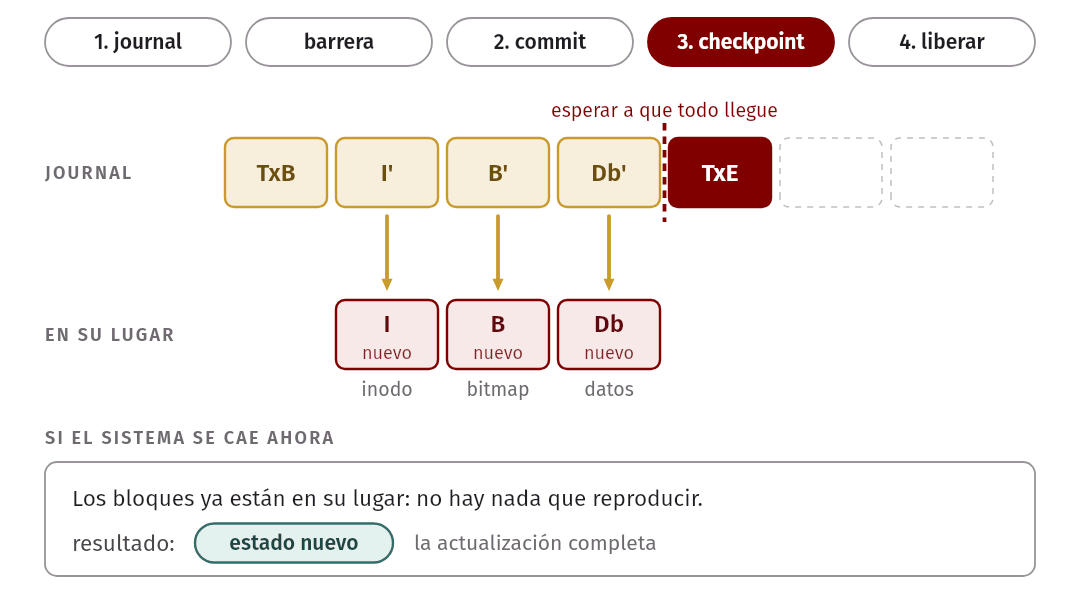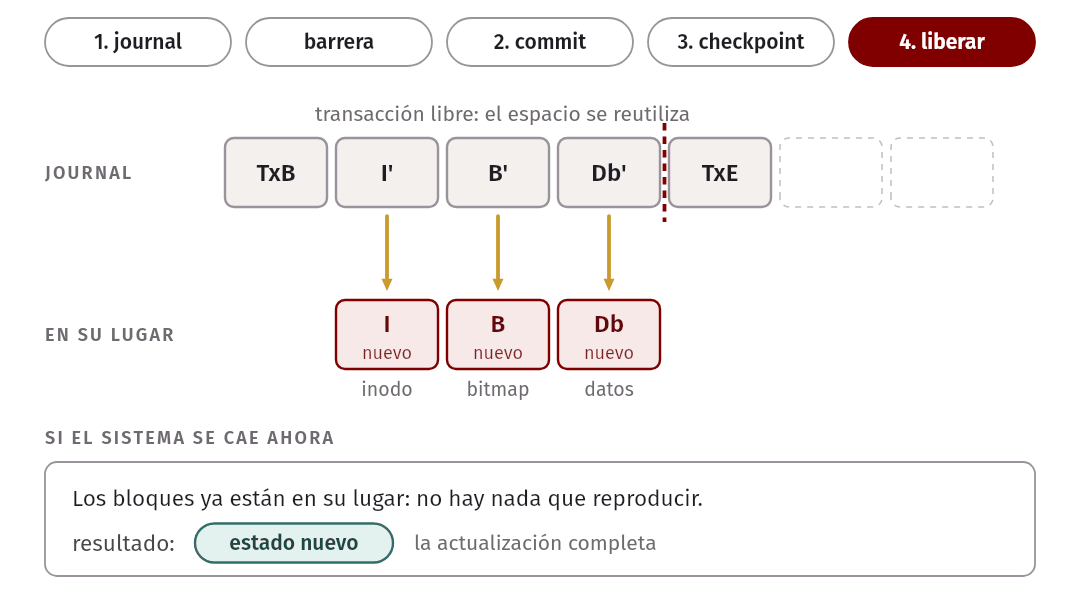
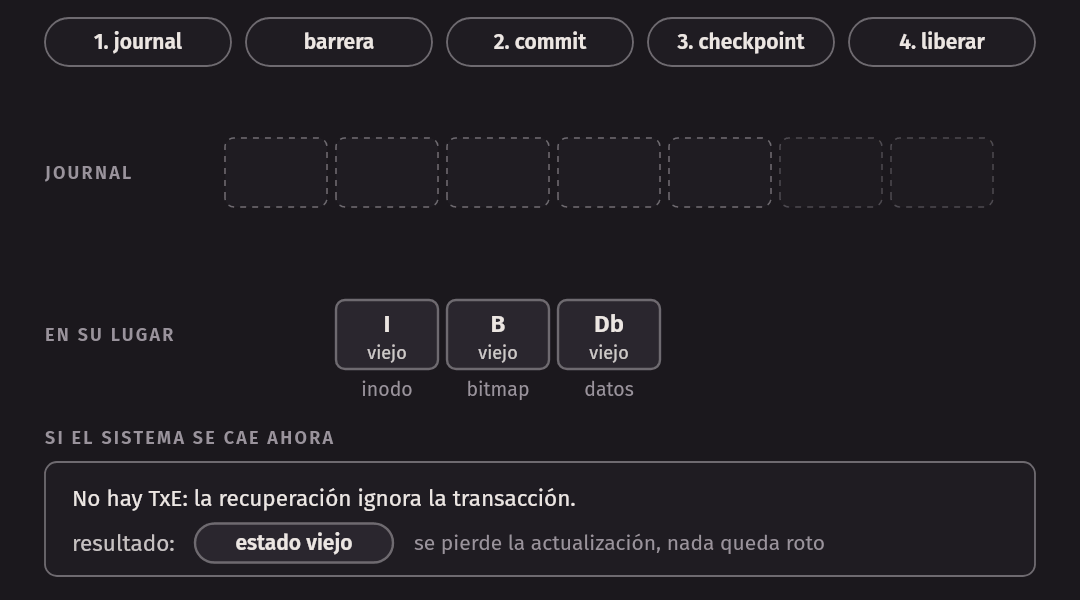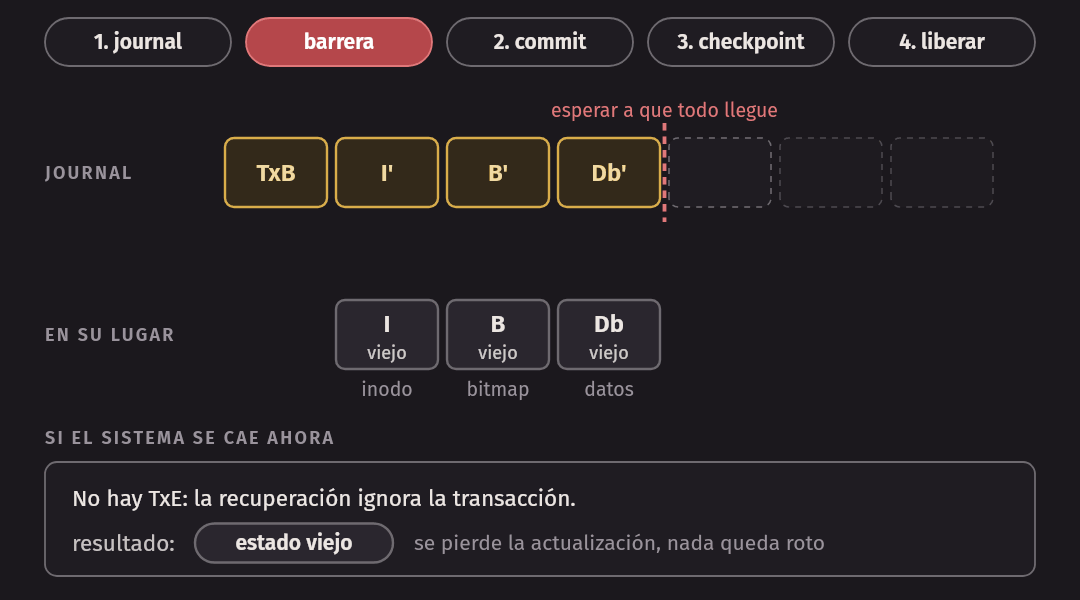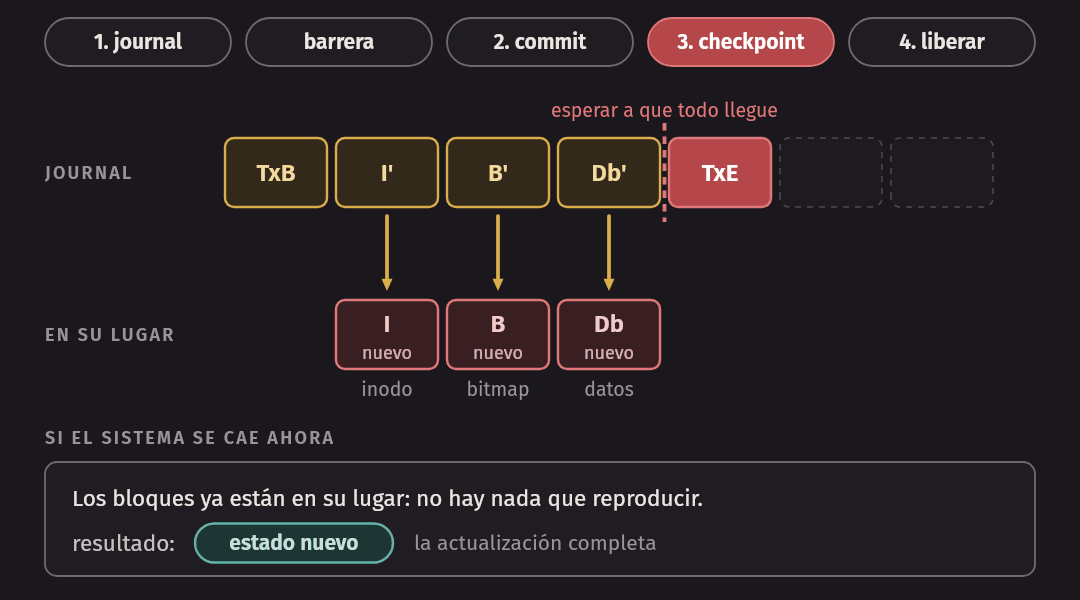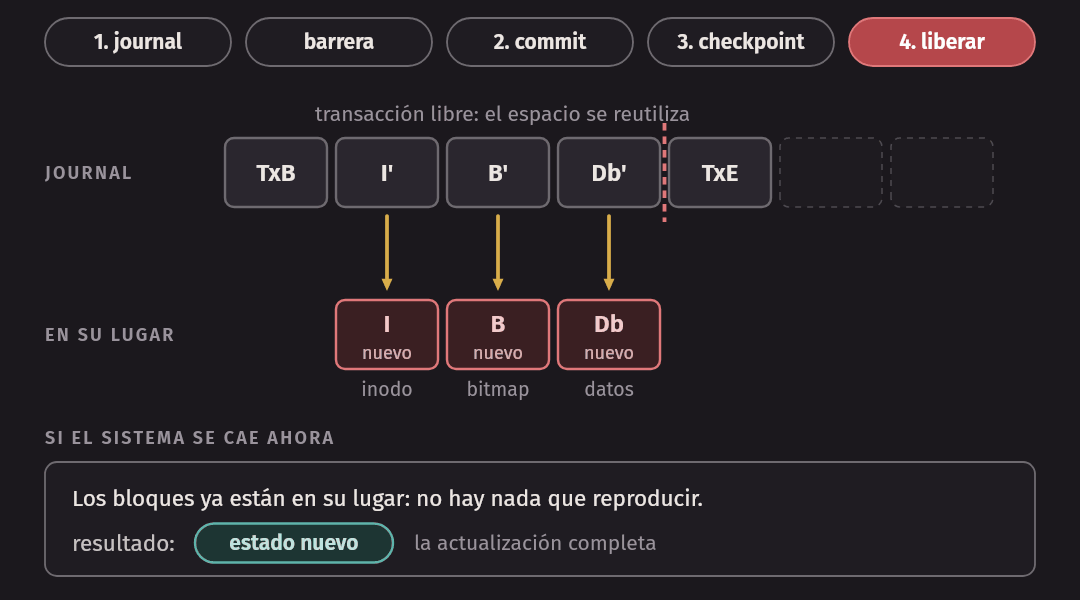
¿Por qué TxE va aparte? Sería más rápido mandar los cinco bloques juntos, pero el disco puede reordenar escrituras. Si TxE llega antes que Db’ y el sistema se cae, la recuperación ve una transacción aparentemente completa y copia basura a su lugar. Por eso se escribe todo menos TxE, se espera (una barrera) y recién después se escribe TxE, que cabe en un sector y es atómico. ext4 evita esa espera con un checksum del contenido de la transacción: si al recuperar el checksum no coincide, la transacción se descarta.
journal.c simula un fallo después de cada
escritura y luego la recuperación. ./journal data muestra que todo fallo
antes de TxE deja el estado viejo y todo fallo después, el nuevo;
./journal reorder muestra lo que pasa sin barrera:
$ ./journal reorder
== sin barrera: TxE llega antes ==
en disco al fallar    tras recuperar
(nada)                ok: estado viejo
TxB                   ok: estado viejo
TxB TxE               CORRUPTO: replay de basura
TxB TxE j:I           CORRUPTO: replay de basura
TxB TxE j:I j:B       CORRUPTO: replay de basura
TxB TxE j:I j:B j:Db  ok: estado nuevo
La recuperación
Al arrancar, las transacciones sin TxE (o con checksum incorrecto) se ignoran: estado viejo, nada roto. Las confirmadas se reproducen (replay) en orden: es un log de rehacer (redo logging). Si el fallo ocurrió durante el checkpoint, se copian todos los bloques otra vez; escribir dos veces lo mismo da el mismo resultado, así que el replay es idempotente. Recuperar cuesta segundos. Además, ext3 agrupa varios segundos de actualizaciones en una transacción: si se crean diez archivos en un directorio, su bloque se escribe una vez.
Idea clave. El journaling transforma una actualización de muchos bloques en una sola escritura atómica: la del bloque de commit. Antes de ella, la transacción no existe; después, existe completa.
Journaling de metadatos (modo ordered)
El journaling de datos escribe cada dato dos veces, y con escrituras grandes pierde la mitad del ancho de banda. El modo ordered (el de ext3 y ext4 por defecto) solo pasa los metadatos por el journal:
- Escribir Db en su lugar, y en paralelo TxB, I’ y B’ en el journal. Esperar.
- Escribir TxE.
- Checkpoint de I y B.
- Liberar.
¿Por qué los datos van antes del commit? Si TxE llegara antes que Db y el sistema se cayera, el replay dejaría un inodo válido que apunta a basura: el caso “I y B” de la tabla. Regla: primero lo apuntado, después lo que apunta. El modo writeback ignora ese orden: más rápido, con riesgo de basura.
Revocación
Un directorio es metadato, así que sus bloques pasan por el journal. Se crea
el directorio foo y su bloque 1000 queda en el journal (Tx1); se borra foo
(Tx2); se crea bar y el bloque 1000 se reutiliza para sus datos, que en
modo ordered no van al journal. Si el sistema se cae antes de liberar Tx1, el
replay copia las entradas viejas de foo sobre los datos de bar. ext3 y ext4
lo evitan con un registro de revocación (revoke record) escrito al borrar:
la recuperación no reproduce los bloques revocados.
Otras soluciones
- Soft updates (FFS de FreeBSD): ordenar con cuidado todas las escrituras para que el disco nunca apunte a basura, por ejemplo escribir el dato antes que el inodo. Funciona, pero requiere conocer en detalle cada estructura.
- Copy-on-write (ZFS, btrfs, APFS): nunca sobrescribir; escribir las versiones nuevas en lugares libres y, al final, cambiar un único puntero raíz. LFS, que veremos la semana 15, lleva esta idea al extremo.
- Backpointers: cada bloque guarda quién lo apunta, y la consistencia se verifica al leer, sin ordenar escrituras.
El log de xv6
El log de xv6 ocupa los bloques 2 a 32: una cabecera (struct logheader,
con un contador n y los números de bloque destino) y 30 bloques de copias.
Cada llamada que modifica el disco es una transacción:
begin_op();
bp = bread(...);
// modificar bp->data[]
log_write(bp);
brelse(bp);
end_op();
log_write() reemplaza a bwrite() pero no escribe: anota el bloque en la
cabecera en memoria y lo fija (pin) en la caché, para que no sea desalojado:
hasta el commit, esa copia en memoria es el único registro del cambio. Un bloque modificado dos veces se anota una sola vez
(absorción).
En xv6.
begin_op()enkernel/log.creserva espacio en el log con una cuenta conservadora: cada llamada puede escribir hastaMAXOPBLOCKS= 10 bloques y el log tieneLOGBLOCKS= 30. Silog.lh.n + (log.outstanding + 1) * MAXOPBLOCKS > LOGBLOCKS, o si hay un commit en curso, la llamada duerme. Por esofilewrite()enkernel/file.cparte unwritegrande en transacciones de((10 - 1 - 1 - 2) / 2) * 1024= 3072 bytes.
Group commit
Varias llamadas pueden estar en la misma transacción: log.outstanding las
cuenta, y solo la última en salir ejecuta commit() para todas. Es
group commit. Mientras dura el commit, los nuevos begin_op() esperan.
El commit
commit() tiene cuatro pasos:
write_log()copia cada bloque modificado de la caché a su lugar en el log.write_head()escribe la cabecera conn > 0y la lista de destinos.install_trans()copia los bloques del log a su lugar (el checkpoint).write_head()conn = 0vacía el log.
¿Por qué el commit es escribir la cabecera? Antes, la cabecera en disco
dice n = 0 y la recuperación (recover_from_log(), llamada desde fsinit()
al arrancar) ignora el log aunque esté completo: estado viejo, entero. Después,
dice n = 3 y la recuperación copia los tres bloques: estado nuevo, entero.
Una sola escritura separa “nada” de “todo”: la cabecera ocupa 4 + 30 · 4 = 124
bytes y cabe en un sector de 512 B, cuya escritura el disco hace de forma
atómica (el bloque de 1 KB son dos sectores). Un fallo durante install_trans() deja n = 3, y se copian los tres
otra vez: idempotente. El segundo write_head() es obligatorio: si no, una
cabecera vieja podría combinarse con los bloques de la transacción siguiente.
A diferencia de ext3 en modo ordered, xv6 registra datos y metadatos
(writei() pasa los datos por log_write()): es journaling de datos. Su log
no es circular, porque se vacía en cada commit, y por lo mismo no necesita
revocación.
Resumen
- Un sistema de archivos reparte el disco en superbloque, bitmaps, tabla de inodos y datos. La ubicación de un inodo se calcula con su número.
- El inodo apunta a sus datos con punteros directos, indirectos y multinivel, o con extents. Con bloques de 4 KB, punteros de 4 B, 12 directos y un indirecto, el máximo es 4144 KB; en xv6, 268 KB.
- Sin caché, abrir
/foo/barcuesta 5 lecturas y cada escritura que reserva un bloque cuesta 5 E/S. La caché de páginas y el write buffering hacen viable el sistema, a costa de la durabilidad. - FFS agrupa lo relacionado en grupos de cilindros y reparte los archivos grandes en trozos grandes para amortizar el posicionamiento.
- Un fallo a mitad de una actualización deja el disco inconsistente.
fsckrevisa todo; el journaling escribe en el journal, confirma con una escritura atómica, hace checkpoint y libera. En modo ordered, los datos van antes del commit y solo los metadatos pasan por el journal. - En xv6, cada llamada es una transacción entre
begin_op()yend_op(); el commit es escribir la cabecera del log, yend_op()confirma en grupo.
Ejercicios
- En VSFS sin caché, ¿cuántas lecturas cuesta
open("/a/b/c/d")si cada directorio ocupa un solo bloque? ¿Y sictiene tres bloques ydestá en el último? Verifiquen el primer caso convsfs -vcreando los directorios. - Con bloques de 1 KB, punteros de 4 B, 12 directos y un indirecto, ¿cuál es
el tamaño máximo de un archivo? Compárenlo con
MAXFILEde xv6. - En xv6, ¿en qué bloque del disco y en qué byte de ese bloque está el inodo
150? ¿Qué entrada del bloque indirecto contiene el byte 200 000 de un
archivo? Verifiquen con
bmapcalc. - Con un disco de 10 ms de posicionamiento y 200 MB/s de transferencia, ¿de qué tamaño deben ser los trozos de un archivo grande para aprovechar el 50 % del ancho de banda? ¿Y el 99 %?
- En el modo ordered, ¿qué pasa si el sistema se cae después de escribir Db y
TxB, pero antes de TxE? ¿Y si el orden fuera TxB, I’, B’, TxE y después Db?
Usen
journal.cpara comprobarlo (agreguen un modo nuevo). - En
kernel/log.c, ¿qué pasaría sicommit()no hiciera el segundowrite_head()? Describan una secuencia de dos transacciones y un fallo que deje el disco corrupto.