
Apuntes · Capítulo 15Distribuidos
LFS, SSDs, integridad y sistemas distribuidos
LFS, SSDs, integridad y sistemas distribuidos
En la semana 14 vimos cómo FFS ubica inodos y datos en lugares fijos y cómo el journaling lo protege de un apagón. Este capítulo cierra la parte de persistencia con tres preguntas. ¿Qué pasa si, en vez de escribir cada bloque en su lugar, escribimos todo al final de un log? ¿Cómo funciona una SSD, que no puede sobrescribir y por dentro hace justamente eso? ¿Y qué hacemos cuando el disco devuelve datos equivocados sin avisar?
La segunda mitad pasa a los sistemas distribuidos: comunicar máquinas por una red que pierde mensajes, y cómo NFS y AFS comparten archivos.
Ruta de lectura.
- Antes de clase (15–20 min): la primera parte de «LFS: un sistema de archivos que solo agrega» (hasta «¿Qué tan grande debe ser un segmento?»), «Bancos, bloques y páginas», de «SSDs: flash por dentro», y «Comunicación no confiable».
- En clase: sesión A, «LFS: un sistema de archivos que solo agrega», «SSDs: flash por dentro» e «Integridad de los datos»; sesión B, «RPC», «NFS: un servidor sin estado» y «AFS: archivos completos y callbacks».
- Después de clase: repasar el «Resumen» y resolver los «Ejercicios». Para ampliar: OSTEP cap. 43 a 45 y 48 a 50, «Escrituras mal dirigidas y escrituras perdidas» y «Scrubbing».
Lectura. OSTEP cap. 43–45 (LFS, SSDs, integridad) y cap. 48–50 (sistemas distribuidos, NFS y AFS). El código está en
code/week-15;make testcorre todos los ejemplos.
LFS: un sistema de archivos que solo agrega
A comienzos de los 90, Rosenblum y Ousterhout notaron que la caché absorbía casi todas las lecturas, así que al disco llegaban sobre todo escrituras; que el acceso secuencial era cada vez más rápido que el aleatorio (semana 12); y que crear un archivo pequeño en FFS escribe inodo, bitmap, directorio y datos, cada uno en su lugar fijo.
Su propuesta, el Log-structured File System (LFS), es nunca sobrescribir nada. Datos y metadatos se juntan en memoria en un segmento que, al llenarse, se escribe al final del log con una sola escritura grande y secuencial.
¿Qué tan grande debe ser un segmento?
Cada escritura paga un posicionamiento (búsqueda más rotación), T_pos, y
luego transfiere a la tasa pico R_pico. Escribir D MB toma
T = T_pos + D / R_pico, y la tasa efectiva es D / T. Si queremos que la tasa
efectiva sea una fracción F de la pico, despejando:
D = F / (1 - F) × R_pico × T_posCon T_pos = 10 ms, R_pico = 100 MB/s y F = 0,9: D = 9 × 100 MB/s × 0,01 s
= 9 MB. Para el 95 % hacen falta 19 MB, y para el 99 %, 99 MB: cada punto cerca
del máximo cuesta mucho más buffer.
El mapa de inodos
Si nada se sobrescribe, cada vez que un archivo cambia su inodo se escribe en una
dirección nueva. ¿Cómo encontramos el inodo número k? LFS agrega una
indirección: el mapa de inodos (inode map, imap), que traduce número de
inodo a la dirección de su versión más reciente. El imap también se escribe en el
log, en pedazos, junto a los inodos que cambiaron.
El punto de partida fijo es la región de checkpoint (checkpoint region, CR): un bloque en una dirección conocida que apunta a los pedazos más recientes del imap. Se actualiza cada tanto (unos 30 segundos), no en cada escritura.
Un ejemplo: el archivo k tiene un bloque D en la dirección A0, su inodo en A1
y el pedazo del imap que lo contiene en A2. El programa sobrescribe ese bloque.
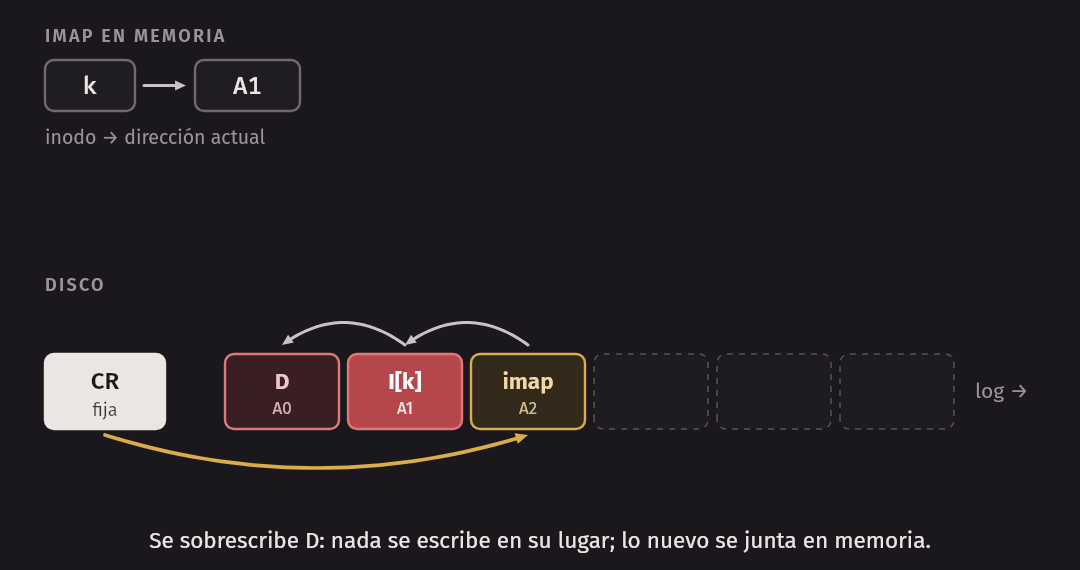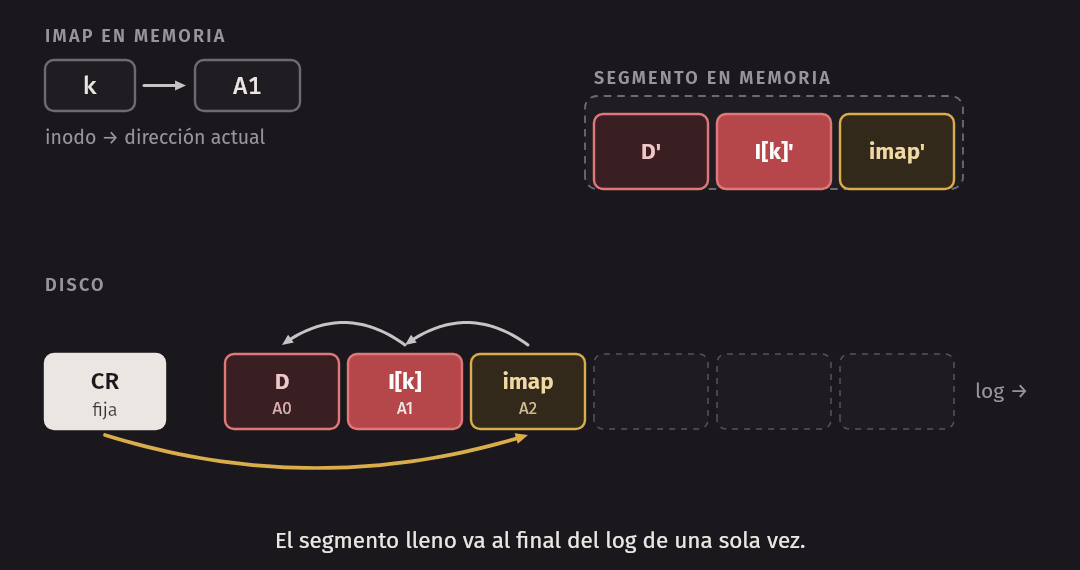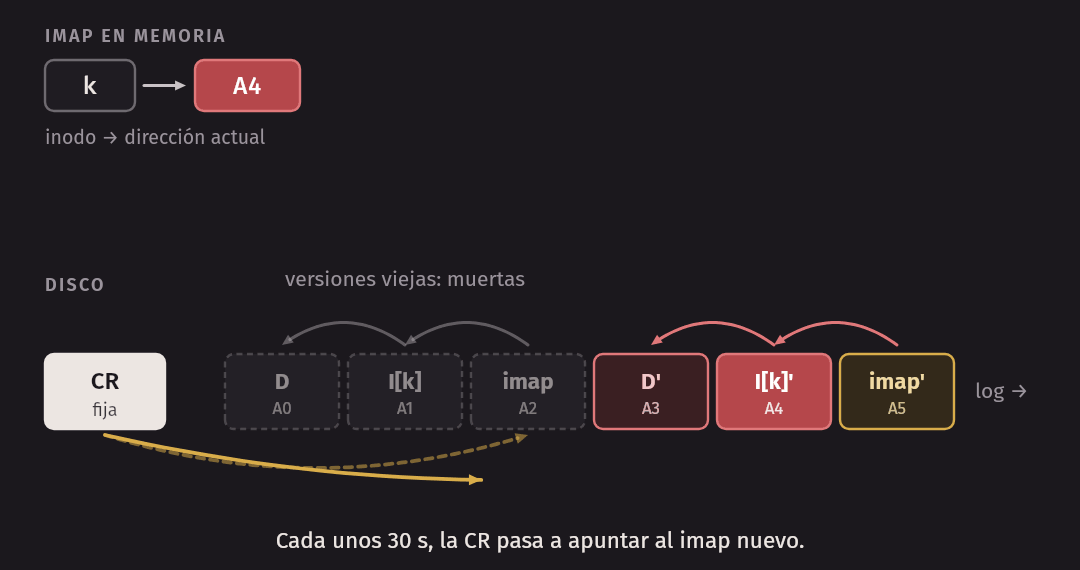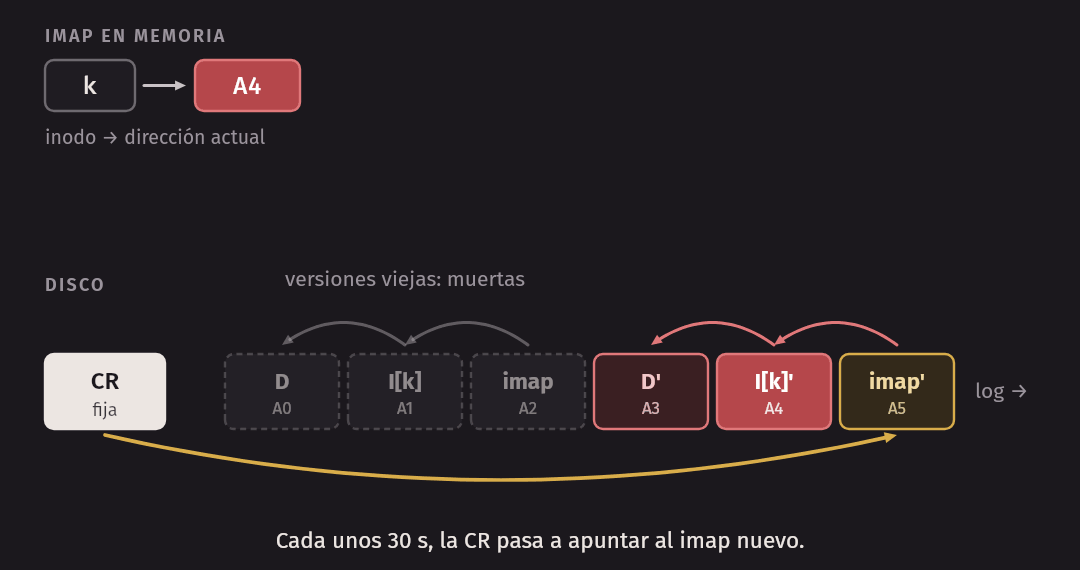
LFS agrega al log D' (A3), un inodo nuevo que apunta a A3 (A4) y un pedazo de
imap nuevo con k → A4 (A5). Lo que está en A0, A1 y A2 queda muerto. Cuando
toca actualizar la CR, esta pasa a apuntar a A5.
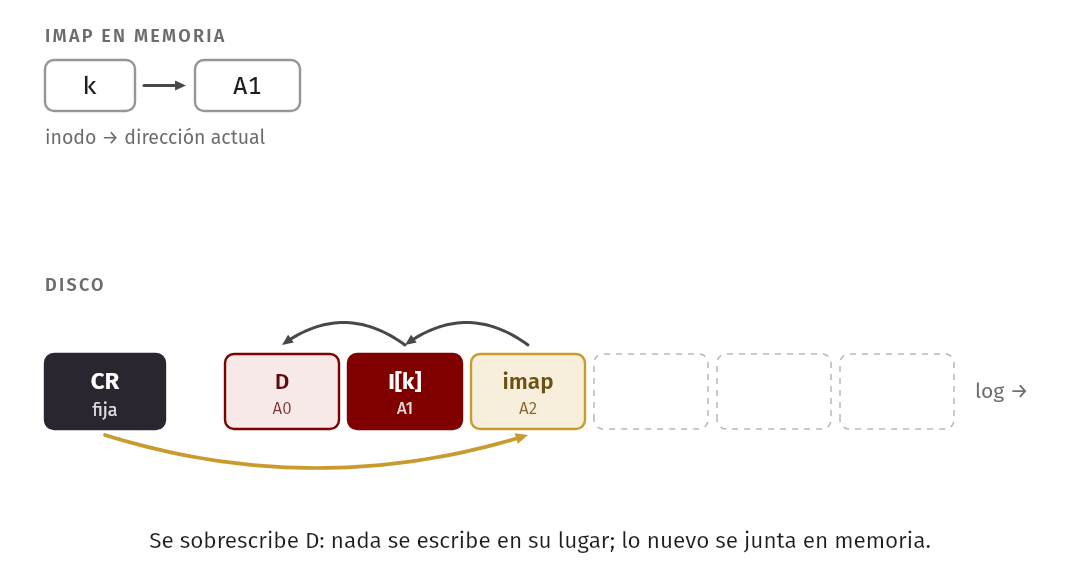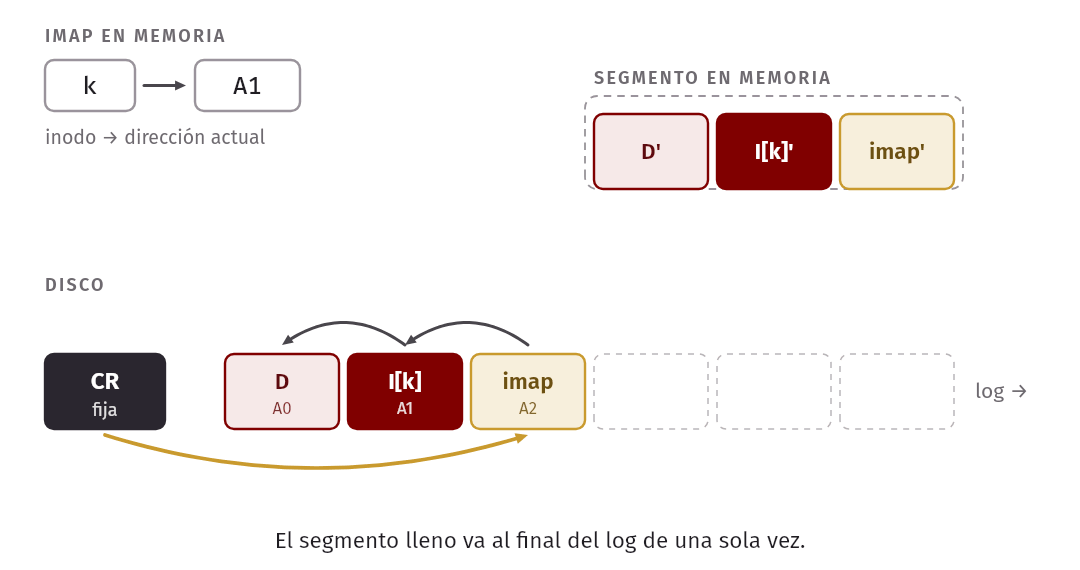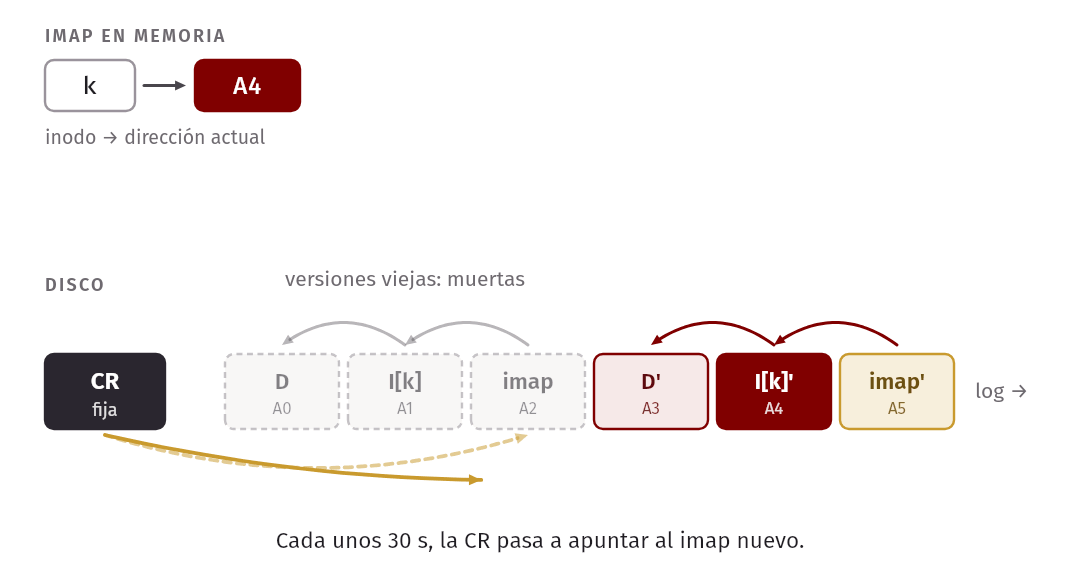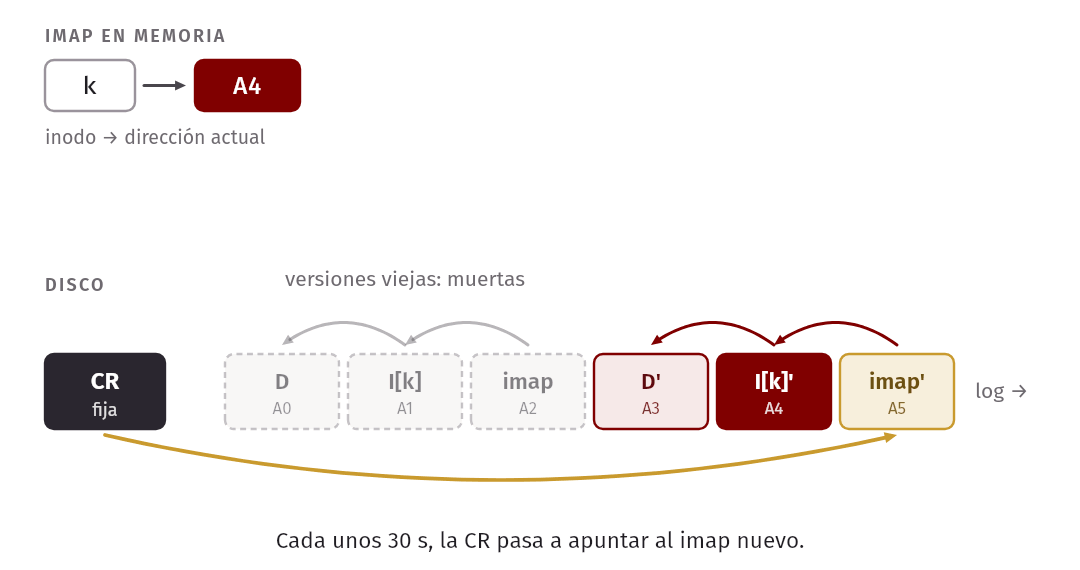
Para leer, LFS carga todo el imap en memoria al montar; luego busca el inodo en el imap, lo lee y sigue sus punteros como FFS.
En xv6. xv6, como FFS, guarda los inodos en un arreglo en posiciones fijas. En
kernel/fs.h,#define IBLOCK(i, sb) ((i) / IPB + sb.inodestart)calcula el bloque de un inodo con una división. Por eso no necesita imap: un inodo nunca se mueve. LFS necesita el imap justamente porque sus inodos cambian de lugar en cada escritura.
Esto responde la primera pregunta de repaso: FFS no necesita imap porque la ubicación de cada inodo es una función fija de su número; en LFS esa ubicación cambia cada vez que el inodo se reescribe, y el imap es la tabla que la registra.
El imap tiene otro efecto: como un directorio guarda (nombre, número de inodo) y no direcciones, mover un inodo no obliga a reescribir el directorio. Sin esa indirección, cada cambio se propagaría por los directorios hasta la raíz.
Limpieza
Como LFS nunca sobrescribe, el disco se llena de versiones viejas. El limpiador (cleaner) trabaja por segmentos: lee M segmentos, se queda con los bloques vivos, los escribe compactados en N < M segmentos nuevos y deja libres los M viejos. Así siempre hay espacio contiguo para escribir rápido.
Para saber si un bloque está vivo, cada segmento empieza con un resumen del
segmento (segment summary) que dice, para cada bloque, de qué inodo es y en
qué posición del archivo. Para el bloque en la dirección A, el limpiador lee del
resumen “inodo k, bloque 2”, busca k en el imap, lee el inodo y mira su
puntero 2. Si apunta a A, el bloque está vivo; si apunta a otro lado, es basura.
Un atajo: guardar un número de versión del archivo en el imap y en el resumen; si
no coinciden (el archivo se borró o se truncó), el bloque es basura sin leer el
inodo.
¿Qué segmentos limpiar? La propuesta original separa segmentos calientes (se sobrescriben seguido) de fríos, y limpia antes los fríos: a los calientes conviene darles tiempo para que acumulen más basura.
Recuperación ante fallos
LFS guarda dos CR, una en cada extremo del disco, y las alterna. Cada una lleva una marca de tiempo al inicio y otra al final; si no coinciden, quedó a medias y se usa la otra. Después de un reinicio, LFS hace roll forward: desde la última CR válida, recorre el log y recupera los segmentos escritos después.
En xv6. El log de xv6 (
kernel/log.c) no es LFS: es un journal de redo. Los bloques de una transacción se escriben primero en el log y, después del commit,install_translos copia a su lugar fijo:bread(log.dev, log.lh.block[tail]),memmoveybwrite(dbuf). El log es temporal y los datos terminan escritos dos veces. En LFS el log es el sistema de archivos y cada dato se escribe una sola vez.
La idea de escribir en un lugar nuevo (copy-on-write) sobrevivió en WAFL, ZFS, btrfs y, como veremos, dentro de cada SSD.
SSDs: flash por dentro
Bancos, bloques y páginas
La memoria flash NAND guarda bits como carga eléctrica en celdas: 1 bit por celda (SLC), 2 (MLC) o 3 (TLC). Más bits por celda dan más capacidad, pero menos velocidad y menos duración. Un chip se organiza en bancos que trabajan en paralelo; cada banco tiene bloques grandes (típicamente 128–256 KB), y cada bloque tiene páginas de unos 4 KB. Ojo con el nombre: un bloque flash no es un bloque del sistema de archivos, es la unidad de borrado.
La flash tiene tres operaciones:
| Leer página | Programar página | Borrar bloque | |
|---|---|---|---|
| SLC | 25 µs | 200–300 µs | 1,5–2 ms |
| MLC | 50 µs | 600–900 µs | ~3 ms |
| TLC | ~75 µs | ~900–1350 µs | ~4,5 ms |
Leer es rápido y no depende de la posición. Programar solo cambia 1s por 0s, así que la página tiene que estar borrada. Borrar pone todo el bloque en 1s: es lento y desgasta (un bloque MLC aguanta unos 10 000 ciclos; uno SLC, unos 100 000). Por eso no se puede sobrescribir en el lugar: cambiar una página obligaría a copiar las demás del bloque, borrarlo y reprogramarlo.
El FTL
Hacia afuera, la SSD es un disco común que lee y escribe bloques de 4 KB. La traducción la hace el FTL (flash translation layer), que corre en el procesador de la SSD. Un FTL de mapeo directo (página lógica N = física N) tendría que borrar y reprogramar un bloque entero en cada sobrescritura.
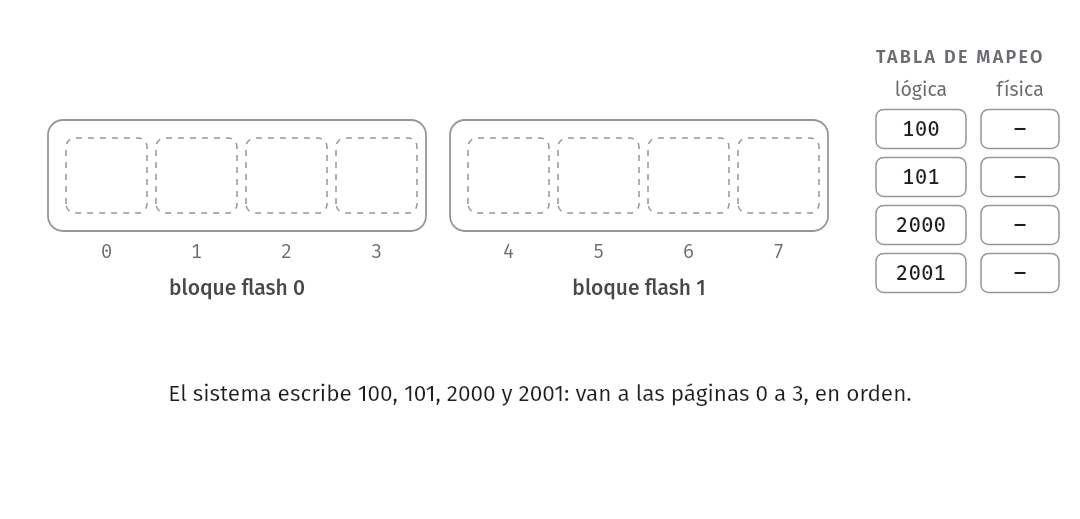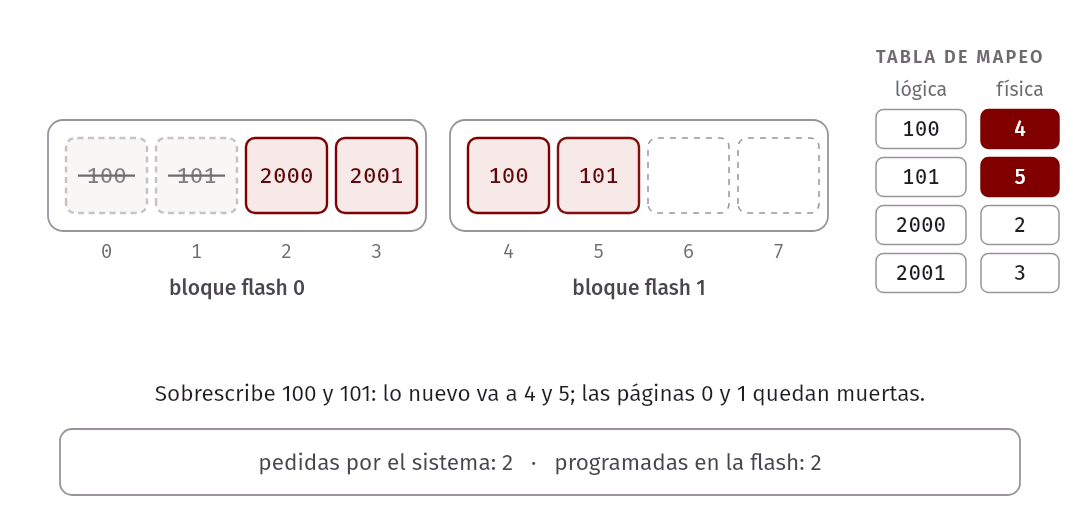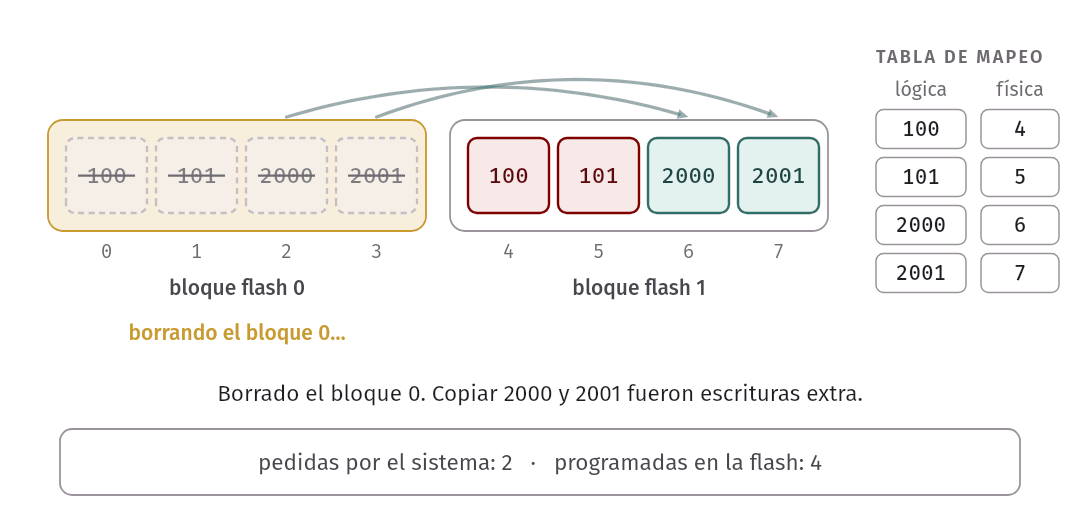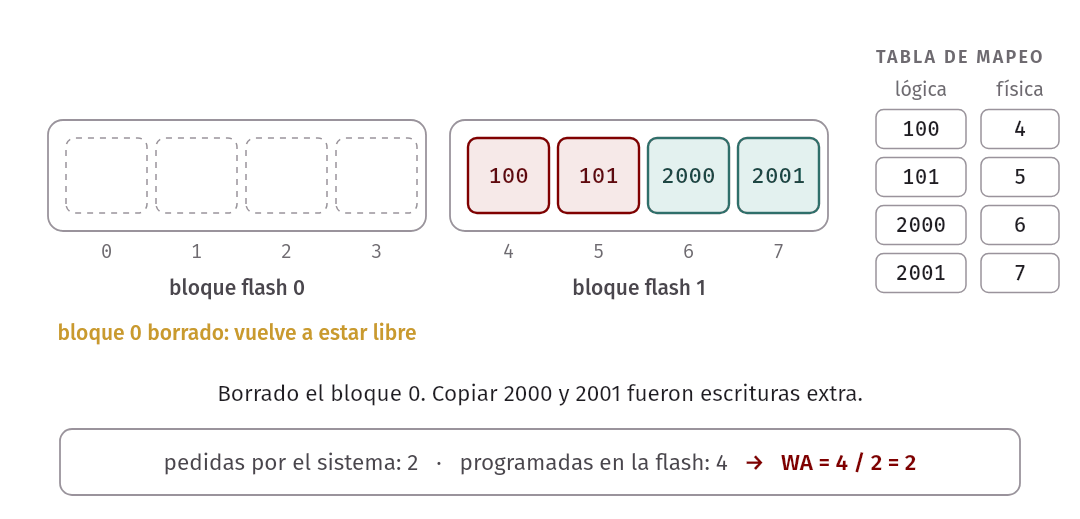
Los FTL reales son log-structured: cada escritura va a la siguiente página libre del bloque activo, y una tabla de mapeo en memoria anota dónde quedó cada página lógica. Si el sistema escribe las páginas lógicas 100, 101, 2000 y 2001, van a las físicas 0, 1, 2 y 3. Si después sobrescribe 100 y 101, los datos nuevos van a las físicas 4 y 5, la tabla se actualiza, y las páginas 0 y 1 quedan muertas. Es LFS otra vez, dentro del disco.
Recolección de basura y amplificación de escritura
Las páginas muertas hay que recuperarlas, pero solo se puede borrar un bloque entero. El recolector de basura (garbage collector, GC) elige un bloque, copia sus páginas vivas al final del log, actualiza la tabla y borra el bloque. En el ejemplo, el bloque 0 tiene muertas las páginas 0 y 1 y vivas la 2 y la 3: el GC copia 2000 y 2001 a las físicas 6 y 7 y borra el bloque 0.
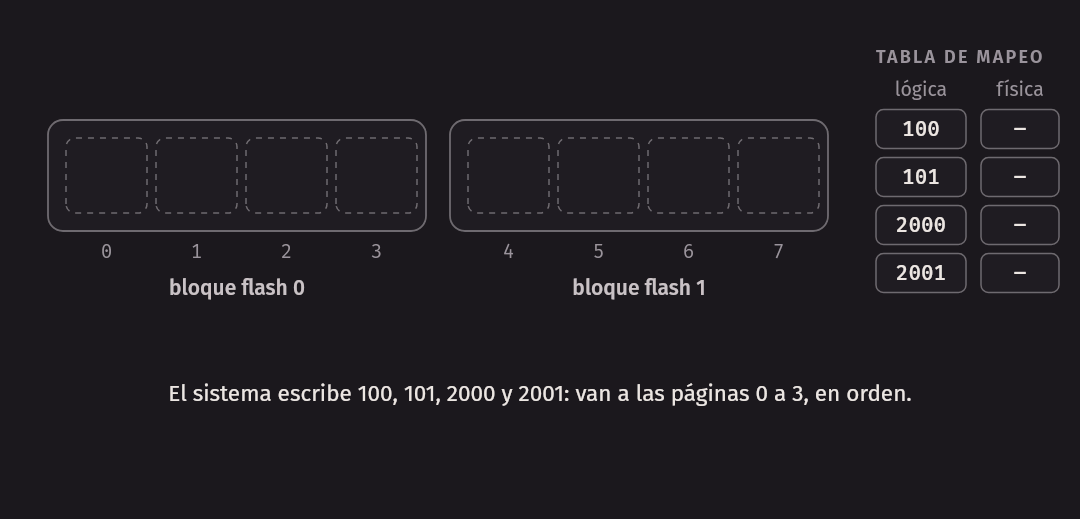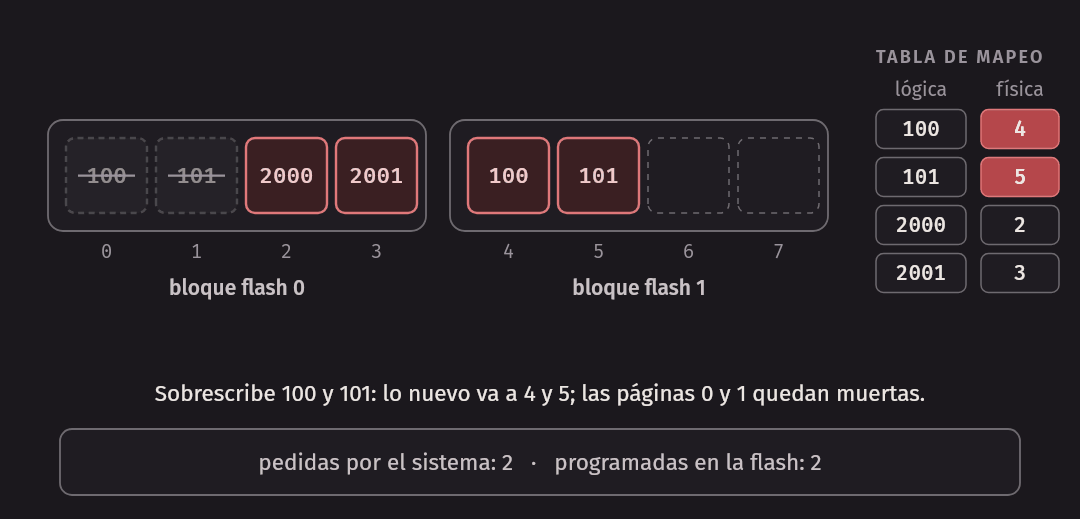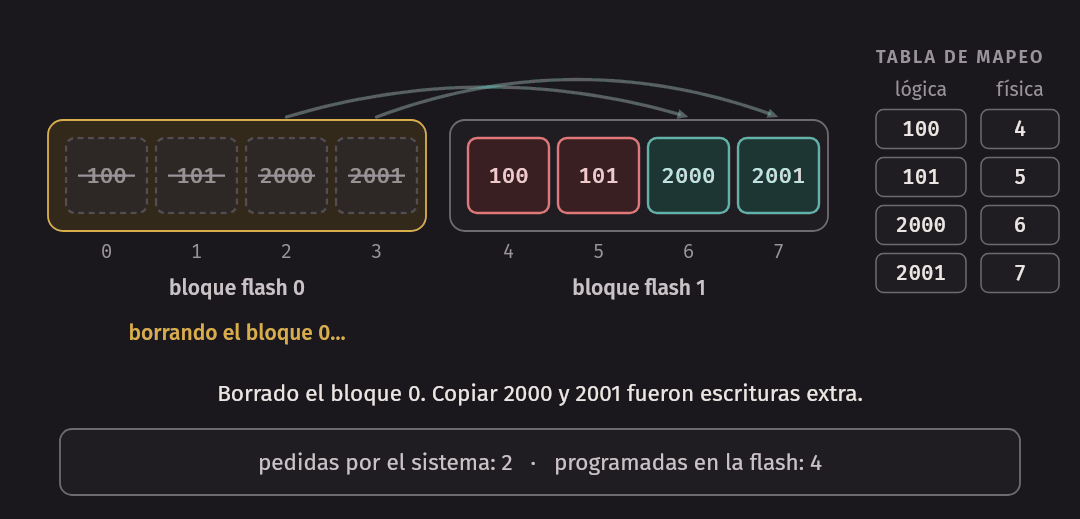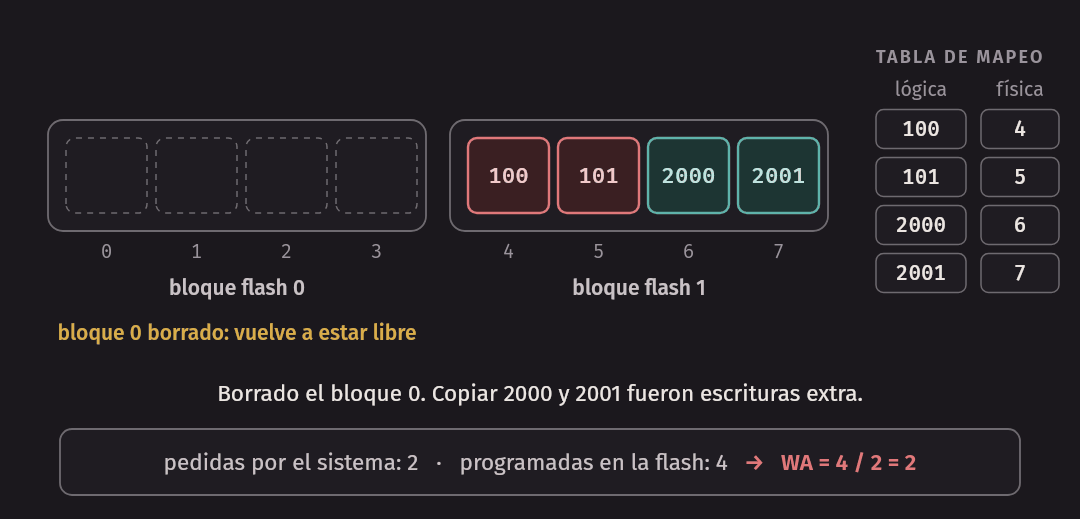
Esas copias son escrituras extra. La amplificación de escritura (write amplification) las mide:
WA = páginas programadas en la flash / páginas que pidió escribir el sistemaEn el ejemplo, el sistema escribió 2 páginas (las nuevas versiones de 100 y 101) y la flash programó 4 (esas dos más las dos copias del GC): WA = 2.
El programa ftl.c simula un FTL log-structured de
128 bloques de 32 páginas con un GC greedy: cuando quedan menos de dos bloques
libres, recolecta el que tiene menos páginas vivas. Llena una fracción de la
capacidad y luego hace 20 sobrescrituras al azar por página:
$ for u in 50 70 90; do ./ftl $u; done
ocupación 50%: escrituras del host 40960, copias del GC 9436
  amplificación de escritura = 1.23
ocupación 70%: escrituras del host 57340, copias del GC 48265
  amplificación de escritura = 1.84
ocupación 90%: escrituras del host 73720, copias del GC 305283
  amplificación de escritura = 5.14
Esto responde la segunda pregunta de repaso. Con el disco casi lleno, hasta el bloque “más vacío” tiene casi todas sus páginas vivas: para liberar una página hay que copiar varias, y al 90 % cada escritura cuesta más de cinco en la flash. Por eso las SSD esconden capacidad extra (sobreaprovisionamiento) y existe TRIM: el sistema de archivos avisa qué bloques borró y el GC deja de copiarlos.
El tamaño de la tabla de mapeo
Con mapeo por página, una SSD de 1 TB con páginas de 4 KB tiene 2⁴⁰ / 2¹² = 2²⁸ páginas. Con 4 bytes por entrada, la tabla ocupa 2²⁸ × 4 = 2³⁰ bytes: 1 GB de DRAM solo para la tabla.
El mapeo por bloque usa una entrada por bloque de 256 KB (64 veces menos), pero sobrescribir 4 KB obliga a copiar el bloque entero. Los FTL híbridos mapean por página unos pocos bloques de log y el resto por bloque. Otra opción es dejar la tabla en la flash y cachear en DRAM la parte que se usa, como una TLB.
Nivelación de desgaste
Un bloque con datos fríos nunca tiene basura, así que el GC nunca lo borra,
mientras los bloques calientes se gastan. La nivelación de desgaste (wear
leveling) mueve cada tanto los datos fríos para que esos bloques entren en la
rotación. Con ./ftl 90 hot (80 % de las escrituras al 20 % de las páginas),
nuestro FTL, que no nivela, termina con bloques de 71 y de 124 borrados.
Integridad de los datos
Los discos fallan a medias
El RAID de la semana 13 supone fallas fail-stop: un disco funciona o está muerto. Los discos reales también fallan de a un bloque:
- Error latente de sector (latent sector error, LSE): un sector se dañó, por un roce del cabezal o por radiación. El ECC del disco detecta que los bits no son válidos y el disco devuelve un error al leer.
- Corrupción silenciosa: el disco devuelve datos incorrectos sin avisar. Causas: firmware con errores, un bus que voltea bits, escrituras que terminan en el lugar equivocado.
Un estudio de Bairavasundaram y otros sobre 1,5 millones de discos durante unos tres años encontró al menos un LSE en el 9,40 % de los discos baratos (SATA) y el 1,40 % de los caros (SCSI/FC), y corrupción en el 0,50 % y el 0,05 %. Con miles de discos, eso pasa todas las semanas.
Errores latentes
Los LSE son fáciles de detectar: el disco avisa. Para recuperarse se usa la redundancia conocida: el espejo o la paridad. El caso feo es un LSE durante la reconstrucción de un disco caído en RAID 4/5; por eso existen esquemas con dos paridades, como RAID-6.
En xv6. Cuando el disco virtio termina un pedido,
virtio_disk_intrenkernel/virtio_disk.crevisa el byte de estado que escribió el dispositivo:if (disk.info[id].status != 0) panic("virtio_disk_intr status");. Ante un error de E/S, xv6 no reintenta ni tiene otra copia: detiene el sistema.
Checksums
La corrupción silenciosa necesita otro mecanismo, porque el disco no avisa. La herramienta es el checksum (suma de verificación): una función que, a partir de un bloque de datos, calcula unos pocos bytes que lo resumen. Al escribir un bloque se guarda su checksum; al leerlo se recalcula y se compara. Si no coinciden, el sistema sabe que el dato está mal y, si tiene redundancia, lee la otra copia y repara el bloque.
Algunas funciones comunes, de la más barata a la más robusta:
- XOR de todos los bytes. No detecta dos cambios en el mismo bit de bytes distintos, porque se cancelan.
- Suma módulo 256. No detecta bytes reordenados.
- Fletcher: dos sumas,
s1 = s1 + dys2 = s2 + s1(módulo 255). Comos2acumulas1, depende de la posición de cada byte. Adler-32 es una variante. - CRC: trata los datos como un polinomio y guarda el resto de dividirlo por un polinomio fijo. Detecta muy bien ráfagas de errores; lo usan Ethernet, zip y muchos sistemas de archivos.
Un ejemplo con los datos 1, 2, 3, 4 y los mismos datos al revés:
| d | s1 | s2 | d | s1 | s2 | |
|---|---|---|---|---|---|---|
| 1 | 1 | 1 | 4 | 4 | 4 | |
| 2 | 3 | 4 | 3 | 7 | 11 | |
| 3 | 6 | 10 | 2 | 9 | 20 | |
| 4 | 10 | 20 | 1 | 10 | 30 |
La suma da 10 en los dos casos y el XOR da 4 en los dos: ninguno nota que los bytes se reordenaron. Fletcher da (10, 20) y (10, 30): sí lo nota. En C, la versión de 16 bits cabe en unas líneas:
static uint32_t fletcher16(const uint8_t *d, size_t n) {
    uint32_t s1 = 0, s2 = 0;
    for (size_t i = 0; i < n; i++) {
        s1 = (s1 + d[i]) % 255;
        s2 = (s2 + s1) % 255;
    }
    return (s2 << 8) | s1;
}
El programa checksum.c calcula XOR, Fletcher-16,
Adler-32 y CRC-32 de un archivo y prueba tres daños en una copia en memoria:
$ seq 1 1000 > num.txt
$ ./checksum num.txt 100
...
2. El mismo bit volteado en dos bytes seguidos
  XOR-8        00000031 -> 00000031  NO DETECTADO
  Fletcher-16  000084b9 -> 000080b9  detectado
  Adler-32     9e0f7a5c -> 9e0b7a5c  detectado
  CRC-32       8dc4565d -> 910792e7  detectado
Con un solo bit volteado, los cuatro detectan el cambio. XOR falla cuando dos cambios se cancelan; los otros tres no. Ningún checksum es perfecto: hay 2³²⁷⁶⁸ bloques posibles de 4 KB y solo 2³² valores de CRC-32, así que existen colisiones. Lo que se busca es que los errores comunes no las produzcan.
Idea clave. Un checksum no corrige nada: solo convierte un error silencioso en uno detectado. Para corregir hace falta redundancia, igual que con un LSE.
Escrituras mal dirigidas y escrituras perdidas
Dos fallas engañan a un checksum guardado junto al dato:
- Escritura mal dirigida (misdirected write): datos correctos en el bloque equivocado; su checksum viaja con ellos y calza. Solución: guardar también un identificador físico (disco, bloque). Si el bloque 7 dice “soy el bloque 4”, está mal.
- Escritura perdida (lost write): el disco dice que escribió, pero no lo hizo. El dato viejo y su checksum viejo son coherentes entre sí. Soluciones: verificar al escribir (releer, duplicando las E/S) o guardar el checksum en otro lugar, como el inodo o el bloque que apunta al dato (ZFS).
Scrubbing
Un checksum solo se revisa al leer, y lo que nadie lee en meses podría dañarse
en todas sus copias. El scrubbing recorre todo el disco periódicamente,
verifica cada checksum y repara con la copia buena. Cuesta poco: 8 bytes por
bloque de 4 KB son menos del 0,2 % del espacio. scrub.c
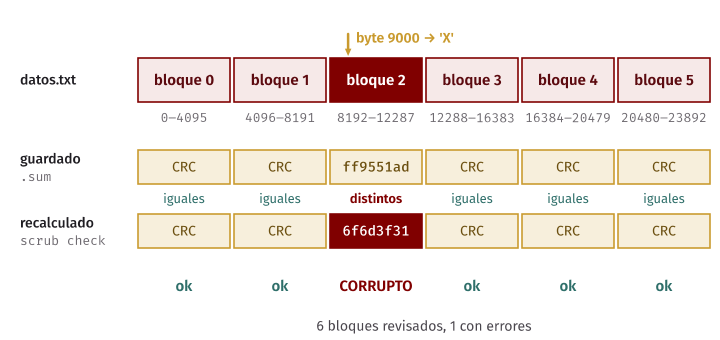
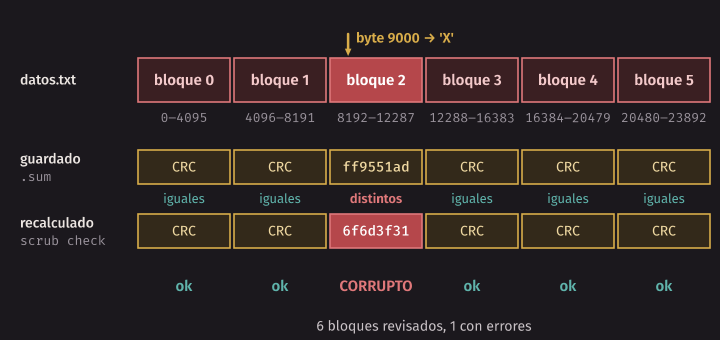
guarda un CRC-32 por bloque de 4 KB en un archivo aparte y luego los verifica:
$ seq 1 5000 > datos.txt
$ ./scrub sign datos.txt
6 bloques firmados en datos.txt.sum
$ printf 'X' | dd of=datos.txt bs=1 seek=9000 conv=notrunc status=none
$ ./scrub check datos.txt
bloque 2: CORRUPTO (guardado ff9551ad, leído 6f6d3f31)
6 bloques revisados, 1 con errores
El byte 9000 está en el bloque 2 (bytes 8192 a 12287), y es el único que falla.
En xv6.
breadybwriteenkernel/bio.cno calculan ni guardan checksums, ystruct buf(kernel/buf.h) no tiene un campo para uno. xv6 confía en que el disco devuelve lo que se escribió.
Comunicación no confiable
En un sistema distribuido, muchas máquinas cooperan por una red, y con miles de máquinas siempre hay alguna fallando. La red pierde mensajes (un router con el buffer lleno descarta paquetes), los corrompe, los duplica o los retrasa.
UDP refleja esa realidad: se envía un datagrama y nadie garantiza que llegue (trae un checksum, así que al menos no entrega datos corruptos). Encima se construye confiabilidad con cuatro piezas: el receptor confirma cada mensaje (ack); si el ack no llega a tiempo (timeout), el emisor reintenta; y si lo perdido era el ack, el receptor recibe un duplicado, que reconoce por su número de secuencia y no vuelve a procesar. TCP hace todo esto por dentro.
RPC
Una llamada a procedimiento remoto (RPC) hace que llamar a una función en otra máquina parezca local. Un compilador genera stubs: el del cliente empaqueta los argumentos (marshaling) y espera la respuesta; el del servidor desempaqueta y llama a la función. Un runtime se encarga de timeouts, reintentos y secuencias.
udprpc.c es un RPC mínimo: fork() crea un
servidor con una operación ADD(n) que suma a un contador, y ambos hablan por
127.0.0.1. El servidor descarta al azar pedidos y respuestas; el cliente espera
50 ms (SO_RCVTIMEO) y reintenta:
$ ./udprpc 200 20
llamadas ADD: 200  reintentos: 120  dedup: no
contador esperado: 200  contador en el servidor: 253  <-- ¡sumas duplicadas!
$ ./udprpc 200 20 dedup
llamadas ADD: 200  reintentos: 120  dedup: sí
contador esperado: 200  contador en el servidor: 200
Reintentar tras un pedido perdido es inofensivo; tras una respuesta perdida,
el servidor suma otra vez: ADD no es idempotente. Con dedup, el servidor
recuerda la última secuencia y su respuesta y no re-ejecuta duplicados. Funciona,
pero el servidor ahora tiene estado, que se pierde si se reinicia.
NFS: un servidor sin estado
En NFS (Sun, versión 2, años 80), los programas usan open, read y write
como siempre, y un sistema de archivos del cliente, en el kernel, los convierte
en mensajes a un servidor. Es un protocolo abierto: cualquiera puede
implementar un cliente o un servidor.
La meta fue recuperarse rápido y sin complicaciones de una caída del
servidor. Si open devolviera un descriptor guardado en el servidor, tras un
reinicio read(fd) no significaría nada. NFSv2 eligió un servidor sin estado
(stateless): cada pedido trae todo lo necesario para atenderlo.
La pieza central es el file handle: (volumen, número de inodo, número de generación). La generación cambia cuando un inodo se reutiliza, así un file handle viejo no termina abriendo otro archivo. Algunos mensajes del protocolo:
| Mensaje | Lleva |
|---|---|
LOOKUP |
file handle del directorio, nombre |
GETATTR |
file handle |
READ |
file handle, offset, cantidad |
WRITE |
file handle, offset, cantidad, datos |
CREATE, MKDIR, REMOVE |
file handle del directorio, nombre |
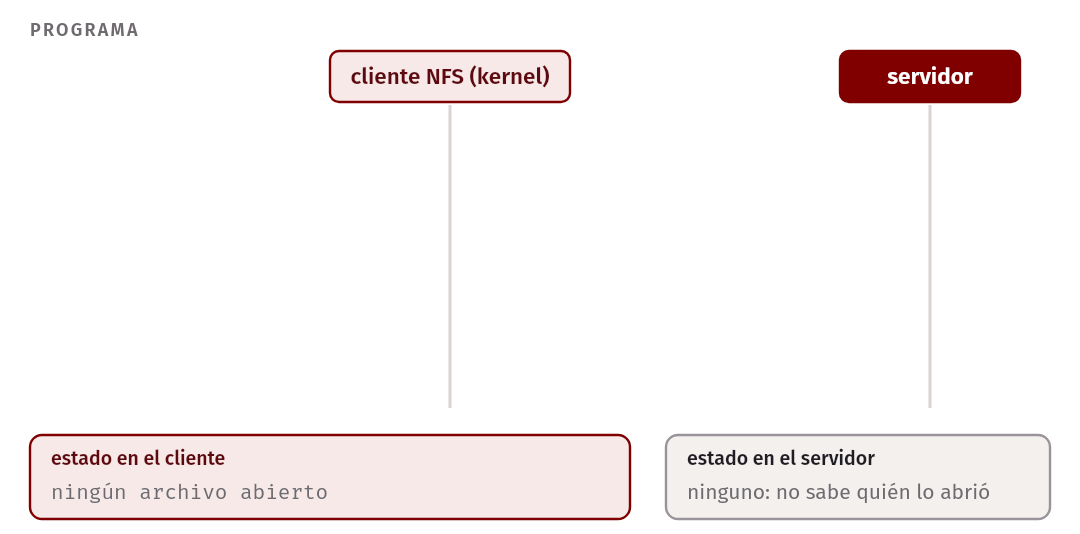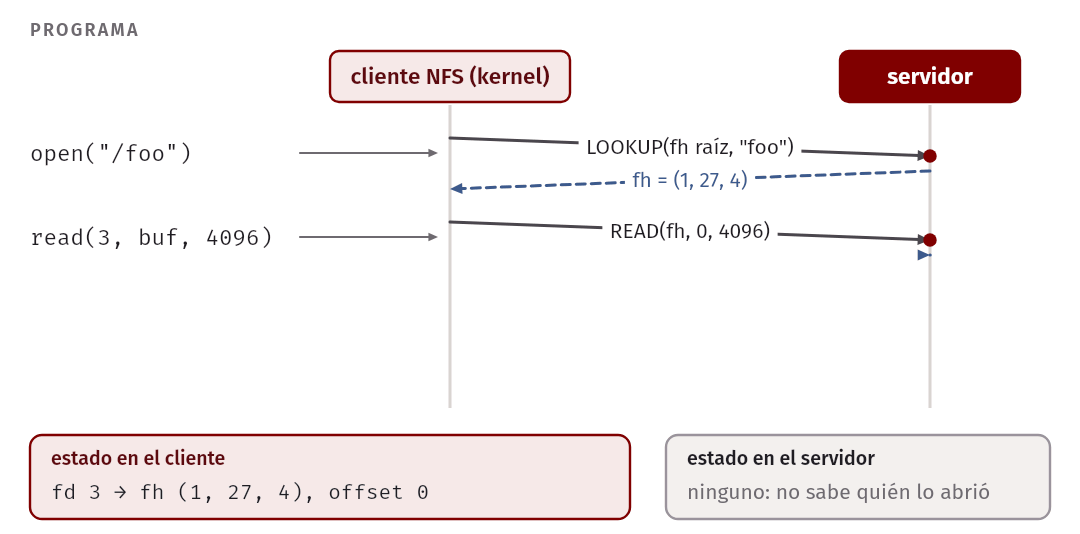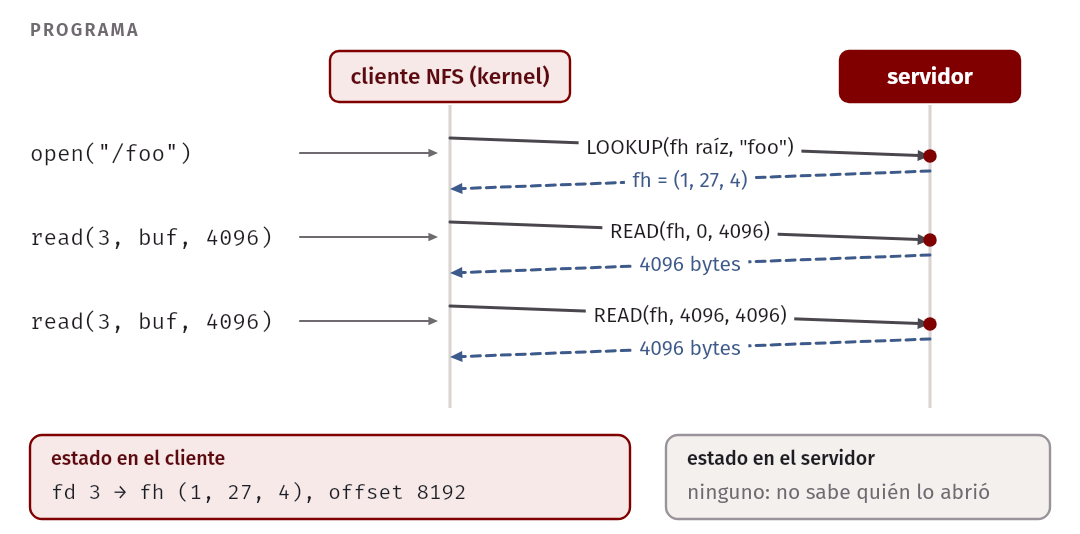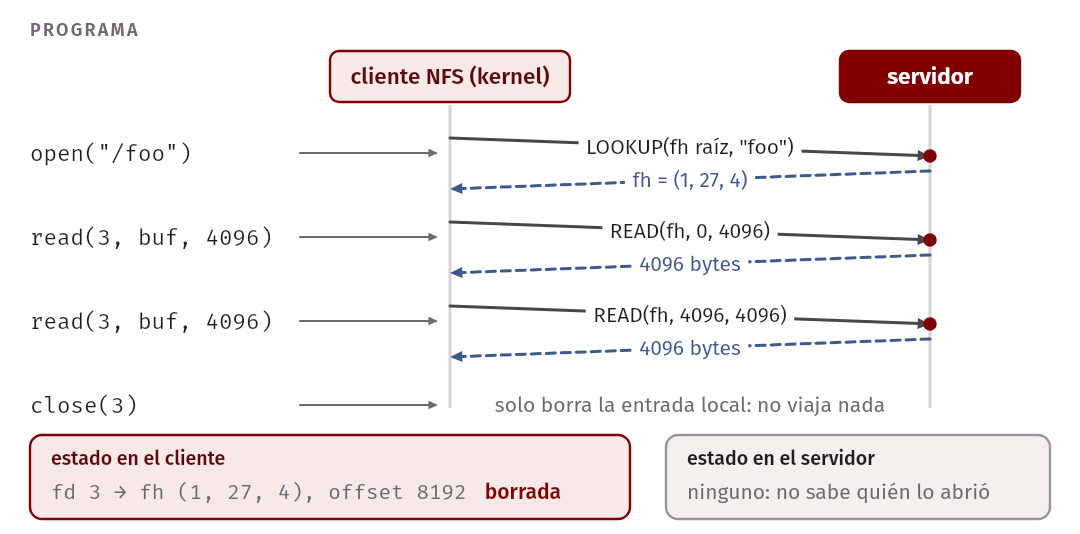
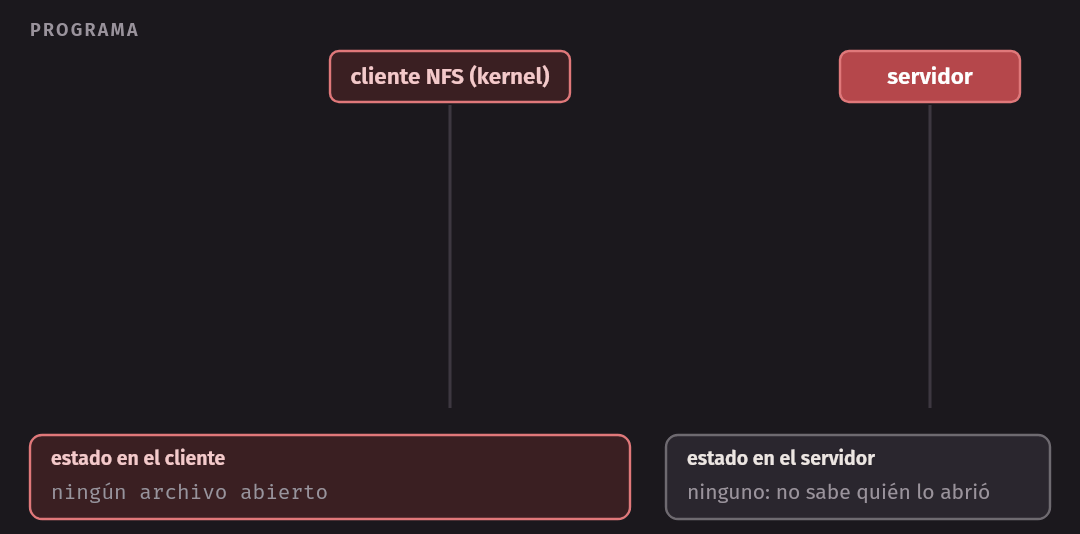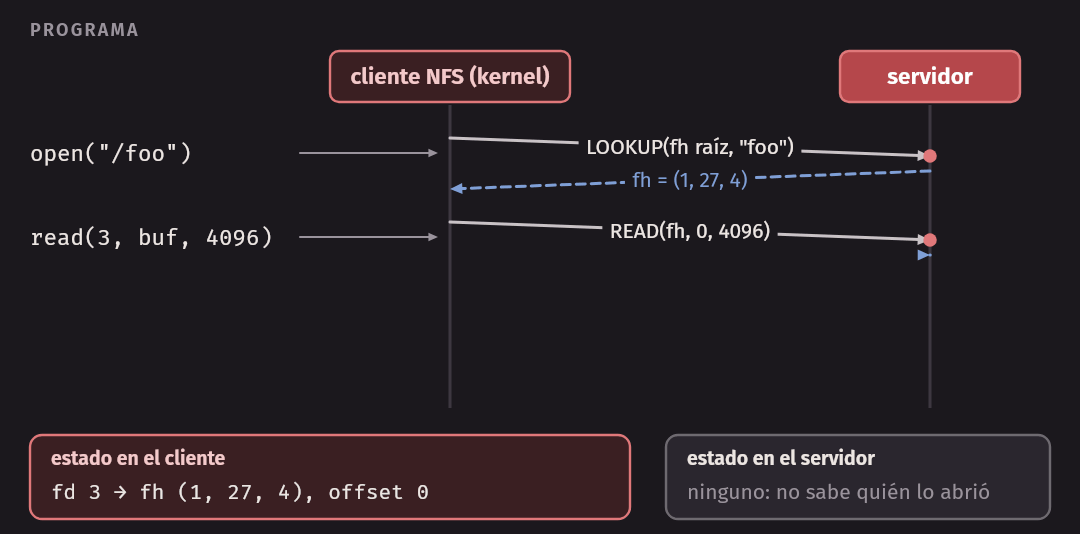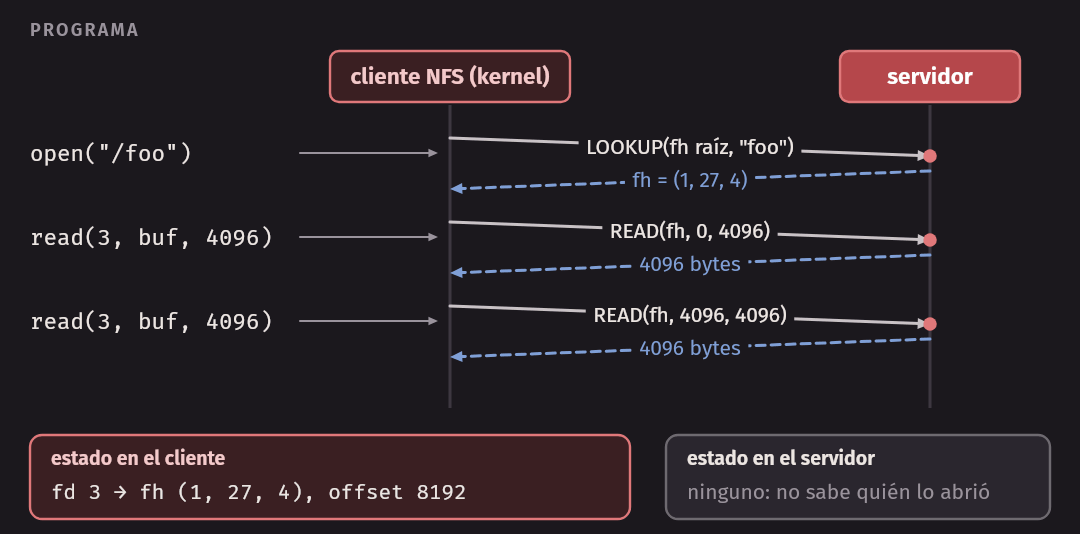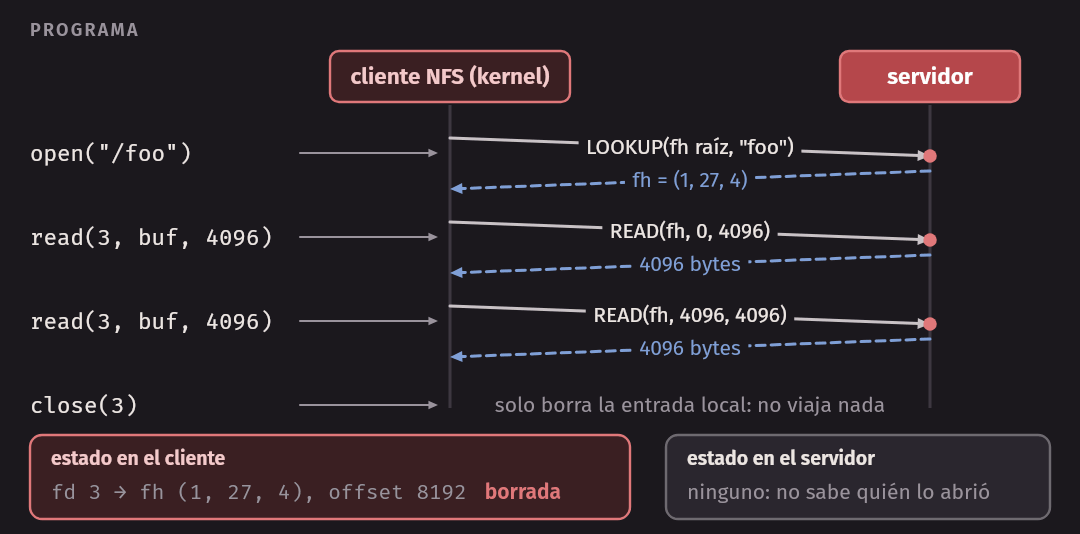
open("/foo") envía LOOKUP(fh de la raíz, "foo") y recibe el file handle. Es
el cliente el que guarda el descriptor, el file handle y el offset; un
read(fd, buf, 4096) se convierte en READ(fh, offset, 4096). close solo
libera la entrada local.
Idempotencia
Como cada pedido trae el offset absoluto, repetir un WRITE(fh, 8192, "hola")
deja el archivo igual que hacerlo una sola vez. Una operación así es
idempotente. READ, WRITE, GETATTR y LOOKUP lo son.
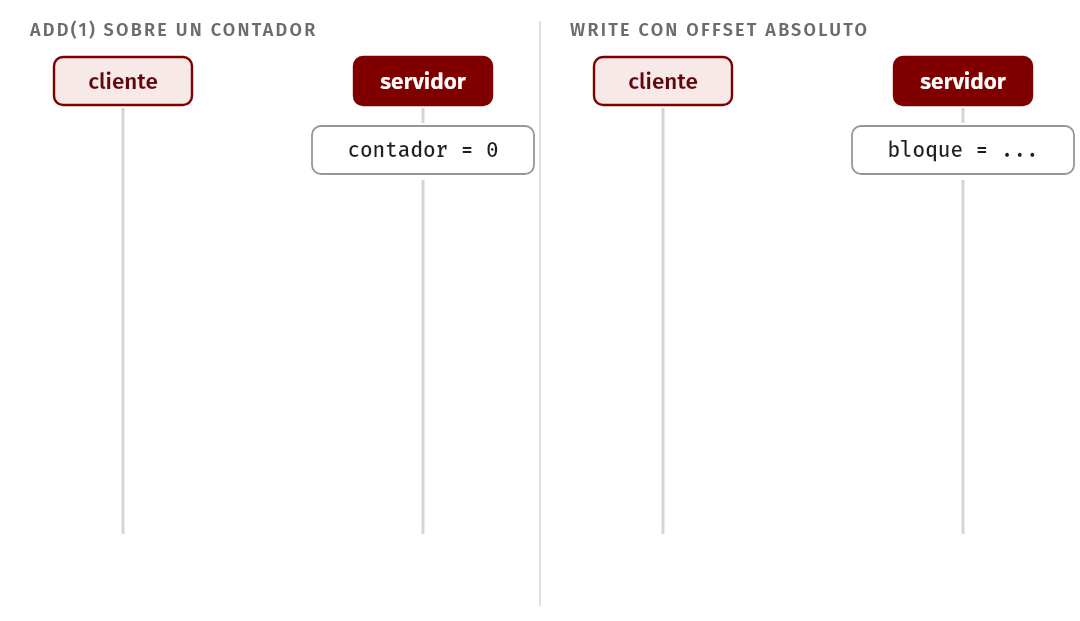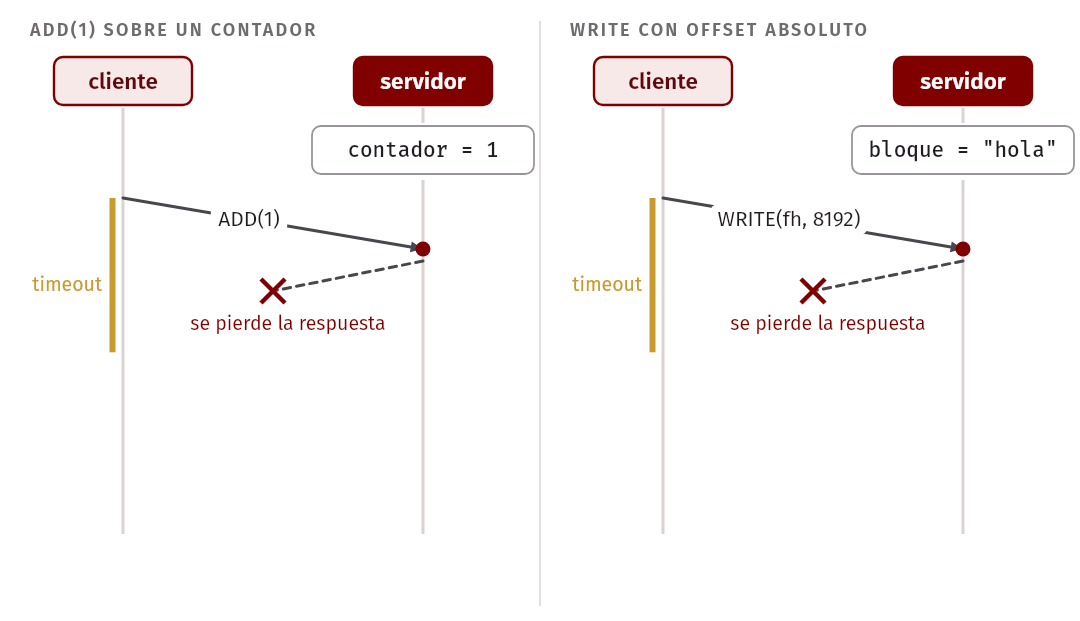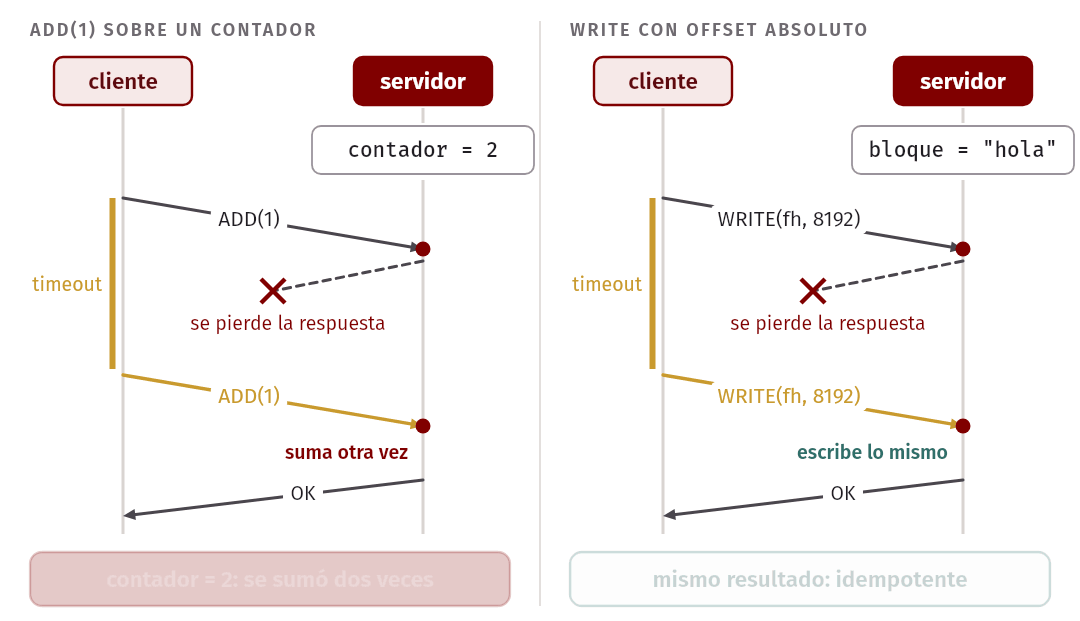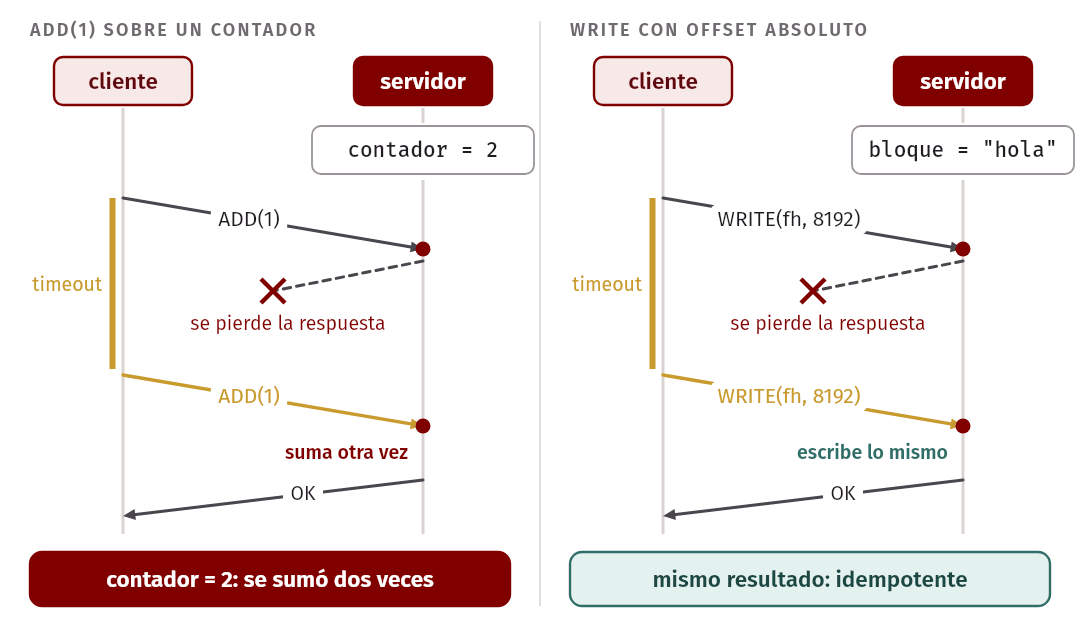
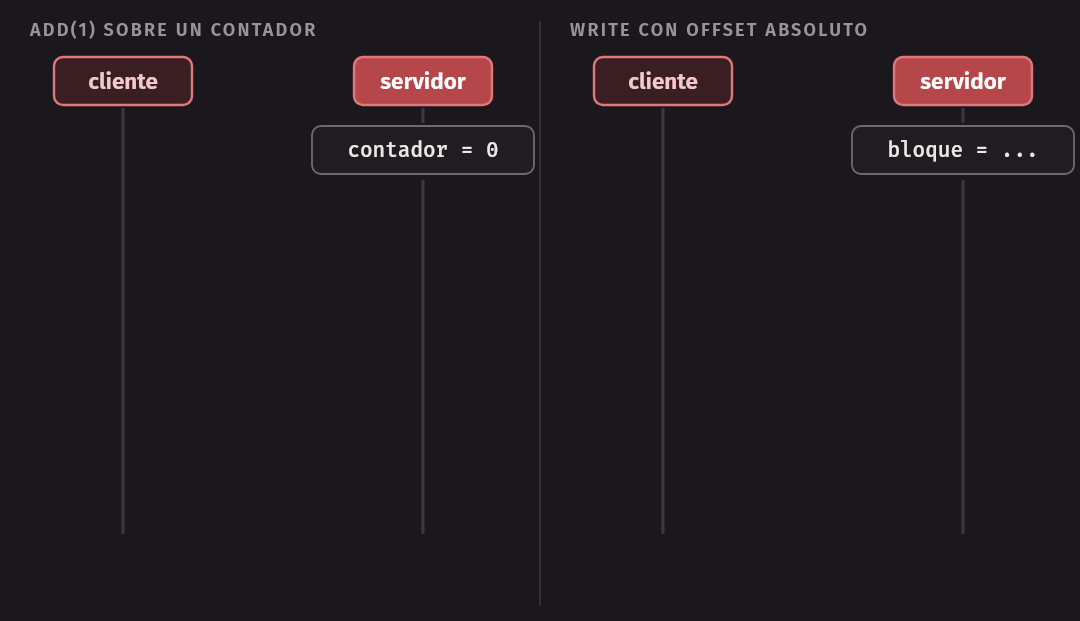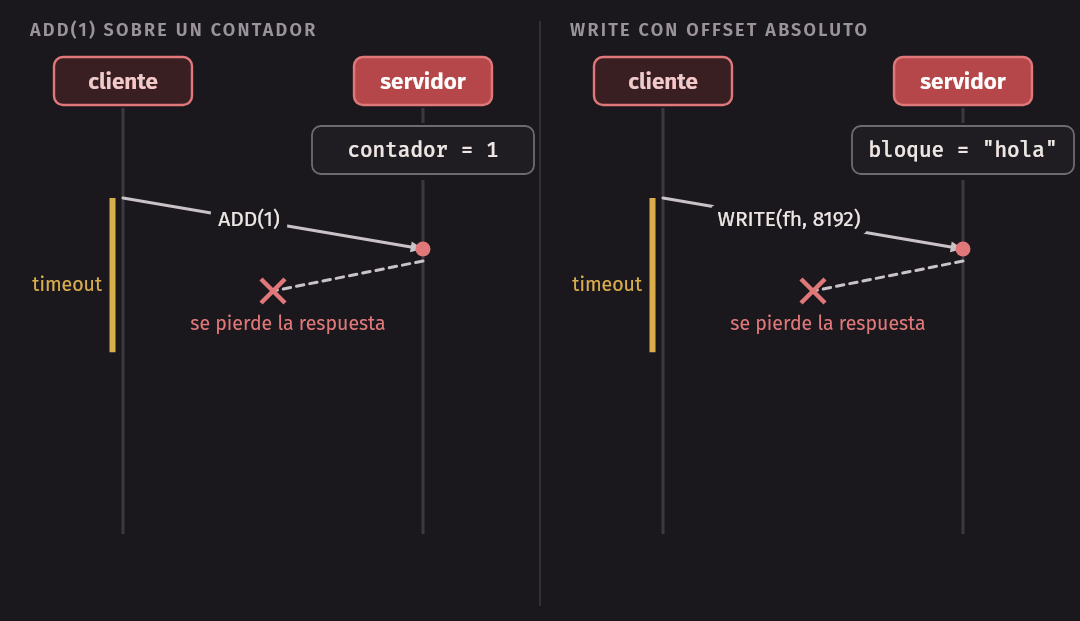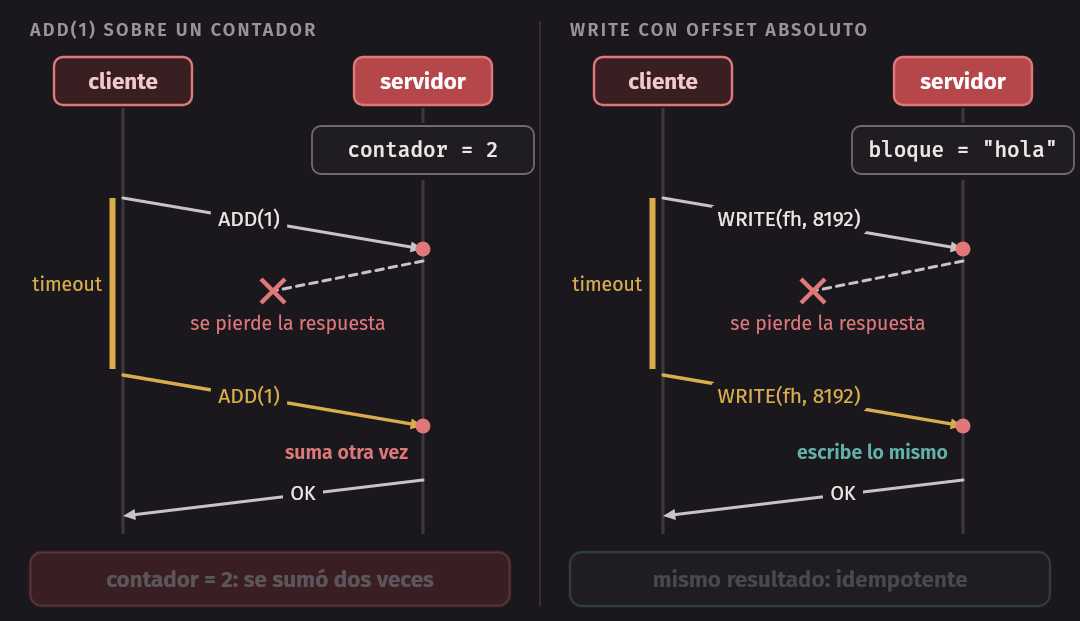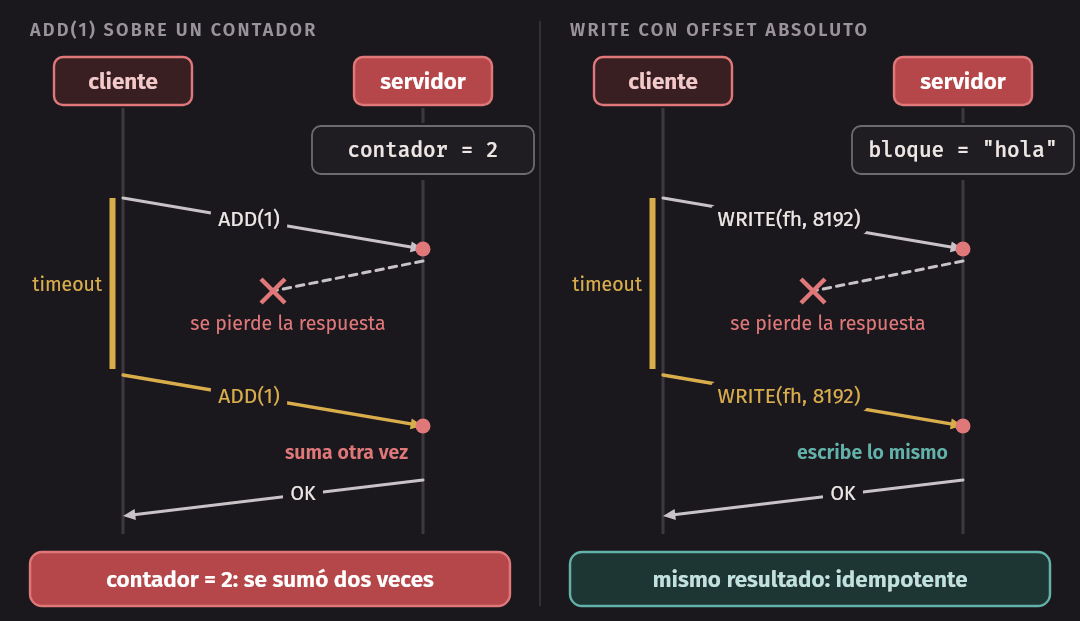
Esto responde la tercera pregunta de repaso. Desde el cliente, tres fallas se
ven igual: se perdió el pedido, se perdió la respuesta, o el servidor se cayó
(antes o después de ejecutar). Si todas las operaciones son idempotentes, el
cliente tiene un solo remedio para las tres: reintentar. No necesita saber cuál
ocurrió, y el servidor no necesita la tabla de secuencias que usamos en
udprpc. Algunas operaciones son más difíciles: un MKDIR repetido responde
“ya existe” aunque el primero sí funcionó.
La caché del cliente
Para no cruzar la red en cada read, el cliente guarda bloques en memoria. Eso
trae dos problemas de consistencia:
- Visibilidad: si C2 escribe y deja los bloques en su caché, C3 lee la versión vieja del servidor. NFS usa flush-on-close: al cerrar, el cliente envía todo lo que modificó.
- Caché vencida: C1 sigue usando la versión vieja que tenía cacheada. Antes
de usarla, NFS envía
GETATTRpara comparar la fecha de modificación; para no saturar el servidor, se agregó una caché de atributos de unos 3 segundos, durante la cual se pueden leer datos viejos.
El servidor, en cambio, no puede responder WRITE antes de llevarlo a
almacenamiento estable: si confirma el bloque b desde memoria y se cae, el
cliente no lo reintenta y el archivo queda con el valor viejo en medio. Por eso
los servidores NFS usan memoria con batería o sistemas como WAFL.
AFS: archivos completos y callbacks
AFS (Carnegie Mellon, años 80) buscó que un servidor atendiera muchos
clientes. Desde la primera versión cachea archivos completos en el disco
local: al abrir se trae el archivo entero, se trabaja localmente y al cerrar, si
cambió, se devuelve. Pero al reabrir, el cliente preguntaba “¿cambió?”
(TestAuth) y el servidor recorría rutas completas: aguantaba unos 20 clientes.
AFSv2 introdujo dos cambios:
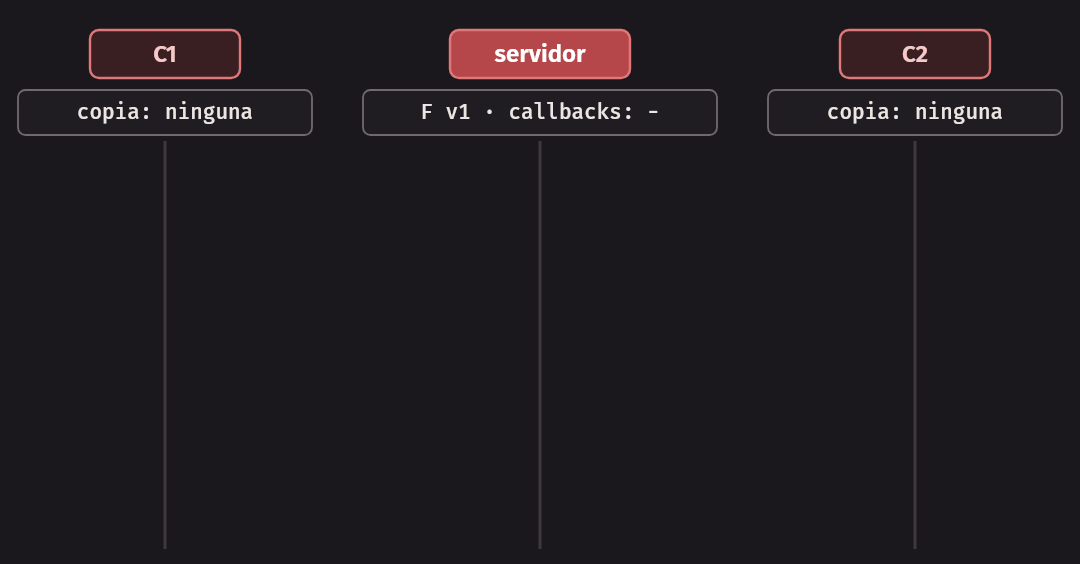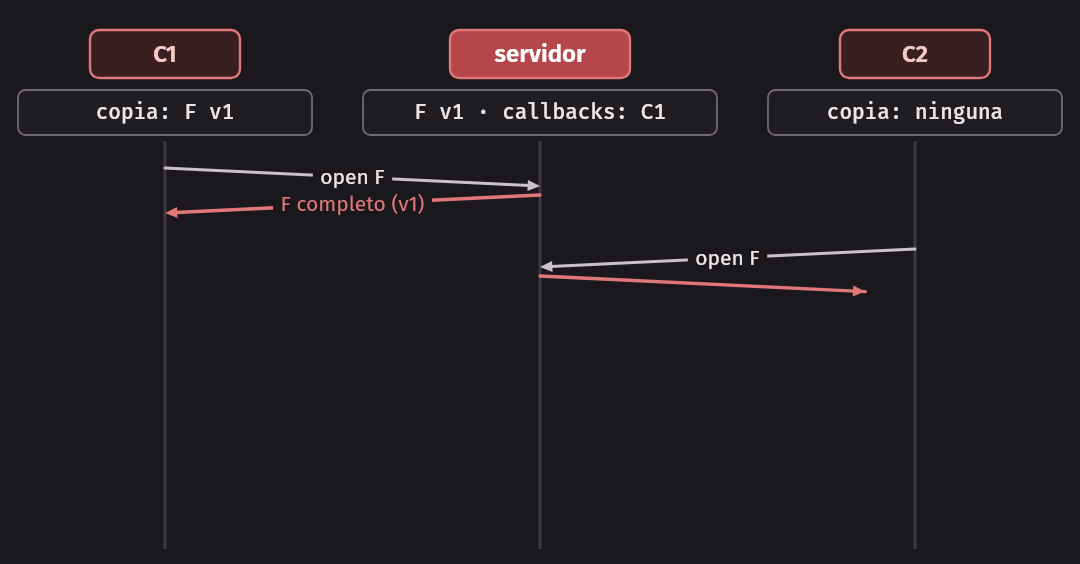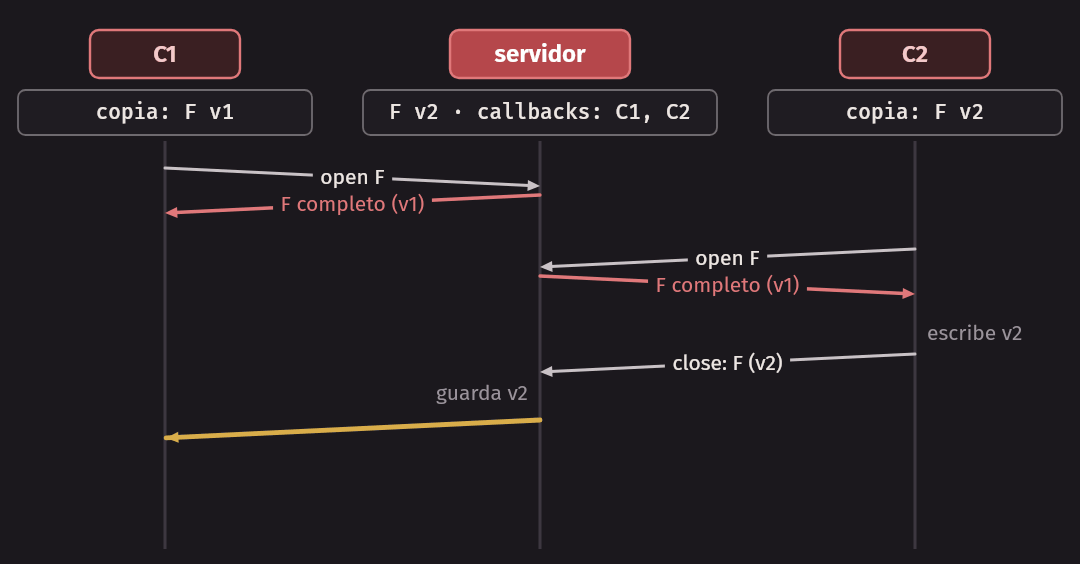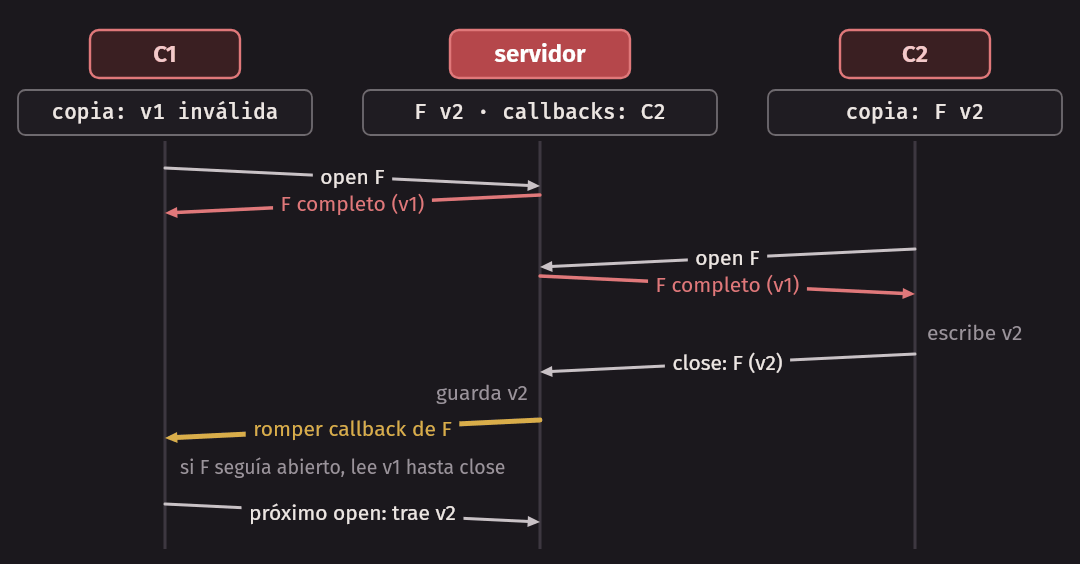
- Callbacks: al entregar un archivo, el servidor promete avisar al cliente si alguien lo modifica. El cliente ya no pregunta; usa su copia hasta recibir un aviso. Es el paso de polling a interrupción.
- FID (volumen, archivo, generación) en lugar de rutas: el cliente recorre los directorios y los guarda en su caché.
Un servidor pasó a atender unos 50 clientes. El precio es que ahora el servidor tiene estado: sabe qué clientes tienen copia de cada archivo.
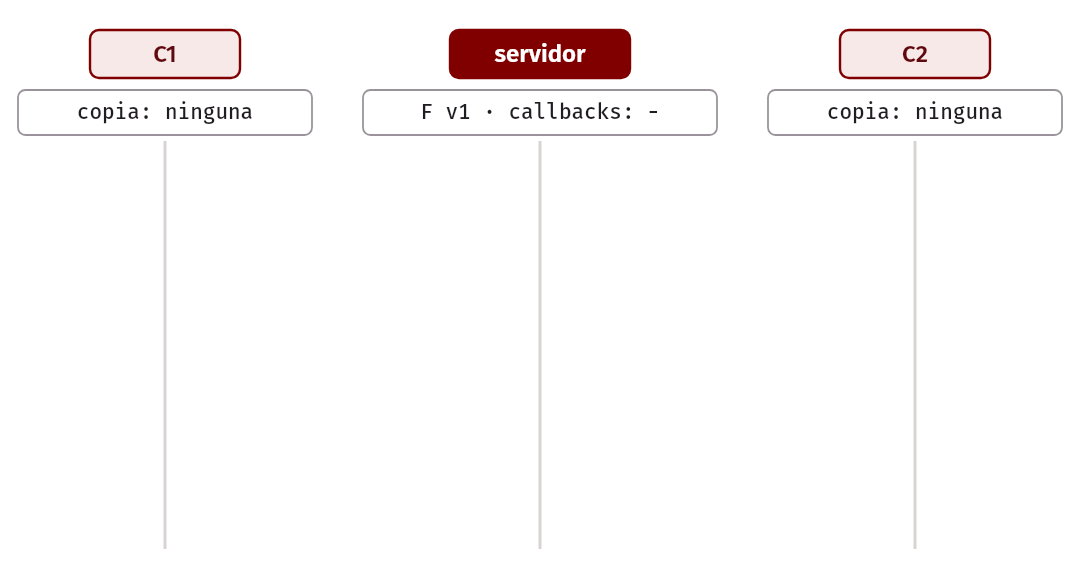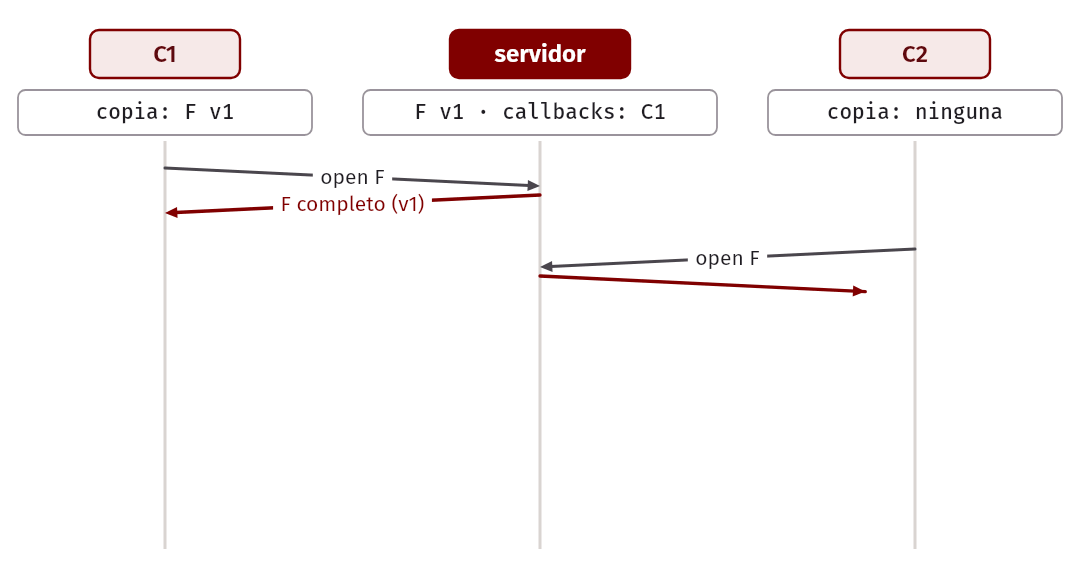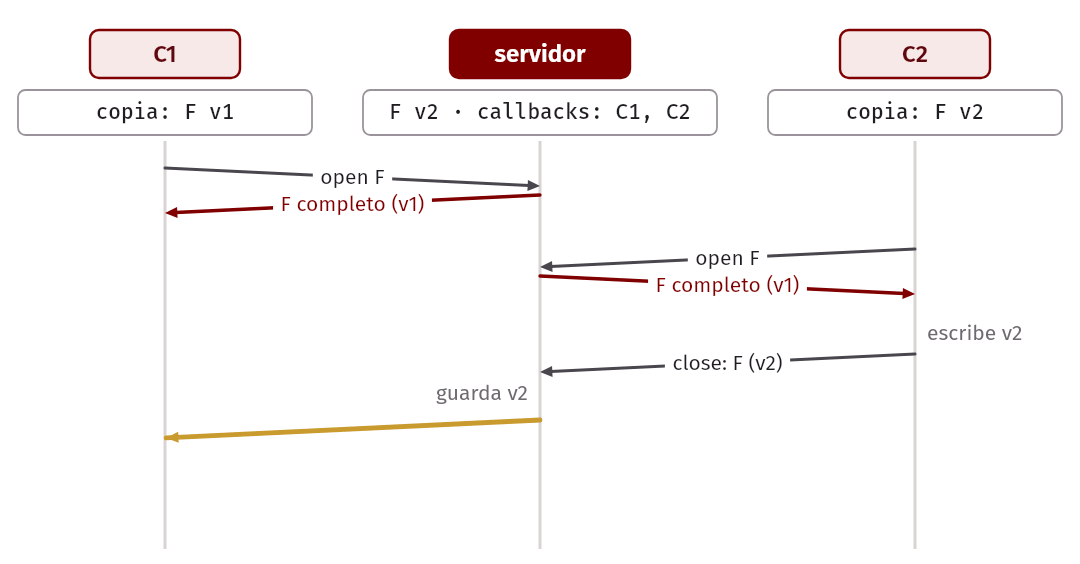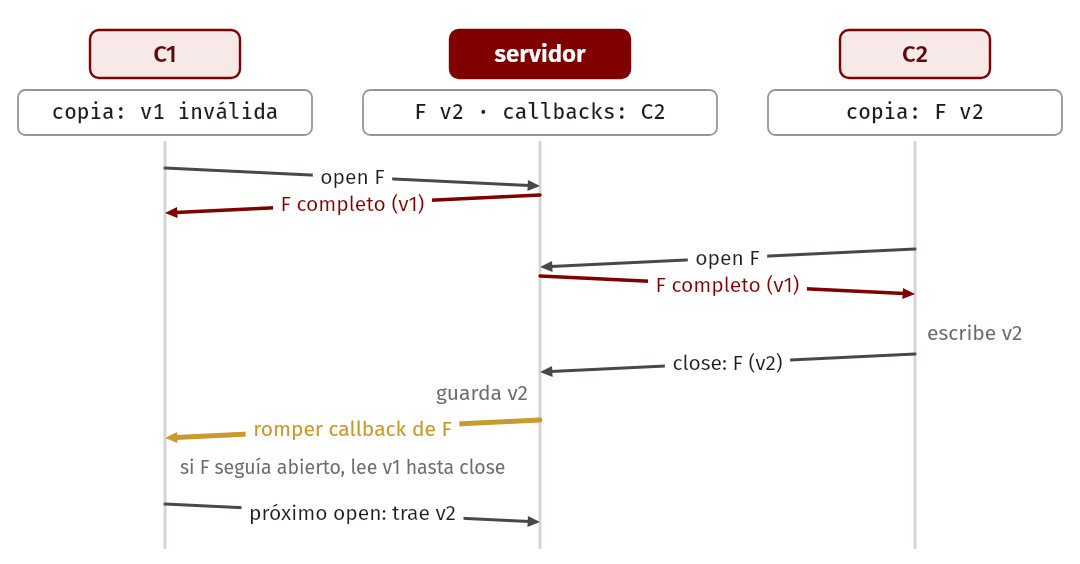
Un ejemplo: C1 y C2 abren F y reciben v1; el servidor anota callbacks para los
dos. C2 escribe v2 y cierra, enviando F al servidor, que rompe el callback de
C1. Si C1 todavía tiene F abierto, sigue leyendo v1 hasta cerrarlo; el próximo
open trae v2.
Consistencia y fallos
En AFS, lo escrito no se ve en otras máquinas hasta el close. Si dos clientes
modifican el mismo archivo, gana el último en cerrar (last writer wins): el
archivo queda entero de uno o del otro, mientras que en NFS puede mezclar bloques.
Los callbacks complican la recuperación: si un cliente o el servidor se reinicia, pudo perderse un aviso, y los clientes deben revalidar su caché.
| NFSv2 | AFSv2 | |
|---|---|---|
| Qué se cachea | bloques, en memoria | archivos completos, en disco |
| ¿Cambió? | GETATTR (caché de 3 s) |
callback |
| Visibilidad | al cerrar | al cerrar |
| Escrituras simultáneas | bloques mezclados | gana el último en cerrar |
| Servidor | sin estado | con estado |
| Tras una caída | reintentar | revalidar cachés |
Resumen
- LFS escribe todo en segmentos al final del log; como los inodos se mueven, necesita un imap, una CR fija y un limpiador que use el resumen del segmento.
- Una SSD no puede sobrescribir: su FTL es un LFS con tabla de mapeo, GC y nivelación de desgaste. La amplificación de escritura se dispara con el disco casi lleno.
- Los LSE se detectan solos; la corrupción silenciosa necesita checksums, un identificador físico, el checksum en otro lugar para las escrituras perdidas y scrubbing.
- Sobre una red que pierde mensajes: acks, timeouts, reintentos y secuencias; RPC los esconde detrás de una llamada.
- NFS: servidor sin estado y operaciones idempotentes; flush-on-close y
GETATTR. AFS: archivos completos, callbacks, gana el último en cerrar.
Ejercicios
- Con
T_pos= 8 ms yR_pico= 200 MB/s, ¿de qué tamaño debe ser un segmento de LFS para alcanzar el 90 % de la tasa pico? ¿Y el 95 %? - En LFS, un programa crea el archivo
/ay escribe un bloque. Enumeren todo lo que LFS agrega al log (datos, inodos, directorio, pedazos de imap). Comparen con lo que escribiría xv6 en su log y luego en los lugares fijos. - Ejecuten
./ftlcon ocupaciones de 30 % a 90 % en pasos de 10 y grafiquen la amplificación de escritura. Modifiquengc()enftl.cpara que elija un bloque al azar en vez del que tiene menos páginas vivas. ¿Cómo cambia la curva? - Calculen a mano la suma, el XOR y Fletcher de los datos 0, 1, 2, 3. Encuentren
otros cuatro bytes distintos con el mismo Fletcher. Verifiquen con
checksum.py -D 0,1,2,3 -c. - Modifiquen
scrub.cpara que guarde, junto a cada CRC, el número de bloque, y quecheckinforme si el bloque leído tiene el identificador de otro bloque. ¿Qué falla de las vistas en el capítulo detecta este cambio? - En
udprpc.c, cambienADDpor una operaciónSET(x)que asigna el contador. Corran./udprpc 200 20sindedup. ¿Hay valores incorrectos? ¿Por qué? - Dos clientes NFS abren el mismo archivo de 3 bloques y escriben los 3 bloques
a la vez, intercalando los
WRITE. Describan los posibles contenidos finales. Repitan el análisis con AFS.